[그룹 리센느와 성공학 개론]
미나미가 짧은 인터뷰에서 잘되는 조직의 핵심을 말했는데..
"이 동료들과 같이 일하면 즐겁다." 이다. 미나미는 이 사람들이 안떠났으면 좋겠다는 표현을 썼다.
이런 분위기가 형성된 조직은 절대 망하지 않는다. 사업도 비즈니스도 조직의 분위기가 일번이다.
https://t.co/oVzU9krQea
[리센느 신곡발매 및 지능적인 컨텐츠 전략]
리센느가 대중에게 처음으로 알려진 것은 "유튜브 안원잘부"였다.
본격적인 입소문을 타자 그들은 신곡을 내기보다는 기존에 뜰만한 타이틀과 이미 대중에게 널리 알려진 "카라의 Pretty Girl"로 대중 가요 시장 진입에 성공했다.
오늘 신곡 타이틀의 일부를 공개했는데.. 곡을 공개한 것이 아니고 가사를 선공개했다. 그녀들이 지금까지 겪은 서사를 가사로 만들었다.
여기에 곡이 더해지면 한층 더 파괴력을 갖출것으로 예상된다.
중소 아이돌을 운영하는 기획사가 어떻게 살아남아야 하는지 교과서적인 사례를 보는것 같아 놀랍다.
https://t.co/nU91jGvju6
[테슬라 로드스터와 차원의 확장]
기존 자동차 메이저들은 자동차를 2차원 세상에서 작동하는 기계로 한정했었다.
하지만 테슬라는 300년 넘은 고정관념을 단번에 깨부쉈다.
이런 신기능을 돈을 아끼지 않는 부자들을 대상으로 한 슈퍼카에 적용한것도 적절한 판단이다.
https://t.co/7nCKMcxMb1
[스텝이 꼬일대로 꼬여버린 AI정책]
독파모(한국형 독자 파운데이션 모델)는 애초의 취지가 프론티어 모델 성능에 육박하는 AI를 만드는 것이었다.
여러가지 반발이 커질대로 커지자 두개를 동시에 추진하겠다는 것은 악수 중에 악수다.
차라리 이쯤에서 욕을 먹을지언정 독파모는 "실패한 실험"임을 깨끗하게 인정하고 새로운 말로 갈아타는 것이 낫다.
https://t.co/9betJeCcOn
[독파모 대참사의 원인]
독파모(한국형 독자 파운데이션 모델)로 연일 AI판이 시끄럽다.
나는 애초에 이 프로젝트가 시작할때부터 이 프로젝트는 실패할 거라고 단정했다.
"이유는 간단하다."
① 한국에는 프론티어 AI모델을 A부터 Z까지 완벽하게 구현해 본 사람이 한명도 없기 때문이다. 인터넷에 공개된 데이터와 소스로 중소형 모델을 구현해본 사람은 많다. 하지만 챗GPT-5급 이상의 멀티모달 프론티어 AI모델을 구현해본 사람은 없다.
1차 독파모 평가때 네이버가 중국의 멀티모달 모델 Qwen의 가중치를 카피해서 탈락한 것을 보면 알 수있다. 오픈AI, 구글, 앤트로픽에 있어야할 핵심인재가 한국에 있을리는 만무하다.
언론에 여러 교수나 전문가들이 나와서 이러쿵저러쿵 말은 하지만 사실 이들중에도 프론티어급의 AI모델을 A부터 Z까지 만들어 본 사람은 아무도 없다. 아마 "입으로만 떠들지 말고 당신이 만들어 보시라." 하면 알아서 다 내뺄 걸로 보인다.
그정도로 첨단 AI를 만드는 기술은 어렵고 상당한 기술과 노하우가 필요한 일이다.
그런 상황에서 ② 정량적인 평가기준을 만들기는 상당히 어려웠을 것으로 보인다. 프론티어 모델을 처음부터 끝까지 만들어 보고 어떤 점이 핵심인지를 아는 사람만이 객관적인 프��임워크 아래 "평가기준"을 설계할 수가 있다. 따라서 정성적인 평가로 갈수밖에 없었을 것이다.
그런 상황에서 정량적 평가를 위해 찾은 방법이 AAII라는 AI 벤치마크 기업의 도움을 받아 벤치마크를 추진한 것이었는데.. 여기도 평가 데이터셋 중 절반 이상을 외부에 공개하고 돈을 내면 실제 테스트를 더 해주는 기업이기 때문에 "데이터 사전학습"이 논란이 됬던 것이다.(공공기관도 아니고 쉽게 말해 테스트 데이터셋을 팔아먹는 업자다.)
소위 "무빙타겟"방식으로 평가를 하겠다는 것은 프레임워크가 없다는 것과 같은 말이다.
이 "서바이벌 평가"라는 것이 ① 프론티어 AI개발을 전체적으로 꿰뚫어볼 수 있는 사람 과 ②기술과 정책을 아우르는 명확한 평가 프레임이 없으면 불가능하다는 사실을 뒤늦게나마 정부관계자들은 깨달은 것으로 보인다.
https://t.co/IghhvobYV8
[국가대표AI 중단 검토]
그간 국가대표AI는 공정한 평가문제로 상당히 ���끄러웠다.
최첨단 AI기술의 성능을 평가하는 걸 공무원이나 공공기관 직원들이 전문가 자문을 받는다고 해도 문제없이 해낼 수가 있었을까?
애초부터 불가능한 프로젝트였다.
#국가대표AI
https://t.co/pwg8pf0zfE
[AI시대에 인간이 더 귀중해 지는 역설]
결국 이것을 입증하는 논문이 나왔는데..
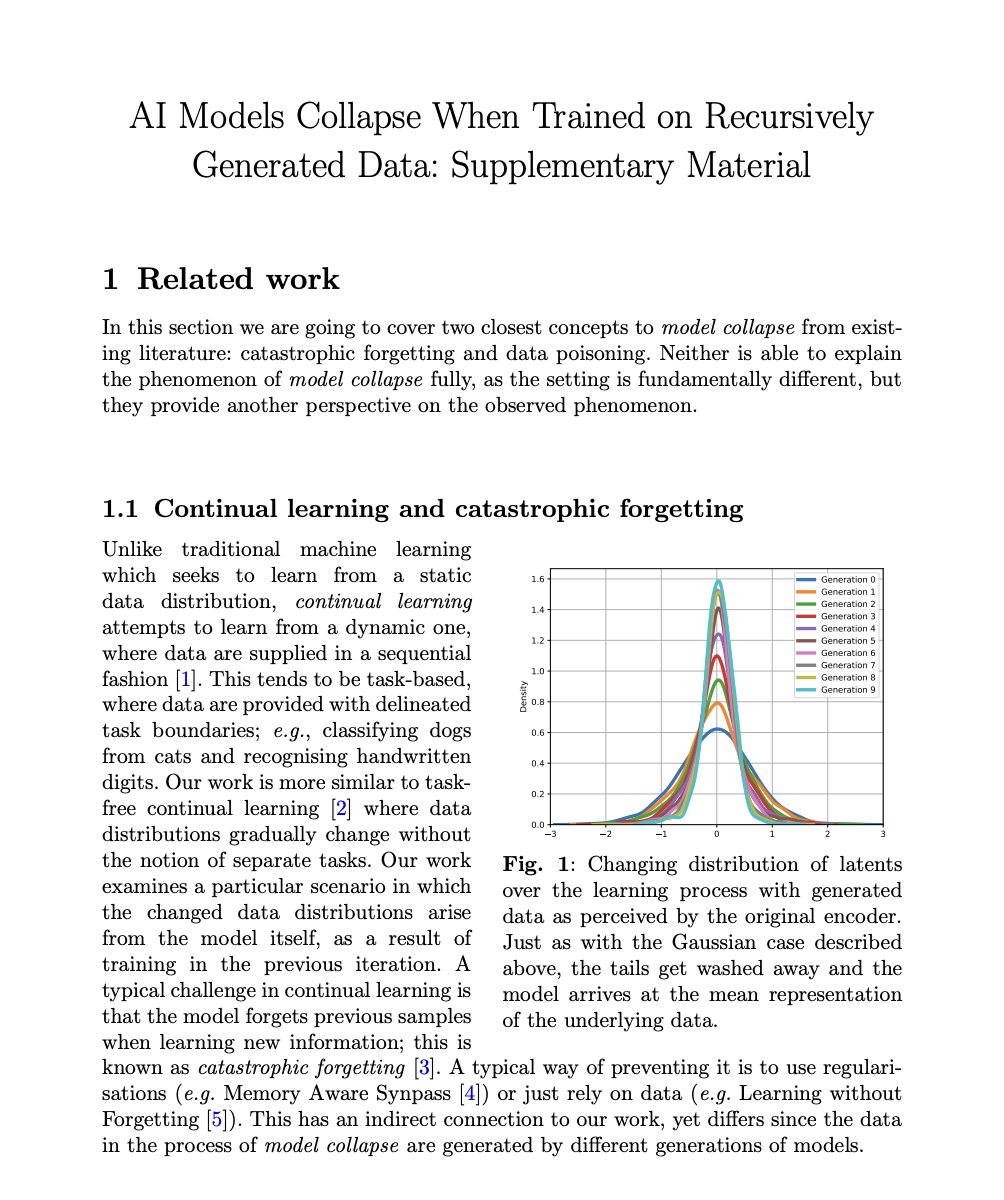
이제 인터넷에 올라가는 글들은 AI가 쓴 글들이 많아서 이 글들로 학습했을때 오히려 최신 AI의 지식이 퇴보한다는 것이다.
"자신만의 독특한 관점" "자신만의 세계관"을 갖는 인간이 더욱 귀중해지고 있다.
ChatGPT has now a big problem.
Researchers at Oxford and Cambridge exposed a massive threat to large language models.”
They call it “model collapse."
Internet ecosystem is rapidly changing, and generative AI will soon contribute much of the text found online. This forces us to consider what happens to future iterations like gpt-n when they are trained on data scraped from the web that was already generated by an llm.
According to the research, indiscriminately using model-generated content in training causes "irreversible defects" in the resulting ai. the model loses the "tails of the original content distribution." in other words, it begins to forget the creative, fringe, and unique nuances of actual human writing, collapsing into a repetitive echo chamber.
This isn't just a chatgpt issue.. the researchers built theoretical intuition showing this collapse is ubiquitous across learned generative models, occurring in large language models as well as in variational autoencoders and gaussian mixture models.
Tech companies rely on scraping the internet for large-scale data to build smarter models. However, the paper warns that if we want to sustain the benefits of training on web data, model collapse must be taken seriously.
Ultimate takeaway? data collected from genuine human interactions is going to become increasingly valuable in a web filled with ai content.
[사고의 주도권을 AI에게 넘기면 나타나는 현상]
슬슬 그 부작용들이 나타나기 시작했고 외국 교육기관들은 AI 사용을 금지하기 시작했다.
앞으로 핵심 인재들을 키워내는 명문학교는 아이러니하게 AI를 학습에 활용하지 않는 학교가 될거로 감히 예상한다.
https://t.co/tOGs3ODvo5
[해외 평가 업자에 인공지능 평가를 맡겼던 한국]
이번 독파모 평가에서 해외 인공지능 평가업체에 AI수준 평가를 맡겼는데 벤치마크 1위 판정을 받은 업체가 떨어져서 시끄러웠다.
AAII는 중립적인 공공기관이 아니고 기업이다.
문제는 그들은 기업이기 때문에 그들의 평가 데이터셋을 외부에 공개한다는 것에 있다.
물론 전부를 공개한다는 것은 아니다. (공��된 데이터셋으로 테스트를 해보시고 일부는 돈을 내고 더 해보라는 의미..) 즉 평가 데이터셋을 팔아먹는 기업에 가깝다.
그래서 이번에 평가대상 기업들이 "사전학습" 의혹으로 또 시끄러웠던 것이다.
수능을 보는데 절반정도 답안이 공개된 시험지로 시험을 본것과 똑같다.
https://t.co/SP9jr5SBuv
[대중에게 "공포"를 주입하는 AI 3대 기업 CEO들]
현재 프론티어 AI들은 "자아"를 가지고 있는게 아니다. 말을 너무 잘 만들어내서 "자아"를 가지고 있는것 처럼 보일 뿐이다.
버리의 말처럼 대중에게 "공포"를 주입해서 자신들이 만들어낸 앵무새를 신격화하고 있다.
https://t.co/qW0DJbvjFN
[프론티어 AI 개발을 위한 4.7조 출자 가능해?]
① 5조 이상되는 쌩돈을 출자할 기업이 있는지도 의문이고
② 매출도 실적도 없는 미래가치만 있는 기업의 전환사채(CB)에 대해 전환가액을 어떻게 정할라고?
③ 그걸 개발한 핵심 인재는 있나?
아무리 봐도 무리수데쓰
https://t.co/k7fLRgabTn
[한국이 AI에 취약한 이유]
알고리즘 코딩은 컴퓨터공학 + 수학 + 데이터공학이 결합된 분야로 컴퓨터 전공자가 새로 공부도 해야하고 원래 돈도 안됬었다.
대부분 한국의 개발자들은 소위 클라이언트 코딩(웹, 앱, DB, 게임 클라이언트 등) 수요가 많아 이쪽으로 진로를 정했다.