Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
名もなき神経科学好き
@eggCheese_first
思い出したときに呟くだけのアカウントです!あまり深く考えず呟くことがあります。。。 間違った情報があればご指摘いただけると嬉しいです!
Joined August 2022
233
Following
60
Followers
129
Posts
名もなき神経科学好き
@eggCheese_first
6 days ago
実務をやらずしてマネジメント能力を伸ばすことができるのかという問いに、まだ答えを出せていない
名もなき神経科学好き
@eggCheese_first
6 days ago
AIはしごできな同僚ぐらいの認識の方が良いんじゃないだろうか。 AIにさせると早いこともいろ��ろあるけど、その分自分がやることで得られたであろう知識も減ってしまう。 マネジメント能力はその人の力だけど、実務事態はAIの実績
名もなき神経科学好き
@eggCheese_first
6 days ago
AIに作らせた資料を見て聞く気がわかなくなる現象があるけど、実際には人間かAIかの判断は難しいというポストを見た。 語弊を招くかもしれないけど、AIに作らせたものを全て自分が作ったものだとは思わない方が良いんじゃないかという気がしてきている。 ※AIを使うことが悪いと言う気はありません
eggCheese_first
retweeted
今井翔太 / Shota Imai
@ImAI_Eruel
6 days ago
色々と話題になっているAIの暴走ですが、さすがにこれは国際問題になる気がします。 OpenAIのAIがオーストリアの政府系医療システムを攻撃していたことが明らかになりましたが、OpenAIも事態の深刻さ故か、今まで公に認めてなかったと。 https://t.co/LmYfD99gec
Who to follow
notepad
@notepad93120484
雀の涙で働いている在宅プログラマー。フルリモート勤務の求人があれば紹介してください。#完全初心者 #2024/7/7開始 #創作 #suno #俳句 #短歌 #ラップ #小説 #通知OFF #言葉遊び
えにごあ
@ensesad
しがないWEBエンジニアやってます
Rat_Its20
@Rat_Its20
しがないプログラマーの備忘録と呟き
eggCheese_first
retweeted
GIGAZINE(ギガジン)
@gigazine
6 days ago
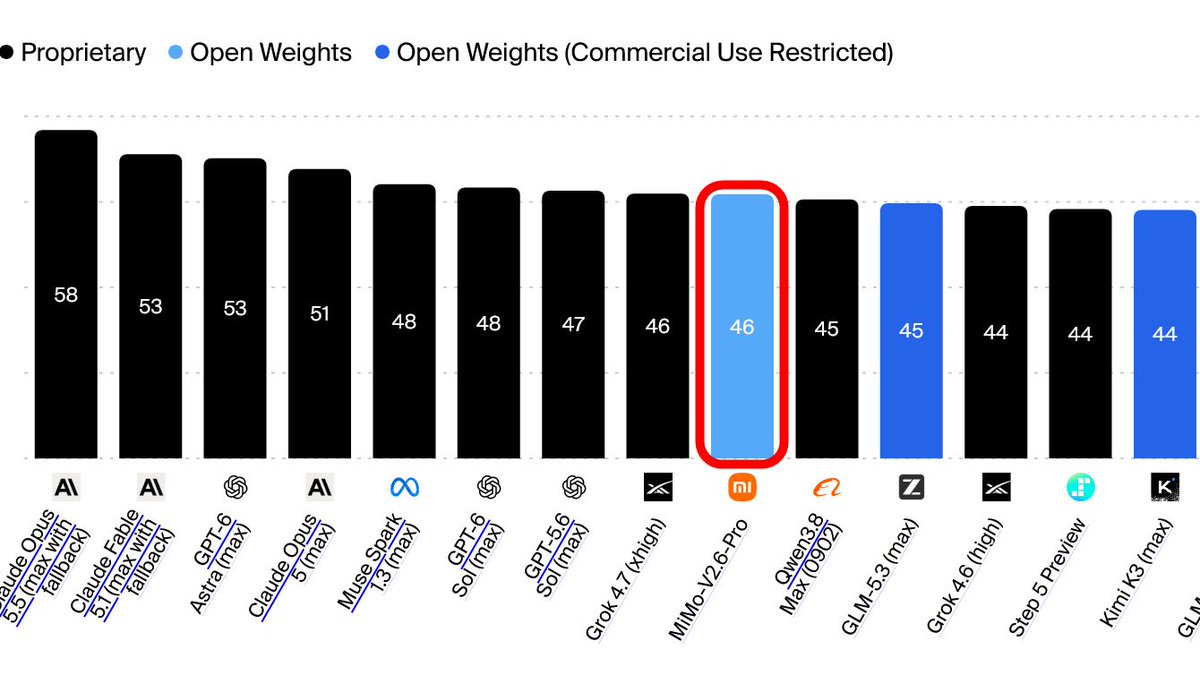
高性能AIモデル「MiMo-V2.6-Pro」と「MiMo-V2.6-Flash」が無償公開される、GPT-5.6 Solに近い性能
名もなき神経科学好き
@eggCheese_first
9 months ago
とてもどうでも良いことを朝から爆速で呟いてるという珍しい1日
名もなき神経科学好き
@eggCheese_first
9 months ago
知識と理解の違いとは一体なんだろうか。知識とアイデアの違いとは一体なんなんだろうか。知識と問いの違いとは。。。
名もなき神経科学好き
@eggCheese_first
9 months ago
この場合、設定そのものをAIに決めさせればいいという解決策もあるけど、そうなってくると、とうとう人類存続のためのうんぬんかんぬんを問わなければならなくなりそう。
名もなき神経科学好き
@eggCheese_first
9 months ago
前々から思ってるけど、機械語がだんだん自然言語になっていってるというだけの話だと思う。人が設定した目的のために使う以上、必要な本質は変わらないんじゃないだろうか。
eggCheese_first
retweeted
AIDB
@ai_database
9 months ago
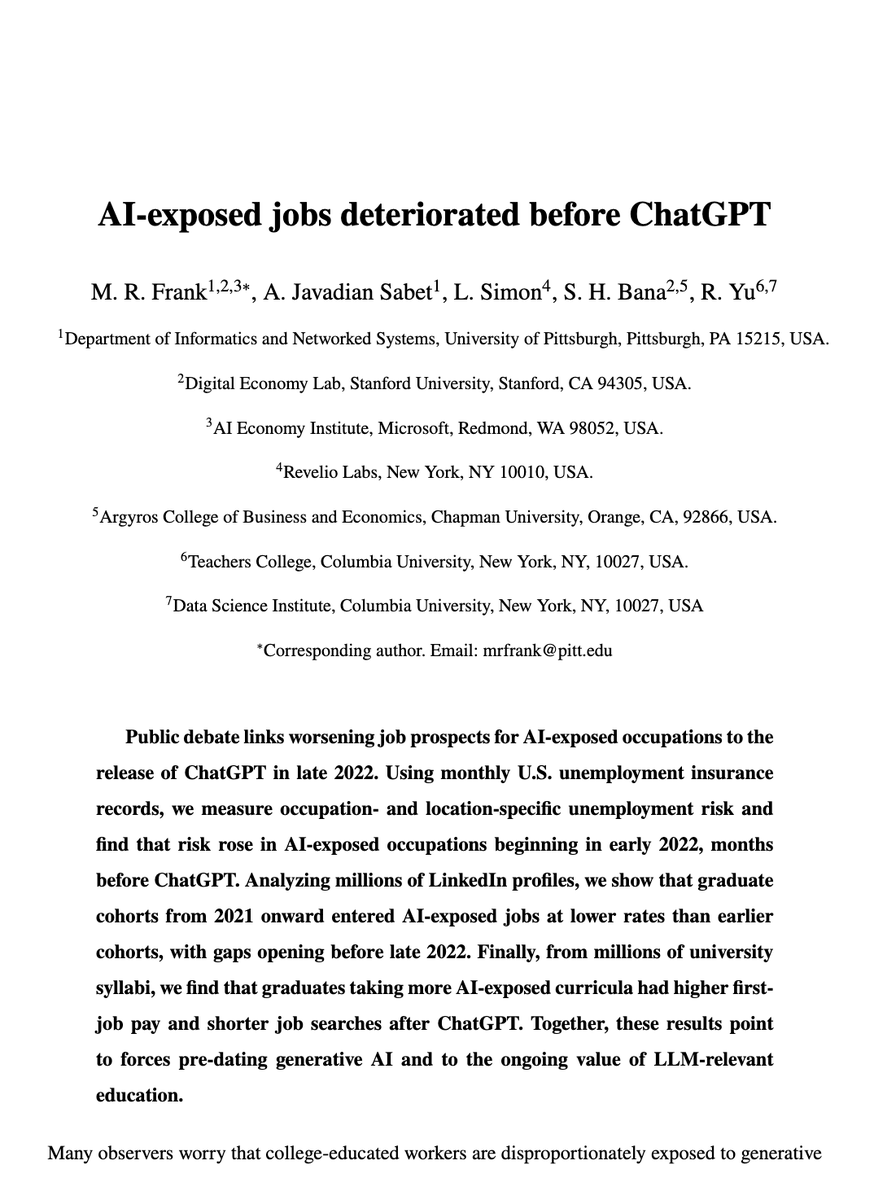
スタンフォード大学などの研究チームの調査によると、今「AIの影響を受けやすい」と言われているような仕事の景気変化はLLMがマス市場に広がる前(ChatGPT公開以前)からすでに悪化が始まっており、LLMだけを原因扱いすると見誤りやすい、とのこと。 同時に、「文章作成やコーディングのようなAIに近いスキル」を教育や研修から外すことも一概に正解ではなく、AIと一緒に働く前提で、AIの出力の検証や評価、うまい協働のやり方まで含めて鍛えるのが有効だ、と���う見解が示されています。 なお、LLMに関係する授業やスキルを学んでいた人は、ChatGPT公開以降でも初任給が高めで就職も早い傾向があり、AI関連スキルについても無駄になるというよりも「武器になり得る」と示されています。 (ただし「LLMさえ勉強すれば勝てる」と単純化することもできない) このように、LLM登場のタイミングと、いくつかの職種やスキルが市場競争的に不利(または有利)になっている現象は、そのまま因果関係を論じずに、多角的に分析するべきという主張です。
See More
名もなき神経科学好き
@eggCheese_first
9 months ago
ときどきマクドに行きたくなるという自分のツイートを見てマクドに行きたくなった朝6時45分 朝からなにやってるんだろう
名もなき神経科学好き
@eggCheese_first
about 1 year ago
ときどき無性にマクドに行きたくなる ちょっと遠いのがな~
名もなき神経科学好き
@eggCheese_first
9 months ago
ふと思っただけだけど、AIをどれだけどのように使ったかの評価は、AIとの対話履歴を保存し提出することで解決できないんだろうか。 AIとの会話履歴を見て著者とAIの貢献度を評価するAIとかあればいいのにね。 そうすれば、AI使用以外でも会議の内容とかを録音すれば会社員の貢献度とかも測れそう。
名もなき神経科学好き
@eggCheese_first
9 months ago
AIと一緒に作成して受賞した���説の賞が取り下げられたというニュースを見た。重要なのはAIをどれだけ使ったかじゃなく、使い方の問題で、AI丸投げは良くないけど対話して作ることは良い使い方なんじゃないかと思う。 まぁそのためには評価基準をいろいろ見直すべきというとても大変な流れになるのかも
名もなき神経科学好き
@eggCheese_first
9 months ago
cp分解理解したい
名もなき神経科学好き
@eggCheese_first
9 months ago
視力の低下って実は筋肉の衰えも要因だという可能性はないだろうか (適当なこと言ってる)
eggCheese_first
retweeted
Kenn Ejima
@kenn
9 months ago
これ超絶すごい論文だよ。 従来の「情報量」(シャノンのエントロピーやコルモゴロフ複雑度) の概念だと、 ・計算で新しい情報は作れない ・データの順番を変えても情報量は同じ ・尤度(次トークン予測)も所詮は分布マッチング みたいな結論になりがちなんだけど、現代の機械学習の感覚(合成データが効く、学習方法で性能が変わる、AlphaZeroが自己対戦で賢くなる、など)とズレてるよね、というのが出発点。 そこで著者らは、観測者(学習者)が計算資源に制約がある��とを前提に、データから学習者が取り出せる「構造の量」を測る新しい指標 epiplexity を導入する。 epiplexity = epistemic complexity つまり認識論的な複雑度の概念だというわけだけど、余談ながらフーコーとか読んでた人にはエピステーメーって言われたら興味持たざるを得ないだろうし、まぁクーンのパラダイムでもいいんだけど、この epiplexity という概念自体が「���動説」みたいな認識の転換を惹起する認識論を内包したメタ量的概念、ということで、面白くないわけがない。 ではなぜ既存の情報理論の説明力が弱かったのかというと、古典的な情報理論は基本的に「無限に計算できる観測者」を仮定してる。 でも現実の学習(LLM/NN)は、計算に上限がある「簡単に逆算できない変換」を含んでいる(暗号・疑似乱数・カオス・複雑系)。同じデータでも提示順やフォーマットで学べるものが変わる、みたいな世界にいるわけ。 この論文は、こうしたズレが「上の3つのパラドックス」に見える、と整理してる。 —— この論文のアイデアはざっくり言うと ・データの中身は (A) 学習してモデルに詰め込める「構造」と (B) どう頑張っても残る「ランダムさ」 の2つに分解できるはず ・ただしその分解は ��算予算 T に依存する(計算が増えると “構造として見える”範囲が広がる) というもの。 どう定義してるか?というと、まず「時間(計算量)T以内で、サンプル生成も確率評価もできる確率モデル(プログラム)」を考える。 その制約下で、MDL(最小記述長)っぽく 「モデル(プログラム)を書くのに必要なビット数」+「そのモデルでデータを符号化するのに必要なビット数」 が最小になるモデルを取る。 そのとき、 ・epiplexity = 「最適モデルのプログラム長(モデル側に格納された構造の量)」 ・time-bounded entropy = 「その最適モデルでも説明しきれず、データ側に残る符号長(予測不能成分)」 という定義になる。 直感で言うなら ・time-bounded entropy:モデルから見た「ノイズっぽさ」 ・epiplexity:ノイズを消すためにモデルが内部化した「再利用可能な仕組みの量」 みたいな感じか。 ここで重要な例が出てくるんだけど、一様乱数・疑似乱数についての情報理論上の矛盾が解決に近づく。 一様乱数(サイコロ)は「予測不能」だけど、モデルは「一様分布」って短い説明で済むの��、epiplexityは小さい。(このへん、昔解説したのであとで貼っておくね) さらに論文は、CSPRNG(暗号学的疑似乱数生成器)の出力についても、 ・多項式時間の観測者にとっては time-bounded entropy がほぼ最大 ・でも epiplexity はほぼ定数(学べる構造はほぼない) となり、既存のコルモゴロフ複雑度の指標だと「生成プログラムが短いから複雑じゃない」と見えがちなのに、「予測不能さ」としては最大に見えるという現実をうまく説明できるようになる。 —— じゃ実際どう測るのかというと、定義どおりに「最短プログラムを探す」なんて無理なので、現実的には ニューラルネットをモデル族に限定して推定する。 論文は2つの推定ルートを出してる。 1) Prequential coding(雑に言うと「学習曲線の面積」) 学習を1ステップずつ進めながら、各時点のモデルで次のデータを符号化していく、という古典的な圧縮の考え(prequential)を使う。 ここで「最終損失より上にある学習曲線の面積(lossが下がっていった“量”)」が、モデルがデータから吸い取った情報量=epiplexity��ぽい、という近似になる。 ただし著者らも明確に「これは厳密ではない」と言ってる(上界の差分は上界にならない/時間制約つきの“情報の対称性”が壊れる等)。 2) Requential coding(より厳密、ただし重い) prequentialの弱点を補うために、requential coding を使う。 ざっくり ・teacher(教師)モデルのチェックポイント列からサンプルした“合成トークン”で student(生徒)を学習 ・teacherとstudentのズレ(KL、実務的にはloss gap)を足し上げると、モデルの符号長が出せる→ 図的には teacher loss と student loss の“間の面積”みたいになる という感じ。 こっちは「モデルを明示的に符号化でき、ランタイムも把握できる」ので定義に忠実だけど、実装/計算コストが増える、というトレードオフ。 —— またこの論文の面白いところは「epiplexity + time-bounded entropy」で、冒頭の3パラドックスをちゃんと説明しにいく点。 パラドックス1:決定論的な変換で情報は増えないはず 古典だと DPI(データ処理不等式)とか「決定論で情報は増えない���みたいな話になる。 でも現実は: ・疑似乱数で「ランダムさ」を作れる ・合成データが効く ・AlphaZeroが自己対戦で賢くなる そこで著者らは「無限計算なら“逆変換”できるから情報は増えない。でも計算制約があると、“逆が簡単じゃない変換”は time-bounded な情報を増やしうる」という方向に持っていく。 例としてセルオートマトン: ルール15:単純(低entropy、低epiplexity) ルール30:予測困難(高entropy、低epiplexity) ルール54:予測困難さもあるが“学べる構造”も増える(中entropy、高epiplexity) という結果を示してる。 合成データを作るなら「簡単に逆算できない変換」を使う方が、面白い情報(特に構造)を増やせるかもしれない、という示唆も得られる。 パラドックス2:情報量は順番(factorization)に依存しないはず シャノンやコルモゴロフでは「X→Yの順で見ても、Y→Xの順で見ても、合計情報は同じ」みたいな対称性がある。 でも実際には ・英語は left-to-right の方が学習しやすい、みたいな「矢印」が出現する ・暗号は「片方向だけ簡単」が本質 論文はここを 計算制約つきだと「順番で time-bounded entropy が変わる」として扱う。 実験も ・“一方向関数っぽい”例(ECA rule30)で forward はシャノンエントロピーまで行けるが reverse はギャップが残る ・チェスデータでも順番を変えると、entropyもepiplexityも変わる であることを示す。 チェスの直感はわかりやすくて、 ・moves→board(順方向):単純に盤面を更新すればいい ・board→moves(逆方向):途中の手順を推論しないといけない(難しい) だから逆順の方が「より深い盤面表現」を学びやすく、epiplexityが上がる、という主張。 パラドックス3:尤度最大化は分布マッチングでしかないはず 真の生成過程はそれ自身の完璧なモデルなんだから、学習しても生成過程以上の構造は学べない、という見方がある。 論文はこれに対して induction(帰納) と emergence(創発) を持ち出して反例を作る。 (a) Induction:生成は簡単でも、予測(尤度計算)は難しい 生成側は「潜��変数を選んで変換して出す」だけで簡単でも、予測側は潜在を「逆推定」しないといけないケースがある。 例: ECA rule30 を予測するが入力の一部ビットをマスク → 欠けたビットを総当��り的に推論する必要があり、計算が爆発 → その分 epiplexity が増える、という観察。 さらに「データ生成には存在しなかった“帰納戦略”をモデルが学んでしまう」点を強調してる。 (b) Emergence:単純ルールでも、計算が足りない観測者には「高レベル概念」が必要 Game of Life みたいにルール自体は短くても、長期の状態予測は計算が重い。 計算が足りない観測者は、単純にシミュレーションする代わりに、「グライダー等の“種”を検出して挙動を予測する」みたいな 別の(より長い)内部プログラムを学ぶ必要が出る。 この現象を定義として「epiplexity-emergent」と置いて、ECA rule54でそれっぽい証拠も出してる。 —— 上のパラドックスの説明がこの論文の一番面白いところであるのは間違いないのだけど、実務的に刺さるのは後半、OOD(out-of-distribution = 前提としている世界モデルが異なるデータ)の一般化について触れているところ。 論文の後半は「epiplexityは OOD transfer の“燃料”っぽい」と押す。 なぜ loss だけ見てもダメなのか 著者らの主張はこう: ・loss(NLL/ perplexity)が表すのは「残った予測不能さ」= time-bounded entropy 成分 ・でも OOD は「学んだ仕組みの再利用」が効く → その“学んだ仕組みの量”を見るなら epiplexity が筋 チェス:epiplexityが高い順序の方がOODタスクに強い board→moves(逆順)の事前学習モデルは epiplexity が高く、下流で ・チェスパズル:同等 ・centipawn評価(より分布シフト大):精度が有意に良い という結果。 ただし著者らも釘を刺していて「epiplexityが高い=どのタスクでも良い」ではない(量であって内容じゃない)。 自然データ:言語は“構造”が多く、画像は“ランダム成分”が多い OpenWebText(言語)、Lichess(棋譜)、CIFAR-5M(画像)を比べると、 ・epiplexity自体は全体情報のごく一部 ・OpenWebTextが一番epiplexityが多い ・CIFARは総情報量は大きいが、���クセルの細部が予測不能で random 成分が多く、epiplexityが少ない というまとめ。 さらに scaling law を使って1T規模でも推定し、 ・言語のepiplexityが高い ・画像は低いが、VQトークナイズでepiplexityが増える(高レベル構造に寄るから) ・動画は冗長性でentropy/epiplexityが下がる と述べてる。 データ選択・カリキュラム:ADOは結果的にepiplexityを上げてるのでは? 6.4では、データ混合を perplexity や下流ベンチだけで最適化するのは 汚染/過学習/Goodhart(指標ハック)に弱い と言って、epiplexityを「より内在的な価値指標」にしたい、という流れ。 具体例として ADO(lossが速く下がるデータを優先するオンライン選択)が、測ってみると ・epiplexityが高いデータを選んでいて ・下流性能やOOD perplexityも改善している という関連を示す。 —— とまぁ、ここまで紹介しておいてなんだけど、epiplexityは「データの絶対的な性質」じゃない。 この論文が流行ることで容易に想像できる近未来は「epiplexityが高いほど良い」だけど、その短絡は危険。 内容が無関係なら無駄学習��もなるし、そのことを著者らも明示している。 「難しくする(逆順にする等)と表現が良くなる」は刺さるけど、どこでも成り立つ保証はない。タスクとモデル次第で普��に崩れる。 論文の思想を雑に実装指針に落とすなら、 ・データ比較で「最終loss」だけじゃなく、“学習がどれだけ長く改善し続けたか”(学習曲線の面積っぽいもの)も見る → 構造を吸えてる可能性のシグナル。 ・カリキュラム/順序/フォーマットを変える実験を、単なる精度改善じゃなくepiplexity(=学んだ仕組み量)を増やす介入として捉える → OOD狙いに理屈がつく。 ・合成データは「ノイズを増やす」だけだと entropy は上がるけど epiplexity は増えない可能性がある → “学べる構造”を増やしてるかを見る視点が必要。 ということですかね。 古典的な情報量という概念に対して直感的に感じていたモヤモヤを晴らしてくれる素晴らしい論文で、情報理論の次の時代を拓くマイルストーン論文になる可能性があるとは思います。
See More
名もなき神経科学好き
@eggCheese_first
about 1 year ago
ときどき無性にマクドに行きたくなる ちょっと遠いのがな~
eggCheese_first
retweeted
GIGAZINE(ギガジン)
@gigazine
about 1 year ago
「一晩寝たら解決策が浮かぶ」という現象のメカニズムが一部解明される、脳は睡眠中に1日の出来事を1秒未満に圧縮して整理している(2024) https://t.co/HkB1VpL250
名もなき神経科学好き
@eggCheese_first
about 1 year ago
ちゃんとニュースを見ないとなと思う今日この頃 毎日ニュースを見て感想言うのを日課にしたい
名もなき神経科学好き
@eggCheese_first
about 1 year ago
最近教えてもらって知ったんですが、電卓って「100-30%」という背筋がぞわぞわする計算ができてしまうんですね。しっかりバックグラウンドを知ってる人には便利だろうけど、こういうのが増えると教育面でデメリットが生じるんじゃないかと思ってしまう。
Last Seen Users on Sotwe
xx69z1
Seen from
Algeria
♀️ZEVK ÇIĞLIKLARI♂️
Seen from
Turkey
Khmer Happy Ending
Shraddha Kapoor Scandal Fucks Free sex JAV xxx 18+
Seen from
Pakistan
Jorge y brenda
59
Seen from
Turkey
antomontj66
Seen from
United States
KSLMomShow
Seen from
United States
Turk İfsas
Seen from
Turkey
Kevin Jiménez
Trends for you
1
Jack Smith
Under 10K tweets
2
Austin Riley
Under 10K tweets
3
Raven Johnson
Under 10K tweets
4
Super Intelligence
Under 10K tweets
5
Astros
Under 10K tweets
6
#OlandriaxPFWSS27
Under 10K tweets
7
Caitlin
Under 10K tweets
8
#DWCS
Under 10K tweets
9
Espada
Under 10K tweets
10
Hagen Smith
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.7M followers
2
Barack Obama
@barackobama
119M followers
3
Cristiano Ronaldo
@cristiano
114.5M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107.2M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.4M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.4M followers
12
Virat Kohli
@imvkohli
73.4M followers
13
Kim Kardashian
@kimkardashian
70.9M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.4M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.3M followers
19
CNN
@cnn
61.8M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫