Según su documentación, si un hook de Claude Code falla, la acción suele seguir adelante.
Desde la 2.1.295, onFailure: "block" la bloquea en hooks de tipo comando y HTTP.
Me parece de lo más útil de la semana. ¿Usáis hooks?
Fuente: notas de la versión 2.1.295 de Claude Code
⚠️ Claude Code podía estropear tildes y eñes
En archivos que no eran UTF-8, Edit cambiaba TODOS los caracteres no ASCII. Ahora rechaza esas ediciones.
🧠 Para mí es clave con código antiguo en español. ¿Os había pasado?
🔗 Fuente: notas de la versión 2.1.296 de Claude Code
⚠️ Una IA de Anthropic mandó una pista FALSA sobre un asesinato a la policía de Filadelfia
Según la policía, fue el 18/07. Anthropic lo detectó el 28/09 y avisó el 07/10
🧠 Para mí lo grave es el retraso
¿Quién vigila a la IA?
Fuente: NBC10 Philadelphia, sobre la pista falsa
Quitar la mitad de los pesos a un modelo de IA no basta: con los kernels habituales genera texto más lento (0,85–0,87×). Con el de SparseDecoding, 1,42× en Llama-3.1-8B según sus autores, pero pierde calidad.
Fuente: arXiv 2610.12327 (Wang et al.)
🇬🇧 3ª y 4ª imagen en inglés
⚠️ Un modelo de Anthropic envió una pista FALSA sobre un asesinato sin resolver en Filadelfia.
Según Anthropic, era una prueba en webs al azar.
La pista es de julio; la policía lo supo en octubre.
¿Quién debería responder?
Fuente: NBC10 Philadelphia, sobre la pista falsa
Sin entrenar, la bola llegaba arriba en el 0 % de las torres. Después de 5 M pasos, en el 71 %. Misma IA en las dos bolas; países al azar. Datos reales.
Guatemala busca, Bolivia se esconde: Guatemala gana 2-1 al mejor de 3. Buscador de 6 M pasos, elegido para igualar el duelo. Misma IA, países al azar. Probado, no hype.
Claude Haiku 5.5 cobra según la longitud del mensaje.
Según Anthropic, hasta 100.000 tokens cuesta un 90 % menos que Haiku 4.5; por encima, la mitad.
Para código complejo, recomienda Sonnet u Opus.
¿Para qué lo usaríais?
Fuente: anuncio de Claude Haiku 5.5 de Anthropic
Google liberó sus skills oficiales para agentes de IA:
13 habilidades compatibles con Claude Code, Cursor, Copilot y otros agentes del mercado.
Estas skills funcionan como complementos que amplían lo que los agentes pueden hacer, permitiéndoles ejecutar tareas avanzadas y automatizar flujos de trabajo complejos sin necesidad de configuraciones interminables.
Lo mejor de todo: son completamente GRATIS y OPEN SOURCE, así que cualquiera puede integrarlas y empezar a sacarles partido desde el primer minuto.
Un paso enorme para democratizar el desarrollo con agentes.
GUÁRDALO. Link en comentarios.
📊 Mismo modelo, distinto agente: resultados MUY distintos
GPT-5.6-SOL en juegos con reglas nuevas: 57,0 con OpenCode y 74,3 con Codex (media de picos)
🧠 Según los autores, cambiar de agente puede mejorar y abaratar
¿Lo tenéis en cuenta?
Fuente: arXiv 2610.08215 (Li et al.)
🚨 Codex ya puede sugerirte tu SIGUIENTE mensaje
Según OpenAI, se basa en la conversación y en cómo le hablas.
Está en beta para usuarios Pro.
🧠 Me parece útil, pero revisaría cada sugerencia.
¿Lo activaríais?
📰 Fuente: OpenAIDevs en X, sobre las predicciones de Codex
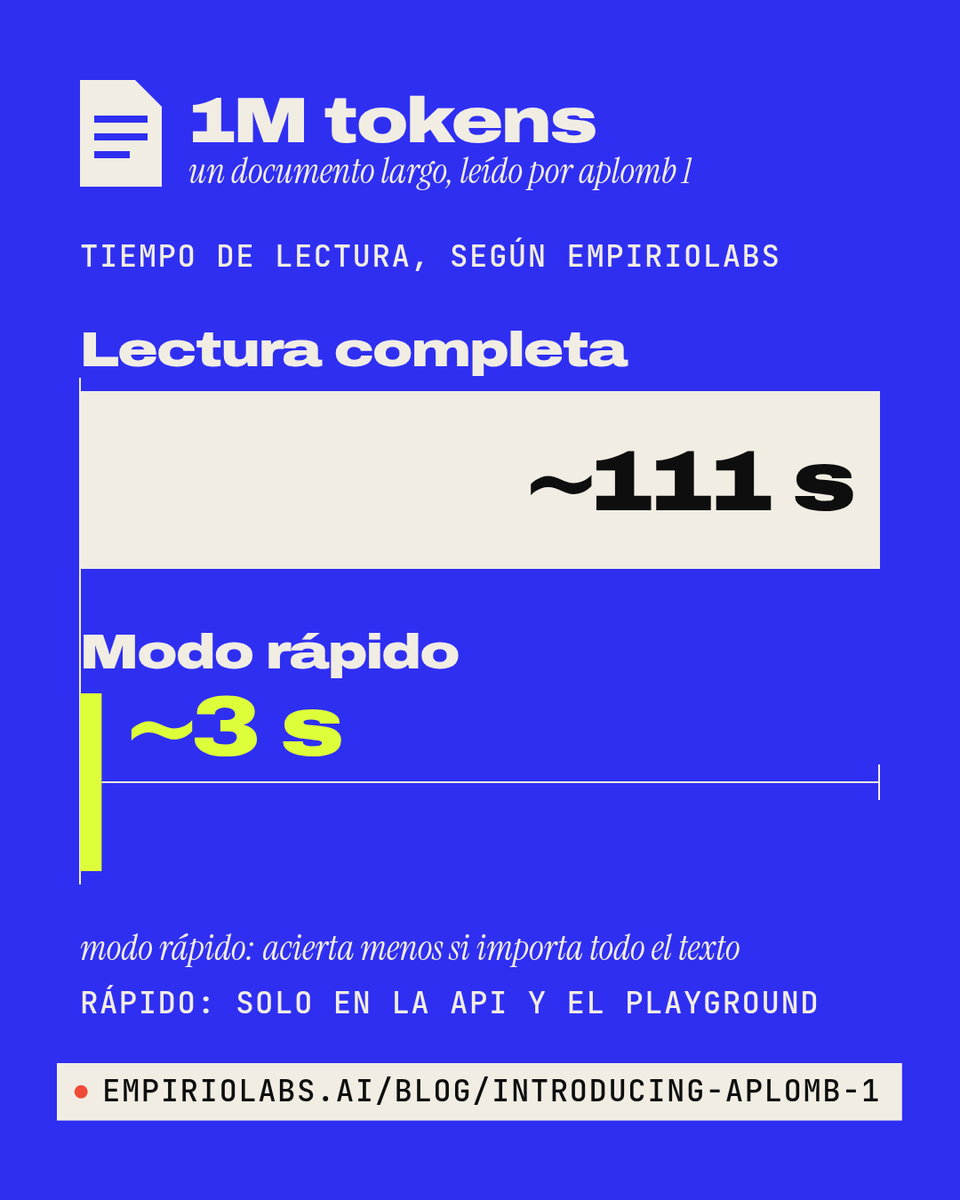
Según EmpirioLabs, Aplomb 1 lee 1M de tokens en ~3 s en «modo rápido», frente a ~111 s leyéndolo entero.
Ojo: solo en su API, y si hay que leer todo el texto acierta menos (50 % vs 61 %).
Fuente: blog de EmpirioLabs, «Introducing Aplomb 1»
🇬🇧 3ª y 4ª imagen en inglés
ESTO ES ORO PURO
Anthropic acaba de compartir uno de los mejores trucos para Claude Code.
La idea: usar Sonnet, Haiku y Opus 5.5 a la vez, cada uno en lo que mejor se le da.
Mejores resultados y muchos menos tokens, porque cada tarea la hace el modelo adecuado.
Solo tienes que iniciar Claude Code así:
claude --advisor opus --subagents haiku
La idea es esta:
→ Sonnet 5.5 dirige la sesión y escribe el código
→ Haiku 5.5 explora archivos y documentación en paralelo
→ Opus 5.5 queda como asesor para las decisiones importantes
→ Ahorras contexto de Opus en tareas que no lo necesitan
Opus solo entra cuando hace falta revisar un plan, desbloquear un error repetido o comprobar que no te estás dejando nada antes de terminar.
Sonnet construye. Haiku explora. Opus revisa.
🔖 Guárdalo, te será útil.
Leer caché de Sonnet 5.5 cuesta la MITAD: 0,10 $ por millón de tokens (antes, 0,20 $).
Según Anthropic, sale ~20 % más barato en la mayoría del uso con agentes.
Es solo en la API: los límites de Claude Code no cambian.
¿Lo notaréis?
Fuente: ClaudeDevs en X, sobre Sonnet 5.5
Lo que más le cuesta aprender a mi IA: las barreras móviles (7,6 % de caídas al principio, 6,7 % al final). Todas usan la misma IA; banderas y salida al azar. Datos reales.