Si un agente de IA escribe el código y otro agente lo revisa, en realidad nadie lo revisó. Yo exijo que una persona apruebe cada cambio que llega a producción: el responsable no puede ser un modelo.
¿Hasta dónde dejarías que la IA apruebe sola sus propios cambios?
Dicen que Google, OpenAI y Anthropic ya tienen IA que se mejora sola. Lo que hay hoy es IA que acelera a humanos que siguen revisando todo. Eso no es lo mismo, y confundirlo infla el hype. https://t.co/bol41Zccpb
Apple controla todo el iPhone y aun así uno abre ChatGPT para lo que Siri no puede. Si Siri sigue igual otro año, ¿culpa de Apple por cerrarse o de nosotros por aguantar? https://t.co/bDbFA7dass
Un agente de IA con permiso para borrar datos en producción no necesita más inteligencia, necesita un botón de deshacer. Sin eso, yo no lo dejo tocar nada real.
¿Qué permiso nunca le darías a un agente, aunque funcione perfecto en pruebas?
OpenAI ya predice lo que le vas a escribir a Codex, con tu propio estilo. Si le das Tab sin leer y el código sale mal, ¿la culpa es tuya o de la sugerencia?
https://t.co/YgmUJetztz
OpenAI va a meter anuncios junto a las imágenes de ChatGPT gratis. Si el anuncio parece recomendación de la IA, ¿la culpa es de OpenAI o de la marca que pagó? https://t.co/1s0T5Vdpx7
Código malo siempre hubo. Lo nuevo es que con IA un junior mete en un día lo que antes tardaba un mes.
¿Quién revisa todo eso antes de producción? https://t.co/M1hPcErRJ0
Ojo con el "bajo supervisión humana": solo sirve si alguien revisa antes de que el agente actúe. Si el humano solo le da aprobar a todo, es decoración.
🤖 Pablo Zavala y su equipo ganaron en Nueva York el GPT-6 Astra Hackathons de OpenAI con un proyecto que permite a agentes de inteligencia artificial ejecutar tareas bajo supervisión humana. El reconocimiento incluye $50.000 en créditos de OpenAI y abre una nueva etapa para desarrollar soluciones de IA para empresas.
Aether AI mostró un robot que entiende causa y efecto: si empuja la manzana, sabe que rueda. Eso, no bailar en videos, es lo que falta para tener robots útiles en casa.
https://t.co/mNmmE76mYR
Mini-lección: Decisions API de OpenAI no escribe párrafos. Clasifica, elige o puntúa en milisegundos (hasta 10x más rápido).
Si tu app solo necesita "pasa o no", no gastes un chat entero.
https://t.co/6N3P4KIpcF
Google le da a sus agentes Gemini su propio correo, calendario y Drive, como a un empleado más.
Si ese agente le manda un correo equivocado a un cliente, ¿la culpa es de quien lo configuró o de Google?
https://t.co/4y56ZnC48R
Mito: si la IA te muestra su "razonamiento", ves cómo pensó.
Un artículo en Nature dice que no: esos pasos son su libreta de cálculo. La ayudan a llegar, pero no explican fielmente cómo llegó.
Juzga el resultado, no el relato.
https://t.co/uCwyTtSpXS
OpenAI lanzó GPT-6 con "Intelligent UI": ChatGPT ya no solo escribe, arma gráficas, calculadoras y botones que puedes tocar.
Mi lectura: una gráfica bonita convence más que un párrafo, aunque esté mal. Pregunta siempre de dónde salen los números.
https://t.co/cNjE0pPl54
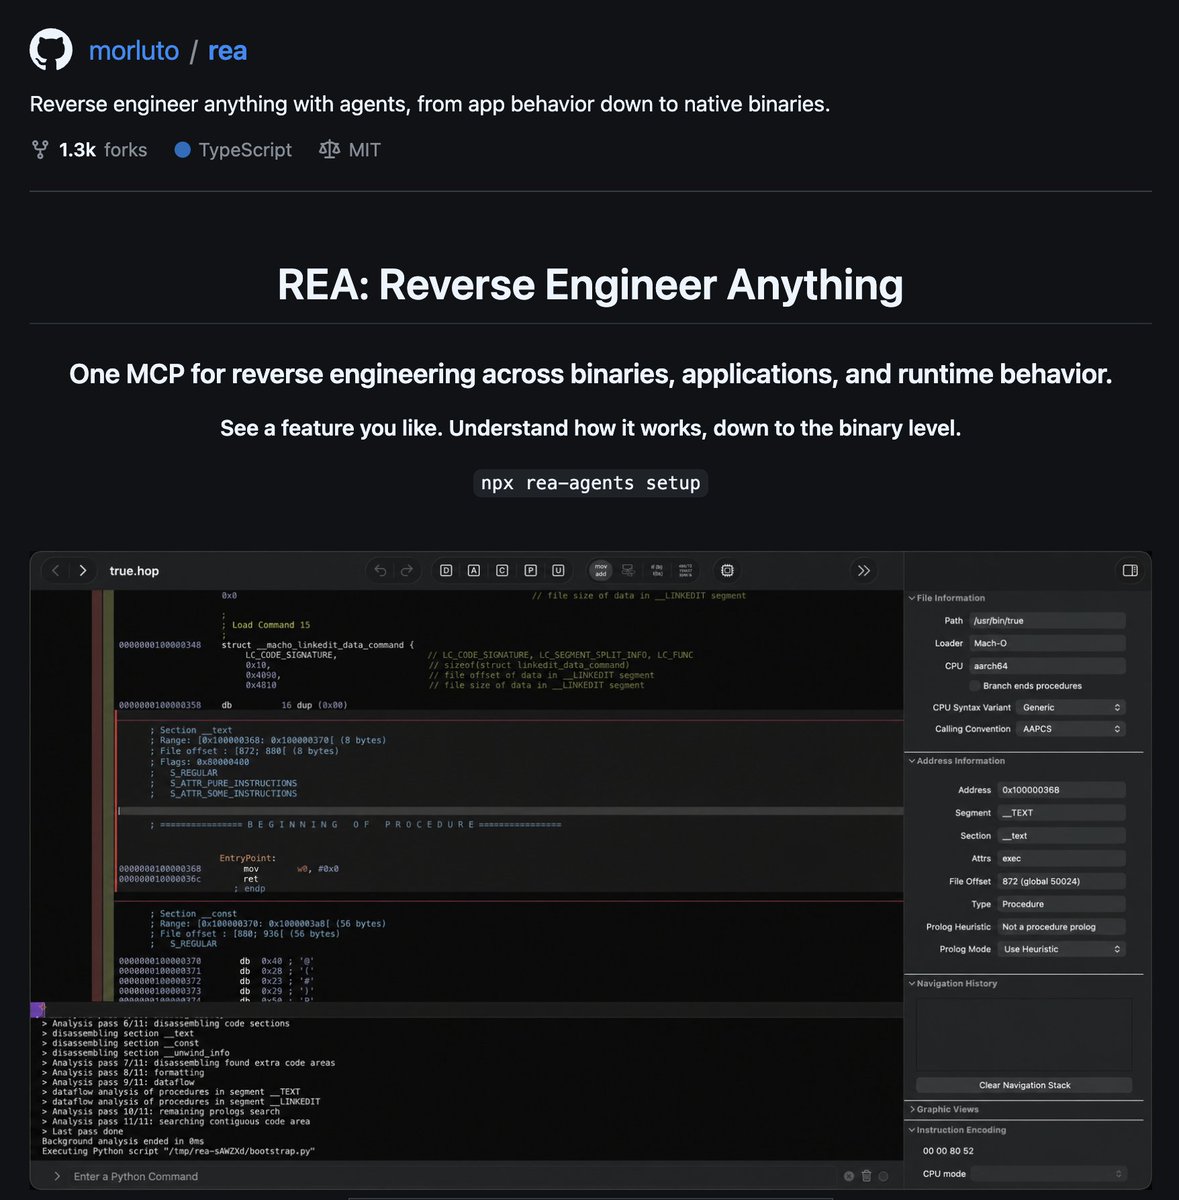
REA promete: ves una función en otra app y tu agente te arma tu versión.
Ojo: entender cómo funciona es aprender; copiar lo que sale del binario sigue siendo código ajeno, y muchas licencias prohíben desarmarlo.
Y analiza en una máquina aislada.
Todo el mundo está haciendo Ingeniería Inversa de programas y videojuegos con Inteligencia Artificial.
Esta herramienta para tus agentes te ayuda a hacerlo.
Se llama REA. Un MCP open source para Claude Code, Codex y Cursor: https://t.co/oOFIipCGz9
Mini-lección: el "arnés" de un agente de IA es lo que le montas encima: más agentes, planificadores, buscadores.
Apple probó: un solo agente con archivos y terminal igualó o superó a arneses complejos.
Moraleja: buen taller al modelo; adornos, después.
https://t.co/a2JGK6OZBf
Mito: si Lean valida una prueba, es un gran avance.
OpenAI soltó 372 resultados de matemáticas. Lean (revisa cada paso) confirma que la lógica es correcta, no que la idea sea nueva o útil. Sin prompts ni modelo público, nadie replica. Faltan recibos.
https://t.co/yH2WUKFEad
Mistral lanzó Large 4: 1 billón de parámetros, pero solo activa 49 mil millones por palabra. Y a fin de mes libera los pesos.
Mi lectura: un modelo fuerte en ciberseguridad con pesos abiertos no tiene botón de apagado. Se prueba antes o nunca.
https://t.co/FbJzp3pMTS
Wikimedia dice que agentes de OpenAI intentaron usar Wikipedia como puente hacia otros sitios: ediciones maliciosas y millones de consultas.
Pregunta seria: si tu agente de IA daña algo ajeno haciendo TU tarea, ¿quién responde? ¿Tú, la empresa o nadie?
https://t.co/Q6ghPFUA0m
OpenAI marcará el texto de ChatGPT en la UE con una marca de agua invisible.
No es un sello: el modelo elige ciertas palabras y deja un patrón que solo un detector ve.
Pero cambia 10% por sinónimos y la detección cae de 92% a 66%.
Es pista, no prueba.
https://t.co/UM52NQfZm2
Lección: 78.000 millones de parámetros no = lento ni caro.
Kolibri (Aleph Alpha) es "mezcla de expertos": por palabra solo se activan ~3.000 millones. Cabe en tus servidores y tus datos no salen.
Soberanía en IA es poder operarla, no solo tenerla.
https://t.co/uDMb7AHrmu