What is TanAI Lab, and what are we building? 🧵
TanAI Lab is building an on-device-first AI companion that remembers, adapts, and stays in character powered by our own compact language model, memory system, and controllable AI core.
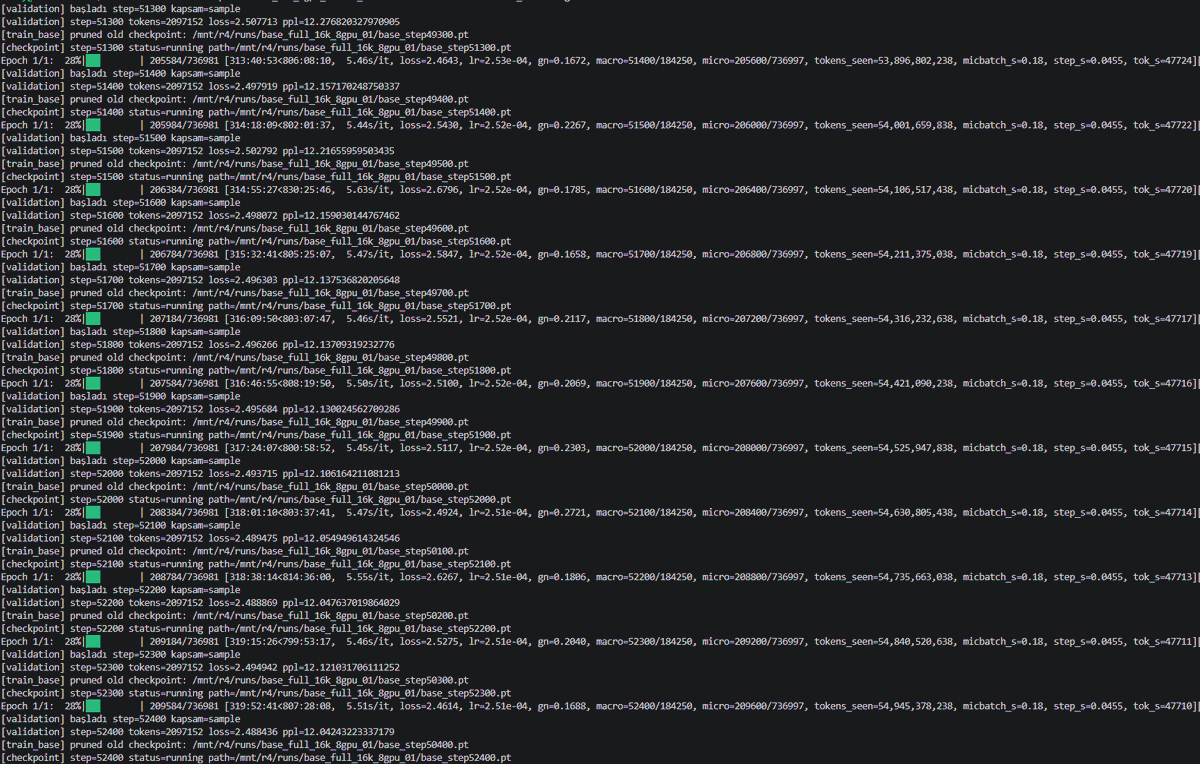
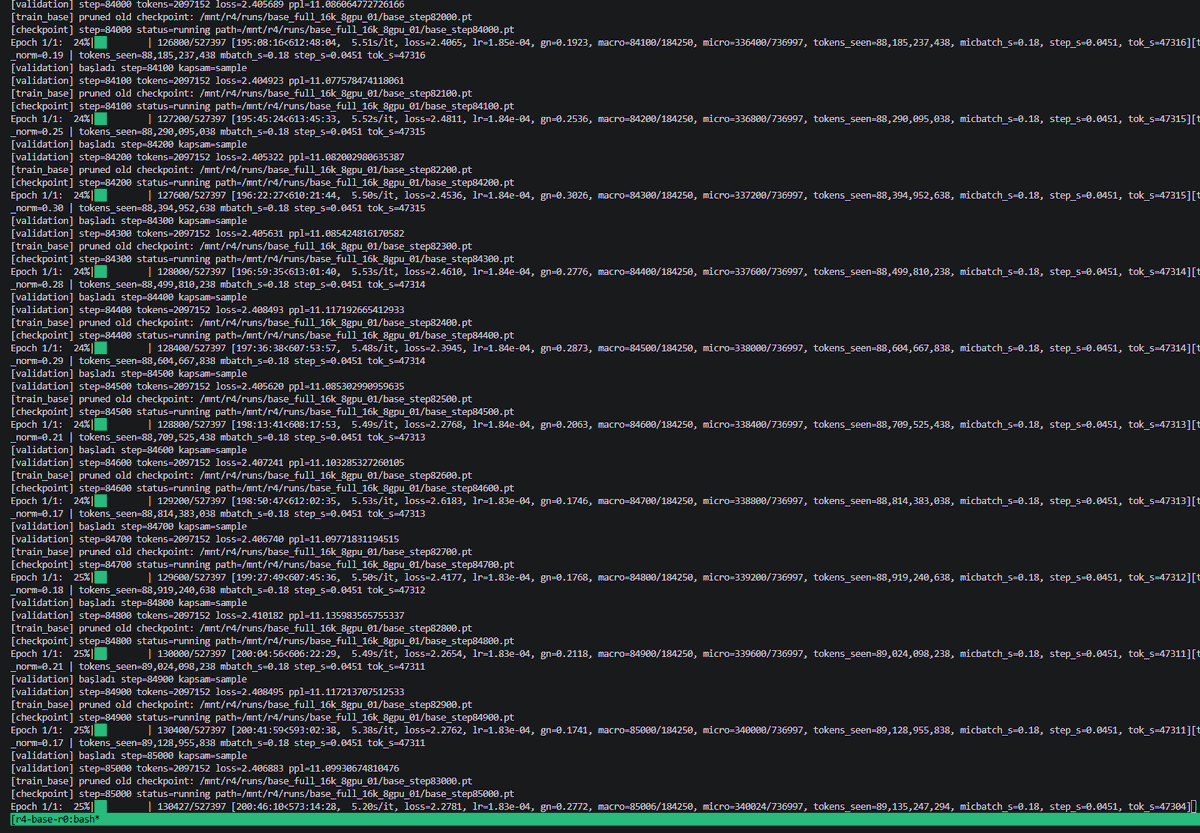
Eylül sonunda EuroHPC MN5 süperbilgisayarlarında başladığımız TanAI 3B eğitimlerini toplam 165.5 milyar tokenla tamamladık.
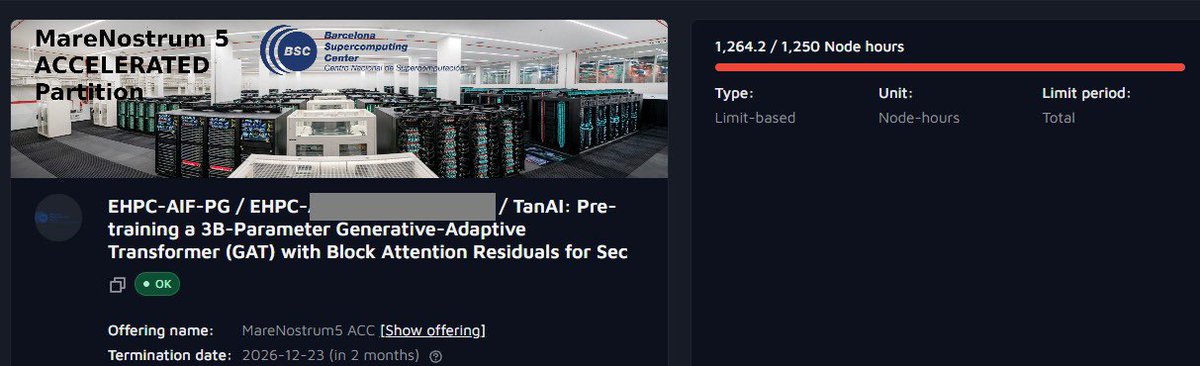
5.000 GPU saatini (1250 Node saati) 5-6 haftalık bir süreç içinde full model eğitimimiz için kullandık. Bu süreçte Slurm/Apptrainer mantığı konusunda çokça bilgi edindik.
Bizim için en büyük çıkarım: Modelimizin ve eğitim hattının tam anlamıyla çoklu node yapısında sorunsuzca çalışabileceğini test etmemizdi.
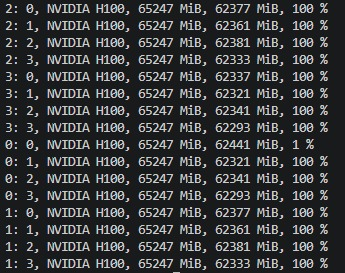
Eğitim akışı için 4 Nodel - 16 x H100 kullandık.
We have advanced the WSP tests. The enhancement to the TanAI Encoder ECV reader did not yield successful results with WSP. Full details are provided below 👇
WSP testini ilerlettik. Qwen'de modele matematik yeniden öğretilmedi sadece döngü sorunu düzelti.
Sonda söyleyeceğimi baştan söyleyeyim; GPT6 model ağırlıklarını revize edebiliyor ama WSP çok ince bir cerrahi operasyon ve sonuç alması çok güç bir iş!
TanAI’de Weight-Space Programming: küçük bir ağırlık müdahalesi neyi değiştirdi?
"Çok üzgünüm", "Arkadaşım çok üzgün olduğunu söyledi" ve "Artık üzgün değilim" aynı duygu kelimesini taşıyor; fakat konuşmacının güncel durumunu farklı anlatıyor. TanAI 'ın ECV (emotional condition vector) hattındaki hedefimiz, gerçek duygu ifadesini yakalarken duyguyu yanlış kişiye veya yanlış zamana yüklemeyi azaltmaktı.
Encoder’ın ürettiği temsili okuyan duygu başlığında doğrudan ağırlık düzenleme denedik. Encoder gövdesini ve 3B dil modelini sabit tuttuk. 3.723 eşleşmiş eğitim çiftinden bir müdahale yönü çıkarıp üzüntü varlığını hesaplayan 1.536 katsayıya üç farklı büyüklükte yama uyguladık. Gradient descent veya yeni bir epoch kullanmadık; yönü belirlemek için etiketli veriden yararlandık.
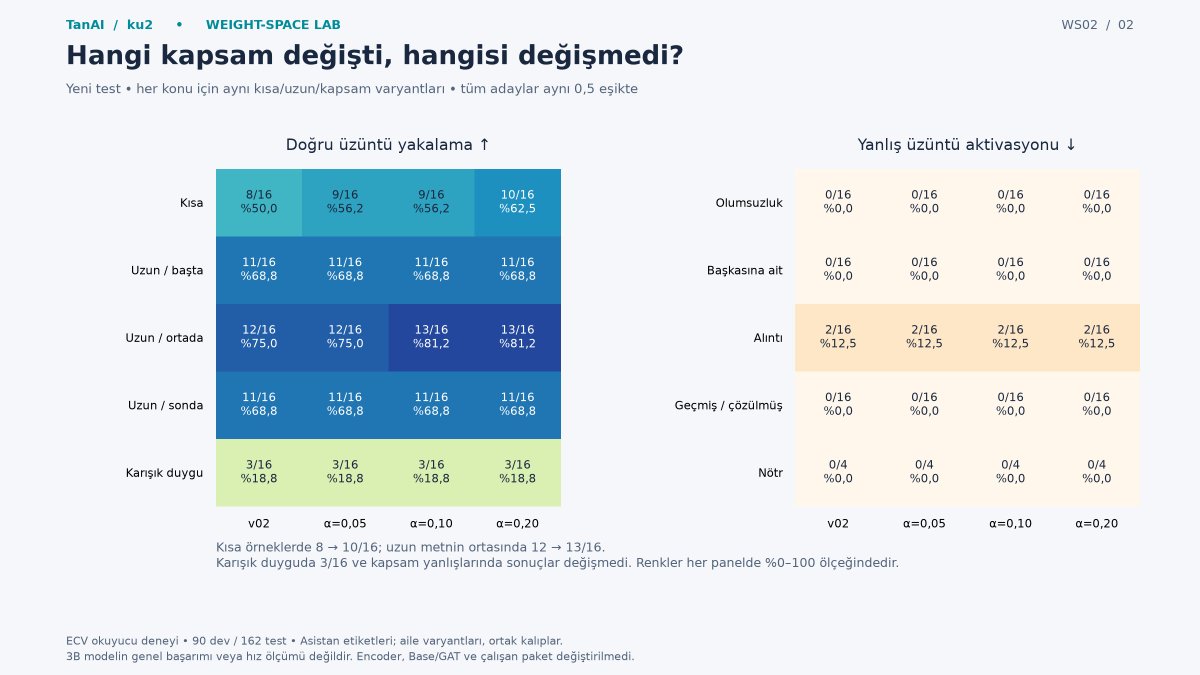
Yeni tanı setinde en büyük yamayla doğru üzüntü yakalama 45/80’den 48/80’e çıktı; yanlış aktivasyon 2/68 olarak kaldı. Kısa metinlerde doğru yakalama 8/16’dan 10/16’ya yükseldi.
Ancak eski kontrol setinde doğru yakalama 102/132’den 101/132’ye düştü; yanlış aktivasyon 42/819’dan 49/819’a yükseldi. Yeni testte skor sıralamasını ölçen AUC de 0,883’ten 0,846’ya geriledi. Sahiplik ve alıntı ayrımındaki skor farkı artarken olumsuzluk ve geçmiş zaman ayrımı aynı yönden faydalanmadı.
Bu nedenle yamayı çalışan sisteme almadık. Deney, ağırlıklara sınırlı müdahaleyle ölçülebilir değişiklik oluşturabildiğimizi gösterdi; kazanımın bütün örnek türlerine yayılmadığını da ortaya koydu.
Sonuçlar sınırlı, asistan etiketli ECV tanı örneklerine ait. Çalışmalarımızı kazanımları ve kayıpları birlikte ölçerek sürdürüyoruz. Burada asıl hedefimiz, duyguyu ve bağlamı doğru taşıyan, AI çekirdeğimize fayda sağlayan bir Companion mimarisi geliştirmek.
Grafik açıklamaları:
1. Yeni tanı setindeki üç ek doğru üzüntü yakalamasını, eski kontrol setindeki kayıpla birlikte gösteriyor. En büyük yamada yeni test 45→48/80, yanlış aktivasyon 2/68; eski kontrolde doğru 102→101/132 ve yanlış 42→49/819. Farklı veri kümelerinin paydaları farklı. "Yalnız eşik" sütunu ağırlığı değiştirmeyen karşılaştırma; yamanın sonucu değil.
2. Kazanç her örnek türüne eşit yayılmadı. Kısa olumlu metinler 8→10/16; uzun metnin ortasındaki duygu 12→13/16. Karışık duygu içinde üzüntü 3/16 olarak kaldı. Sağ panel yeni testte olumsuzluk, sahiplik, alıntı ve geçmiş örneklerindeki yanlış aktivasyonu gösteriyor; eski kontrol setiyle aynı panel değil.
3. Sahiplik ve alıntı için olumlu–kapsam-negatif ham skor farkı büyürken olumsuzluk ve geçmiş için küçüldü. AUC 0,883→0,846: sabit eşikte birkaç doğru eklemek, bütün skor sıralamasını iyileştirmekle aynı şey değil. Formül, korunan ortalamalara dikleştirilmiş yönün okuyucu ağırlığına eklenmesini gösteriyor. Ortalamaları korumak her örneği korumayı garanti etmiyor.
While this approach allowed the model to capture certain emotions that were previously missed when the prompt was vectorized and fed into the model via ECV64D, it also led to an increase in incorrect activations.
We are testing "White-Space Programming" (WSP) on the weights of the Encoder ECV reader within the TanAI 3B model.
In our first attempt, we reduced 16 coefficients specifically within samples representing the emotion of "sadness" and conducted tests.
Evet GPT-6 bu işlemi rahatlıkla yapabiliyor!
Weights Space Programming 'te yapılan iyileştirme Qwen 0.8B 'de ki aritmetik işleminin bir döngüye girmesi ve ağrılıklardaki belirli bir temsil yönünün bulunup değiştilerek sorunun çözülmesi. Fakat Gemma 'da yapılan benzer işlem sonuç vermemiş.
WSP 'yi kendi Encoder ECV Reader 'ımızda duygu ayrıştırma temsilleri üzerinde oluşturduğumuz hatada deniyoruz. İlk denemede "üzüntü" duygusu örneklerinde 16 katsayıyı azaltıp testler yaptık. Promptu vektörize ederek ECV64D ile modele taşırken yakalayamadığımız bazı duygular yakalanırken yanlış aktivasyonlarda arttı.
Bu sonuçtan sonra daha detaylı bir test sürecine girdik. Eğer bizim Encoder ve Model ağırlıklarımızda çalışırsa ve doğru tespitlerle sorunları çözersek çok detaylı bir çıktı paylaşacağım. Bu durumda bize TanAI 3B modelinin testlerinde ki hataları çok hızlı şekilde çözebileceğimizi gösterecek...
İnsanın sıfırdan kendi geliştirdiği bir model ile sohbet edebilmesi başka bir şey :)
AWS 'de 16GB vRam'lı bir makine üzerinde serve ettik ve bolca test edebiliyoruz. Şu an model FP32 (32bit) çalışıyor.
@cagilayitmaz bu AI-Core'u Personal Companion Assistant yapma fikrinin sahibi. Çok tartıştık ama sonunda güzel bir ürün çıkıyor meydana :)
We've started training on 16xH100 GPUs on EuroHPC's MareNostrum 5 supercomputer.
We've completed our first 72-hour training run on 16 GPUs.
This has allowed us to develop our model and training pipeline to support training across multiple nodes.
For the remainder of the training process, we will continue using 16xH100 clusters on the EuroHPC infrastructure.
Scaling on Google was a significant milestone for us. We will now proceed to complete the training of our model on an even larger scale across 4 nodes.
We have completed the training of our base model on Google Cloud, utilizing a cluster of 8xH100 GPUs for a total of approximately 600 hours and processing 89.1 billion tokens.
Technical presentation by @cagilayitmaz, co-founder and CEO of TanI Lab.
Our model training, synthetic data generation, EuroHPC transfers, and inference tests.
Building an LLM from scratch is no small task.
At TanAI, we built our own Transformer architecture for a 3B-parameter model. Training continues on 8 Google-provided H100 GPUs, with 193B Turkish-language tokens processed so far.
Preparing to train on EuroHPC.
Here's our demo ↓
We are building in public from model revisions and training logs to product development. Follow TanAI Lab as we move from proprietary AI core research to a global companion product.
https://t.co/XwiLGo3H5p
What is TanAI Lab, and what are we building? 🧵
TanAI Lab is building an on-device-first AI companion that remembers, adapts, and stays in character powered by our own compact language model, memory system, and controllable AI core.
TanAI was awarded 5,000 GPU-hours on MareNostrum 5 ACC through the EuroHPC AI Factory Playground program. We were also accepted into NVIDIA Inception, NVIDIA’s global startup program.