Deux ingénieurs d’Anthropic viennent de passer 24 minutes à présenter toutes les fonctionnalités de
Claude Code dont tu ignorais probablement l’existence, et c’est entièrement gratuit.
J’ai vu des formations à 300 $ qui n’abordent même pas ce qu’il montre dans les 10 premières minutes.
( La suite de la vidéo est dans les commentaires. )
La plupart des gens vont passer à côté de ce contenu.
Le genre de thread que tu vas regretter de ne pas avoir mis en signet. 🔖
🚨 DeepSeek just did something wild.
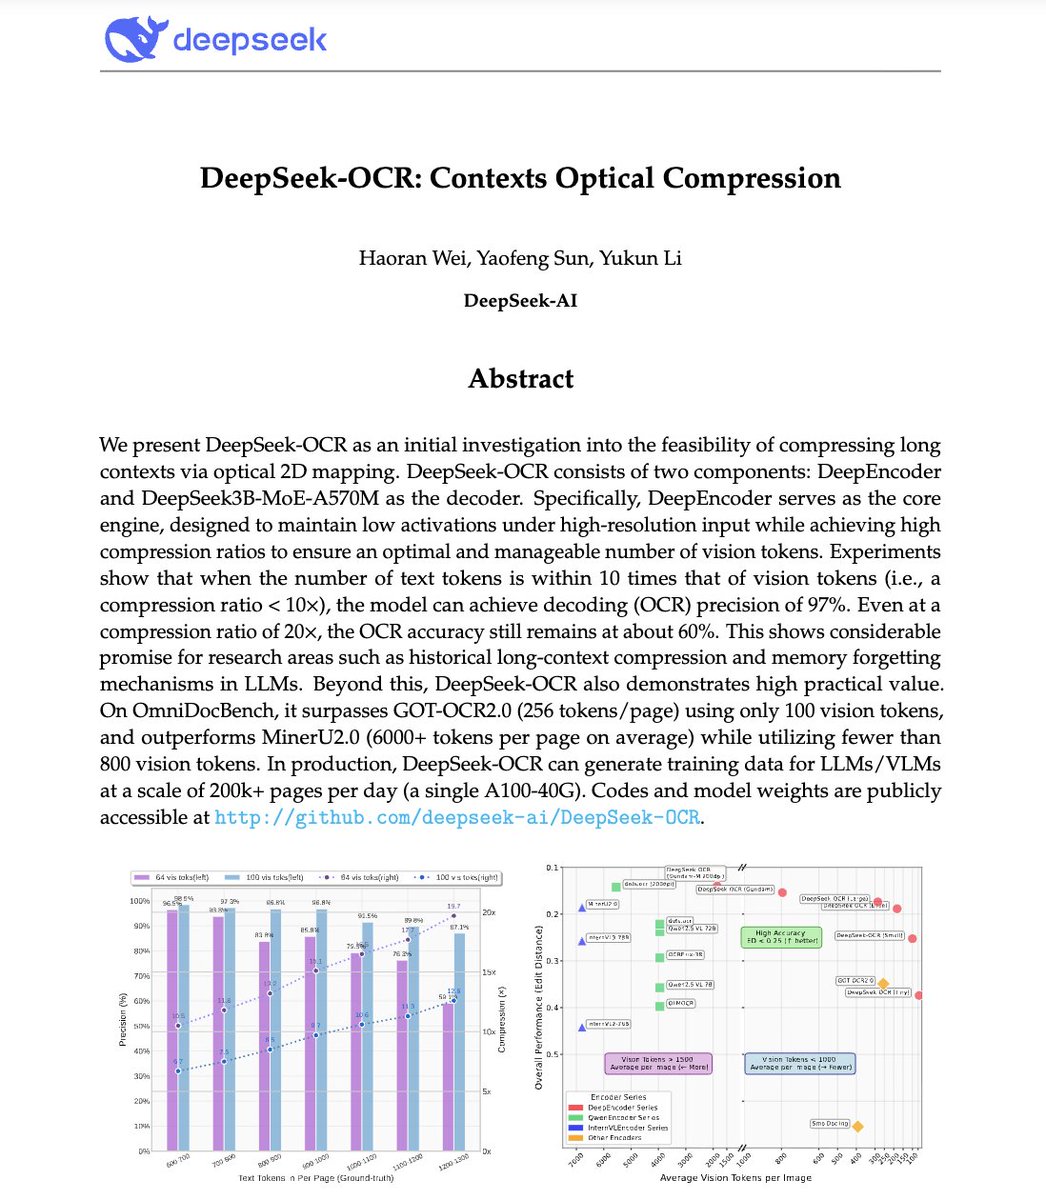
They built an OCR system that compresses long text into vision tokens literally turning paragraphs into pixels.
Their model, DeepSeek-OCR, achieves 97% decoding precision at 10× compression and still manages 60% accuracy even at 20×. That means one image can represent entire documents using a fraction of the tokens an LLM would need.
Even crazier? It beats GOT-OCR2.0 and MinerU2.0 while using up to 60× fewer tokens and can process 200K+ pages/day on a single A100.
This could solve one of AI’s biggest problems: long-context inefficiency.
Instead of paying more for longer sequences, models might soon see text instead of reading it.
The future of context compression might not be textual at all.
It might be optical 👁️
github. com/deepseek-ai/DeepSeek-OCR