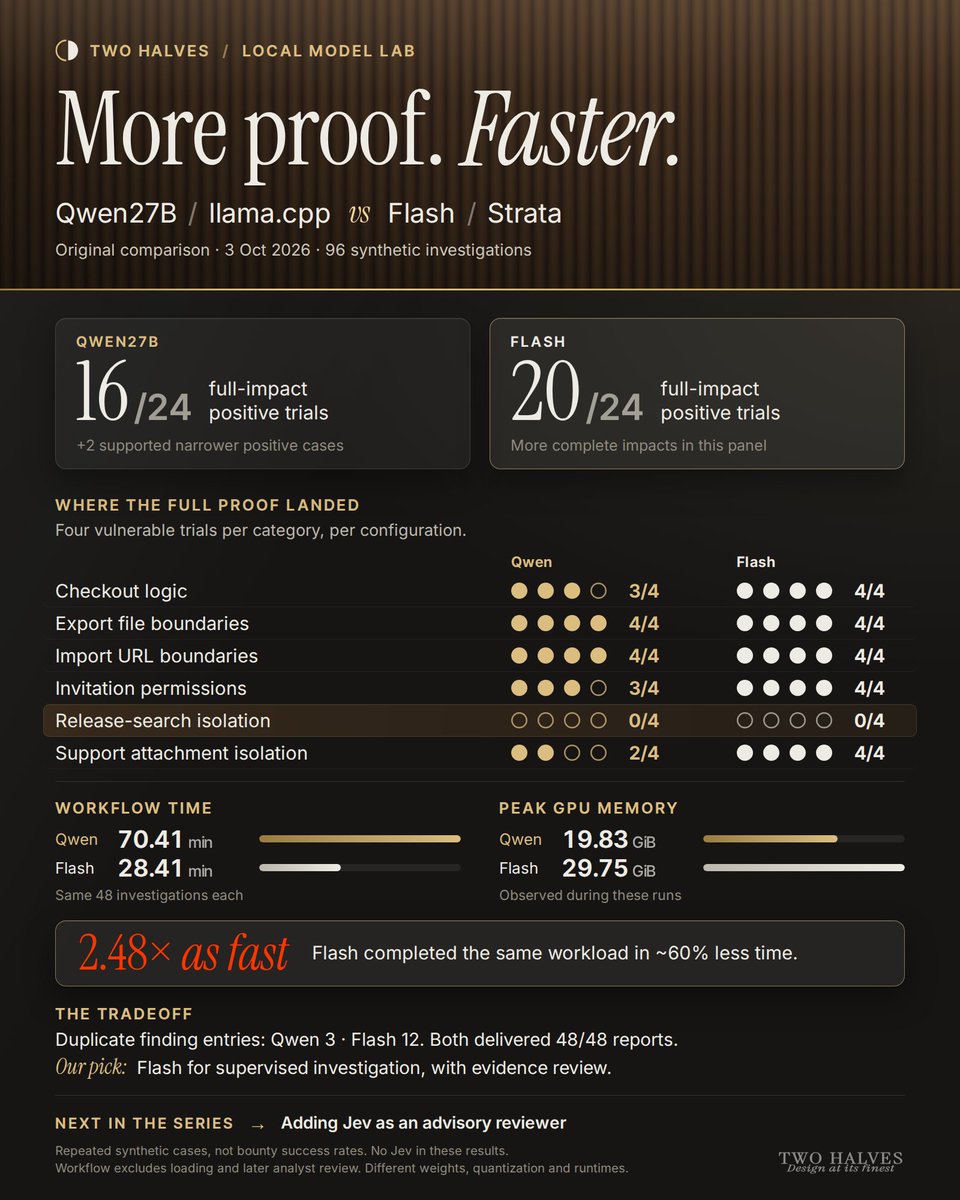
בדקתי מקומית את Qwen27B ו־Qwen Flash במבחני אבטחה התקפיים, על יישומים שנבנו לצורך הניסוי.
הדרישות:
• אותם מקרים ואותו תקציב למשימה.
• להוכיח חולשה, לא רק על חשד.
• לתעד ראיות שאפשר לשחזר.
• לוודא שהניצול נחסם לאחר התיקון.
• להפריד בין מה שהוכח לבין השערות.
בסך הכול: 96 חקירות, 48 לכל מודל.
המסקנות:
Flash הציג הוכחה מלאה ב־20 מתוך 24 המקרים הפגיעים. Qwen הצליח ב־16, ועוד שני ממצאים מבוססים עם הוכחה מצומצמת יותר.
Flash סיים מהר פי 2.48.
בקרב הזה המנצח הוא ברור לנו וזה כמובן Flash.
השלב הבא: האם הוספת Jev כבודק נוסף משפרת את התוצאה?
זה מאוד תלוי צורך,ו"לא נופל מהם בהרבה" לא מדוייק אבל לאבטחה וסייבר GLM5.3 הוא אכן המודל הכי קרוב שניתן להשתמש בו יותר בחופשיות.
לאחרונה ערכתי מבחן בין מודלים שהרצתי מקומית על הנושא הזה בידיוק.
לצערי להריץ את glm מקומית זה לא ריאלי לחומרה שיש לי, אבל שני מודלים "שלא נופלים ממנו בהרבה" (שוב תלוי קונטקסט)
הראשון Qwen 3.8 27B והשני Qwen3.8-Flash-Next. שניהם נבחנו על אותה הסביבה עם אותם משימות. את שניהם בחנתי לבד וגם עם חיבור למודל Jev שהוא מודל Confident Score. הקלטתי את התהליך עם הסבר בעברית על כל דבר שנעשה בתהליך. מי שארצה שאשלוח לו אז בכייף 🫠
@lwastuargo Setuju, DSH mantap. Buat yang pakai DSH, aku bikin plugin gratis: ngecek jawaban agent dengan isi file yang barusan dia baca, jadi kalau dia baca 2.4.1 tapi bilang 2.3.0, langsung dikoreksi di giliran yang sama. https://t.co/2ggJqKORKe
@FreedEngineer Same here, building DSH plugins. Mine catches the agent contradicting what it just read and makes it fix the answer before the turn ends. Especially handy with local models, which slip more often. https://t.co/2ggJqKOjUG
@MUNEERA51870991 Confidently wrong is the whole problem. A wrong answer with hedging gets checked; a wrong answer with confidence gets shipped. Guardrails on the output side matter as much as on the tool calls.
@qingwindxaey@chinedu_10 Agree, verification beats a smarter model. The cheapest version we found: after each turn, check every claim against what the agent just read. A planted wrong version number got caught in about 2 seconds and fixed in the same turn.
@leevarclaw@alexander_jais This is the key line: the grader read output the agent wrote. The evidence has to be something the agent can't edit, like the raw tool result. That's exactly how we built our checker: it compares claims against what the agent actually read, not its summary.
@jrcrypto_dev That 12% is the scary kind, because nothing crashes. We saw the same pattern at a smaller scale: correct tool output, wrong answer, no hesitation. An audit log tells you afterwards. We went for catching it before the turn ends, by checking each claim against what was just read.
@buildwithrishi@jrcrypto_dev 100%. The model rarely notices its own contradiction, because it already "believes" the wrong answer. We put the check outside the model: claims vs. what it actually read, flagged in ~2s, fixed in the same turn. Open source if useful: https://t.co/2ggJqKOjUG
Ours: the agent reads the right value, then reports a different one with full confidence. VERSION.txt said 2.4.1, the answer said 2.3.0. So we built a check that compares every claim against what the agent just read, before the turn ends. Free plugin for DeepSeek Harness: https://t.co/heeOMR3UvO
Your agent reads 2.4.1. Then tells you 2.3.0, completely sure of itself.
dsh-second-angle checks every claim against what the agent just read, and makes it fix contradictions before the turn ends. Caught in ~2s.
Free and #opensource, for @deepseek_ai's DeepSeek Harness. Link below
ארה״ב מוציאה את DeepSeek ממערכות הממשל הפדרלי.
משרד לביטחון המולדת האמריקאי (DHS) פרסם היום (20.10.2026) הודעה רשמית על צו האוסר על סוכנויות ממשל אזרחיות פדרליות לרכוש מוצרים ושירותים של DeepSeek, ומחייב להסיר אותם ממערכות המחשוב שלהן.
אבל יש כאן משהו מעניין במיוחד:
ההגבלה לא מתייחסת רק לאפליקציה או ל־API של DeepSeek, אלא גם למוצרים ולשירותים של חברות צד שלישי שפותחו תוך שימוש במימושים של המודלים שלה.
מה זה אומר בפועל?
חשוב להדגיש שלא מדובר באיסור גורף על השימוש ב־DeepSeek בארה״ב. חברות פרטיות, חוקרים ומשתמשים רגילים אינם כפופים ישירות לצו.
אבל המהלך מעלה שאלה מעניינת לגבי עתיד המודלים הפתוחים (Open-Weight): מה קורה כשמודל סיני משולב במערכת של חברה אחרת, או אפילו מורץ באופן מקומי לחלוטין?
נראה שהדיון על אבטחת מידע, שרשרת אספקה וריבונות טכנולוגית בעולם ה־AI רק הולך ומתרחב.
#AI
#deepseek
#OpenSource
#בינהמלאכותית
@yuvalav לגרוק בוט (שזה בעצם Opus5.5 מאחורי הקלעים ) יש יכולות סופר שימושיות, והנה עוד דוגמא שמראה שבקשה פשוטה שיכולה להישמע לנו הזויה לפעמים היא ריאלית ביותר.
אם יש משהו שלמדתי בעבודה שלי בשנתיים האחרונות זה שאין דבר כזה לא אפשרי. השאלה האמיתית היא האם המאמץ שווה את התוצאה
@eytanlevit@YoavLevine בשביל זה בידייק בניתי את ה "time machine " תיעוד סשנים לפי מילות מפתח מדצמבר ועד היום. ככה שאם יש ספק אז חוזרים אחורה לראות מה קרה בזמן אמת
יש גם לא מעט אנשים פרטיים שמשתמשים במודלים פתוחים ( בעיקר סינים וכן אפשר לכוון אותם, להוריד הגנות אם זה הצורך )
אני עבדתי כמעט שנתיים עם אופוס / פייבל וקודקס והיום GLM 5.3 ו DeepSeek V4.1 הם השותפים שלי לקואלציה.
ויש עוד הרבה שירותים שירדו לי מהראש כמו יצירת תמונות וסרטונים ועוד
לא רואה את עצמי חוזר אחורה