الدراسة اختبرت ١٦ نموذجاً على ١٦ لهجة عربية، في الاتجاهين، على مجموعة
MADAR
ونشرت في ١ نوفمبر ٢٠٢٦. الرقم أعلاه من المراجعة اليدوية لأول مئة جملة في اختبار اللهجة المصرية، مع توجيه باللهجة، للنموذج
EuroLLM-9B
(دقة المعنى ٩٣٫٠، ودرجة اللهجة ٣٦٫٤). النماذج المتخصصة في العربية كانت أثبت في توليد اللهجة على هذه العيّنة الصغيرة. والدرجات المرتفعة تُقرأ بحذر، لأن بعض النماذج ربما رأت بيانات الاختبار سابقاً؛ أما الدرجات المنخفضة فأبلغ في كشف العجز.
https://t.co/ZmCbRbut5Y
كثير من الفرق تطلب من نموذج لغوي صياغة رسالة «بالمصرية» أو «بالشامية» أو «بالعراقية»، حتى يفهمها المستفيد كما يتكلم.
لكن الناتج يخرج أحياناً بالفصحى أو بمزيج غير مستقر، ويُنشر لأن النص يبدو طليقاً.
وهذه مشكلة حسّاسة: رسالة موعد أو موافقة أو تعليمات سلامة بلغة ليست لغة الناس قد تُفهم ناقصة، أو تبدو غريبة فتُهمل.
إليكم ما كشفه تقييم جديد، واختباراً بسيطاً تجرونه على رسائلكم قبل الاعتماد 👇
القيد أولاً: المقاييس الآلية للترجمة قد تمنح درجة عالية لنص فصيح، حتى حين يُطلب منه لهجة محددة؛ وأحد المقاييس المستعملة يميل إلى تفضيل ما يشبه الفصحى.
وفي مراجعة يدوية لمئة جملة من اختبار اللهجة المصرية، مع طلب صريح بالترجمة إلى هذه اللهجة، سجّل أحد النماذج متعددة اللغات دقة معنى ٩٣٪، مقابل درجة لهجة ٣٦٫٤٪ فقط.
والعيّنة صغيرة وعلى لهجة واحدة، فلا تُعمَّم. لكن الدلالة واضحة: سلامة المعنى لا تعني أن النص باللهجة التي طلبتموها.
إليكم الطريقة:
أولاً، اجمعوا خمس عشرة إلى عشرين رسالة قصيرة من عملكم، بعد حذف الأسماء والأرقام.
ثانياً، اطلبوا من النموذج صياغتها باللهجة التي تستخدمونها مع المستفيدين، وحدّدوا المنطقة والجمهور، لا كلمة «العربية» وحدها.
ثالثاً، اطلبوا الصياغة نفسها مرة ثانية بلا تحديد اللهجة، وقارنوا: إن تشابه النصّان، فالنموذج يميل إلى الفصحى.
رابعاً، يعرض النص على شخصين يتحدثان اللهجة، فيحكمان: هل هذه لهجتنا؟ هل نرسلها كما هي؟ وإن اختلفا كثيراً، فلا تُعتمد الصياغة الآلية.
رأيي: النص الفصيح الذي يُظن لهجة أخطر من نص فصيح واضح، لأنه يمرّ بلا مراجعة. والحكم لشخص يتكلم اللهجة، لا لدرجة النموذج.
أي لهجة تكتبون بها للمستفيدين، وهل راجع متحدث منها آخر رسالة قبل أن تخرج؟
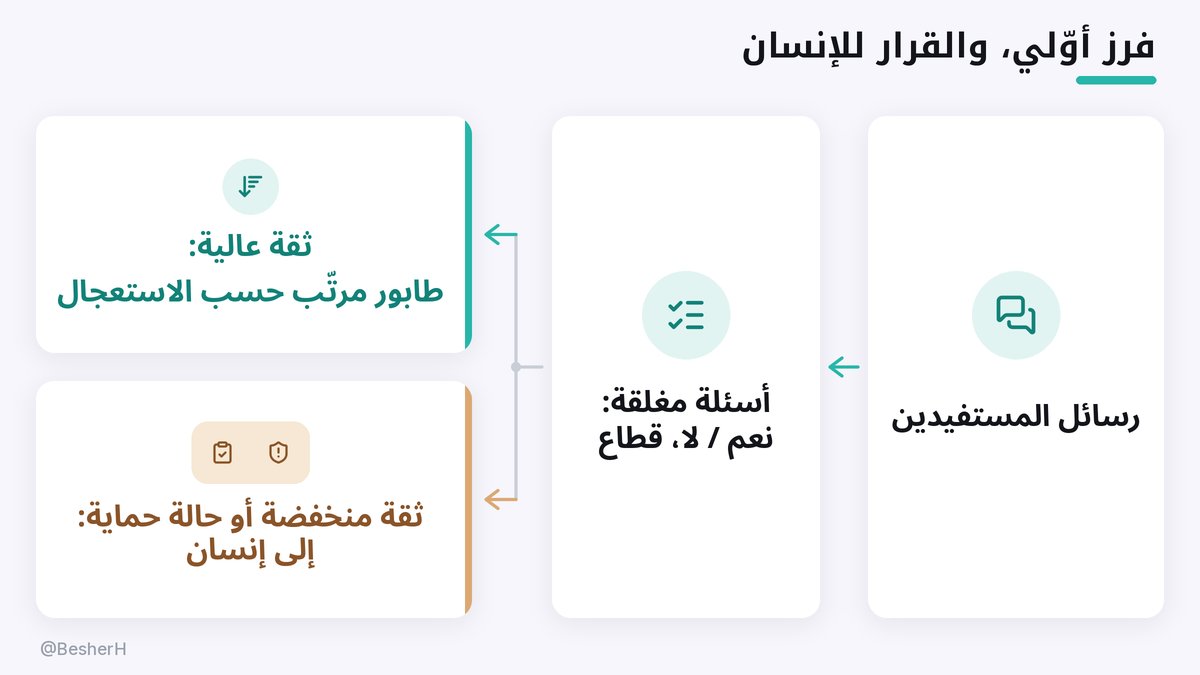
تتراكم لدى المنظمات رسائل الشكاوى والملاحظات من المستفيدين عبر الخط الساخن والرسائل.
وبينها شكوى عاجلة قد تنتظر أياماً في الطابور قبل أن يقرأها أحد.
أداة جديدة من غوغل تساعد في الفرز الأول، وهنا طريقة استخدامها بأمان، مع حدودها 👇
الأداة لا تكتب نصاً، بل تجيب عن أسئلة مغلقة: نعم أو لا، أو اختيار من قائمة، مع درجة ثقة بين صفر وواحد لكل جواب.
ويمكن طرح ما يصل إلى ألف سؤال على الرسالة نفسها في طلب واحد.
Gemini Decisions API
إليكم الطريقة خطوة بخطوة:
أولاً، اكتبوا أسئلة مغلقة واضحة: هل تمسّ الرسالة سلامة شخص؟ هل تطلب مساعدة عاجلة؟ أي قطاع تخص؟
ثانياً، احذفوا الأسماء وأرقام الهواتف والعناوين قبل الإرسال؛ فهي خدمة سحابية، واستخدامها يحتاج موافقة مسؤول حماية البيانات.
ثالثاً، لا تعتمدوا درجة الثقة قبل قياسها: صنّفوا يدوياً مئة رسالة سابقة، وقارنوا، واحسبوا كم رسالة عاجلة فاتت الأداة.
رابعاً، ضعوا قاعدة ثابتة: كل رسالة تمسّ الحماية تذهب إلى إنسان، مهما كانت درجة الثقة.
القيد: الإعلان لا يذكر أداءها على العربية ولا على اللهجات، وكثير من الشكاوى يُكتب بالعامية.
اجعلوها تختصر الطابور، لا أن تقرر من يُترك فيه.
كيف تفرزون الشكاوى عندكم اليوم، وكم تنتظر الرسالة العاجلة قبل أن يقرأها أحد؟
رأيي: هذه الأدوات تختصر القراءة الأولى، لكن تحديد المناطق المتضررة وترتيب الاستجابة يحتاج مصدراً ثانياً، وزيارة ميدانية حيث أمكن.
هل تتحققون من تقارير الأقمار الصناعية بمصدر آخر قبل القرار؟ ٥/٥
https://t.co/PYsGridEBz
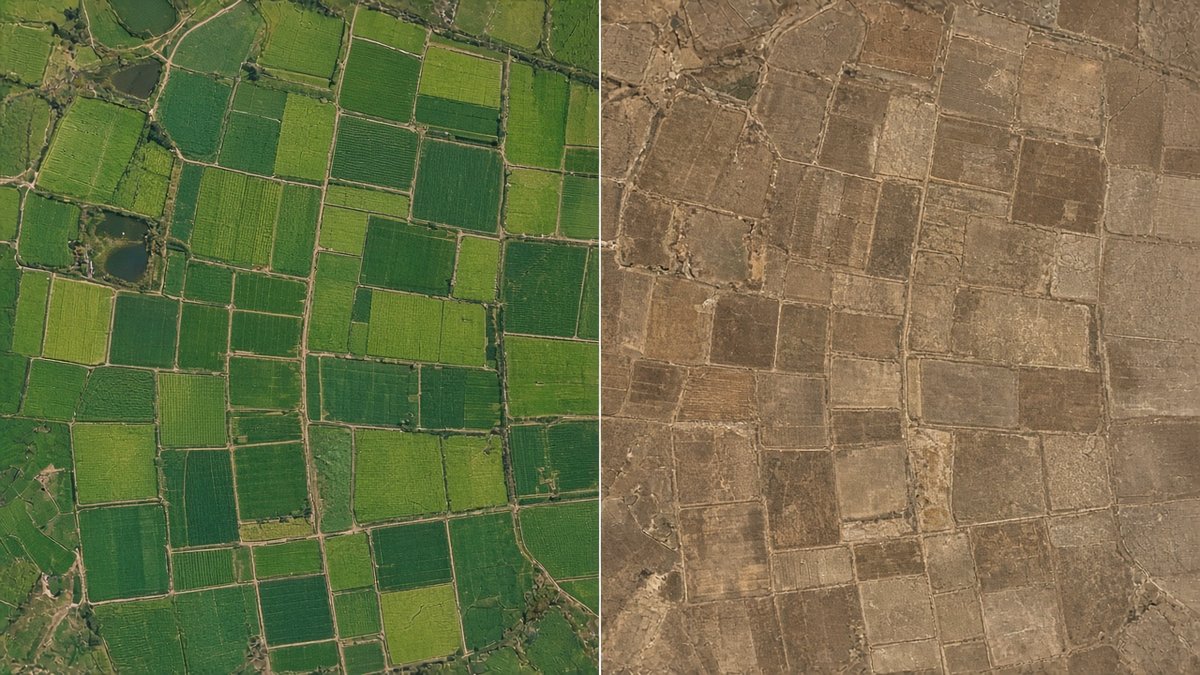
بعد فيضان أو موسم جفاف، تحتاج المنظمة أن تعرف بسرعة: أين تغيّرت الأرض فعلاً، وأين تتدخّل أولاً؟
تحليل صور الأقمار الصناعية يأخذ أياماً من محلل مختص، وأدوات الذكاء الاصطناعي تعد بإنجازه في دقائق.
لكن دراسة جديدة تكشف خطأً خطيراً في هذه الأدوات، وهنا كيف تكشفونه بأنفسكم 🧵 ١/٥
قبل أن تعتمدوا على تقرير من هذه الأدوات، جرّبوا ثلاث خطوات:
اطلبوا التحليل نفسه من قمرين مختلفين للفترة ذاتها. إن اختلفت النتيجة، فلا تبنوا عليها قراراً.
اسألوا السؤال نفسه دون صور. إن جاء الجواب مشابهاً، فالأداة تجيب من معلومات عامة عن المنطقة لا من الصور.
واطلبوا صورة قبل وبعد لكل رقم، وانظروا إليها بأعينكم. ٤/٥
قبل تشغيل أداة كهذه بصلاحيات المدير، يستحق السؤال: ما الذي تعتبره «خفياً»؟
كثير من عمليات الخلفية هي خدمات الحماية والتحديثات، وإيقافها بضغطة واحدة قد يبدو تسريعاً بينما يترك الجهاز مكشوفاً.
وفي أجهزة المنظمات التي تحمل بيانات المستفيدين، أي برنامج يطلب صلاحيات كاملة يمر على مسؤول تقنية المعلومات أولاً، مهما كان مفتوح المصدر.
الصوت والصورة لم يعودا دليلاً على هوية المتصل، لذا فالدفاع الفعّال هنا إجرائي قبل أن يكون تقنياً.
قاعدة بسيطة تكفي: أي طلب عاجل وسري لتحويل أو دفع يُعاد التحقق منه باتصال على رقم معروف مسبقاً، لا على الرقم الذي جاء منه الطلب، ولا يُنفَّذ إلا بموافقة شخصين.
وفي المنظمات، المكاتب الميدانية البعيدة عن المقر هي الهدف الأسهل: موظف مالي وحيد، واتصال ضعيف يبرر رداءة الصوت، وتسلسل إداري يصعب التحقق منه في لحظتها.
The way out is boring: a private set built from your own failure cases, refreshed before anyone can tune to it. A model dropping on Harvey's public bench tells me little. What matters is whether public rankings still predict the ranking on my held-out cases, and that correlation is the thing worth publishing.
بمحاولة واحدة لكل نموذج، قد يكون فرق ٢٧ عن ٢٤٫٥ أصغر من تذبذب النموذج نفسه بين تشغيلين للسؤال ذاته.
لو كُررت التجربة ثلاث مرات، وقُيّمت الإجابات دون معرفة اسم النموذج، لعرفنا هل الترتيب ثابت أم صدفة.
والأهم عندي أن الأربعة أخطؤوا معاً في الموسم المحلي: المعرفة المحلية واللوائح المتغيرة هي الحلقة الأضعف، ولا يكشفها إلا من يعرف الشارع.
حماية البيانات أولًا 🛡️
صور الأقمار الصناعية عامة، لكن دمجها مع مواقع الأسر أو المستفيدين يحوّلها إلى بيانات حساسة.
شاركوا الخرائط المجمّعة فقط، لا النقاط الفردية.
رابط النموذج والعرض التجريبي: https://t.co/6k7sINE5my 5/5
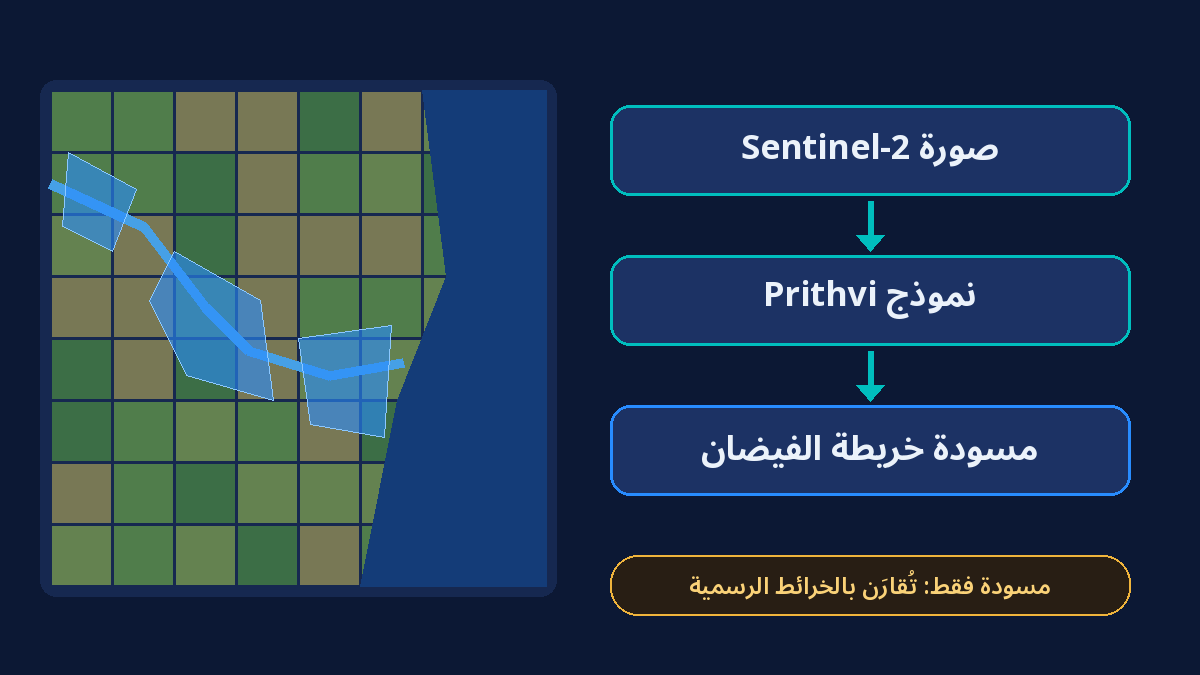
خريطة للفيضان قبل أن تصل الفرق إلى المكان؟ 🛰️
هذا ما يتيحه نموذج Prithvi المفتوح من IBM وNASA، والمتاح على Hugging Face.
إليكم كيف يمكن أن تستفيد منه المنظمات الإنسانية بعد العواصف والفيضانات 🧵 1/5
حدود يجب معرفتها ⚠️
الصور البصرية لا ترى عبر الغيوم، والغيوم كثيفة بعد العواصف مباشرة؛ وهنا تفيد صور الرادار (Sentinel-1).
والنتيجة مسودة تُقارَن بالخرائط الرسمية والمعلومات المحلية قبل أي قرار. 4/5
@abidlabs I'd love to see that 300PB broken down by what runs offline on an 8 GB laptop under a licence that allows use with real beneficiaries. For field teams, that slice is the open-source AI that actually exists, and it's where low-resource language evals are thinnest.