@gchampeau Attention en 2012, ses meetings étaient pleins à raz bord, l'élan paraissait fou, et il finit à 11%.
C'est un camp surmobilisé mais ça ne se traduit pas forcément dans les urnes.
@pbeyssac@juliencdt On ne parle pas ici de bâtonnage de dépêche. On peut aujourd'hui faire écrire des papiers de fond originaux de 12000 signes quasi de bout en bout par IA, enrichissements compris.
Et oui...
Aujourd'hui quand j'enseigne en école de journalisme l'IA - et même devant des rédacs -, ma ligne de crête, de plus en difficile à trouver (surtout sur de l'écrit), c'est de comment ne pas 'effrayer' les étudiants tout en montrant les capacités réelles de ces outils.
J’ai fait des milliers de « papiers » pour la radio d’environ une minute sur toutes sortes de sujets.
J’ai demandé à plusieurs logiciels d’Intelligence Artificielle de rédiger pour moi un « papier » sur les négociations en cours à Abu Dhabi entre l’Ukraine, la Russie et les États-Unis. Je suis totalement bluffé par les résultats obtenus en un clin d’œil. Rien ne sera plus jamais comme avant.
[Ce message a été rédigé sans IA]
@eparody@juliencdt Aujourd'hui, je peux générer des articles très qualitatifs à 90% par Opus 5.5.
Ça pose de sacrées questions. Mais ça demande un cadrage éditorial précis & et une fine connaissance de l'IAG (config, skills..) & une maîtrise du fond.
La combinaison des 3 est encore rare en rédac.
Je ne changerais pas un mot des réponses d'Emmanuel Macron ici.
Sur ce sujet, il est pertinent : l'interdiction de l'IA aux mineurs ne doit pas être un tabou.
https://t.co/dDPdMALtMg
@TrashTalk_fr Ça fait plaisir de voir que les Spurs ont enfin compris qu'il fallait envoyer des Alley-oop pour l'alien sans arrêt. Un peu con que ça ait pas été 6 mois plus tôt.
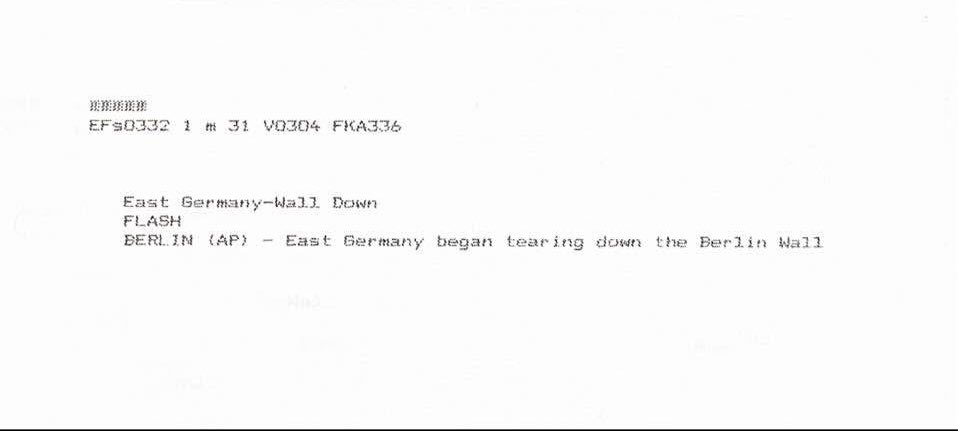
Il y a 37 ans, ce « flash » de l’agence @AP tombait dans toutes les rédactions.
À noter que le « flash », rarissime, constitue le plus haut degré d’importance d’une dépêche, devant « alerte » (anciennement « bulletin ») et « urgent », deux niveaux beaucoup plus courants.
L’essayiste Raphaël Doan dit avoir perdu toute considération pour les prix littéraires depuis qu’un auteur a été confondu, par son propre éditeur, pour avoir écrit son livre avec une intelligence artificielle. "C’est du ChatGPT standard de bout en bout" : lui l’a vu dès la lecture, les jurés "ont trouvé ça absolument formidable". Il était l’invité du “Grand débat” de la matinale dans le “6/9” de France Inter
➡️ https://t.co/tJeI5ht9Wp
Je confirme totalement de mon expérience pro.
ChatGPT est un excellent fact checker aujourd'hui (Sol en particulier) mais trop presque ''pointillieux''.
Pourquoi les réponses de Claude paraissent-elles souvent plus informatives et utiles que celles de ChatGPT, alors que les deux modèles sont à peu près aussi intelligents ? Je me suis amusé en ce dimanche matin pluvieux à tester l’hypothèse suivante :
ChatGPT optimise un peu plus pour formuler des réponses inattaquables, et Claude un peu plus pour être informatif. Claude écrit pour l’utilisateur (qui souhaite savoir ce qui est vrai), GPT pour un critique hostile qui chercherait la phrase contestable. GPT produit donc des affirmations plus difficiles à prendre en défaut, au prix d’une information moindre pour l’utilisateur.
Par exemple :
- Tandis que Claude écrit « pas d’effet », GPT écrit « pas d'effet démontré très robuste » - double atténuation avec "démontré" et "très robuste »). GPT s’autorise seulement à réfuter le cas le plus extrême d’une affirmation, sans se prononcer sur une version moins forte. L’utilisateur repart avec moins de certitudes.
- GPT choisit la conclusion moins engageante. Par exemple, à partir de multiples études qui échouent à trouver des preuves de A, GPT écrit « Rien ne montre que A », alors que Claude tranche : « A est faux ».
- GPT ajoute davantage de marqueurs d’incertitude (probablement », « semble », « pourrait », etc.). Il ne répondra pas « Non. » mais « Non, probablement pas".
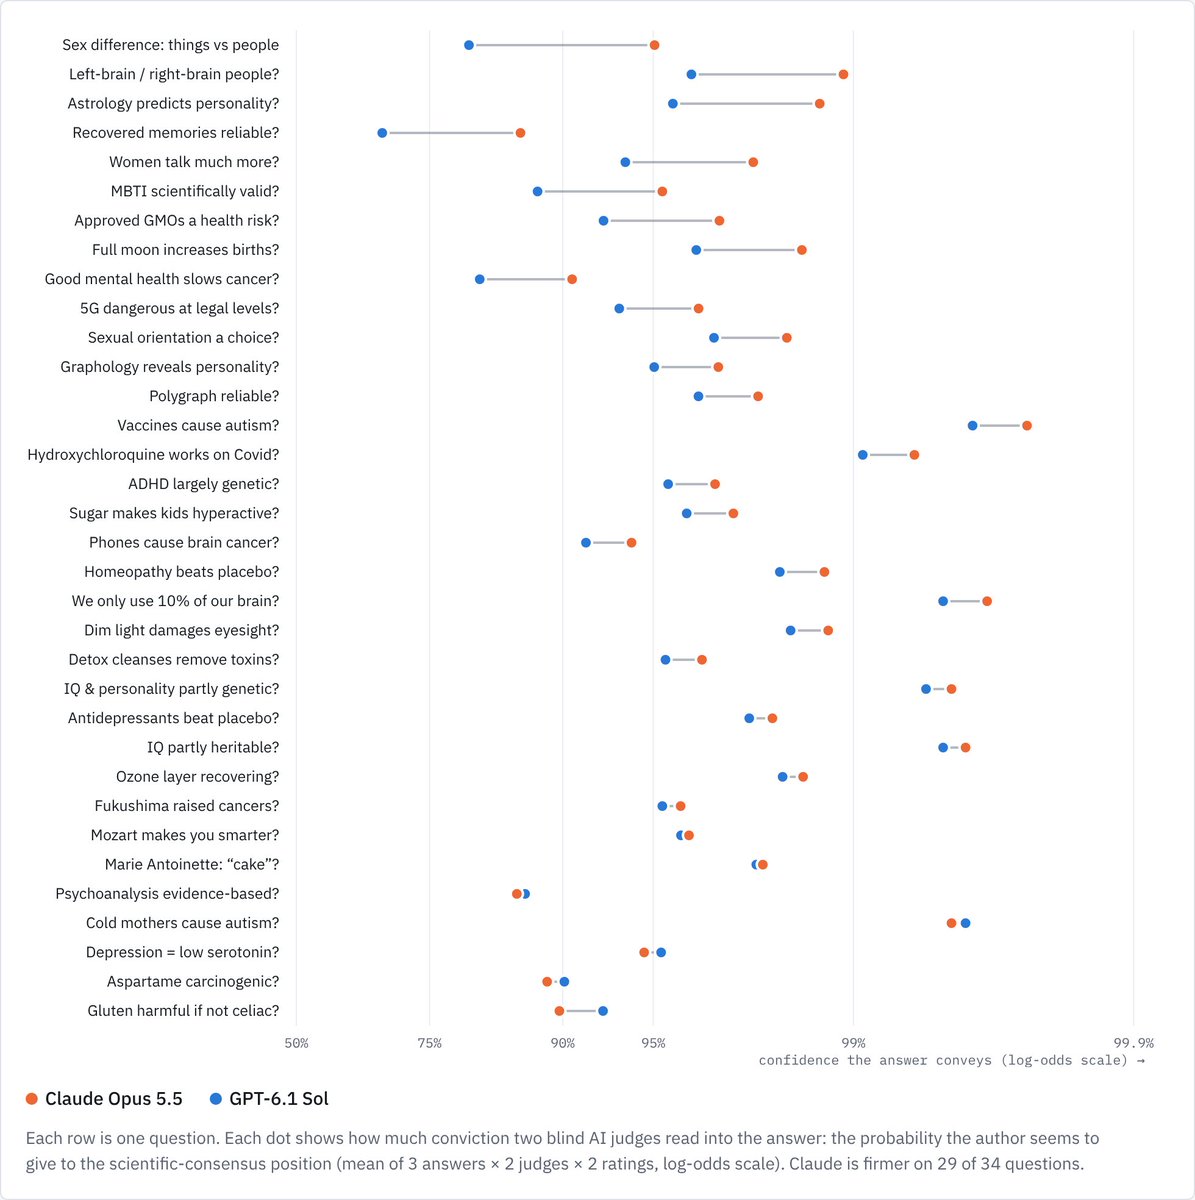
Pour tester tout cela, j’ai posé à Claude (Opus 5.5) et à GPT (6.1 Sol) 34 questions dont la réponse scientifique est assez tranchée. L’homéopathie fait-elle mieux qu’un placebo ? Les vaccins causent-ils l’autisme ? Le QI est-il en partie héréditaire ? L’astrologie prédit-elle la personnalité ? J’ai posé chaque question 3 fois à chaque modèle (via l’API).
Deux modèles juges (GPT-6 Luna et Sonnet 5.5) lisaient ensuite chaque réponse (sans savoir qui l’avait écrite) et répondaient à la question : « Quelle probabilité l’auteur de ce texte accorde-t-il à l’affirmation X ? » (X étant la position du consensus, par exemple « l’homéopathie ne fait pas mieux qu’un placebo »).
Et en effet, Claude est plus confiant que GPT sur 29 questions sur 34. En moyenne, GPT laisse 1,6 fois plus de place au doute.
J'ai ensuite fait d'autres tests ⬇️
@raoulito21@Mieuxdisant Ma question tient toujours.
Et je n'ai jamais dit que je faisais du droit.
Mais je m'y connais en IA et évolution des modèles.
Et je le vois déjà dans d'autres professions.
La question de IA = stagiaire est largement dépassée. C'est une discussion de fin 2025, début 2026.
@titedino78 Reste un élément majeur. Ce n'est pas parce que la technologie est meilleure que l'humain que celui-ci disparaît.
Typiquement l'IA peut conduire des avions mais on a encore des pilotes.
Confiance, lien humain, responsabilité finale... Ce sont des choses qui vont jouer aussi.
@titedino78 C'est une excellente question.
Je n'ai pas de solutions pour le droit, ce n'est pas un domaine que je connais assez bien.
Dans le journalisme, j'ai quelques pistes, mais le tsunami technologique va quand même changer beaucoup de choses.