La torre principal del castillo de Hirosaki continúa su regreso a su ubicación original. 🏯
El 1 de octubre se reanudó la segunda fase del traslado. En 2015 fue desplazada unos 78 metros para reparar los muros de piedra.
#Japón
Kawasaki Heavy Industries presentó un prototipo de robot de construcción naval con "IA física" que toma decisiones de forma autónoma y realiza trabajos de soldadura.
Busca responder, entre otros problemas, a la disminución de técnicos veteranos.
#Japón
El Museo Prefectural de Tokushima exhibe 25 piezas, entre espadas y accesorios ligados a la región. Un adorno de empuñadura de finales del período Edo muestra un pulpo que saca sus tentáculos de una vasija.
Hasta el 7 de febrero de 2027.
#Japón
🚨 AQUÍ TIENES LA MAYOR BIBLIOTECA DE PROMPTS
La biblioteca de prompts open source más grande del mundo y es GRATIS.
prompts chat (antes Awesome ChatGPT Prompts) es una colección seleccionada de prompts que funciona con ChatGPT, Claude, Gemini y mucho más.
> Más de 167k estrellas en GitHub, mencionada por Harvard y Columbia
> Funciona como CLI, servidor MCP o plugin de Claude Code
> Puedes alojar tu propia versión privada con branding y autenticación personalizados
100% GRATIS. Open Source.
Repo: 👇👇
Mitsubishi Heavy Industries bautizó y botó el 8 de octubre en su astillero de Kobe el 'Shōgei', séptimo submarino de la clase Taigei para la Fuerza Marítima de Autodefensa de Japón.
Su entrada en servicio está prevista para marzo de 2028.
#Japón
Este 8 de octubre, Kenso Soai, Nobel de Química de 2026, visitó la Universidad de Ciencias de Tokio, en Shinjuku.
Unos 300 estudiantes y miembros del personal lo recibieron entre aplausos y le entregaron un ramo de flores.
#Japón
El 7 de octubre, Matsuko Deluxe, conocida figura de la televisión japonesa, fue nombrado jefe por un día de la comisaría de Shibuya (Tokio).
En el acto alertó sobre distintas modalidades de estafa, que también afectan a los jóvenes.
#Japón
El festival Nagasaki Kunchi (長崎くんち) comenzó el 7 de octubre en el Santuario Suwa (諏訪神社), en la ciudad de Nagasaki. Hasta el día 9 participan seis barrios con actuaciones tradicionales.
#Japón
Meta ha prohibido los anuncios que promocionan TikTok y otros servicios de ByteDance en siete países, entre ellos EEUU, Canadá y Japón.
La restricción también afecta a campañas de terceros que enlacen a esos servicios. España no figura entre los países afectados.
#SocialMedia
Novedad de Google. Han dado a conocer el UGC Fresh Data Program, por el que plataformas con un "alto volumen de interacción y gran base de usuarios" pueden enviar directamente a Google los comentarios más recientes y sus señales de interacción.
Es independiente de la API de indexación.
Sólo pueden participar plataformas centradas en UGC, no un blog con comentarios de los lectores, aunque sea muy popular. Y la plataforma debe tener moderación activa.
Más info aquí: https://t.co/UUc3qDPywA
Puedes tener la mejor estrategia de contenidos, pero si tu empresa hace esto, tu marketing digital está muerto antes de nacer...
Descubre por qué falla y qué debe aportar (sí o sí) la empresa para que funcione 👉 https://t.co/jcnNMQQfK2
En Tsukuba (Ibaraki) ha comenzado la operación regular de un autobús automatizado en la línea circular de la Universidad de Tsukuba. 🚌
Circula con nivel 2 y conductor a bordo; el objetivo es implantar el nivel 4 en el ejercicio fiscal 2027.
#Japón
¿Cómo? ¿Que ya hay una alternativa open-source a Dots (la herramienta de agentes personales de OpenAI)?
→ Roles y permisos propios
→ Tareas programadas
→ Chat, llamadas y Slack
→ Docs editables y aprobación humana
→ Autoalojable
https://t.co/vFewYUojDm
Un solo artículo hizo el 95% del tráfico de Discover de 49 webs. Y casi todo en cuatro días.
La página que cumplía todos los requisitos de imagen de Google hizo cero clics.
En el Search Central Live de Barcelona, Google repasó qué pide Discover. Útil si eres un medio. Pero la pregunta que nos hacen los clientes es otra: ¿cuánto tráfico da Discover a una web de negocio?
Lo medí en 49 webs de clientes con Search Console. 90 días, del 6 de julio al 3 de octubre.
➡️ Clics desde la búsqueda web: 3.097.868
➡️ Clics desde Discover: 2.899
➡️ Peso de Discover: 0,09%
➡️ Webs sin una sola impresión en Discover: 42 de 49
Y de esos 2.899 clics, 2.747 son de un único artículo de blog: qué formación profesional estudiar con más de 40 años.
Se publicó el 7 de julio. Del 10 al 13 de julio hizo 2.597 clics. Después, ni una impresión en casi tres meses.
Lo que más me sorprendió fue la imagen. Ese artículo tiene la etiqueta og:image vacía. Google cogió una imagen grande del cuerpo y le bast��. Mientras, la única página de la muestra con imagen de 2.560 píxeles y permiso para mostrarla grande hizo cero clics.
La imagen te da la tarjeta grande. No te mete en el feed. Lo que decide es si el contenido interesa a alguien que no lo estaba buscando.
Para una web de negocio, mi lectura:
➡️ No metas Discover en el plan como canal. Es un golpe de suerte, no una fuente.
➡️ Haz el mínimo técnico: max-image-preview:large en la meta robots y una imagen de 1.200 px de ancho.
➡️ Si un mes sube el tráfico de golpe, mira el informe de Discover antes de atribuírselo al SEO.
El SEO sigue siendo lo que trae los 3 millones de clics. Discover es el 0,09%.
Datos completos, tablas y metodología en la bitácora (enlace en el primer comentario).
¿Alguna vez os ha entrado un pico de Discover que luego nadie supo explicar?
En Ashikaga Gakkō (Tochigi), conocida como la escuela más antigua de Japón, está en marcha la renovación completa del tejado de paja del Hōjō.
Es la primera sustitución completa de su cubierta desde que el edificio fue reconstruido en 1990.
#Japón https://t.co/KNoOl4hPsY
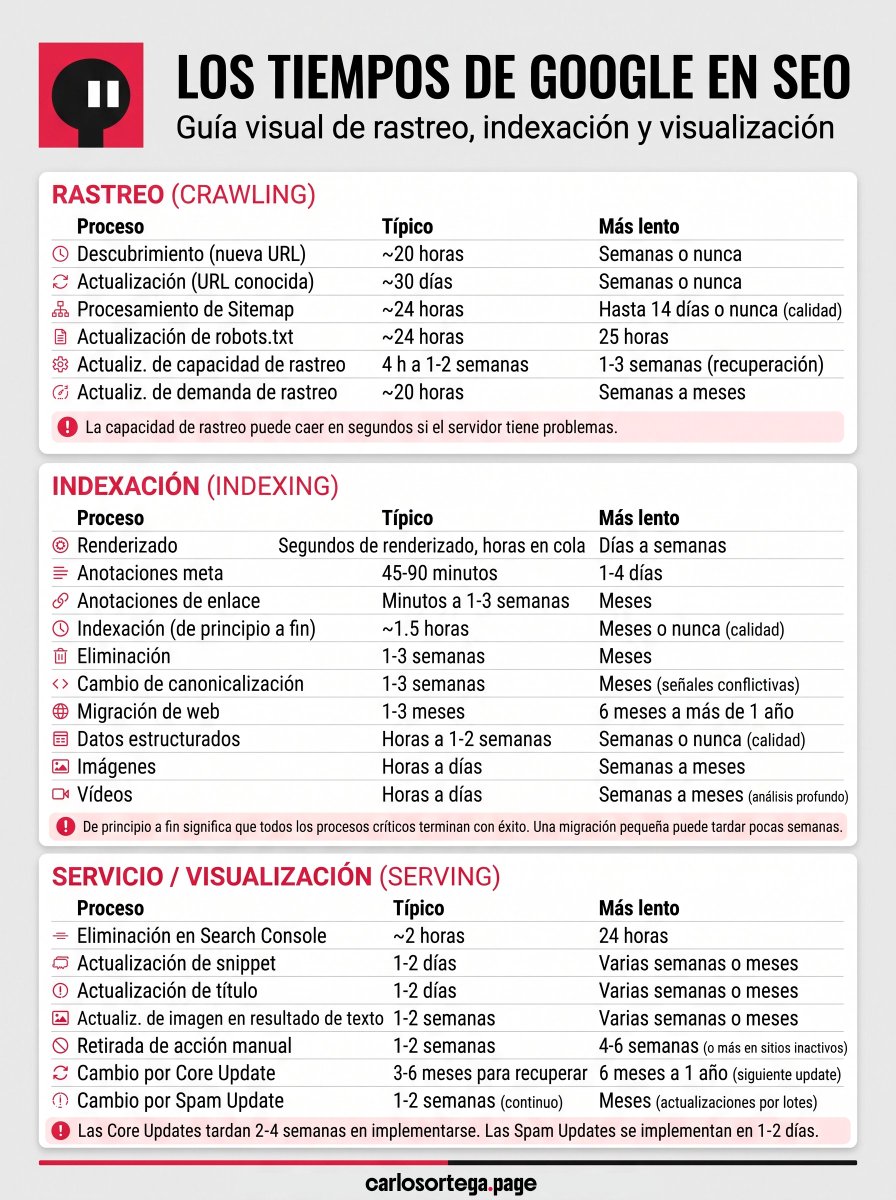
¿Sabes cuánto puede tardar Google en encontrar tu post recién publicado? ¿Y en indexarlo?
¿Cuánto puedes tardar en recuperarte de un mal Core Update?
Esos y otros muchos más datos similares los compartió Google en el evento de la semana pasada en Barcelona.
Y te los dejo todos, resumidos y listos para guardar o imprimir, en esta imagen 👇
¡Esta colección de skills tiene más de 100 mil estrellas!
Son 25 skills de Ingeniería de Addy Osmani.
✓ TDD, seguridad, review y Web Performance
✓ Spec, plan, build, test, review y ship
✓ Claude Code, Cursor, Codex...
→ https://t.co/LXVpnCyEnx
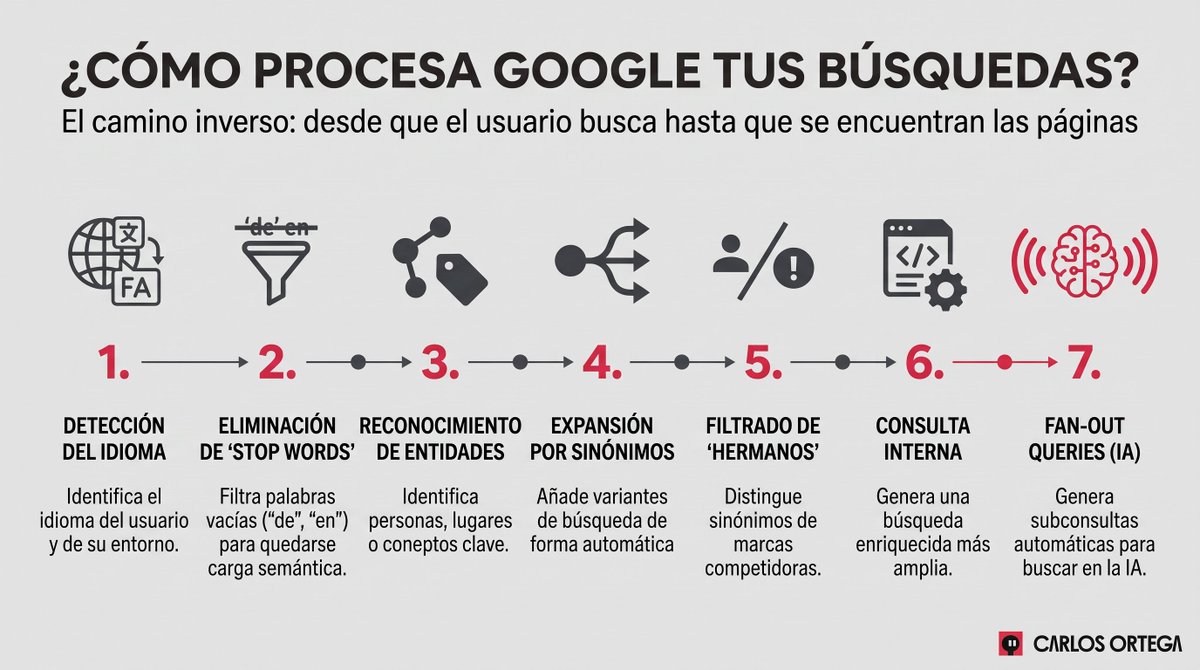
Se suele hablar mucho del camino de una página web hasta los resultados de Google, pero poco sobre el camino inverso: El camino de una búsqueda de usuario hasta encontrarse con esas páginas.
🤔 ¿Cómo entiende y procesa Google tus búsquedas?
Porque tú escribes cosas, pero eso no es lo que llega tal cuál a su índice para decidir qué resultados te muestra.
Google lo explicó la semana pasada en su evento en Barcelona.
Los pasos son principalmente:
1⃣ Detección del idioma
Google identifica el idioma en que has hecho la búsqueda para ofrecerte el contenido adecuado.
Si no le queda muy claro o buscas una marca, usa cosas como tu ubicación, los ajustes del navegador o la configuración del dispositivo para asegurarse.
2⃣ Eliminación de 'stop words'
Después, el buscador elimina palabras sin demasiada utilidad como "de" o "en" para centrarse en los términos con más carga semántica. Si estas palabras alteran el sentido global, mantiene sin embargo la frase entera.
Por ejemplo 'Señor' y 'Anillos' son dos entidades distintas. Pero juntas y con las preposiciones, indican claramente que buscas la entidad 'El Señor de los Anillos'.
3⃣ Reconocimiento de entidades
Google detecta por tanto si efectivamente buscas una u otra cosa/persona/lugar... Y así interpreta la búsqueda sobre ese elemento concreto, combinando texto con el Knowledge Graph, su universo de entidades correlacionadas.
4⃣ Expansión mediante sinónimos
Este paso es clave. El sistema reescribe la consulta añadiendo variantes aprendidas del comportamiento real de los usuarios. Esto conecta la búsqueda con ciertos contenidos aunque no usen exactamente las mismas palabras.
Es decir, tú quizás buscas 'PC' pero él busca también resultados para 'ordenador de sobremesa', ya que entiende que son lo mismo.
Google no usa lingüistas, así que no siempre usan sinónimos como tal, académicamente hablando. A veces establecen la relación igual entre conceptos que puedan parecernos más alejados ya que saben que el usuario busca en realidad lo mismo en ambos casos.
Irónicamente y aunque por lo general sabe cómo lidiar con ello, en ciertos casos el que una palabra tenga o no tilde puede llevarle a confusión...
5⃣ Filtrado de términos 'hermanos' (Siblings)
Google distingue entre sinónimos y marcas o productos competidores relacionados (como Canon y Nikon). Reconoce la categoría común, pero jamás los intercambia para no alterar la intención.
Así, si buscas 'ofertas Carrefour' nunca te mostrará resultados con ofertas de Mercadona. Sabe que son lo mismo (hipermercados) pero de diferentes marcas, con lo que no establece esa relación de 'sinónimo' que comentábamos en el punto anterior.
6⃣ Consulta interna reescrita
Al final, toda esta información se combina para formar una consulta interna mucho más amplia que la tecleada por ti.
'Pero ¿Y en sus resultados con IA? ¿Cómo funciona?'
Básicamente lo mismo, dicho por el propio John Mueller, ya que las AI Overview beben directamente de lo que toda la infraestructura del buscador le da.
Pero...
7⃣ Fan-out queries
Antes de darte resultados en la IA para tu búsqueda, expande dicha consulta con fan-out queries: Consultas relacionadas con la tuya con las que obtener resultados que la complementen.
Éstas siguen exactamente el mismo proceso de reescritura antes de consultar el índice, por cierto.