no sé en qué momento este post llegó a +600k impresiones.
hay algo de todo esto que vale la pena remarcar:
cuanto más escala el uso de agentes, más aparecen problemas de sistemas distribuidos que ya conocemos.
discovery, routing, permisos, observabilidad, ownership, etc.
por eso sigue siendo clave estudiar diseño de sistemas.
tu diferencial va a estar en saber qué pedirle a la IA y usarla para implementarlo más rápido.
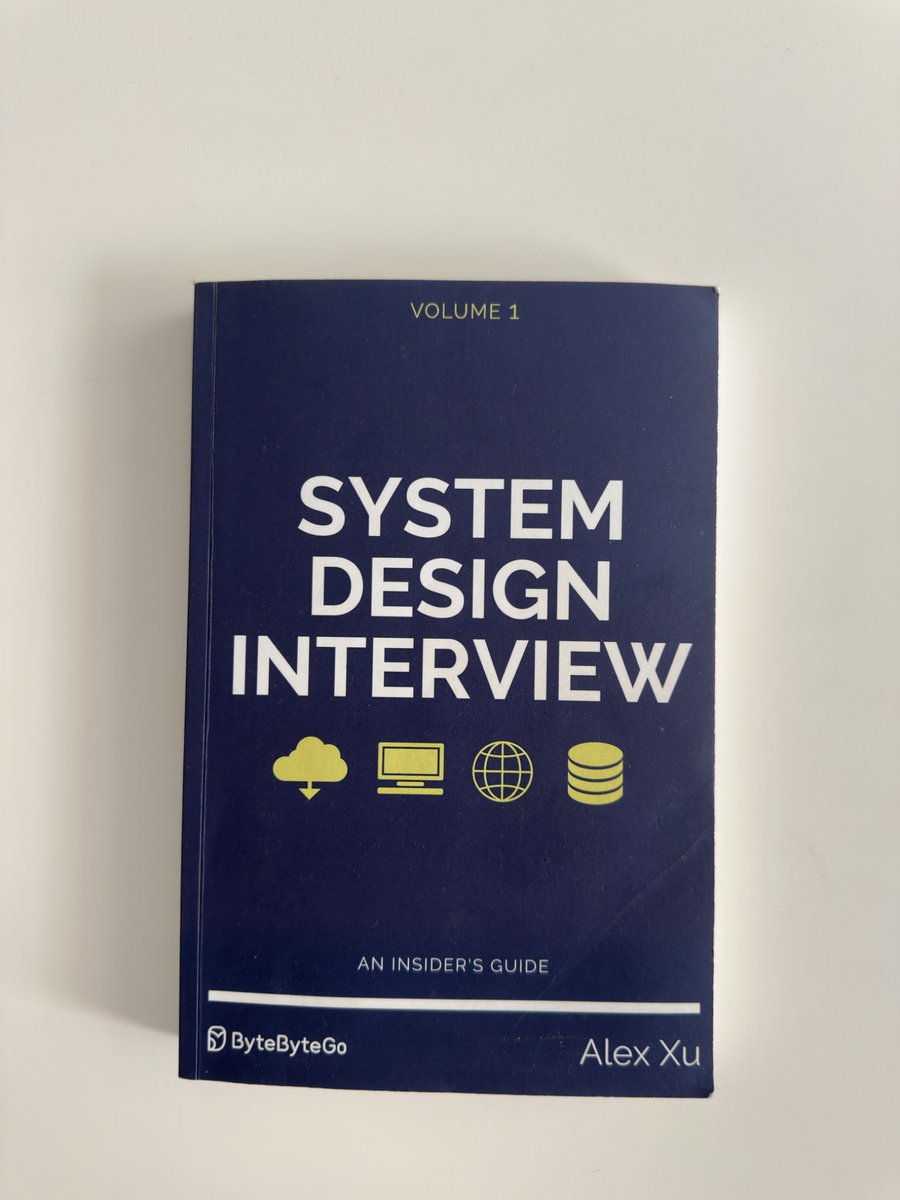
si quieren empezar a estudiar system design, les dejo mi libro favorito para arrancar:
System Design Interview, de Alex Xu.
estudiar Harness Engineering hoy es meterte temprano en una capa nueva del software.
todavía no están del todo definidas las mejores prácticas, las tools cambian todo el tiempo y hay muy poca gente realmente especializada.
por eso me parece un buen momento para aprenderlo: todavía estás a tiempo de entender cómo se está construyendo todo esto desde abajo.
hasta ahora, podías ser un buen dev sin involucrarte en el producto.
cada vez hay menos lugar para eso.
el futuro es del product engineer:
capacidad técnica + entender a fondo el negocio.
Spec-Driven Development es una forma de trabajar con agentes donde primero definís qué querés construir y recién después los dejás escribir código.
en vez de:
idea → prompt → código
hacés algo más parecido a:
idea → spec → plan → tareas → código → verificación
la spec deja claro cómo debería funcionar la feature, qué reglas tiene, qué casos borde existen y cómo sabés que quedó bien.
por ejemplo, en vez de pedir:
“agregá cancelación de suscripciones”
primero definís:
1) quién puede cancelar
2) qué pasa con pagos pendientes
3) qué pasa si cancelás 2 veces
4) qué estado queda guardado
5) cómo verificás el resultado
con eso, el agente entiende mucho mejor qué tiene que hacer y tiene menos margen para asumir cosas por su cuenta.
después puede usar esa spec para armar el plan, escribir el código y revisar si lo que hizo cumple con lo que definiste al principio.
la idea es dejar bien claro qué querés construir antes de que el agente empiece a trabajar. eso reduce errores, evita retrabajo y hace más fácil revisar si el resultado quedó como esperabas.
si usás Claude Code o Codex, ya estás usando un agente. pero si querés construir el tuyo, además de elegir el modelo y las tools, tenés que decidir cómo va a trabajar.
para eso existen distintos patrones. te explico 5 con un mismo caso: un agente que organiza viajes.
1) ReAct → decidir, actuar y observar.
elige una acción, usa una tool y toma el resultado como información para decidir cómo seguir.
ejemplo: busca vuelos y, si salen caros, prueba otras fechas.
2) Plan-and-Execute → planificar y después ejecutar.
divide el objetivo en pasos antes de ejecutarlos. puede revisar el plan según los resultados.
ejemplo: primero define cómo resolver transporte, alojamiento y actividades; después trabaja sobre cada parte.
3) Reflexion → aprovechar los intentos anteriores.
analiza cómo salió un intento y guarda una reflexión para orientar el siguiente. usa memoria acá.
ejemplo: registra que dejó poco tiempo para los traslados y lo tiene en cuenta al rehacer el itinerario.
4) Evaluator-Optimizer → generar, evaluar y corregir.
una llamada al modelo produce una propuesta y otra la revisa con criterios definidos. ese feedback sirve para mejorarla.
ejemplo: arma el itinerario, detecta que supera el presupuesto y lo ajusta.
5) Orchestrator-Workers → dividir y delegar.
un coordinador decide qué subtareas hacen falta, las delega a otros agentes y reúne los resultados.
ejemplo: según el viaje, reparte búsquedas de vuelos, alojamiento o requisitos de entrada.
¿cómo los implementás? con código que organiza las llamadas al modelo, las tools y la información que se guarda. un SDK como el de OpenAI te da las piezas. vos tenes que definir el flujo.
podés combinarlos: planificar con Plan-and-Execute, ejecutar cada paso con ReAct y revisar y corregir el resultado con Evaluator-Optimizer.
no todas las tareas necesitan el effort al máximo.
me gustó este flujo para trabajar con Claude Code:
1) pedile que te haga preguntas para definir bien la tarea.
2) implementá en low/medium, revisá lo que hizo e iterá.
3) pasá a high para verificar la solución y probar casos borde.
un detalle interesante de estas pruebas: más effort ayudó a detectar errores, pero no necesariamente a corregir un enfoque equivocado.
darle más tiempo no reemplaza tener bien definido qué querés resolver.
cuando diseñás un agente, también tenés que pensar qué pasa cuando algo falla.
algunas cosas a tener en cuenta:
1) reintentos: volver a probar si el error es temporal. ¿cómo? con un máximo de intentos y cada vez más tiempo entre uno y otro para no empeorar la saturación del servicio. (backoff)
2) timeouts: poner un límite a cuánto esperás una respuesta.
3) fallbacks: tener una alternativa si algo falla. otra tool, otro modelo o una forma de resolver parte de la tarea.
4) estado: guardar qué hizo y qué quedó pendiente. si procesó 80 de 100 documentos, que pueda retomar desde ahí.
5) human in the loop: definir cuándo frenar y pedir ayuda. explicar qué pasó, qué intentó y qué necesita para seguir.
6) logs: registrar qué tools usó, qué devolvieron y dónde hubo errores. si algo falla, necesitás entender qué pasó.
mucho de esto es ingeniería de software de siempre.
solo que ahora tenés un modelo que decide el próximo paso según el resultado del anterior (agent loop).
algunos usos posibles de Jev en el diseño de agentes:
1) elegir qué modelo usar según la tarea.
2) seleccionar el nivel de razonamiento (effort) del modelo según la dificultad.
3) elegir qué tool usar: buscar en la web, consultar una DB o llamar a una API.
4) evaluar los documentos recuperados en un RAG y seleccionar cuáles incluir en el contexto.
5) rutear un pedido al agente especializado que corresponda.
6) evaluar si un error requiere reintentar o cambiar de estrategia.
7) decidir cuándo seguir automáticamente y cuándo pedir intervención humana (human in the loop).
vos definís las opciones y los criterios.
Jev devuelve probabilidades y el harness las usa para decidir cómo sigue el agente.
Jev es un modelo de IA diseñado para tomar decisiones entre opciones que vos definís.
¿qué tiene de interesante?
(1) le pasás contexto y las opciones posibles. por ejemplo: una consulta y los modelos disponibles para resolverla. Jev elige cuál usar.
(2) devuelve probabilidades para cada opción. tu código puede usarlas para decidir si actuar o pedir una revisión.
(3) según TypeSafe, responde en 70–500 ms y cuesta USD 0,042 por millón de tokens de entrada, con salida gratis. en sus evaluaciones, reportan hasta 200x más velocidad y 400x menos costo que los LLMs comparados.
(4) puede servir para elegir tools, filtrar documentos que no aportan a una respuesta o detectar acciones que necesitan aprobación.
(5) no genera texto. complementa a los LLMs: Jev toma esas decisiones y otro modelo escribe, programa o razona en profundidad.
ojo que puede elegir mal. que respete las opciones que definiste no garantiza que la elección sea correcta.
si tu agente hace muchas llamadas solo para decidir el próximo paso, ese ahorro puede acumularse bastante.
muy claro el artículo:
Si queres aprender a diseñar y escalar aplicaciones, hay 2 libros que me cambiaron la forma de pensar los sistemas:
1) System Design Interview (Vol. 1):
Perfecto para empezar. Te enseña a razonar desde lo básico: cómo crece una app, qué pasa con el tráfico y cómo escalar.
2) Designing Data-Intensive Applications
Más técnico y profundo, pero una joya. Explica cómo funcionan las bases de datos, los sistemas distribuidos y arquitecturas.
Cuando entendes los principios detrás de un sistema, todo se vuelve más claro: las decisiones técnicas, los cuellos de botella y los trade-offs.
cada vez estoy más convencido de esto:
diseño de sistemas + orquestación de agentes va a ser una de las combinaciones más valiosas de los próximos años.
You can now set Claude Code's output style to Concise.
Claude leads with the result, keeps responses short, and still gives full detail when you ask.
Turn it on in /config → Output style, or set "outputStyle": "Concise" in settings.json.
Most people want to become AI Engineers
Very few know what to learn next
That's why I'm giving away one of the best Agentic AI Engineer Roadmaps for FREE to the first 4500 people only
Inside you'll learn
✅ Python Fundamentals
✅ LLM Fundamentals
✅ LangChain LangGraph CrewAI AutoGen
✅ LCEL Runnables & Workflows
✅ Memory Systems
✅ Tool Integrations
✅ RAG Systems
✅ Multi Agent Systems
✅ Real World AI Projects
✅ Interview Questions & Answers
72 Hours Only
How to get
Follow me (so I can DM you)
Like + RT
Comment "ROADMAP"
Once the limit is reached I'll stop sending it.
Esto es algo que mucho deberían tener cuenta cuando usan IA en general:
Y es que no es lo mismo escribir una descripción larga y genérica que usar el término técnico correcto.
Ejemplo:
Filtra la lista mientras voy escribiendo” ≠ Debounced search + client-side filtering
“Que se actualice solo sin recargar la página” ≠ Optimistic updates o Real-time con WebSockets
Conocer los nombres correcto en el area que estas trabajado, es la clave para que el modelo sea mas preciso.