نزلنا Session 3 من الـ AI Architecture Design Course
في السيشن دي بنعرف اكتر عن ال Real-World Engineering اللي محتاجها علشان تبني AI Platform من الصفر.
هتعرف إزاي تتعامل مع New-User Cold Starts، و تبني Hyper-Personalized Recommendation Engines، و تعمل Deployment ل Self-Hosted LLMs، والسيشن دي هتديك تصور واضح عن ال Architecture وال Engineering اللي ورا الأنظمة دي.
هنمشي في ال Stack بالكامل، بداية من Debezium CDC و Kafka، مرورا ب Feast Feature Stores، ووصولا ل GPU Clusters on GCP.
شوفوا ال Session كاملة من هنا:
https://t.co/Whcb3xLEOh
واستكشفوا ال Course Playlist كاملة:
https://t.co/LquLGjlu3G
#AI #MLOps #SystemDesign #EcommerceAI #MachineLearning #MLOpsMENA
Your Dashboard Says 200 OK. Your Model Is Wrong.
ممكن يكون عندك AI System شغال عادي، مفيش Errors والـ APIs كلها بترد بشكل طبيعي، لكن الـ Model نفسه بدأ يطلع Results مش دقيقة زي الأول.
وده لأن إن الـ System يكون شغال مش معناه بالضرورة إن الـ Model بيشتغل كويس.
عشان كده لازم نفرق بين نوعين من الـ Observability.
أولا: Infrastructure Observability
دي بتساعدنا نتابع حالة الـ Infrastructure والـ Services، ونعرف لو فيه مشاكل في الأداء أو التشغيل.
فيه Tools زي:
- Prometheus: لمتابعة الـ Metrics والـ Alerts.
- Grafana: لعرض الـ Metrics في Dashboards.
- Loki: لتجميع ومتابعة الـ Logs.
لكن ده مش كفاية عشان نعرف إذا كان الـ Model لسه بيقدم نتائج كويسة ولا لأ.
ثانيا: AI Observability
هنا بنبدأ نتابع الـ AI System نفسه، زي:
- Output Quality: هل الـ Model بيطلع نتائج صحيحة؟
- Evaluation Scores: هل جودة النتائج بتتحسن ولا بتقل؟
- Prompt Versions: هل تغيير الـ Prompt أثر على الـ Output؟
- Latency & Cost: كل Request بتاخد وقت قد إيه وبتكلف كام؟
وفيه Tools بتساعدنا نتابع ده:
- Langfuse: لمتابعة الـ LLM Traces والـ Prompts والـ Evaluations.
- MLflow: لمتابعة الـ Experiments وإدارة الـ Model Versions.
- Evidently AI: لمتابعة الـ Data Drift والـ Model Performance في الـ Classical ML.
ثالثا: اربط الـ Monitoring بالـ Business KPIs
خلينا ناخد مثال من الـ Marketing Automation System.
لو عندك Recommendation Model بيقترح منتجات للمستخدمين، ممكن تلاقي إن كل حاجة شغالة كويس من ناحية الـ Infrastructure، لكن الـ Sales Take-rate بدأ يقل.
هنا لازم تفكر إذا كان فيه تغيير في الـ Data أو إن الـ Model Performance بدأ يتراجع.
المهم إنك متستناش لحد ما الـ System يقع عشان تعرف إن فيه مشكلة.
الـ Infrastructure Monitoring بيقولك إذا كان الـ System شغال، لكن AI Observability بتساعدك تعرف إذا كان بيقدم النتائج المطلوبة ولا لأ.
وده جزء مهم من تصميم أي AI System للـ Production.
لو مهتم بالـ System Design أو Software Architecture أو AI Engineering، تقدر تتابع باقي السيشنز من هنا:
Playlist:
https://t.co/hYAvRDrJTV
Resources | Idea 4
Documentation:
- Evidently AI: https://t.co/HNYWj218B0
- Langfuse: https://t.co/6wIptMIXzR
Tutorials:
- Evidently AI: https://t.co/6dbPQmkGdQ
- Langfuse: https://t.co/dD6K48jJYx
Repositories:
- Evidently AI: https://t.co/D2l0QLWq0Z
- Langfuse: https://t.co/szp149LCYu
Crash Courses:
- https://t.co/POcCo7R7Rj
- https://t.co/9HpPtTsduO
Follow MLOps MENA Community for more:
https://t.co/LIgkOLwCsF
#AIArchitecture #MLOps #LLMOps #AIObservability #MLOpsMENA #EvidentlyAI #Langfuse #MLflow #SystemDesign #AIEngineering
Your model has 95% accuracy in the notebook. But can anyone actually use it?
ممكن تكون دربت Model وحققت Accuracy كويسة جدا، لكن ده مش معناه إنه جاهز للـ Production.
فيه فرق بين إن الـ Model يشتغل كويس في الـ Notebook وإنك تحوله لـ Service حقيقية يقدر الـ Users يتعاملوا معاها.
وده من المواضيع اللي اتكلمنا عنها في الـ AI Architecture Design Course.
خلينا نشوف إيه اللي محتاج تفكر فيه:
1. Model Serving
إزاي تخلي الـ Applications تبعت Requests للـ Model وتستقبل الـ Predictions؟
- BentoML: لتحويل الـ Model إلى API وتجهيزه للـ Deployment.
- KServe: للـ Model Serving على Kubernetes، مع Autoscaling وCanary Rollouts.
- vLLM: لتشغيل الـ LLMs بكفاءة عالية ودعم Continuous Batching.
2. API Design
الـ API مش مجرد Request وResponse. لازم تفكر في:
- Synchronous vs Asynchronous Processing
- Request Batching
- Timeouts and Retries
- Rate Limits
- Latency and Scalability
القرارات دي بتفرق جدا لما الـ Traffic يزيد أو تحصل Failures.
3. Orchestration
إيه لو الـ Request محتاجة أكتر من Model؟
مثلا، Model تعمل Classification، وبعدها Model تانية تعمل Ranking، وفي النهاية Model تولد الـ Response.
هنا محتاج تحدد ترتيب الخطوات، والـ Dependencies بينها، وإزاي تتعامل مع الـ Failures.
الخلاصة: الـ Model لوحده مش كفاية. لازم يكون فيه System يقدر يشغله ويقدمه للـ Users بشكل موثوق.
علشان كده، الـ Serving والـ APIs والـ Orchestration مش تفاصيل نأجلها لما بعد الـ Training، لكنها جزء من تصميم الـ AI System نفسه.
Playlist:
https://t.co/hYAvRDrc4n
Resources | Idea 2
Documentation:
- BentoML: https://t.co/iJchrQbf32
- KServe: https://t.co/xrLuZuTKAa
- vLLM: https://t.co/RkSJPao3CV
Tutorial:
https://t.co/CBqFF3UZoA
Repository:
https://t.co/CGjOYTu0EJ
Videos:
- https://t.co/oyKlN5K3db
- https://t.co/qzxS94yVKh
Follow MLOps MENA Community for more:
https://t.co/LIgkOLw4D7
#AIArchitecture #MLOps #AIEngineering #SystemDesign #ModelServing #LLMOps #MLOpsMENA
لو الـ AI Security Strategy بتاعتك مجرد Document محدش بيراجعه أو بيتأكد إن الـ System ملتزم بيه، يبقى إنت معندكش Security Strategy حقيقية.
الـ Governance مش مجرد Policies، دي Engineering Practice لازم تكون جزء من تصميم وبناء وتشغيل السيستم.
تخيل إنك بتبني Marketing Automation System باستخدام AI Agents بيتعامل مع Customer Data، وبيطلع Recommendations، وبينفذ Campaigns بشكل Automated.
أي قرار غلط ممكن يتحول لمشكلة في Security أو Privacy أو Cost أو Business Control.
إزاي نطبق الـ Governance فعليا؟
1. Architecture Principles
حدد مبادئ واضحة مرتبطة بأهداف الـ Business، زي حماية بيانات العملاء، وHuman Oversight للقرارات المهمة، وتقييم الـ AI قبل الـ Production.
2. Architecture Decision Records (ADRs)
وثّق القرارات المهمة والبدائل والـ Trade-offs، زي الاختيار بين API-based وSelf-hosted LLM، أو Real-time وBatch Processing.
3. Architecture Review Board (ARB)
راجع الـ Security، والـ Privacy، والـ AI Evaluations، والتكلفة، والـ Human Oversight قبل الـ Deployment.
4. Automated Engineering Guardrails
استخدم Automated Checks في الـ CI/CD لاكتشاف أو منع المخالفات، زي فشل الـ Required Evaluation Tests أو غياب Security Settings إلزامية.
مش كل مخاطر الـ AI قابلة للأتمتة، لكن الـ Guardrails بتقلل الاعتماد على الـ Manual Review وحدها.
وده التطبيق العملي في الـ Mini-project بتاع Session 1:
Define 5 Architecture Principles مرتبطة بالـ Business Goals.
Document 3 ADRs.
Build an ARB Checklist.
Add one automated guardrail.
الفكرة إننا منستناش لحد ما السيستم يخلص عشان نفكر في الـ Governance. لازم تكون مدمجة في الـ Architecture Decisions والـ Testing والـ Deployment.
الـ Governance الفعالة هي اللي تقدر تتحقق منها، مش بس تقرأها.
في Session 1 من كورس AI Architecture Design ، طبقنا المفاهيم دي من خلال:
Define 5 Architecture Principles.
Document 3 ADRs.
Build an Architecture Review Board Checklist.
Implement an automated guardrail في الـ CI/CD.
الهدف إنك تحول الـ Governance من مجرد Policies مكتوبة إلى Engineering Controls تقدر تتحقق منها وتفرضها خلال ال life cycle للسيستم.
Course link:
https://t.co/hYAvRDrc4n
Resources:
Microsoft — https://t.co/LHJunrcnZX
NIST AI RMF Playbook — https://t.co/U4labEgk67
NIST AI RMF Video — https://t.co/RRzNCPo410
OWASP AISVS — https://t.co/4tBGcZYTAM
Follow MLOps MENA for more:
https://t.co/LIgkOLw4D7
#AIArchitecture #AIGovernance #AISecurity #SystemDesign #MLOps #ResponsibleAI
New Course from MLOps MENA
Kubernetes Mastery: From Containers to Production & AI Infrastructure
في Kubernetes Mastery هتتعلم من الأساسيات لحد تشغيل Production Clusters، من خلال Hands-on Labs وReal-world Projects.
Course Curriculum:
- Kubernetes Architecture & Workloads
- Networking, Storage & Cluster Security
- Deployments, Scaling & Troubleshooting
- Amazon EKS, Helm & GitOps
- GPU Workloads & AI Infrastructure
مش مجرد Theory! كل Concept هتتعلمه هتطبقه من خلال YAML examples، Commands، وHands-on Labs، علشان تكتسب ال Skills اللي محتاجها في Real-world Scenarios.
Duration: 5 weeks
Time commitment: 3 hours/week
Level: Junior to Mid
Price: FREE
Starting Date: 31 October
سجل من هنا:
https://t.co/AG0l9dtvQJ
Course Details:
https://t.co/3jdqpjfcW8
#MLOpsMENA #Kubernetes #DevOps #MLOps #AIInfrastructure
عمرك فكرت ليه AI Model بيطلع نتائج ممتازة في الـ Notebook، ممكن يفشل تماما في الـ Production؟
تخيل إنك بنيت AI-powered Marketing System بيعمل Product Recommendations وبيساعد الـ Business يزود الـ Sales.
كل حاجة شغالة تمام في الـ Testing، والـ Model بيطلع نتائج كويسة.
بس أول ما تنزل الـ System Production، ويبدأ آلاف المستخدمين يستخدموه في نفس الوقت، ممكن تكتشف إن الدنيا مش ماشية زي ما كنت متوقع.
الـ Response Time بقى بطيء.
الـ System مش قادر يستحمل الـ Traffic.
الـ LLM API وصل للـ Rate Limits.
ولو خدمة وقعت، ممكن تأثر على باقي الـ System.
طب إيه المشكلة؟ ما الـ Model كان شغال كويس في الـ Testing!
المشكلة إن نجاح الـ Model لوحده مش كفاية. إنت مش بتبني Model وبس، إنت بتبني System كامل المفروض يشتغل بكفاءة في ظروف حقيقية.
وعلشان كده، وإنت بتصمم الـ Architecture، فيه شوية حاجات لازم تفكر فيها من البداية:
**Performance:** هل الـ Response Time مناسب للـ Use Case؟
**Scalability:** لو عدد المستخدمين زاد فجأة، هل الـ System هيقدر يستحمل؟
**Availability:** لو الـ LLM Provider وقع، إيه اللي هيحصل؟ وهل الـ System عنده طريقة يتعامل بيها مع المشكلة؟
**Security:** إزاي تضمن إن الـ Customer Data محمية؟
كل نقطة من دول ممكن تغير قراراتك في الـ Architecture.
مثلا، لو محتاج الـ System يطلع Recommendations في الوقت الفعلي، لازم تفكر في الـ Latency من البداية.
ولو بتستخدم LLM API، لازم تحسب حساب الـ Rate Limits والـ Timeouts والـ Retries، وتحدد إيه اللي هيحصل لو الـ API مبقاش متاح.
ولو الـ System بيقع كل ما يحصل Failure في جزء منه، يبقى محتاج تراجع طريقة تصميمك للـ System والتعامل مع الأخطاء.
**الفكرة هنا إن الـ Model ممكن يكون ممتاز، لكن الـ System اللي حواليه هو اللي يحدد إذا كان ينفع تعتمد عليه في الـ Production ولا لأ.**
وده ليه الـ Quality Attributes لازم تكون جزء من الـ Architecture Design من البداية، مش حاجة تبدأ تفكر فيها بعد ما تخلص Implementation.
وده من الحاجات اللي بنتعلمها في AI Architecture Design Course، وإزاي ناخد قرارات في التصميم بناء على الـ Requirements والـ Business Goals، مش مجرد إننا نخلي الـ Model يشتغل.
لو مهتم بالـ System Design أو Software Architecture أو AI Engineering، تقدر تتابع السيشنز من هنا. كل يوم هننزل Session جديدة، وكمان هيكون فيه Cohorts تانية تقدر تشارك فيها لو حابب تحضر Live.
**Playlist:**
https://t.co/hYAvRDrc4n
**Resources | Idea 3**
Follow MLOps MENA Community for more:
https://t.co/LIgkOLw4D7
وسؤال ليك:
لو الـ AI Model بتاعك شغال كويس في الـ Testing، إيه أكتر حاجة هتقلقك قبل ما تنزله Production: الـ Performance، ولا الـ Scalability، ولا الـ Security؟
#SoftwareArchitecture #SystemDesign #AIArchitecture #AIEngineering #MLOps #MLOpsMENA
عمرك رسمت Architecture Diagram وبعد ما خلصتها اكتشفت انك محتاج Diagram تانية عشان تشرح الاولى؟
المشكلة ممكن تكون انك بتحاول تعرض تفاصيل كتير في نفس المستوى، بدل ما تقسم الـ Architecture لمستويات واضحة.
وهنا بييجي دور الـ C4 Model.
الـ C4 Model بيقدم طريقة بسيطة لتنظيم وشرح الـ Software Architecture من الـ Big Picture لحد تفاصيل الـ Code، عن طريق 4 مستويات:
1. System Context (C1)
مين بيستخدم الـ System؟ وايه الـ External Systems اللي بيتعامل معاها؟
ده المستوى المناسب للـ CTOs والـ Business Stakeholders عشان يفهموا الـ System Boundaries والـ Big Picture.
2. Containers (C2)
الـ System متكون من ايه على مستوى الـ Applications والـ APIs والـ Databases والـ Queues؟
ده بيوضح الـ High-Level Technical Architecture وتفاعل الاجزاء الرئيسية مع بعضها.
3. Components (C3)
كل Container جواه ايه من Modules او Components؟ وكل جزء مسؤول عن ايه؟
هنا بنبدأ نفهم الـ Internal Structure بشكل اعمق.
4. Code (C4)
ازاي الـ Components متنفذة على مستوى الـ Classes والـ Code؟
وده مستوى تفصيلي بيحتاجه الـ Developers وقت التنفيذ، ومش ضروري في كل Architecture Diagram.
طب نطبق ده على AI Application ازاي؟
تخيل انك بتصمم AI-powered Customer Support System.
* في C1، بتوضح علاقة الـ Customer والـ Support Team بالـ System والـ External Services.
* في C2، بتعرض الـ Frontend والـ Backend API والـ RAG Service والـ Vector Database والـ LLM Provider.
* في C3، بتفصل الـ RAG Service لمكونات زي الـ Retriever والـ Reranker والـ Prompt Builder.
* في C4، بتوضح تفاصيل الـ Classes والـ Functions المسؤولة عن تنفيذ الـ Retrieval والـ Prompt Construction.
لاحظ ان كل مستوى بيجاوب على سؤال مختلف، وبيقدم التفاصيل المناسبة للـ Audience اللي قدامه.
نفهم من كده الـ Architecture مش مجرد Boxes وArrows. هي وسيلة Communication بتساعد كل Stakeholder يفهم الجزء اللي محتاجه من غير ما يتوه في تفاصيل مش مهمة بالنسبة له.
قبل ما ترسم اي Diagram، اسأل نفسك: مين الـ Audience؟ وايه السؤال اللي محتاج الـ Diagram تجاوب عليه؟
ولو محتاج توصل نفس التصميم للـ CTO والـ Developer، مش لازم تعمل Diagram واحدة فيها كل حاجة. استخدم الـ Right Level of Abstraction لكل Audience.
وده كان جزء من AI Architecture Design Course - Session 1.
تابعوا الكورس من خلال الـ Playlist دي بننزل سيشن جديدة كل اسبوع:
https://t.co/x0gtN1Vy54
⸻
Resources to learn the C4 Model
Documentation
* C4 Model: https://t.co/AKdpfb5KeF
* Introduction: https://t.co/BJuuFToPS8
* Diagrams: https://t.co/SxWdEiYREN
Tutorials & Repositories
* Structurizr DSL Tutorial: https://t.co/ueX0rs32Bb
* C4 Model Example: https://t.co/vo9S4qGpvA
Crash Courses
English:
* https://t.co/K3sbBqevVK
* https://t.co/2ankfL0JNn
Arabic:
* https://t.co/PpkTZjtBrX
Follow MLOps MENA for more:
https://t.co/LIgkOLw4D7
#SoftwareArchitecture #SystemDesign #C4Model #AIArchitecture #MLOps #TechEducation
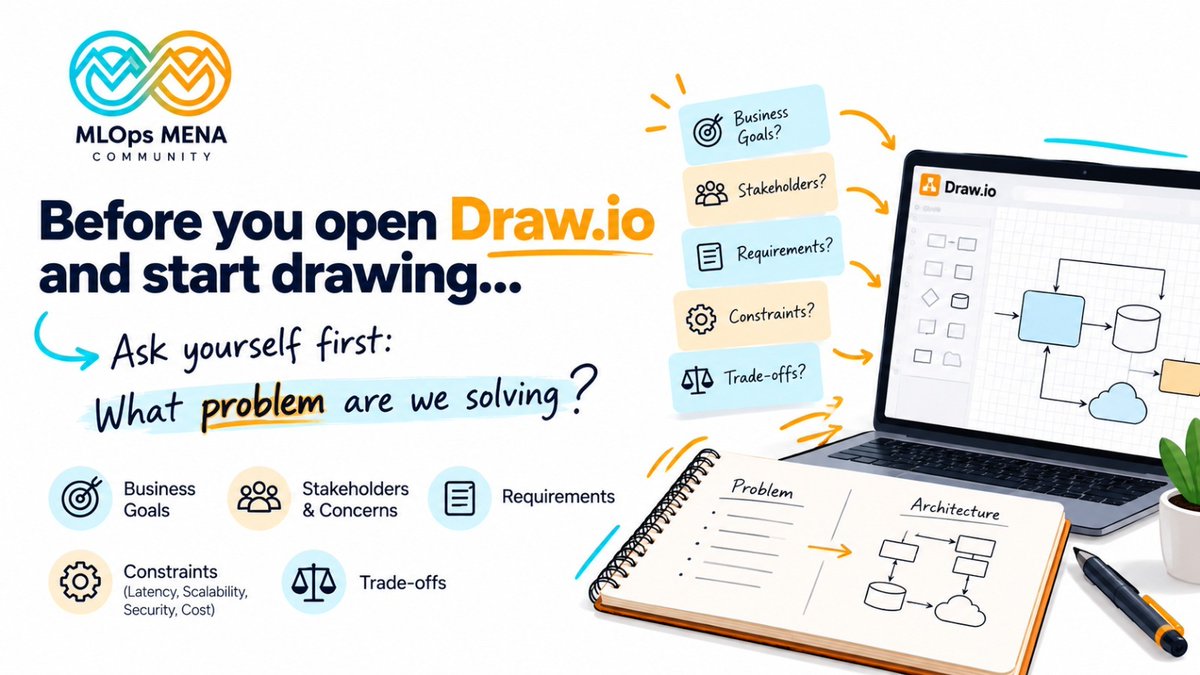
قبل ما تفتح https://t.co/NAQ7p8NrL6 وتبدأ ترسم Architecture، اسأل نفسك الأول: إحنا بنحل مشكلة إيه أصلا؟
من أهم الأفكار اللي اتكلمنا عنها في أول Session من AI Architecture Design Course هي إن الـ Architecture Design مش بيبدأ بالرسم، لكنه بيبدأ بفهم المشكلة والـ Business محتاج إيه بالظبط.
من الأخطاء اللي ممكن تحصل وإنت بتصمم System إنك تبدأ تختار Technologies وترسم Components وتوصلها ببعض، قبل ما تكون فاهم الـ Problem.
تبدأ تفكر هنستخدم أنهي Database، وهل محتاجين Message Queue، وإزاي نقسم الـ Services.
وفي الآخر ممكن تطلع بـ Diagram شكله حلو جدا، بس الـ Architecture نفسها مش مناسبة للمشكلة اللي المفروض تحلها.
علشان كده، قبل ما تبدأ التصميم، محتاج تسأل نفسك شوية أسئلة:
إيه الـ Business Goals اللي المفروض نوصل لها؟
مين الـ Stakeholders، وإيه الـ Concerns بتاعتهم؟
إيه الـ Requirements اللي لازم الـ System يحققها؟
إيه الـ Constraints اللي عندنا، سواء في الـ Latency أو الـ Scalability أو الـ Security أو الـ Cost؟
وإيه الـ Trade-offs اللي نقدر نتقبلها؟
الأسئلة دي ممكن تغير قراراتك في التصميم بالكامل.
مثلا، لو الـ Business محتاج Personalization في الوقت الفعلي، فالاعتماد على Batch Processing بس ممكن ميكونش مناسب.
ولو عندك Requirements قوية للـ Security والـ Privacy، مش هينفع تختار الحل لمجرد إنه أسرع أو أحدث Technology موجودة.
في السيشن، اتكلمنا كمان عن الـ Architecture Development Process، واللي بيبدأ بتحديد الـ Scope والـ Context، وبعدها التواصل مع الـ Stakeholders وفهم الـ Concerns بتاعتهم، ثم تصميم الـ Architecture، وفي النهاية إنشاء Skeleton System يساعدنا نختبر اتجاهنا.
والنقطة المهمة هنا إن كل قرار في الـ Architecture لازم يكون ليه سبب واضح ومرتبط باحتياج حقيقي، مش لمجرد إن الـ Technology دي مشهورة أو إحنا متعودين نستخدمها.
وده مهم جدا في AI Systems كمان، لأن قرارات زي اختيار الـ Model، وطريقة استضافة الـ LLM، وتصميم الـ Data Pipelines، والـ Security والـ Evaluation، كلها قرارات ليها تكلفة وTrade-offs.
لو مهتم بالـ System Design أو Software Architecture أو AI Engineering، دي بلاي ليست الكورس، تقدر تتابع منها السيشنز. كل يوم هننزل Session جديدة، وكمان هيكون فيه Cohorts تانية تقدر تشارك فيها لو حابب تحضر Live.
Playlist:
https://t.co/hYAvRDrc4n
Resources | Idea 1
Documentation:
https://t.co/G2gsreM8xX
Tutorial:
https://t.co/itAS7nVPl4
Repository:
https://t.co/LLO52TB2qg
Crash Course:
https://t.co/pJM20KQAtT
Follow MLOps MENA Community for more:
https://t.co/LIgkOLw4D7
وسؤال ليك: لما بتبدأ System Design جديد، بتبدأ بفهم الـ Requirements والـ Business Goals، ولا بتفكر في الـ Technologies والـ Components الأول؟
#SoftwareArchitecture #SystemDesign #AIArchitecture #AIEngineering #MLOps #MLOpsMENA
خلينا نتفق على حاجة: الـ Senior Engineer مش هو الشخص اللي حافظ Tools أكتر، لكن هو الشخص اللي بيفكر بطريقة مختلفة لما حاجة تبوظ في الـ Production.
تخيل إن الـ Model بتاعك بدأ يطلع Predictions غريبة.
الـ Junior ممكن يفكر "خليني أستنى الـ Ground Truth Labels عشان أشوف الـ Model Performance اتأثرت ولا لأ."
لكن الـ Senior بيكون Mature اكتر وبيقول "طب إيه اللي اتغير؟ وهل أقدر أكتشف المشكلة قبل ما الـ Labels توصل؟"
وهنا بيبدأ ال shift من ال junior mindest لل senior mindset
بدل ما تركز على الـ Model بس، وسع نظرتك للـ Entire ML System
Data Monitoring: هل فيه Data Drift أو مشاكل في الـ Data Quality؟
Prediction Monitoring: هل توزيع الـ Predictions اتغير بشكل غير طبيعي؟
Pipeline Monitoring: هل فيه Failures أو تأخير في الـ Data Processing؟
Infrastructure Monitoring: هل فيه Resource Saturation أو مشاكل في الـ Service Availability؟
الفكرة مش إنك تراقب كل حاجة وخلاص، لكن إنك تعرف إيه الـ Signals اللي ممكن تكشف المشكلة بدري، وإزاي تربطها ببعض عشان توصل للـ Root Cause.
ونفس الـ Mindset دي محتاجها في الـ Interview.
لما تتسأل عن Production Incident، متكتفيش بإنك تحكي المشكلة والـ Fix.
احكيها بالترتيب ده:
C — Context: إيه اللي حصل؟
S — Signal: عرفت منين إن فيه مشكلة؟
A — Action: عملت إيه عشان تحدد الـ Root Cause وتحلها؟
O — Outcome: إيه اللي اتغير بعد الحل؟
L — Lesson: إيه اللي اتعلمته، وإزاي منعت تكرار المشكلة؟
دي مش مجرد طريقة لترتيب إجابتك دي طريقة تفكير بتخليك تنتقل من مجرد شخص بيحل Problems لشخص بيفهم الـ System وبيحسن منه كمان.
The shift is simple: Don't just fix production problems. Learn how to detect them earlier, understand them deeper, and prevent them from happening again.
📚 Resources to learn more:
Google Cloud — Model Monitoring
https://t.co/3i6jA5Jzag
Google SRE — Monitoring Distributed Systems
https://t.co/08bE06FLtB
Google SRE — Incident Response Workbook
https://t.co/gb5X8gpxlf
MLOps Production Interview
https://t.co/0AuhpSEqfX
Incident Response Runbooks — GitHub
https://t.co/n9RQc8yCAb
SREcon25 — Monitoring ML in Production
https://t.co/6etYBvSxAq
Follow MLOps MENA Community for more .
https://t.co/LIgkOLw4D7
#MLOps #MachineLearning #Observability #SRE #ModelMonitoring #MLOpsMENA
مش كل مشكلة بتحصل في الـ Production معناها إن الـ Model نفسه فيه مشكلة.
ساعات السبب بيكون في الـ Data Pipeline، أو الـ Infrastructure، أو الـ Dependencies، أو حتى في الـ Configuration.
عشان كده، مهم يكون عندنا Root Cause Analysis بطريقة منظمة نقدر نمشي بيها من اول اكتشاف المشكلة لحد ما نعرف ال Root Cause
خلينا نقسمها لـ 5 خطوات
1. Identify the Problem
نحدد المشكلة، ونفهم تأثيرها على الـ Users والـ System، وإيه اللي اتغير قبل ما تحصل.
2. Inspect Observability Data
نراجع الـ Metrics والـ Logs والـ Traces عشان نفهم إيه اللي حصل، وإمتى بدأ، وفين ممكن يكون السبب.
3. Find the Root Cause
نحلل الأدلة ونختبر الفرضيات بدل ما نفترض إن أول حاجة ظهرت هي السبب الحقيقي للمشكلة.
4. Fix and Validate
نعمل الـ Fix المناسب، ونتأكد إن المشكلة اتحلت وإن التغيير مش عامل مشاكل جديدة.
5. Prevent Recurrence
نضيف الـ Alerts المناسبة، ونحسن الـ Monitoring، ونكتب Regression Tests أو Runbooks تساعدنا نكتشف المشكلة ونتعامل معاها بشكل أفضل لو اتكررت.
الفكرة مش إننا نرجع الـ System يشتغل وخلاص، لكن إننا نفهم سبب المشكلة ونقلل احتمالية تكرارها.
Resources to learn more:
📚 Documentation:
Google SRE — Incident Management Guide
https://t.co/ouzjYozMKr
Google Cloud — Developing High-Quality ML Solutions
https://t.co/d1DCxEQkxS
📖 Tutorial:
Google SRE Workbook — Incident Response
https://t.co/JAy4JkHfDX
💻 Repository:
Incident Response Runbooks
https://t.co/XmuXnEIrKD
🎥 Crash Course:
https://t.co/8WAMJ0Xcsj
تابعوا السلسلة عشان تتعلموا أكتر عن الـ MLOps والـ LLMOps والـ Production Best Practices.
Follow for more:
https://t.co/LIgkOLw4D7
إزاي تعرف إن الـ RAG System بتاعك بيطلع إجابات كويسة فعلا، مش مجرد إجابات شكلها مقنع؟
الموضوع مش إن الـ Retrieval يجيب الـ Documents الصح وخلاص. ممكن الـ LLM يكون عنده الـ Context المناسب، ومع ذلك يطلع إجابة فيها معلومات مش موجودة في المصادر، أو يجاوب على جزء من السؤال ويسيب الباقي.
علشان كده، وإنت بتعمل Evaluation للـ RAG System، فيه اتنين Metrics مهم تفهم الفرق بينهم:
1. Faithfulness
هل المعلومات اللي في الإجابة موجودة فعلا في الـ Retrieved Context، ولا الـ LLM أضاف تفاصيل من عنده أو غير في المعلومات اللي قدامه؟
2. Response Relevancy
هل الإجابة بترد على سؤال الـ User فعلا، ولا بتتكلم في نفس الموضوع بس مش بتجاوب على المطلوب بالكامل؟
طب خلينا ناخد مثال بسيط.
لو سألت عن مكان وتاريخ حدث معين، والـ LLM ذكر تاريخ مش موجود في المصادر أو خالف التاريخ الموجود فيها، فهنا عندك مشكلة في الـ Faithfulness.
لكن لو ذكر المكان صح ونسي يجاوب عن التاريخ، فدي مشكلة في الـ Response Relevancy.
والنقطة المهمة إن الإجابة ممكن تكون مرتبطة بالسؤال جدا، لكنها في نفس الوقت غلط. علشان كده، الاعتماد على Metric واحدة مش كفاية.
باستخدام Ragas، تقدر تقيس الـ Metrics دي وتستخدم النتائج علشان تفهم جودة الإجابات وتحدد إيه اللي محتاج يتحسن في الـ RAG Pipeline.
ولو بتشتغل على RAG Applications، فيه كام حاجة تستحق إنك تركز عليها:
- إزاي كل Metric بتتحسب؟
- إزاي تقرأ الـ Scores وتعرف هي بتقولك إيه فعلا؟
- إزاي تفرق بين مشكلة في الـ Retrieval ومشكلة في الـ Generation؟
- وإزاي تخلي الـ Evaluation جزء من الـ Testing والـ CI Pipeline قبل كل Release؟
دي بالضبط الحاجات اللي بتفرق بين إنك تبني RAG System وإنك تعرف تقيس جودته وتحسنه باستمرار.
Resources
Crash Course — Building & Evaluating Advanced RAG:
https://t.co/Zl0Wye19g7
Tutorial — RAG Evaluation with Ragas:
https://t.co/ViZampzCAu
Documentation — Available Metrics:
https://t.co/GiSSBwMneK
GitHub Repository:
https://t.co/a0LUgI3g8w
Follow for more:
https://t.co/LIgkOLw4D7
#MLOps #RAG #Ragas #LLMEvaluation #GenerativeAI #LLM #AIEngineering #MachineLearning #MLOpsMENA
إزاي تعرف الـ LLM Application بتاعتك بتتصرف إزاي في الـ Production؟
مجرد إن الـ LLM بيرجع إجابات صحيحة مش معناه إن السيستم شغال بكفاءة.
ممكن تلاقي الـ Response بطيء، أو الـ Token Usage زاد فجأة، أو الـ API Cost بقى أعلى من المتوقع. وممكن كمان الـ RAG System يرجع إجابة غلط، من غير ما تعرف المشكلة في الـ Retrieval ولا الـ Prompt ولا الـ Model نفسه.
هنا بييجي دور LLM Observability.
باستخدام Langfuse، تقدر تتابع كل Request وتفهم اللي بيحصل جواه من خلال:
Traces & Spans: تتبع رحلة الـ Request بالكامل، من أول الـ Retrieval لحد الـ Final Response، وتحدد كل Step استهلك وقت قد إيه.
Latency Monitoring: تعرف التأخير جاي من الـ LLM Call ولا من الـ Database ولا من الـ Tool Calls.
Token Usage & Cost Tracking: تراقب استهلاك الـ Input/Output Tokens والتكلفة حسب الـ Model أو الـ User أو الـ Feature، وتكتشف أي زيادة غير متوقعة.
Debugging RAG Pipelines: لو الإجابة غلط، تراجع الـ Retrieved Chunks والـ Prompt والـ Model Output علشان تحدد مصدر المشكلة بدل ما تعتمد على التخمين.
Evaluation & Quality Monitoring: تربط الـ Traces بالـ User Feedback والـ Evaluation Scores، وتتابع جودة الإجابات جنب الـ Latency والـ Cost.
Production Best Practices: تفصل بين الـ Staging والـ Production، وتحمي الـ Sensitive Data، وتستخدم Dashboards وAlerts لمتابعة أداء السيستم.
طب إيه أهم حاجة تعرفها؟
إنك مش بس تعرف الـ Observability، لكن كمان تعرف تتعامل مع Production Scenarios زي:
الـ LLM Cost زاد للضعف، هتبدأ التحقيق منين؟
الـ RAG بيرجع إجابات غلط، إزاي تحدد مصدر المشكلة؟
الـ Traces مش ظاهرة في Langfuse، إيه الحاجات اللي هتراجعها؟
إزاي تتابع الـ Token Usage والـ Latency من غير ما تعرض بيانات حساسة؟
جهزنا Interview Questions & Answers عن LLM Observability باستخدام Langfuse، مع التركيز على الـ Production Scenarios والـ Python SDK والـ Tracing والـ Cost Tracking.
Resources:
Documentation: https://t.co/4NDjKuQTpw
Getting Started Tutorial: https://t.co/dD6K48jJYx
GitHub Repository: https://t.co/LfEmbyGasc
الـ Observability مش مجرد Dashboard بتعرض أرقام، دي وسيلة تفهم بيها سلوك الـ AI Application وتحدد المشاكل وتاخد قرارات مبنية على بيانات فعلية.
#LLM #LLMObservability #Langfuse #MLOps #AIEngineering #GenerativeAI #RAG
المشكلة مش دايما في الموديل نفسه، ساعات التحدي الحقيقي بيكون في تشغيله تحت ضغط الـ Production.
لما عدد الـ Requests يزيد، محتاجين نضمن إن الـ Inference يفضل سريع، ونستغل الـ Hardware بكفاءة.
هنا بيظهر دور الـ Enterprise Serving Frameworks:
- NVIDIA Triton: لتشغيل الموديلز بكفاءة، مع دعم أكتر من Framework والاستفادة من الـ GPU.
- KServe: لنشر وإدارة الـ Models على Kubernetes، مع دعم الـ Auto-scaling.
طيب إيه الفرق بينهم؟ وإمتى نستخدم كل واحد، وهل ممكن نستخدمهم مع بعض؟
جمعنالك أهم Resources عن Triton وKServe، مع التركيز على الـ Production Scenarios.
Resources:
NVIDIA Triton Inference Server
https://t.co/gu9lnrFpEK
KServe
https://t.co/mnoWNedqrt
KServe Runtime Configurations: https://t.co/cb8cGwZcqO
_________________________________
Follow for more🫡🫡
https://t.co/LIgkOLw4D7
#MLOps #MachineLearning #TritonInferenceServer #KServe #Kubernetes #MLOpsMENA
ال ML Model مش بيتغير، لكن الداتا اللي بيتعامل معاها ممكن تتغير تماما.
وده ممكن يخلي model كان بيعمل Predictions كويسة وقت ال Training، ويبدأ يدي نتائج أقل دقة في ال Production.
مثال: شركة بتستخدم موديل لتوقع طلب العملاء على منتجاتها. مع تغير سلوك الشراء، ال Production Data بتختلف عن الداتا القديمة، وده ممكن يؤدي لتوقعات غلط ومخزون زيادة أو منتجات مش متوفرة وقت ما العملاء يحتاجوها.
هنا بنستخدم Data Drift Detection.
بنقارن بين:
- Reference Data: الداتا اللي بنعتمد عليها كمرجع.
- Production Data: الداتا الجديدة اللي داخلة للنظام.
وباستخدام Evidently AI نقدر نكتشف التغيرات في الداتا ونتابعها، قبل ما نتجاهل مشكلة ممكن يكون ليها تأثير على ال Business.
ومعاه ملف ال Q&A Interview Questions
بيحول الفكرة دي لمجموعه اسئلة كأنك في interview وازاي تتعامل مع سيناريوهات زي كدا.
#MLOps #MachineLearning #DataDrift #EvidentlyAI
مشكلتك بعد ما تبقى Mid-level أو Senior AI Engineer مش إنك تلاقي كورس جديد تتعلم منه RAG أو AI Agents.
المشكلة إنك تلاقي محتوى معمول فعلا للمرحلة اللي وصلت لها.
معظم المحتوى المتاح بيركز على إزاي تبدأ، وإزاي تبني AI Applications. لكن لما توصل لمرحلة إنك مسؤول عن تصميم الـ Systems نفسها، واختيار الـ Architecture المناسبة، واتخاذ قرارات بتأثر على الـ Performance والـ Cost والـ Security في الـ Production، بتحتاج نوع مختلف تماما من التعلم.
والنوع ده من الفرص مش سهل تلاقيه.
عشان كده، في MLOps MENA Community بنطلق AI Architecture Design، كورس تدريبي مجاني لمدة 6 أسابيع، مخصص للـ Mid-level والـ Senior Engineers اللي عايزين ينتقلوا للمستوى التالي في مسيرتهم المهنية.
سواء كنت Mid-level عايز تطور طريقة تفكيرك وتستعد لمسؤوليات أكبر، أو Senior Engineer بتستهدف دور Tech Lead وعايز تطور قدرتك على قيادة القرارات الهندسية وتصميم الأنظمة، فالبرنامج ده معمول للمرحلة دي تحديدا.
خلال الـ 6 أسابيع، هتتعلم:
- Software Architecture: C4, TOGAF and Quality Attributes
- AI System Design: Building Blocks and LLMOps
- LLM & RAG Architecture: APIs vs. Self-hosting, Hybrid Search, Re-ranking and GraphRAG
- Agentic AI Architecture: ReAct, MCP, Memory and Guardrails
- Production Readiness: Security, Governance, Evals and Monitoring
- Enterprise Case Studies: دراسة أنظمة وسيناريوهات واقعية من قطاعات مختلفة
والبرنامج مش مجرد Sessions تسمعها وتخلص؛ هتشتغل على Assignments وCapstone Project تطبق من خلالهم اللي اتعلمته، وتشتغل على تصميم Architecture متكاملة لـ AI System.
الكورس هيقدمه Eng. Sameh Amin — Head of AI at Unifonic، بخبرة أكتر من 20 سنة في الـ Software والـ AI، وعمل على أنظمة وصلت للـ Production في شركات زي Unifonic وDocuSign وEtisalat.
الـ Live Sessions هتديك فرصة تناقش أفكارك وقراراتك مباشرة مع المحاضر، والـ Recordings هتكون متاحة على YouTube بعد الـLive.
البرنامج مجاني، لكن القبول مش مفتوح لكل المستويات. فيه Screening Form قصيرة للتأكد من إن خلفية المشاركين مناسبة لطبيعة المحتوى.
لو وصلت لمرحلة إنك مش عايز تتعلم إزاي تبني AI Application جديدة، لكن عايز تتعلم إزاي تصمم System متكامل، وتختار الـ Architecture الصح، فدي فرصتك.
Apply Now:
https://t.co/tXfsZu38ms
Follow for more🫡🫡
MLOps MENA Community Telegram :
https://t.co/1I7pUytGAR
Follow MLOps MENA Instegram:
https://t.co/kc7YMsdjYU
MLOps MENA Youtube for sessions and courses:
https://t.co/df7nsOv7Ld
MLOps MENA Website:
https://t.co/h58h3aw3CV
MLOps MENA WhatsApp channel:
https://t.co/TFDzdpsxAm
MLOps MENA Discord:
https://t.co/OBlgSUORpM
MLOps MENA X:
https://t.co/enbqoRUbsj
MLOps MENA TikTok:
https://t.co/npNUVVi6Or
#MLOpsMENA #AIArchitecture #LLM #RAG #AgenticAI #MLOps #GenAI
ال ML Service ممكن تكون شغالة وال Model بيعمل Predictions عادي جدا...
بس هل ده معناه إن ال Service حالتها كويسة؟
ممكن الLatency تكون بتزيد،
ال Throughput يقل،
وال Error Rate يعلى،
وإنت مش واخد بالك.
وده بيخلينا نسأل سؤال أهم:
إحنا عارفين ال Service شغالة...
بس عارفين حالتها إزاي؟
هنا بييجي دور Metrics Monitoring.
Prometheus
بيجمع ال Metrics من ال Services وبيخزنها كـ Time Series، وبعدها نقدر نستخدم PromQL عشان نتابع حاجات زي ال Latency وال Throughput وال Error Rate.
وبعدين Grafana بتعرض ال Metrics دي في Dashboards، وتقدر تعمل Alerts لما يحصل Problem.
يعني ببساطة:
Service → Prometheus → PromQL → Grafana
بس الهدف مش مجرد إننا نشوف أرقام على Dashboard.
الهدف إننا نعرف إن فيه مشكلة حصلت، نحدد إمتى بدأت، ونبدأ نعرف فين المشكلة قبل ما ال User هو اللي يكتشفها.
وده جزء أساسي من ال Observability:
إن ال Service متبقاش مجرد شغالة...
لكن نكون عارفين هي شغالة إزاي.
وحاطين مع البوست Interview Q&A File فيه شرح Prometheus وPromQL وGrafana، وكمان Hands-on بـ FastAPI + Prometheus + Grafana.
Follow for more🫡🫡
Resources:
How Prometheus Monitoring works | Prometheus Architecture Explained📽️:
https://t.co/jsD6X6bQUL
Setup Prometheus Monitoring on Kubernetes using Helm and Prometheus Operator📽️:
https://t.co/qbpp6ieyqA
Tutorial 📄:
https://t.co/AW60w2pD36
Documentation 📄:
https://t.co/0KF1a65B6W
Repo🐱:
https://t.co/xCORzFkehT
________________________________
MLOps MENA Community Telegram :
https://t.co/1I7pUytGAR
Follow MLOps MENA Instegram:
https://t.co/kc7YMsdjYU
MLOps MENA Youtube for sessions and courses:
https://t.co/df7nsOv7Ld
MLOps MENA Website:
https://t.co/h58h3aw3CV
MLOps MENA WhatsApp channel:
https://t.co/TFDzdpsxAm
MLOps MENA Discord:
https://t.co/OBlgSUORpM
MLOps MENA X:
https://t.co/enbqoRUbsj
MLOps MENA TikTok:
https://t.co/npNUVVi6Or
#MLOps #Prometheus #Grafana #Observability #Monitoring #MachineLearningال ML Service ممكن تكون شغالة وال Model بيعمل Predictions عادي جدا...
بس هل ده معناه إن ال Service حالتها كويسة؟
ممكن الLatency تكون بتزيد،
ال Throughput يقل،
وال Error Rate يعلى،
وإنت مش واخد بالك.
وده بيخلينا نسأل سؤال أهم:
إحنا عارفين ال Service شغالة...
بس عارفين حالتها إزاي؟
هنا بييجي دور Metrics Monitoring.
Prometheus
بيجمع ال Metrics من ال Services وبيخزنها كـ Time Series، وبعدها نقدر نستخدم PromQL عشان نتابع حاجات زي ال Latency وال Throughput وال Error Rate.
وبعدين Grafana بتعرض ال Metrics دي في Dashboards، وتقدر تعمل Alerts لما يحصل Problem.
يعني ببساطة:
Service → Prometheus → PromQL → Grafana
بس الهدف مش مجرد إننا نشوف أرقام على Dashboard.
الهدف إننا نعرف إن فيه مشكلة حصلت، نحدد إمتى بدأت، ونبدأ نعرف فين المشكلة قبل ما ال User هو اللي يكتشفها.
وده جزء أساسي من ال Observability:
إن ال Service متبقاش مجرد شغالة...
لكن نكون عارفين هي شغالة إزاي.
وحاطين مع البوست Interview Q&A File فيه شرح Prometheus وPromQL وGrafana، وكمان Hands-on بـ FastAPI + Prometheus + Grafana.
Follow for more🫡🫡
Resources:
How Prometheus Monitoring works | Prometheus Architecture Explained📽️:
https://t.co/jsD6X6bQUL
Setup Prometheus Monitoring on Kubernetes using Helm and Prometheus Operator📽️:
https://t.co/qbpp6ieyqA
Tutorial 📄:
https://t.co/AW60w2pD36
Documentation 📄:
https://t.co/0KF1a65B6W
Repo🐱:
https://t.co/xCORzFkehT
________________________________
MLOps MENA Community Telegram :
https://t.co/1I7pUytGAR
Follow MLOps MENA Instegram:
https://t.co/kc7YMsdjYU
MLOps MENA Youtube for sessions and courses:
https://t.co/df7nsOv7Ld
MLOps MENA Website:
https://t.co/h58h3aw3CV
MLOps MENA WhatsApp channel:
https://t.co/TFDzdpsxAm
MLOps MENA Discord:
https://t.co/OBlgSUORpM
MLOps MENA X:
https://t.co/enbqoRUbsj
MLOps MENA TikTok:
https://t.co/npNUVVi6Or
#MLOps #Prometheus #Grafana #Observability #Monitoring #MachineLearning
في البوست اللي فات اتكلمنا عن RAG Drift، وإزاي ال System ممكن يفضل شغال عادي، لكن ال Retrieval يبدأ يجيب Context مختلف أو أقل جودة مع الوقت.
بس حتى لو ال Retrieval تمام وال Context اللي داخل للـ LLM صح، لسه فيه حاجة ممكن تتغير وتعمل مشاكل في ال AI System.
ال Model نفسها، ال Prompt، أو حتى طريقة ال Agent في تنفيذ ال Task.
مثلا عندك AI Agent بيعمل Task معين في 4Steps .
بعد فترة، نفس ال Task بقى بياخد 9Steps.
مفيش Error واضح، وال Final Answer لسه صح.
لكن ال Latency زادت، وال Cost زاد، وال Agent بدأ يعمل Tool Calls ملهاش لازمة.
هنا عندنا Trajectory Drift.
وده مش النوع الوحيد.
Provider Drift:
ال Provider يغير ال Model أو ال Model Version اللي ورا نفس ال API name، فـ نفس ال Code ممكن يبدأ يطلع Results مختلفة.
Prompt Drift:
ال Prompt يتغير واحدة واحدة.
Rule هنا،
Example هناك
تعديل صغير في Template...
لحد ما ال Behavior نفسه يتغير وإحنا مش واخدين بالنا.
والمشكلة الأكبر إنك ممكن تبص على ال Code وتقول:
أنا معملتش أي تغيير!
وده فعلا ممكن يكون صحيح.
لأن في ال LLM Applications
، ال Code لوحده مش هو ال System.
ال Model + Prompt + Context + Tools + Agent behavior كلهم أجزاء من ال System، وأي تغيير فيهم ممكن يأثر على ال Output أو طريقة تنفيذ ال Task.
وعشان كده التعامل مع النوع ده من ال Drift محتاج إننا نشوف اللي حصل الأول:
Trace → Version → Evaluate → Monitor
نعرف أي Model كانت شغال، أي Prompt Version استخدم، ال Agent أخد كام Step، وعمل كام Tool Call، وبعدها نقارن ونحدد التغيير اللي حصل.
وده اللي بنبدأ نفهمه في Idea 4:
LLM Provider & Prompt Drift
حاطين مع البوست ملف شرح كامل فيه التفاصيل، ال Real-life Scenarios، وال Production Practices الخاصة بـ Provider Drift وPrompt Drift وTrajectory Drift.
Follow for more🫡🫡
Resources:
Documentation 📄:
https://t.co/AYC9ftqLBs
Tutorial 📄:
https://t.co/B9sgrKjjXr
https://t.co/Hp0UaYx7mv
Repo🐱:
https://t.co/5nR71BLWyK
_________________________________
MLOps MENA Community Telegram :
https://t.co/1I7pUytGAR
Follow MLOps MENA Instegram:
https://t.co/kc7YMsdjYU
MLOps MENA Youtube for sessions and courses:
https://t.co/df7nsOv7Ld
MLOps MENA Website:
https://t.co/h58h3aw3CV
MLOps MENA WhatsApp channel:
https://t.co/TFDzdpsxAm
MLOps MENA Discord:
https://t.co/OBlgSUORpM
MLOps MENA X:
https://t.co/enbqoRUbsj
MLOps MENA TikTok:
https://t.co/npNUVVi6Or
#MLOps #LLM #AIAgents #PromptEngineering #AIEngineering #RAG
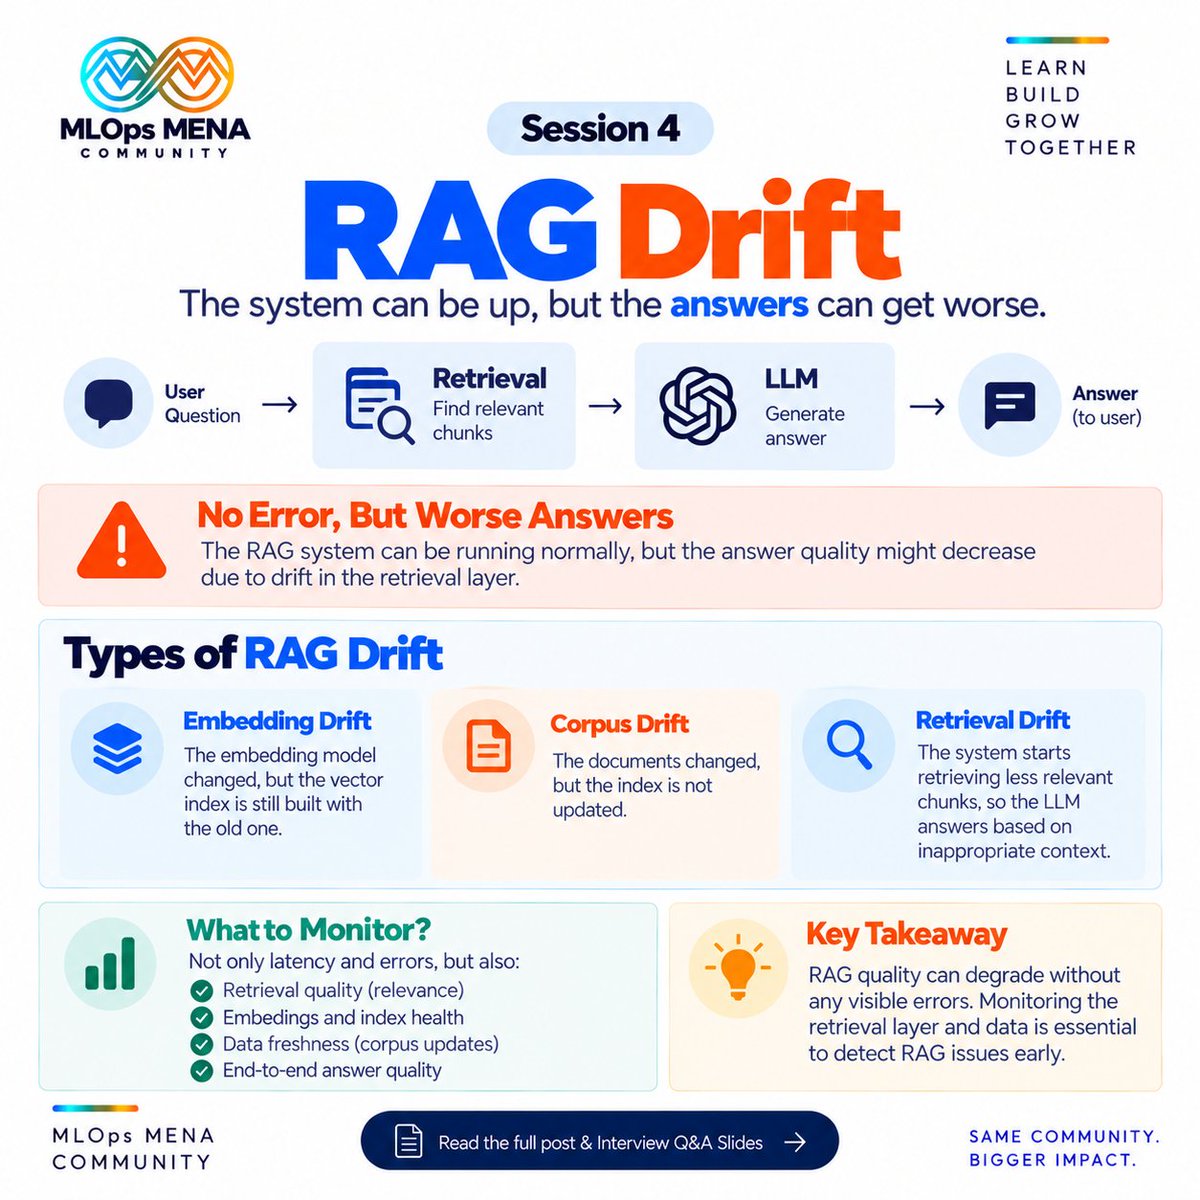
في ال RAG، ممكن ال System يفضل شغال عادي جدا، لكن ال Answers تبدأ تبقى أسوأ.
ليه؟
أحيانا المشكلة بتكون في ال Retrieval Layer نفسها بسبب ال Drift.
وده ممكن يحصل بأكتر من شكل:
• Embedding Drift
ال Embedding Model اتغير، وال Vector Index لسه مبني بالقديم.
• Corpus Drift
ال Documents اتغيرت، لكن ال Index لسه مش Updated.
• Retrieval Drift
ال System بدأ يرجع Chunks أقل Relevance، فال LLM بتجاوب بناء على Context مش مناسب.
يعني ال RAG ممكن جودته تقل من غير أي Error واضح.
وعشان كده، Monitoring ال RAG مش بس Latency و Errors، لازم نتابع جودة ال Retrieval وال Data كمان.
ووفرنا مع البوست Slides فيها Interview Q&A عن RAG & Vector Drift.
Follow for more🫡🫡
Resources:
crash courses📽️ :
1- https://t.co/4IJrcyUPfH
2-https://t.co/v6vs7LBvAA
3- https://t.co/oC3IQDl1fk
Documentation 📄:
https://t.co/Wq8hODTBbv
Tutorial 📄:
https://t.co/u2tnJBjCUl
Repo🐱:
https://t.co/pRzYW5H8gl
https://t.co/9ztOT5nZx5
_________________________________
Follow the MLOps MENA channel on WhatsApp: https://t.co/TFDzdpsxAm
MLOps MENA Youtube:
https://t.co/df7nsOv7Ld
MLOps MENA Website:
https://t.co/h58h3aw3CV
MLOps MENA Discord:
https://t.co/OBlgSUORpM
MLOps MENA Telegram :
https://t.co/1I7pUytGAR
MLOps MENA Instegram:
https://t.co/kc7YMsdjYU
MLOps MENA X:
https://t.co/enbqoRUbsj
#MLOps #RAG #LLM #AIEngineering #MachineLearning
مش كل يوم بنشوف Summit بيجمع ال AI
in all aspects دي في مكان واحد.
وعشان كده مبسوطين نعلن عن 𝐎𝐮𝐫 𝐏𝐚𝐫𝐭𝐧𝐞𝐫𝐬𝐡𝐢𝐩 𝐰𝐢𝐭𝐡 𝐁𝐫𝐚𝐢𝐧𝐬𝐌𝐢𝐧𝐠𝐥𝐞 في 𝐁𝐫𝐚𝐢𝐧𝐬𝐌𝐢𝐧𝐠𝐥𝐞 𝐀𝐈 𝐒𝐮𝐦𝐦𝐢𝐭.
من 10 لـ 16 October، ال Summit هيجمع ناس من خلفيات مختلفة في الـ AI، من Developers وML Engineers وResearchers لحد Founders وBusiness Leaders وStudents.
وال Summit متقسم لـ 5 Tracks:
🔹 𝐀𝐈 𝐢𝐧 𝐓𝐞𝐜𝐡 & 𝐈𝐧𝐟𝐫𝐚𝐬𝐭𝐫𝐮𝐜𝐭𝐮𝐫𝐞
للناس المهتمة بال AI Engineering، ال Infrastructure والتكنولوجيا اللي بتبني وتشغل ال AI Systems.
🔹 𝐀𝐈 𝐢𝐧 𝐒𝐭𝐚𝐫𝐭𝐮𝐩𝐬 & 𝐄𝐧𝐭𝐫𝐞𝐩𝐫𝐞𝐧𝐞𝐮𝐫𝐬𝐡𝐢𝐩
من بناء ال AI Products وال Startups لحد ال Growth وال Scaling.
🔹 𝐀𝐈 𝐢𝐧 𝐁𝐮𝐬𝐢𝐧𝐞𝐬𝐬 & 𝐄𝐧𝐭𝐞𝐫𝐩𝐫𝐢𝐬𝐞
عن إزاي ال AI بيغير طريقة الشركات في ال Operations وال Decision Making.
🔹 𝐀𝐈 𝐢𝐧 𝐋𝐞𝐚𝐫𝐧𝐢𝐧𝐠 & 𝐃𝐞𝐯𝐞𝐥𝐨𝐩𝐦𝐞𝐧𝐭
عن ال AI في التعليم، ال EdTech، وال Upskilling ومستقبل ال Work.
🔹 𝐀𝐈 𝐢𝐧 𝐂𝐫𝐞𝐚𝐭𝐢𝐯𝐞 𝐈𝐧𝐝𝐮𝐬𝐭𝐫𝐢𝐞𝐬
عن تأثير ال Generative AI على ال Design وال Content وال Media وال Creative Workflows.
وال Summit مش مجرد Sessions تتفرج عليها وخلاص.
على مدار الأسبوع فيه Live Sessions , Panels and Day Spotlight and Speed Networking عشان تقدر تتعرف على ناس من مجالات وخلفيات مختلفة.
وفيه 100+ Speakers و100+ Sessions، فسواء أنت شغال في الـ AI، بتتعلمه، أو حتى مهتم تعرف ال Industry رايحة فين، هتلاقي حاجات كتير تستاهل المتابعة.
وبالنسبة لينا، مبسوطين إن 𝐌𝐋𝐎𝐩𝐬 𝐌𝐄𝐍𝐀 𝐂𝐨𝐦𝐦𝐮𝐧𝐢𝐭𝐲 جزء من ال Summit من خلال ال Partnership مع 𝐁𝐫𝐚𝐢𝐧𝐬𝐌𝐢𝐧𝐠𝐥𝐞.
ال Community بالنسبة لنا مش بس Learning وContent، لكن كمان Connections وفرص إنك تقابل ناس من نفس المجال وتتعلم من تجارب مختلفة.
📅 10–16 October 2026
🌐 Online
ولو حابب تكون جزء من ال Summit، تقدر تسجل من خلال :
https://t.co/7ksCoPpv5M
See you at the Summit.
Follow for more🫡🫡
_________________________________
Follow the MLOps MENA channel on WhatsApp: https://t.co/TFDzdpsxAm
MLOps MENA Youtube:
https://t.co/df7nsOv7Ld
MLOps MENA Website:
https://t.co/h58h3aw3CV
MLOps MENA Telegram:
https://t.co/1I7pUytGAR
MLOps MENA Discord:
https://t.co/OBlgSUORpM
MLOps MENA Instegram :
https://t.co/kc7YMsdjYU
MLOps MENA X:
https://t.co/enbqoRUbsj
#BrainsMingleAISummit #CloserThanYouThink #MLOpsMENA #AI #ArtificialIntelligence #MLOps