The non-English tax is real.
Sutton's Bitter Lesson, translated across languages and normalized to OpenAI English token count:
Hindi: OpenAI 1.37×, Anthropic 3.24×
Arabic: OpenAI 1.31×, Anthropic 2.86×
Chinese: OpenAI 1.15×, Anthropic 1.71×
Claude’s tokenizer charges a much higher linguistic tax.
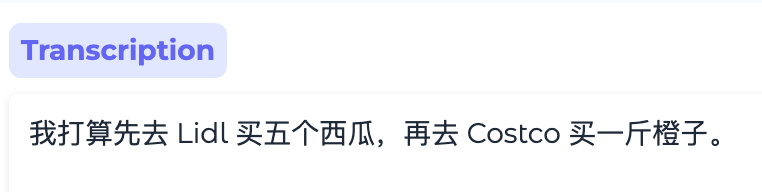
我算是 Typeless 忠实老用户了,还专门买了 DJI Mic Mini 做语音输入。一直好奇它用的什么模型,因为中文夹英文、品牌名、地名都识别得很准。
后来试了豆包流式语音 2.0,英文品牌/地名经常识别错,改提示词也没明显改善。
最后换成 OpenAI GPT-4o mini Transcribe,准确率直接拉满,成本也很低。