۲۶ نفر شاهد فوران آتشفشان در اندونزی بودند؛ ۲۳ نفر جان باختند و ۳ نفر زنده ماندند.
یکی از قربانیان از لحظات پیش از مرگش فیلم گرفته بود. در آخرین لحظه، گدازه به سرش برخورد کرد و باعث مرگ فجیع او شد.
Impactante video de cómo un oso cazando unas cabras montesas usó la estrategia del desgaste y el cansancio. Las cabras, al ver que el oso no se daba por vencido, sacrificaron a la más débil para salvarse.
🚨 ULTIMO MOMENTO: una ingeniera de anthropic revelo que ya no hay que escribirle prompts a claude
"no se supone que le escribas prompts a claude
se supone que construyas un sistema que se prompte solo"
en 45 minutos mostro exactamente como arman los agentes adentro de anthropic
agentes que recuerdan lo que paso antes
que corrigen sus propios errores
que se vuelven mas inteligentes con cada corrida
esto no es una teoria mas
es literalmente como lo hacen ellos por dentro
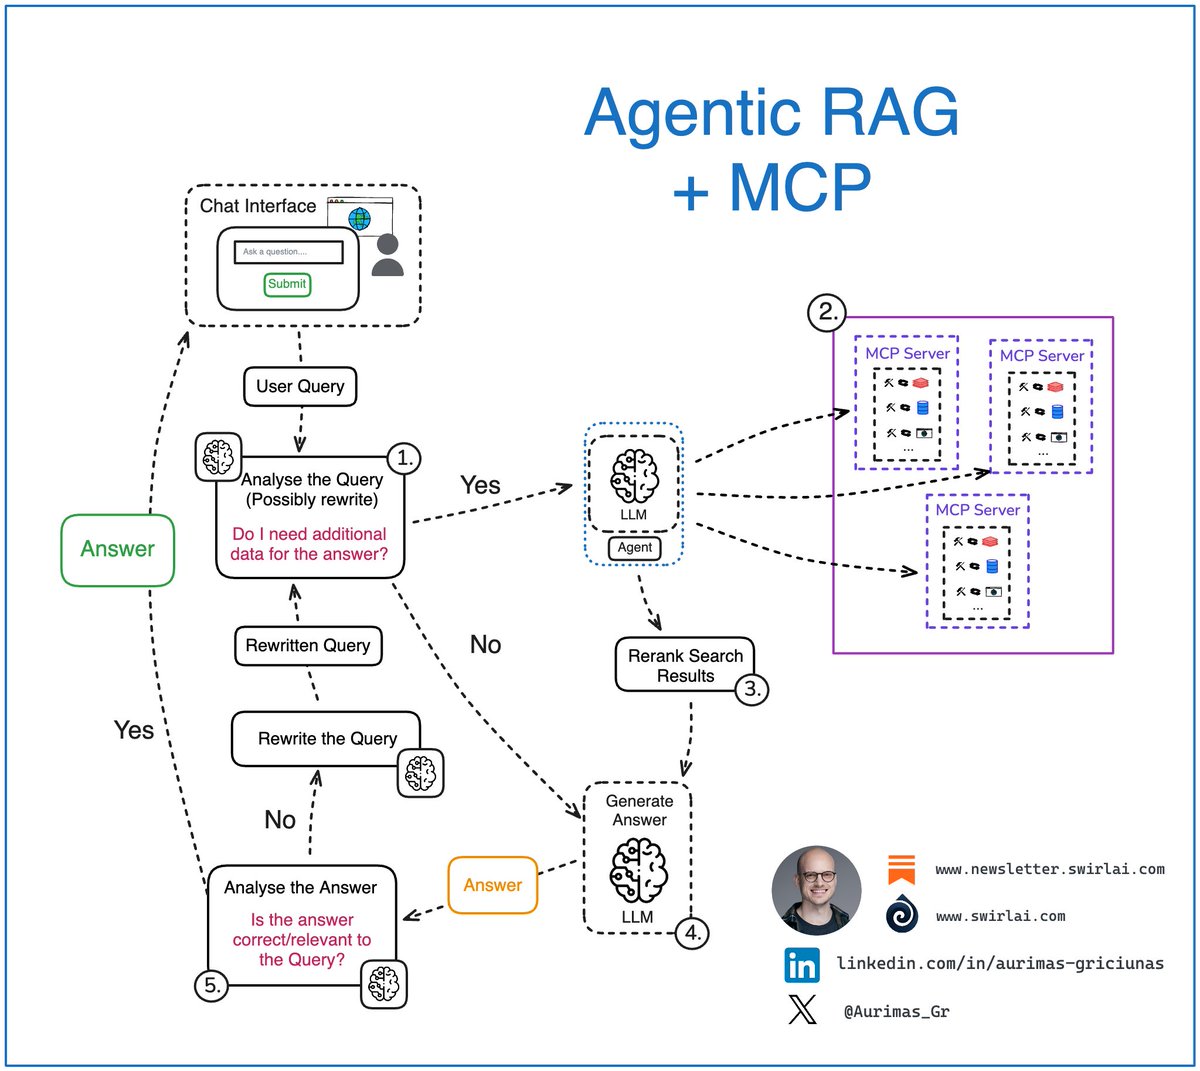
Integrating 𝗔𝗴𝗲𝗻𝘁𝗶𝗰 𝗥𝗔𝗚 Systems via 𝗠𝗖𝗣 👇
If you are building RAG systems and packing many data sources for retrieval, most likely there is some agency present at least at the data source selection for retrieval stage.
This is how MCP enriches the evolution of your Agentic RAG systems in such case (𝘱𝘰𝘪𝘯𝘵 2.):
𝟭. Analysis of the user query: we pass the original user query to a LLM based Agent for analysis. This is where:
➡️ The original query can be rewritten, sometimes multiple times to create either a single or multiple queries to be passed down the pipeline.
➡️ The agent decides if additional data sources are required to answer the query.
𝟮. If additional data is required, the Retrieval step is triggered. We could tap into variety of data types, few examples:
➡️ Real time user data.
➡️ Internal documents that a user might be interested in.
➡️ Data available on the web.
➡️ …
𝗧𝗵𝗶𝘀 𝗶𝘀 𝘄𝗵𝗲𝗿𝗲 𝗠𝗖𝗣 𝗰𝗼𝗺𝗲𝘀 𝗶𝗻:
✅ Each data domain can manage their own MCP Servers. Exposing specific rules of how the data should be used.
✅ Security and compliance can be ensured on the Servel level for each domain.
✅ New data domains can be easily added to the MCP server pool in a standardised way with no Agent rewrite needed enabling decoupled evolution of the system in terms of 𝗣𝗿𝗼𝗰𝗲𝗱𝘂𝗿𝗮𝗹, 𝗘𝗽𝗶𝘀𝗼𝗱𝗶𝗰 𝗮𝗻𝗱 𝗦𝗲𝗺𝗮𝗻𝘁𝗶𝗰 𝗠𝗲𝗺𝗼𝗿𝘆.
✅ Platform builders can expose their data in a standardised way to external consumers. Enabling easy access to data on the web.
✅ AI Engineers can continue to focus on the topology of the Agent.
𝟯. Retrieved data is consolidated and Reranked by a more powerful model compared to regular embedder. Data points are significantly narrowed down.
𝟰. If there is no need for additional data, we try to compose the answer (or multiple answers or a set of actions) straight via an LLM.
𝟱. The answer gets analyzed, summarized and evaluated for correctness and relevance:
➡️ If the Agent decides that the answer is good enough, it gets returned to the user.
➡️ If the Agent decides that the answer needs improvement, we try to rewrite the user query and repeat the generation loop.
Are you using MCP in your Agentic RAG systems? Let me know about your experience in the comment section 👇
She built 100+ agents for Anthropic and made $1.3M - and in 60 minutes leaked everything she knows at Stanford:
02:07 - her first agent for Anthropic brought her $1.3M
08:34 - agents replace a team of 50 engineers worth $200k a month
19:47 - one agent did overnight what the company planned for 5 years
after watching I launched my first agent - $7k in the first week and zero employees needed.
Save & watch - the article below is step by step how to build your first agent like hers.
DEJA NETFLIX PAUSADO 50 MINUTOS Y APRENDÉ A CONSTRUIR EVALS DESDE CERO
este tipo entrenó a 2.000+ pm's e ingenieros de openai, anthropic y google y nos regala un tutorial COMPLETO gratuito.
01:25 - análisis en vivo de 100 trazas reales
09:50 - criterio de evaluación con una simple hoja de cálculo
24:44 - por qué el binario le gana a la escala del 1 al 5
30:08 - true positive y true negative rate 36:00 - evals continuos en producción
4 pasos: etiquetar a mano, categorizar errores, construir jueces de ia binarios y validados, y desplegarlos en producción con etiquetado periódico.
nada de criterios genéricos tipo "útil" o "correcto". se evalúan fallos específicos del producto.
guárdalo y mira los primeros 20 minutos hoy.
علشان كذا شركات الطيران تكره Claude.
رحلة طالعة بـ $889.
أنا دفعت $229.
لا نقاط، ولا VPN، ولا «خبير سفر» سري.
Claude حوّل اللابتوب حقي لآلة صيد رحلات.
هذي 10 برومبتات تلقى لك تذاكر أرخص، وسياسات أأمن، ومسارات أفضل خلال دقائق. احفظها لأنك بتحتاجها 🔖
Las aerolíneas no quieren que sepas esto 🤫
ChatGPT y Claude pueden encontrar vuelos 50% más baratos usando estrategias muy específicas...
No es magia, son estos 7 prompts:
1/ El que más dinero ahorra
Actúa como un experto en tarifas aéreas. Voy de [CIUDAD ORIGEN] a [CIUDAD DESTINO] entre [FECHAS]. Presupuesto: [X€]. Equipaje: [sí/no]. Encuentra la combinación más barata entre vuelos directos, escalas y aeropuertos alternativos. Explica el razonamiento de cada opción.
2/ El truco de las fechas flexibles
Quiero viajar de [ORIGEN] a [DESTINO] alrededor de [FECHA]. Analiza cómo cambiar la salida o el regreso ±3 días afecta el precio. ¿Qué combinación suele ser más barata: salida entre semana, fin de semana, mañana o noche?
3/ Los aeropuertos que nadie mira
Para el trayecto [ORIGEN] → [DESTINO], identifica aeropuertos alternativos en un radio de 100 km de cada extremo. Para cada alternativa, estima el ahorro potencial y el coste real del traslado terrestre (tiempo + dinero).
4/ El comparador de valor real
Compara estas opciones de vuelo: [PEGA LAS OPCIONES]. Evalúa cada una por: precio total con equipaje, duración real del viaje, tiempo de escala, reputación de la aerolínea en puntualidad y política de cambios. Dame un ranking final con justificación.
5/ El detector de costes ocultos
Revisa este itinerario: [PEGA EL ITINERARIO]. Identifica todos los costes que no aparecen en el precio inicial: tasas de equipaje, selección de asiento, traslados entre aeropuertos, visados o autorizaciones necesarias, y riesgos de perder conexión.
6/ El negociador de reembolsos
Mi vuelo [NÚMERO DE VUELO] fue [cancelado/retrasado X horas] el [FECHA]. Según el Reglamento CE 261/2004, ¿tengo derecho a compensación? Redacta una reclamación formal a [AEROLÍNEA] exigiendo [compensación/reembolso]. Tono firme pero correcto.
7/ El planificador completo
Cuando ya tienes todo claro, este prompt te da el plan final.
Actúa como un consultor de viajes. Analiza todo mi viaje: [PEGA LOS DETALLES: origen, destino, fechas, presupuesto, preferencias]. Dame un plan optimizado priorizando: ahorro económico, comodidad y reducción del estrés. Incluye checklist de cosas a confirmar antes de reservar.
Estos prompts funcionan en ChatGPT, Claude y Gemini.
La IA no reserva por ti pero sí analiza opciones mejor que cualquier comparador.
INCREÍBLE: La IA ya puede encontrar vuelos baratos como los agentes de viaje que cobran $500 (gratis).
Aquí tienes 12 prompts brutales de Claude que te ahorran miles en vuelos. Guárdalo 👇
De prompt engineering → context engineering → harness engineering → loop engineering → graph engineering:
La lista no deja de crecer, y cada nuevo término suele tratarse como si sustituyera al anterior.
Pero la realidad es otra: cada capa envuelve a la anterior. La forma más sencilla de diferenciarlas es preguntarse cuál es su unidad de trabajo.
Prompt engineering es el mensaje
El modelo no recuerda nada antes de esa llamada, así que el prompt tiene que contener todo lo necesario: el rol, el contexto, las instrucciones, algunos ejemplos y el formato de salida.
Si el resultado no es el esperado, la clave está en descubrir qué elemento falta o falla, no en reescribir todo el prompt una y otra vez.
La unidad de trabajo es una única entrada.
Context engineering es la memoria
A lo largo de varios pasos, la ventana de contexto es limitada, pero la información disponible no lo es. Por eso hace falta un proceso de selección.
Ese proceso consiste en conservar lo importante, resumir lo útil pero voluminoso y descartar el resto.
Un buen contexto no consiste en meter más información, sino en saber qué eliminar.
La unidad de trabajo es lo que permanece dentro de la ventana de contexto.
Harness engineering es la máquina
Por sí solo, un modelo solo genera texto.
El harness se encarga de recopilar la información necesaria, ejecutar el modelo, llamar a herramientas o subagentes y verificar el resultado mediante pruebas o un evaluador.
Ese paso de verificación es, en gran medida, lo que diferencia una simple llamada a una API de un agente de IA.
La unidad de trabajo es una ejecución completa de la máquina.
Loop engineering es la ejecución iterativa
Una sola ejecución rara vez resuelve todo el problema.
Hace falta un mecanismo que decida si la máquina debe volver a ejecutarse. Para ello se necesita un objetivo definido desde el principio, límites como un número máximo de iteraciones o un presupuesto de coste, y un criterio automático que determine cuándo la tarea realmente ha terminado.
Que un agente deje de pedir herramientas no significa que haya completado el trabajo; solo significa que ha terminado ese turno.
La unidad de trabajo es toda la ejecución del ciclo.
Graph engineering es la coordinación
Cuando varios bucles tienen que trabajar juntos, necesitas definir qué se ejecuta, cuándo se ejecuta, qué puede hacerse en paralelo y qué componentes supervisan a otros.
Los nodos realizan el trabajo, las conexiones (edges) deciden qué ocurre después y el estado compartido fluye entre ellos.
De hecho, un único bucle no deja de ser un grafo de un solo nodo con una conexión que apunta de vuelta a sí mismo. Por eso los grafos organizan los bucles, no los sustituyen.
La unidad de trabajo es el proceso completo.
La relación entre todas estas capas es sencilla:
El prompt y el contexto viven dentro de la fase de recopilación del harness.
El harness ejecuta una pasada completa.
El loop decide si esa pasada debe repetirse.
El graph decide qué bucles se ejecutan y cómo se coordinan entre sí.
Cuanto más amplías la perspectiva, mayor es la unidad de trabajo.
Cuanto más profundizas, vuelves al prompt.
Y eso también indica dónde depurar un problema: identifica qué capa ha fallado según su unidad de trabajo y corrige esa capa.
El prompt es la parte más fácil de modificar, por eso suele recibir la culpa de errores que, en realidad, se originan tres niveles más arriba.
En el articulo de abajo, se explica que es el graph engineering, donde explica la idea principal, cómo empezar, cómo gestionar el estado compartido, cómo crear un enrutamiento fiable y cuándo usar un grafo realmente merece la pena.
Si quieres mantenerte al día, léelo a continuación👇
🚨 الصين أطلقت نموذج OCR مفتوح المصدر بحجم صغير جدًا، لكنه يقرأ ملفات PDF كاملة من أول صفحة إلى آخر صفحة دفعة واحدة.
اسمه Unlimited-OCR، بحجم 3 مليارات معلمة فقط، ويعمل محليًا على جهازك.
بعكس أغلب أدوات OCR اللي تقسّم الملف صفحة صفحة، هذا النموذج يقرأ المستند كاملًا في تمريرة واحدة.
• يدعم تحليل ملفات تصل إلى 100 صفحة دفعة واحدة (نافذة سياق 32K).
• يدعم لغات متعددة مباشرة.
• حقق 93% في أحد معايير تقييم OCR، متفوقًا بـ 6 نقاط على خط الأساس.
• معدل الخطأ أقل من 0.11 حتى بعد 40 صفحة.
• يعمل 100% محليًا بدون الحاجة لإرسال ملفاتك إلى السحابة.
والأفضل؟ إنه مفتوح المصدر بالكامل.
🚨 وقف تقول لـ Claude: “تصرّف كأنك خبير في إدارة حسابات التواصل الاجتماعي.”
برومبت سيئ = نتائج سيئة.
إليك 6 برومبتات تساعدك تنمّي حساباتك على السوشال ميديا بمستوى وكالة احترافية قيمتها 5,000 دولار.
مهندس في Anthropic يقول:
“مو لازم تراقب النموذج في كل خطوة. حطه داخل Graph، وهو بنفسه يكتشف أخطاءه وينفذ المهام بالتوازي.”
وفي 25 دقيقة يشرح كيف تبني Anthropic وكلاء يعملون بالتوازي، يراجعون أعمال بعضهم، ويتعافون تلقائيًا عند حدوث الأخطاء.
🚨 انتبهوا يا اخوان !
Google AI Studio صار يوفر واجهة API مجانية لنماذج Gemini بمستوى إنتاجي، بدون الحاجة لربط بطاقة ائتمانية أو الاشتراك في فترة تجريبية.
تقدر الآن تنشئ API Key مباشرة وتستخدم:
Gemini 2.5 Flash
Gemini 2.5 Pro
Gemini 3.6 Flash (الأحدث)
وكلها ضمن الحصة المجانية.
حدود الاستخدام تعتبر ممتازة لمعظم المشاريع:
حوالي 15 طلبًا في الدقيقة (RPM).
حتى 1 مليون Token في الدقيقة (TPM).
وحوالي 1,500 طلب يوميًا (RPD).
وهذا يكفي لتجربة التطبيقات، وإطلاق المشاريع الصغيرة، وحتى تشغيل بعض التطبيقات الخفيفة في بيئة الإنتاج.
والبداية سهلة جدًا:
يكفي تثبيت مكتبة Python بالأمر:
pip install google-generativeai
وخلال دقيقتين تقدر ترسل أول طلب إلى Gemini.
والأفضل من ذلك، أنه متوافق مع أدوات مثل LiteLLM، لذلك إذا عندك مشروع يستخدم عدة نماذج، تقدر تضيف نقطة نهاية Gemini المجانية بدون الحاجة لإعادة بناء مشروعك.
أما إذا كنت تشغل النماذج محليًا، فـ Ollama يظل خيارًا ممتازًا.
لكن إذا كنت تحتاج خدمة سحابية مستقرة، ودعمًا للوسائط المتعددة، ونافذة سياق طويلة، فواجهة Gemini API المجانية أصبحت خيارًا قويًا جدًا.
🚨 ودّع Excel.
أصبح بإمكان Claude يصمّم لك لوحة تحكم مالية (Finance Dashboard) احترافية، وكأنها من إعداد محلل مالي يتقاضى 9,000 دولار… ومجانًا.
هذه هي 7 برومبتات تساعدك تبني لوحة التحكم المالية الخاصة بك، وتتابع أموالك وميزانيتك وقراراتك المالية باحترافية. 📊💰
🚨 عاجل: Claude عنده ميزة مخفية اسمها “Social Media Manager Mode”.
تقدر تستخدمها لإدارة حساباتك على السوشال ميديا بالكامل، وكأن عندك مدير سوشال ميديا محترف بقيمة 5,000 دولار بالشهر… وكل هذا مجانًا.
إليك 8 برومبتات تفتح لك هذا الوضع: 👇
UN INGENIERO DE ANTHROPIC CREÓ ESTE SISTEMA DE GRAPHS Y ACABA DE REVELAR CÓMO FUNCIONA
La mayoría de la gente que debate sobre graphs en internet nunca ha visto uno ejecutarse de verdad.
Tarea → Investigador → Planificador → Redactor + Agente de Código → Revisor → Despliegue
Seis nodos, un estado compartido y paquetes de información viajando de un extremo a otro en tiempo real mientras el graph completa el trabajo por sí solo.
El modo de bucle deja de tener sentido en cuanto la tarea se divide en especialidades reales. Un solo agente deja de intentar hacerlo todo.
Si el revisor detecta un fallo, lo envía directamente al nodo que lo provocó.
No hace falta reiniciar todo el flujo ni se pierde el contexto.
Un graph no es un bucle más sofisticado.
Es el organigrama que les faltaba a tus agentes.
Guárdalo, mira cómo funciona y luego lee el artículo de abajo👇