A 199.7 GB model. A 16 GB laptop. A USB SSD. One line of C++ changed.
We ran GLM-5.3-Flash (320B params, 18B active) on a MacBook Pro M4 with 16 GB. It works. It is 6 seconds per token. Thread on why that is still worth writing up.
Numbers:
– 20–28 s to a listening server
– ≈11 GB resident for a 199.7 GB model
– good day: 30 s to first token, 0.17 tok/s, SSD ≈780 MB/s
– bad day: 180 s to first token, 0.084 tok/s
Not usable for chat. Not claimed to be.
„Setzt ihr KI ein?" ist die langweiligste Frage im Erstgespräch. Die Antwort ist bei jedem Anbieter ja.
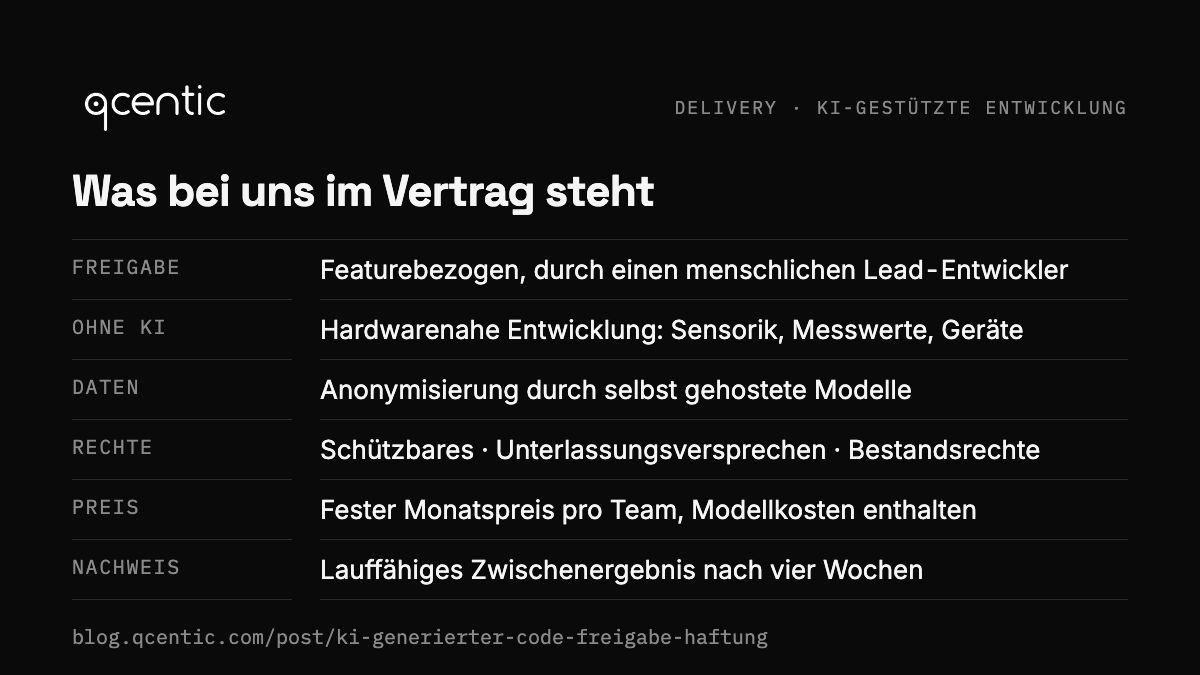
Die Frage, die unterscheidet: Wer haftet für den Code, der dabei entsteht?
Unsere Antwort steht im Vertrag, nicht auf einer Folie.
Deshalb kein Tagessatz. Der Tagessatz ist der einzige Preis unserer Branche, der sich verschlechtert, wenn der Anbieter besser wird.
Fester Monatspreis pro Team, Modellkosten enthalten, monatlich kündbar. Nach 4 Wochen steht ein lauffähiges Zwischenergebnis.
Our first open-source release, published under the Actana AI umbrella. We built it because we run coding agents on more than one machine and lost track of which one was waiting. MIT and pre-release.
https://t.co/yEMz8U5Sj6
Qcentic has been building software since 2013. We never wrote about it. That changes today, slowly.
What lands here:
– experiments from our own lab, with the numbers
– open-source tools we build for our own work
– what we learnt, and what we got wrong
https://t.co/6DUOPOhfVE