Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
Rain sky
@Rainskynb66
小小萌新一枚~ 序列图灵派,做数分机器学习,Ai Agent正在加入~ 玩点基金,做点股票~ Web3正在看~ 这里是挣点小零花钱的Rain 关注就回
台湾省台北市
Joined October 2026
1.1K
Following
995
Followers
158
Posts
Rain sky
@Rainskynb66
about 5 hours ago
@YxzRainy
输入呀,最后一位输入呀😎
Rain sky
@Rainskynb66
about 8 hours ago
@Yobert88ace
那我多找找素材
Rain sky
@Rainskynb66
about 20 hours ago
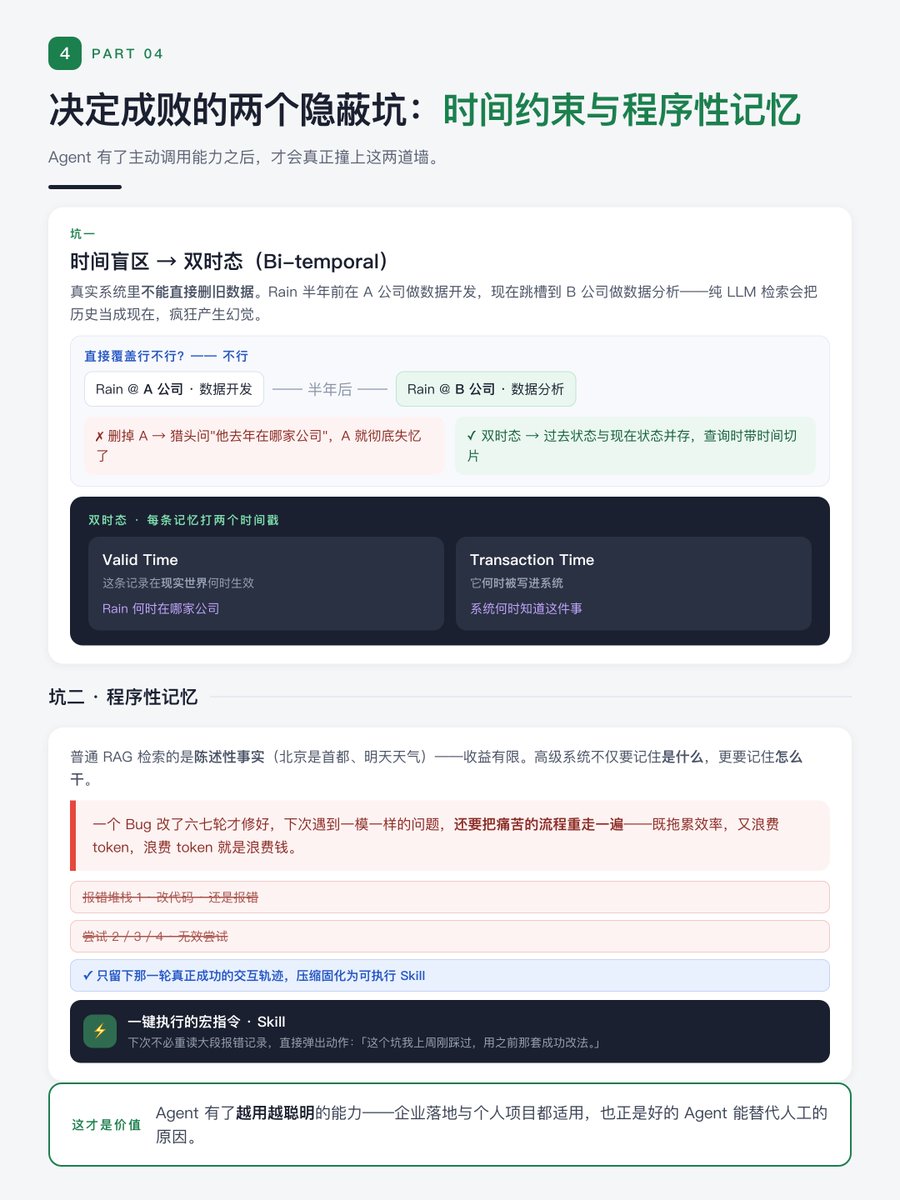
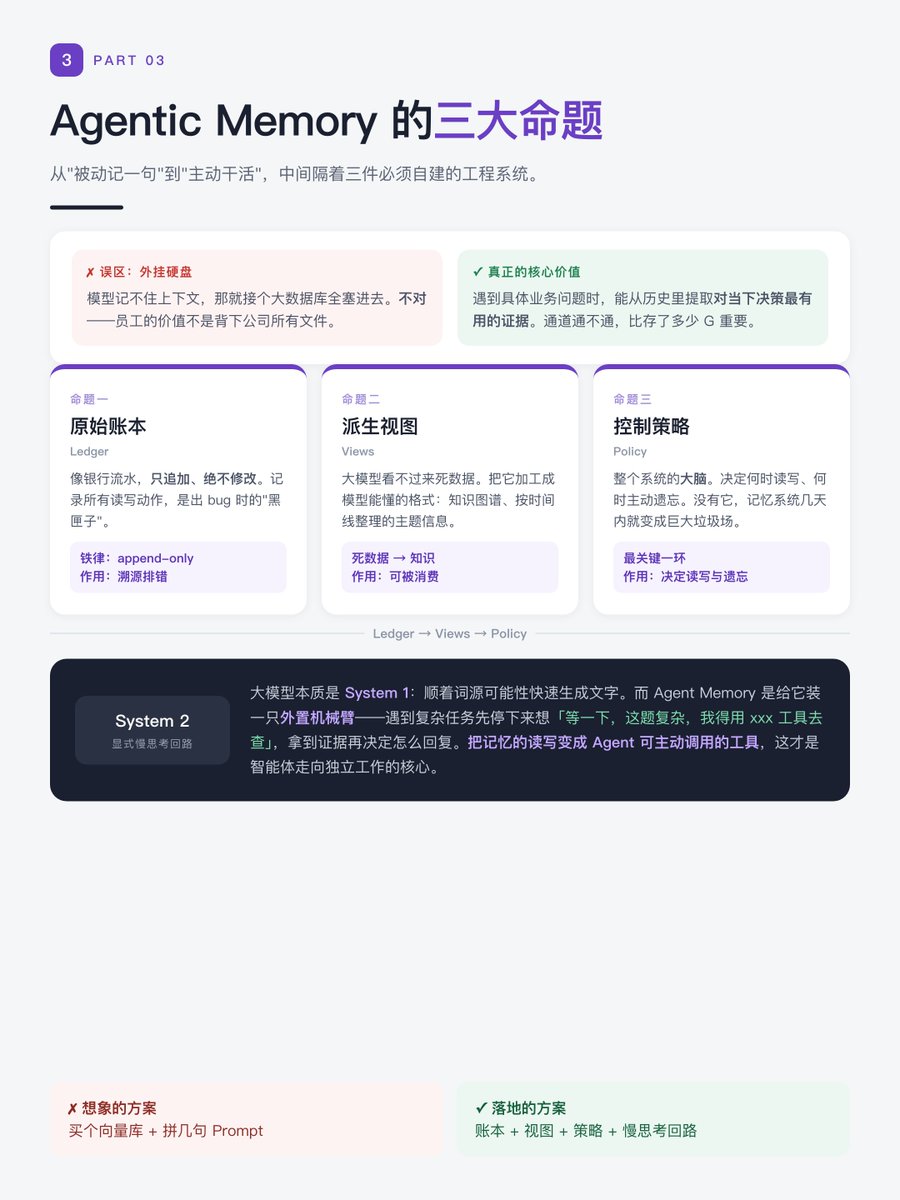
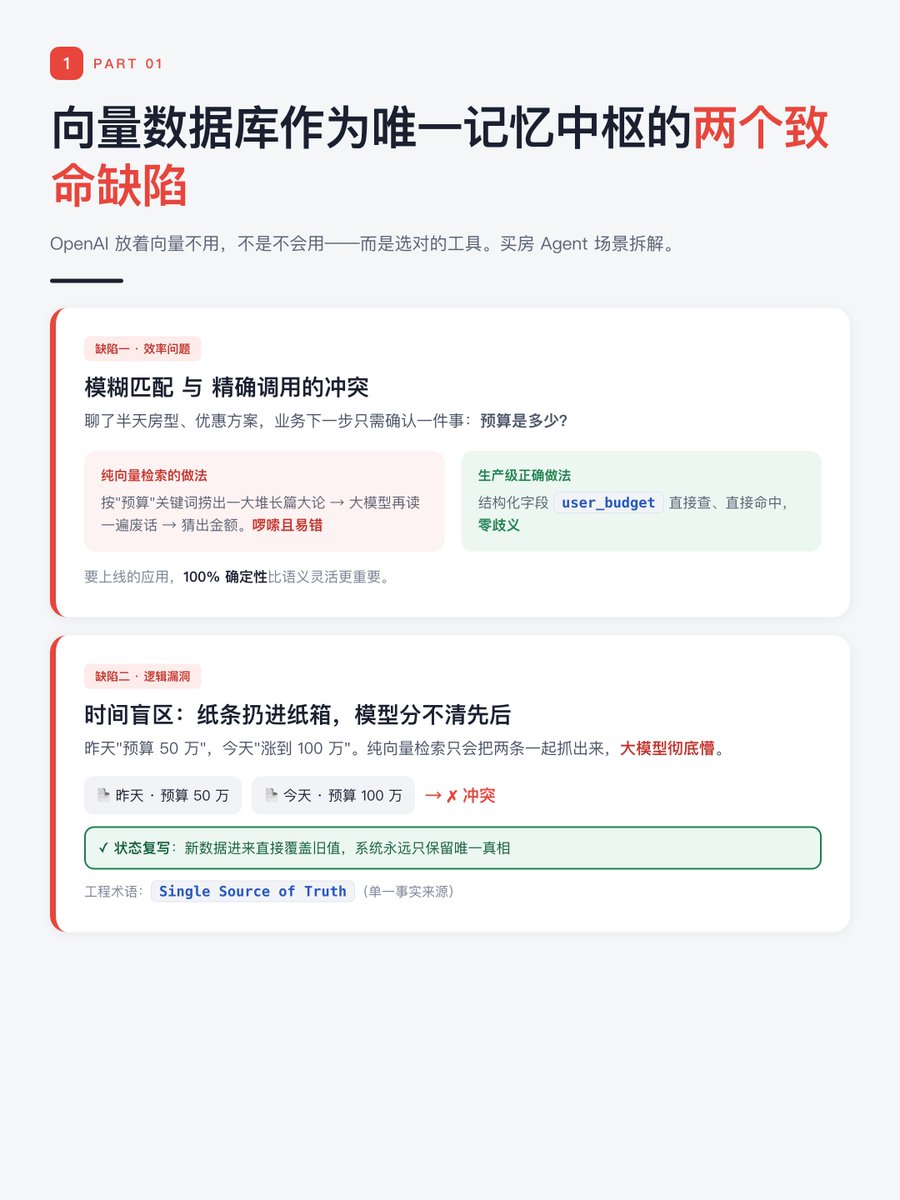
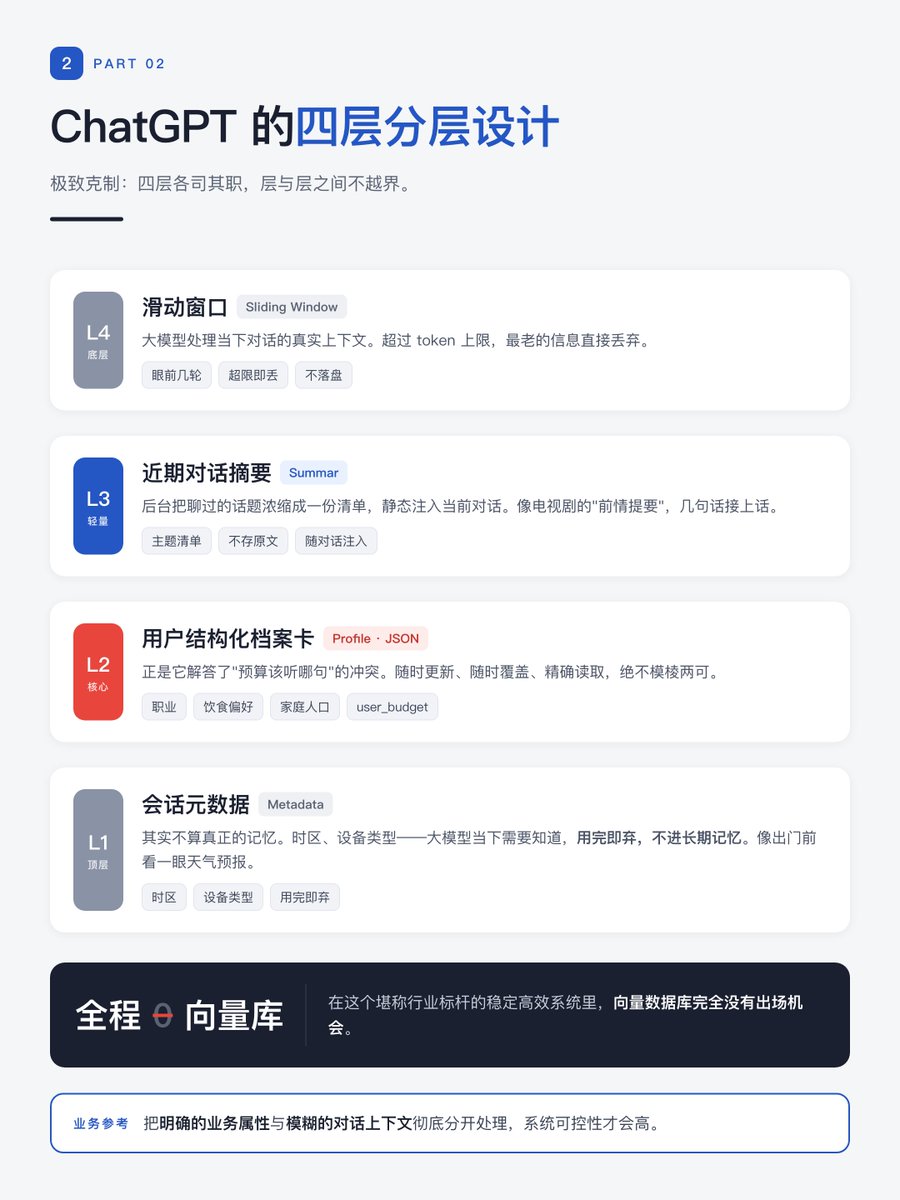
如果你是一个Agent��构师,那么Agent的记忆机制应该怎么设计? 用向量数据去存历史对话,用户每次提问就用RAG去库里捞相关内容? 本篇我们就来彻底扒一扒怎么去构建一个生产级的Agent Memory架构,以OpenAI(GPT)为例。 一、向量数据库的致命局限 刚才提到的纯靠向量RAG数据库来做记忆,到底有哪些致命的缺陷? 我们来直接拆解目前的行业标杆OpenAI,看它是怎么搞定用户的海量记忆的。 不知道大家有没有琢磨过既然向量这么火,那为什么OpenAI他们自己做底层架构的时候却放着这个万能工具不用呢? 不管是AI还是传统的软件本质上都是去选对的工具,而不是为了��明我会用多么炫酷的技术。 如果把向量数据库当成是agent唯一的记忆中枢,它在真实业务里是有两个致命缺陷的: 一个是模糊匹配和精确调用的冲突,另一个就是处理时间状态时的系统性困境。 我们可以拿个具体的业务场景来拆解一下,这样会直观很多。 比如说第一种情况假设你现在正在做一个帮人买房子的agent,用户跟你聊了半天比对了各种房型还扯了优惠方案,这时候业务走到下一步,系统其实只需要确认一个关键信息这个用户的最终愿意花多少钱,预算到底是多少? 如果你用普通的向量检索也就是去搞这个模糊匹配它会怎么干呢? 它会根据你的预算前这些关键词从历史记录里扒出一大堆的长篇大论,然后大模型还得再把这些��话读一遍去猜到底是多少钱,这在业务线上不仅啰嗦而且很容易出错! 但是在标准的业务开发里事情不应该是这样的,对吧? 我们更需要的是精确调用,系统里面就应该有个字段干脆叫做userbudget(用户的预算)。 需要的时候直接去查,直接命中没有一点歧义,对于要上线的生产级应用来说,这种100%的确定性才是最重要的,这就是我们讲的效率问题。 那接下来要说的第二个缺陷就是个真正要命的逻辑漏洞了,也就是时间盲区的问题。 还是买房这个例子,假设用户昨天跟你说,我预算只有50万;但是今天他中彩票了,跑过来跟你说:“诶,我预算涨到了100万了” 如果你靠纯向量检索,他处理信息的方式就像什么呢? 就好比,你准备了一个大纸箱子,用户昨天跟你说50万,系统记在一张纸上,扔进去;今天变成100万了,系统又写了一张新的纸条扔进去。 当agent需要确认预算的时候,手一伸进去抓取。 这样两张纸条一起被摸出来了,这时候大模型就彻底懵了,他根本分不清这两句话的时间先后逻辑,到底应该听谁的? 那正确的做法应该是什么样呢?其实很简单,既然是预算,那它就是一个动态的状态。 我们需要的是状态复写新数据进来了,就直接把旧的给覆盖掉。 整个系统里面永远只保留当前最新的唯一的那个真相,在工程上管这个叫做SingleSourceofTruth(单一事实来源)。 所以你看,如果不去解决这两个底层冲突。 我们做的Agent就会显得很健忘,甚至逻辑混乱根本没法承接稍微复杂一点的真实业务。 那么回到标题,既然靠纯向量检索走不通,那么像OpenAI这样头部玩家,到底是怎么搭记忆架构的呢?方案就两个字,就是分层! 二、ChatGPT 的四层分层设计 ChatGPT的分层极致���克制: 会话元数据 (Metadata):时区、设备类型。用完即弃,不进长期记忆。 用户结构化档案卡(Profile):JSON格式,随时更新、随时覆盖、精确读取(如职业、饮食偏好)。绝不模棱两可。 近期对话摘要(Summar):轻量级话题清单,静态注入当前对话,不存原文。 滑动窗口 (Sliding Window):超过窗口的数据直接删除不要。 第一层叫做会话元数据(Metadata)。这其实不算真正的记忆,它只是你当前的环境信息。 比如你现在的时区是哪,用的是手机还是电脑,这些信息大模型当下需要知道但是用完直接就扔了。 就好比我们出门之前看了一下手机上的天气预报,你知道今天下雨就再把伞就行了,你不需要把这几天的天气预报都背进脑子里,对吧? 所以呢,它绝对不进长期记忆。 第二层叫做用户结构化档案卡(Profile)。这个非常关键,它其实就正好解答了我们上一部分���到的那个预算到底听哪句的这个冲突。 GPT解决这种事实明确的方法就是建一个结构化的表格,也就是代码里面的JSON格式比如说你的职业是什么,你带爱好是什么,你家里有几口人,你的预算是多少; 只要你的喜好变了,它就随时更新;随时把旧数据给覆盖掉,他追求的是100%的精确读取,绝不可以模棱两可。 这个时候就会有疑惑,明确的属性可以用表格存,但长篇大段的聊天记录怎么办呢? 那就到了第三层近期对话摘要(Summar)。对于大段大段的闲聊,在GPT不会傻乎乎地去存你说的每一句废话。 它会在后台悄悄地把你聊过的主题浓缩成一个非常清亮的一个清单。 其实特别像你看电视剧或者直播讲解,每集开头都会有一个前情提要,短短几句话告诉你之前发生了什么。 有这个清单注入到对话里,Agent就能把话接上。 根本就不需要去翻所有的原话记录��� 最后,最底下这一层才是大模型真正处理当下对话的滑动窗口(Sliding Window)。 这个大家应该都很熟,就是你眼前的这几轮聊天一旦聊得太多,超过了这个token的上限怎么办?非常简单粗暴就是最老的信息直接丢弃。 有没有注意到?在这个堪称行业标杆的极其稳定高效的记忆系统里面,完全都没有这个向量数据库出场的机会。 这其实给我们在业务里做Agent提供了一个非常实用的参考。 就是我们一定要把明确的业务属性和模糊的对话上下文彻底的分开处理,做的这个系统的可控性才会高。 到这里,可能有人会觉得GPT这种还是有点偏被动的。 基本上都是人聊一句他记一句。 那如果我们真的想做一个能主动思考主动帮你干活的agent。 也就是所谓的Agent Memory我们需要搞清楚什么呢? 三、Agentic Memory 的三大命题 Ledger(原始账本):类似银行流水,只追加不修改,记录所有读写动作,记录错误的“黑匣子”。 Views(派生视图):将死数据转化为大模型能看懂的知识图谱 Policy(控制策略):系统的大脑。决定何时读写、何时主动遗忘。没有它,记忆系统几天内就会变成“巨大的垃圾场”。 这里有一个极大的误区是外挂硬盘,大模型记不住上下文,那我就给他接一个大容量的数据库嘛,把聊过的东西全都塞进去。 但这其实是不对的,我们想象一下:如果Agent就像一个真实的员工,最大的价值难道是把公司所有的文件都背下来吗?绝对不是,对吧? 真正的能力是遇到一个具体的业务问题时,能从过去的历史记录里面,提取出对当下这个决策最有用的证据,这才是记忆系统的核心价值。 根本就不在于你存了多少G的数据,而在于在于历史数据转换成当前决策的这条通道到底通不通畅。 那具体怎么把这条通道给打通呢?这就是第二个命题的作用。 我们在工程上必须要搭的一个系统三件套,首先底层得有个基础��做Legger(原始账本)。 原始账本这个特别像银行流水,它有个铁律就是���能追加绝对不能修改,为什么? 因为这个是底线,以后Agent要是出了bug开始胡言乱语,我们得靠这个黑匣子一样的东西去溯源排错。 那有了流水账本。大模型直接看是看不懂的,或者说是看不过来,所以第二步我们需要做Views(派生视图), 简单说就是把那些死板的底层数据加工成大模型能看懂的格式。比如说知识图谱,或者是按时间线整理好的用户主题信息。 最后也是最关键的第三个组件,叫Policy(控制策略)。 这其实才是整个记忆系统的大脑,它得负责决定Agent什么时候该去查资料,什么时候该写记录,甚至什么时候需要主动去遗忘那些没用的信息。 如果没有这个控制大脑,那么我们的系统不出几天绝对会变成一个巨大的数据垃圾场。 对于我们做业务落地的来说,这意味着一个真正的生产级灾难! 这绝不可能仅仅是买个向量数据库再加上几句Prompt就能搞定的。 截止这里,有了这一套架构,大模型具体怎么去用它呢? 这就到了第三个命题。我们得给Agent建立一个显式的慢思考回路。 大家应该都知道,大模型本身是个直觉系统,也就是所谓的System1,根据词源的可能性生成文字。 你问它问题,它本能的顺着往下生成文字,速度是很快的,但是,真正的Agent Memory是把记忆变成一个它可以主动操作的工具。 就就好比给大模型装了一个外置的机械臂,当遇到复杂任务的时候,大模型不会立刻去瞎猜。 而是会触发一个System2的慢思考回路,它会停下来想,【等一下,这个问题好像有点复杂,我得要用xxx工具去执行用户的需求】。 让模型自己拿到证据了再决定怎么回复,把对数据的读写变成Agent可以主动调用的工具,这才是智能体真正走向独立工作的核心。 不过当Agent真正拥有了这种主动调用的能力之后,在实际运行的过程中还是会遇到两个隐蔽的坑。 这就到了我们最后一部分。 四、时间约束与程序性记忆 这两个被很多人忽视的底层骨架:时间约束和程序性记忆。 我们先说第一个。时间盲区我们在最开始其实也稍微提过一嘴时间的问题,但是在买房那个例子里,场景是比较简单的。 直接把旧预算覆盖掉就行了,可是在很多真实的系统里你是绝对不能够直接删旧数据的。 重新举一个例子:假设系统里面记录了Rain现在在A公司做数据开发,大半年过去之后,Rain跳槽到了B公司做数据分析。 这时候,如果你纯靠大模型(LLM)去检索,它很容易把过去的历史做当成现在的真相,开始疯狂产生幻觉。 那我们可能就会想了,像前面说的,我们直接把A公司这条数据给删掉,用B公司去覆盖掉,换成B公司不就行了吗? 这是不行的。 为什么呢?因为过两天某个猎头可能会跑来问:“Rain他去年是在哪家公司来着?” 如果我们删掉,A就彻底失忆了。 那我们怎么解决这种冲突呢?工程上有一个专门的保命机制:叫做双时态。 简单来说,就是我们得给每一条记忆打上两个截然不同的时间戳。 一个是这条记录在现实世界是什么��候生效的,另一个是它什么时候被写进系统的。 以后Agent每次去查资料,系统都会底层给它套上一个时间切片的约束。 这就等于明确告诉大模型,【你看这是Rain现在的状态是这个,他过去的状态是那个,你按时间线理清楚,别搞混了。】 有了这个机制Agent处理复杂时间线才不会精神错乱。 到这里,解决了时间问题,我们再来看另一个,也是决定我们的Agent到底是个书呆子还是高级助手的关键。 叫程序性记忆。平时我们做RAG检索,绝大多数情况是在做陈述性事实,什么意思呢? 就是让Agent去查点资料比如北京是首都,明天的天气怎么样,这个公司做什么业务。 这种收益其实是有限的,真正高级的记忆系统不仅要记住是什么,更要记住怎么干。 假设Agent遇到一个代码报错,他去查文档改代码,结果又报错了接着再改,修改了六七轮最后终于修复好了。 如果只有普通的记忆系统,下次遇到一模一样的bug,那大概率还是会把这套痛苦的流程重新走一遍,那就非常拖累效率,而且非常浪费大模型的token,浪费token就是���费钱呀! 那合格的是系统怎么做的呢?它会把刚才那一次真正成功的交互轨迹像一个漏斗一样,把中间那些没用的废话全都过滤掉,最终压缩固化成一个可执行的Skill技能。 我们可以把它理解成一个一键执行的宏指令,等下次你再遇到类似的bug,Agent的脑子里就不会去想那些大段大段的报错记录了,而是会直接弹出一个动作,【这个坑我上周刚踩过我直接去找之前的那套成功的改法就行了。】 对于企业落地或者个人项目来说,这意味着你的Agent有了越用越聪明的能力,这也就是为什么好的Agent替代人工的原因所在。 五、总结 我们是从最基础的向量数据库的坑开始,一路拆解了ChatGPT那种极其克制的四层架构,然后又聊了构建主动型agent必须具备的流水账本、派生视图和控制策略,最后落地到了时间和技能这两个最容易被踩坑的约束机制上。 其实说到底,想构建一个真正能上线的Agent Memory。 绝对不是简单的买个数据库,然后去拼凑几句prompt!
See More
Rain sky
@Rainskynb66
about 8 hours ago
@tyVictg147
谢谢~
Rain sky
@Rainskynb66
about 18 hours ago
@JohnsonLay70702
有一个软件叫CSDN,还有一个东西j叫GitHub,一个查报错,一个扒框架
Rain sky
@Rainskynb66
about 18 hours ago
@Yobert88ace
谢谢~其实我也是个外行,在四处扒资料学习
Rain sky
@Rainskynb66
about 19 hours ago
@XingYao47854
布吉岛啊,还没试呢
Rain sky
@Rainskynb66
about 19 hours ago
@z2810358647
最关键的是申诉也不管用,机器人秒回邮件,秒封
Rain sky
@Rainskynb66
about 19 hours ago
@xluchuan
直接用comfyui,这个蛮厉害的
Rain sky
@Rainskynb66
about 19 hours ago
@Yobert88ace
你好肝啊包子,我怎么感觉总能看到你的新帖子
Rain sky
@Rainskynb66
about 19 hours ago
@moooonvlgw
香肠和卤蛋!
Rain sky
@Rainskynb66
about 20 hours ago
@wei86947
四处扒资料
Rain sky
@Rainskynb66
about 20 hours ago
@wei86947
嘿嘿,我写了一下午
Rain sky
@Rainskynb66
about 20 hours ago
@wanger985
你steam是qq登陆的吗?我微信区的😉
Rain sky
@Rainskynb66
about 20 hours ago
@zhngkn414984690
完了完了,我的推荐被奶龙占领了
Rain sky
@Rainskynb66
about 20 hours ago
@wanger985
大佬带带
Rain sky
@Rainskynb66
about 22 hours ago
@YxzRainy
好慢的gpt
Rain sky
@Rainskynb66
about 22 hours ago
@zhngkn414984690
尼玛,打开X打算���逛,先挨了一拳
Rain sky
@Rainskynb66
about 22 hours ago
@Aly12138
8888卖给上海人
Last Seen Users on Sotwe
[email protected]
Seen from
Pakistan
Environment & Natural Resources Program
Seen from
Indonesia
Brandi
Seen from
Canada
David sam
Seen from
United States
سكس هندي جديد وحصري
Seen from
Saudi Arabia
Wow
Pierre Sautarel
Seen from
France
𝐒𝐚𝐦𝐦𝐲𝐥𝐚𝐝𝐢𝐞𝐬
Seen from
Vietnam
fresa Gómez
Seen from
Chile
sex tutkunu
Seen from
Indonesia
Trends for you
1
#dwts
Under 10K tweets
2
Michael King
Under 10K tweets
3
Bauers
Under 10K tweets
4
#LaGranjaMX
Under 10K tweets
5
Messi
Under 10K tweets
6
Contreras
Under 10K tweets
7
Marchand
Under 10K tweets
8
#TheDropFX
Under 10K tweets
9
Gasser
Under 10K tweets
10
Merrill
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.7M followers
2
Barack Obama
@barackobama
119M followers
3
Cristiano Ronaldo
@cristiano
114.6M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107.2M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.4M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90.1M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.5M followers
13
Kim Kardashian
@kimkardashian
70.9M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.5M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.3M followers
19
CNN
@cnn
61.8M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫