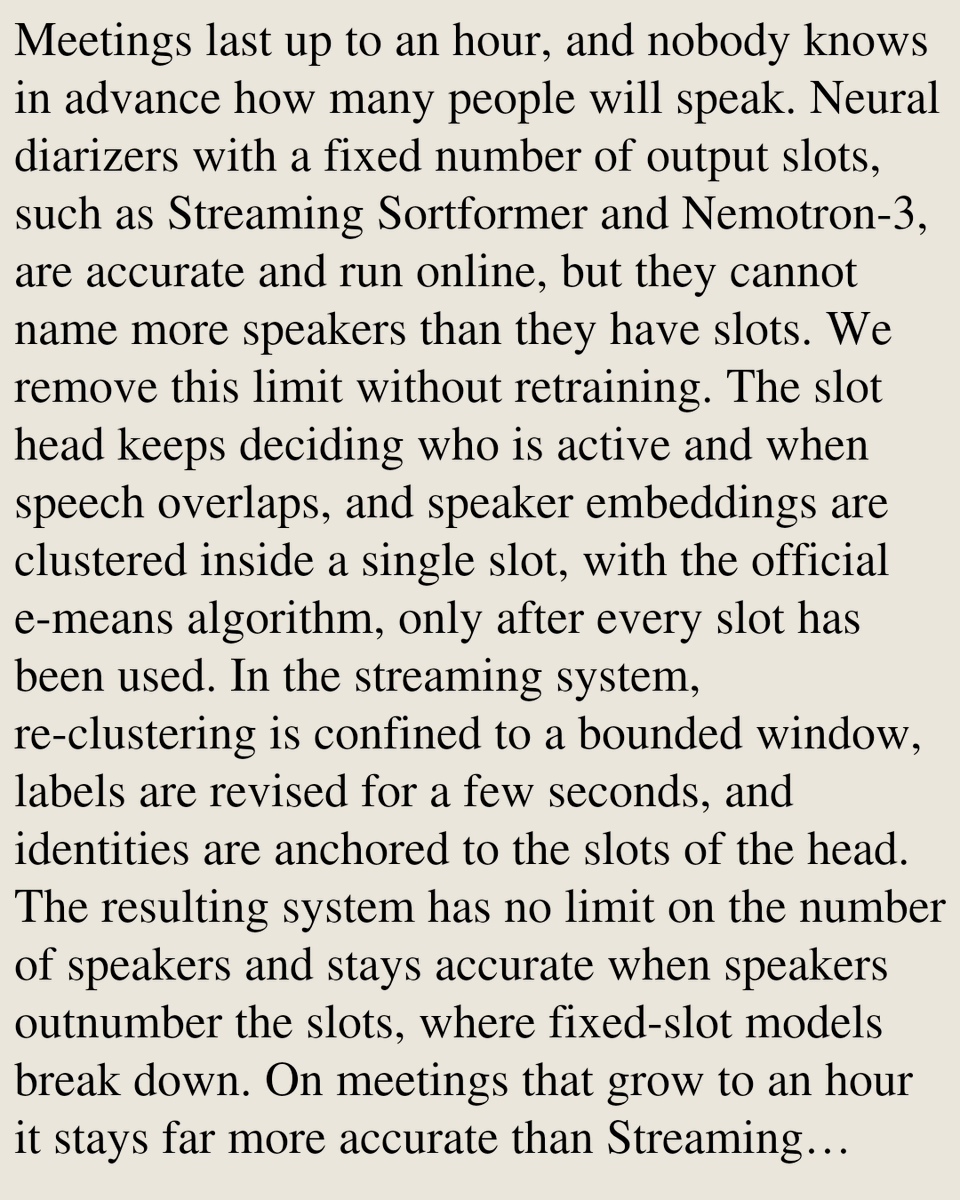
eDIAR: Training-Free Open-Speaker Streaming Diarization for Long Meetings and Large Archives via e-means
Kyudan Jung, Jihwan Kim, Minwoo Lee, Eunji Shin, Jaegul Choo
https://t.co/IRP4Lt8Sxq [𝚌𝚜.𝚂𝙳]
💬Project: https://t.co/VveiTQdyj1
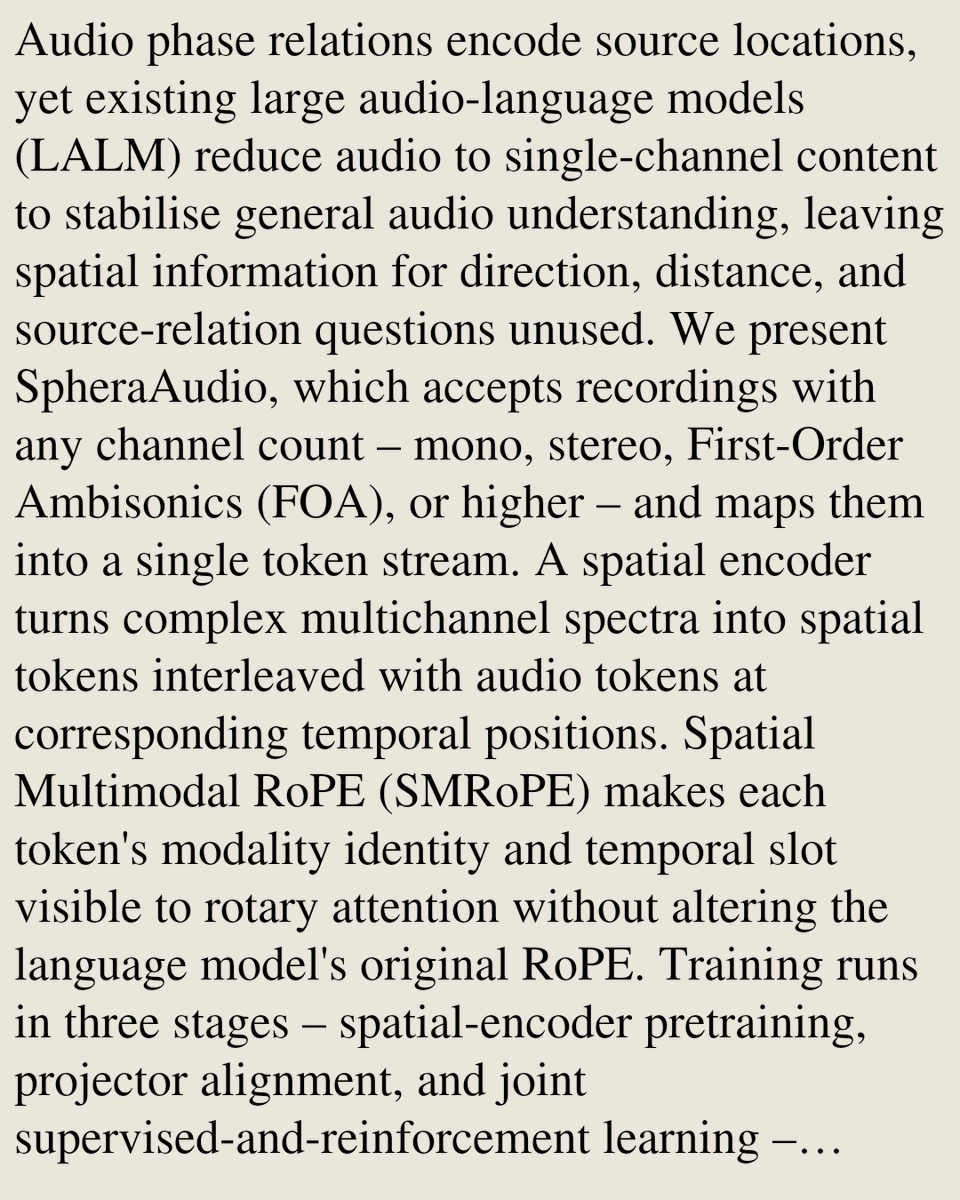
Any Channel Count, One Token Stream: Incorporating Spatial Audio Understanding and Reasoning into Large Audio-Language Models
Yuhuan You, Wenxiang Guo, Zhifang Guo, Yuxuan Wang, Jin Xu
https://t.co/pqOhcGzHHk [𝚌𝚜.𝚂𝙳]
💬Code: https://t.co/fDmhovKu9m.
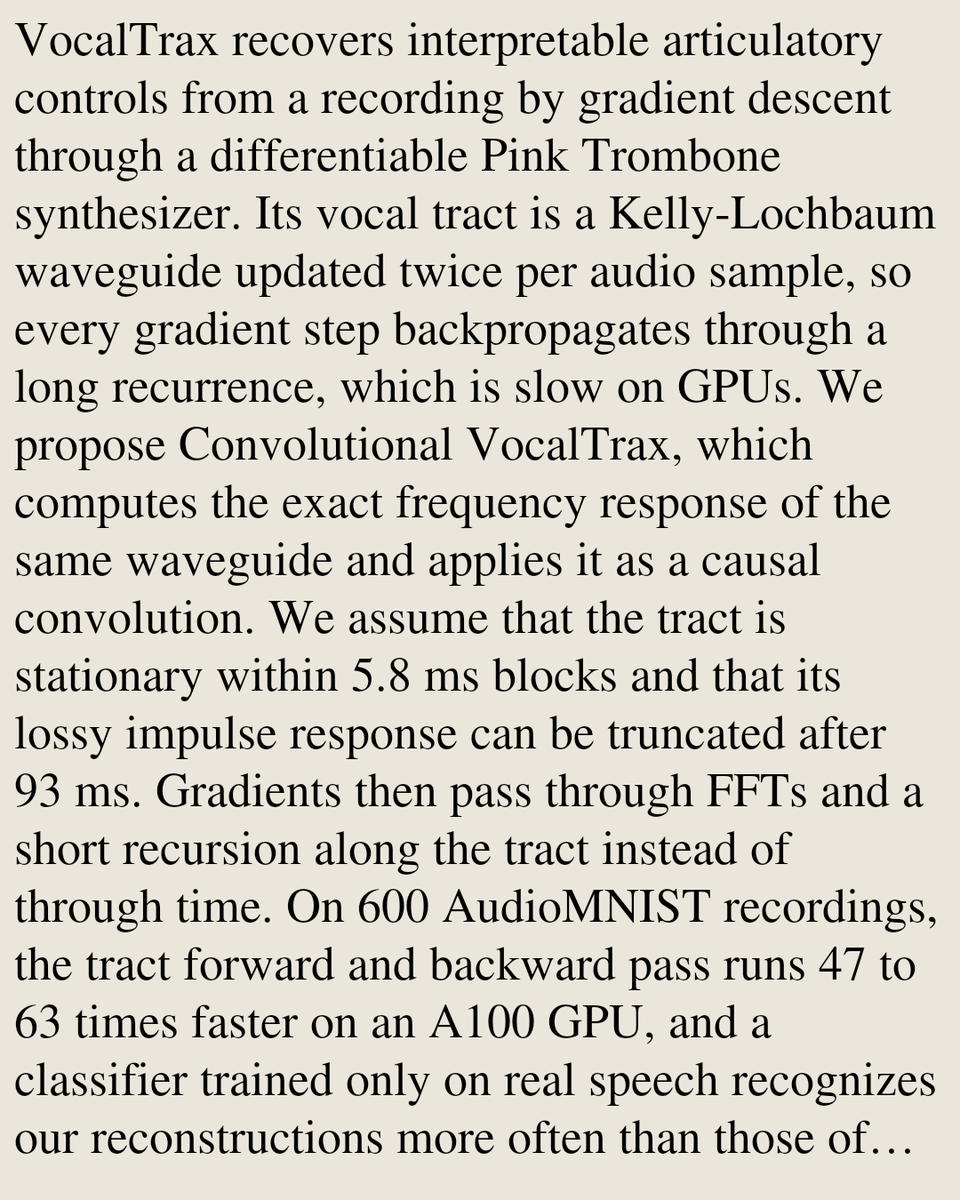
Convolutional VocalTrax: Replacing Backpropagation Through Time with Convolution in Differentiable Articulatory Synthesis
Yongyi Zang, Debasish Ray Mohapatra, Randal Leistikow, Perry R. Cook
https://t.co/C6jmNMYpQ2 [𝚌𝚜.𝚂𝙳]
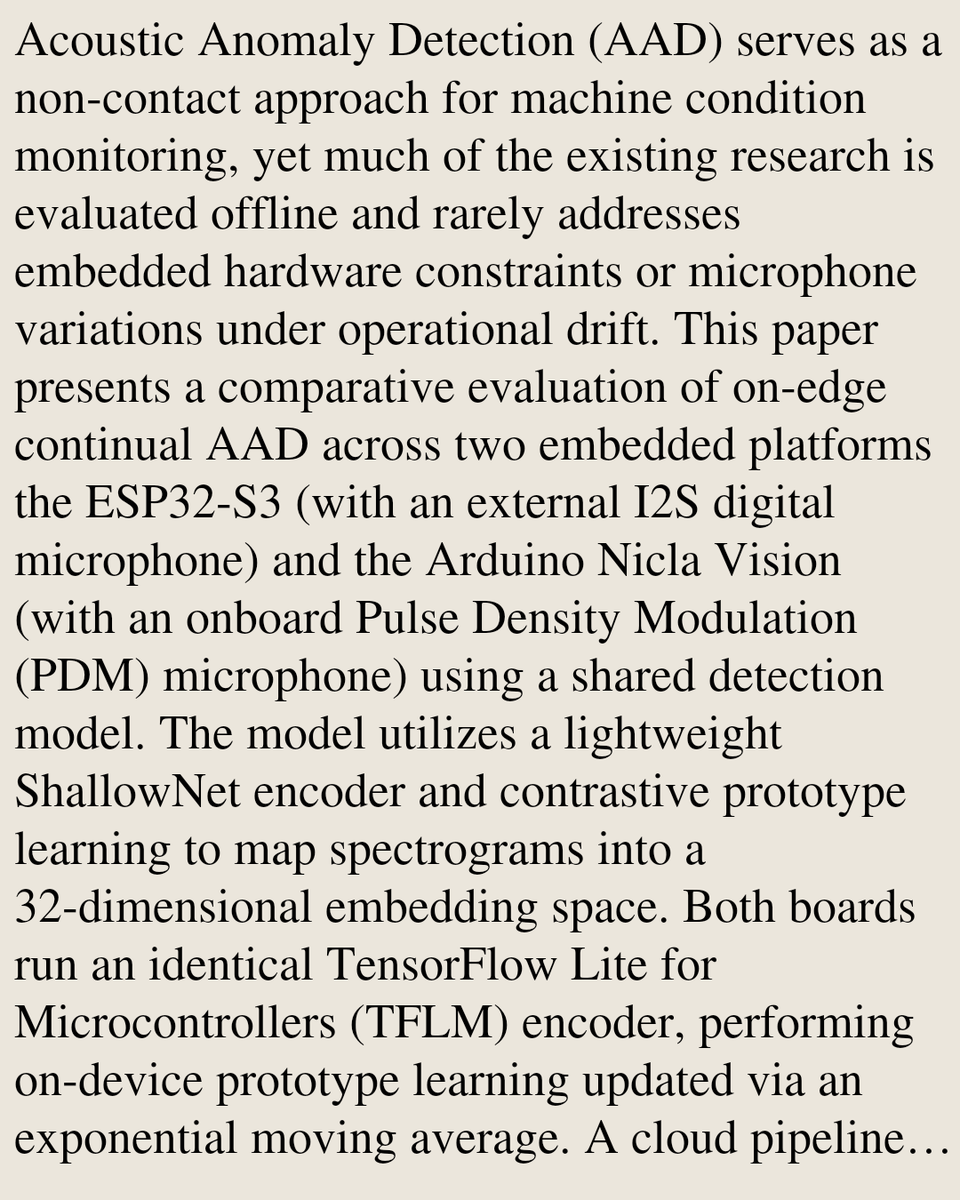
On-Edge Acoustic Continual Anomaly Detection: A Cross-Platform Comparative Study
Rami Zewail, Yehia Ehab, …
https://t.co/wFffyPEnFL [𝚌𝚜.𝚂𝙳 𝚌𝚜.𝙻𝙶]
💬Accepted to the 14th International Japan-Africa Conference on Electronics, Communications and Computations (JAC-ECC 2026)
Right Answers, Inconsistent Evidence: Source-Level Counterfactual Auditing of Large Audio-Language Models
Yi Zhang, Yi Li, Hongwei Du
https://t.co/bjEYmtnD1X [𝚌𝚜.𝚂𝙳 𝚌𝚜.𝙰𝙸]
💬Submitted to ICASSP 2027
DeALR: Decoupled Audio-Latent Optimization with Acoustic Backtracking for Test-Time Reasoning
Haoyu He, Yan Rong, Li Liu
https://t.co/DsgkkvDlTH [𝚌𝚜.𝚂𝙳]
FineSpeaker: Reliable Speaker Representation Learning at Fine Temporal Resolution
Yongkang Yin, Wenhao Yang, Lichun Fan, Jian Luan, Hang Su, Yuexian Zou
https://t.co/jipE5yZWM9 [𝚌𝚜.𝚂𝙳]
Can Music Generation Models Tap Along? Evaluating Generative Approaches to Beat Tracking
Kun Fang, Ziyu Wang, Ichiro Fujinaga
https://t.co/uP9KTg1cfE [𝚌𝚜.𝚂𝙳]
Evaluating AI Musical Creativity: Towards a Quantitative Multi-Dimensional Framework Based on Value, Novelty, and Surprise
Hindy Rossignol, Giorgio Franceschelli, Mirco Musolesi
https://t.co/d2P0Vv7EFE [𝚌𝚜.𝚂𝙳 𝚌𝚜.𝙰𝙸 𝚌𝚜.𝙲𝚈]
Assessing Alignment in Automatic Piano Transcription Datasets: A Benchmark for Scoring Methods
Lucas de Souza Brandão, Lucas Gris, Joaquim Cavalcante, Chukwuemeka Nkama, Andrea Poltronieri
https://t.co/7cJOWpcThk [𝚌𝚜.𝚂𝙳 𝚎𝚎𝚜𝚜.𝙰𝚂]
Exploring Post-Hoc Disentanglement of Audio Foundation Models for Music Similarity
Lucas de Souza Brandão, Gabriel da Costa Merlin, Diego Furtado Silva
https://t.co/qzCB1wtiru [𝚌𝚜.𝚂𝙳 𝚌𝚜.𝙻𝙶]