أندريه كارباتي، أحد مؤسسي OpenAI، طرح فكرة وصلت إلى 16 مليون مشاهدة، وهي استخدام الذكاء الاصطناعي لبناء «عقل رقمي» يحتفظ بكل ما تتعلمه ويجعله قابلًا للبحث والاسترجاع.
الفكرة تعتمد على أداتين:
Obsidian: تطبيق تحفظ فيه مقالاتك وكتبك وملفات PDF وملاحظاتك، ويتيح لك ربط المعلومات ببعضها.
Claude Code: مساعد ذكاء اصطناعي تعطيه صلاحية العمل على ملفاتك، فيقرأ المحتوى ويفهمه ويستخرج أهم المعلومات وينظمها داخل Obsidian.
كيف تستخدمه؟
تثبّت Obsidian وتنشئ مكتبة خاصة بمعرفتك.
تفتح المكتبة باستخدام Claude Code.
تضع فيها أي مقال أو كتاب أو ملف تريد الاحتفاظ بمعلوماته.
تطلب من Claude قراءة المصدر واستخراج أهم الأفكار وربطها بالمعلومات السابقة.
لاحقًا، تستطيع سؤاله عن موضوع معين، وسيبحث في مكتبتك ويربط المعلومات من مصادر مختلفة للإجابة.
مثال: قرأت 10 مقالات عن الذكاء الاصطناعي و5 عن مستقبل الوظائف. بدل ما تنسى محتواها أو تعيد قراءتها، تصبح المعلومات منظمة في مكتبتك، ويمكنك سؤال Claude عن تأثير الذكاء الاصطناعي على سوق العمل بالاعتماد على كل ما جمعته.
الفكرة أنك تبني قاعدة معرفة شخصية تكبر مع الوقت، بدل ما تبدأ من الصفر في كل محادثة.
شرح كامل بالخطوات وطريقة الإعداد في المقال بالأسفل ↓
نشرت Anthropic دليل كامل يشرح افضل طريقة لكتابة التعليمات (Prompts) لنموذج Claude Fable 5.2، والاهم ان بعض العادات التي اعتدنا استخدامها مع النماذج السابقة اصبحت تؤثر سلبًا على ادائه.
الدليل يوضح عدة نقاط تستحق الانتباه:
1. اعطه ملكية المشروع، وليس مجرد مهمة لتنفيذها.
بدل ما تطلب منه إصلاح مشكلة محددة، وضح له ان المشروع ملكه وان عليه مواصلة تطويره وتحسينه.
مثال، إذا طلبت منه تعديل موقع، لا تجعله يضيف حلول جديدة فوق الأكواد القديمة فقط، بل وجهه إلى مراجعة البنية الحالية، وإزالة التكرار، وتحسين الكود الموجود.
بحسب تجارب Anthropic، هذا التوجيه رفع قدرته على تنظيف الأكواد المتكررة بشكل ملحوظ.
2. لا تتركه يتوقف عند اول عقبة.
في المهام الطويلة، قد يتوقف النموذج مبكراً، خصوصا عند استخدام مستويات الجهد المنخفضة او المتوسطة.
الحل هو توضيح انك تريده ان يواصل العمل، ويتعامل بنفسه مع الأخطاء العادية ومشكلات انتهاء المهلة، بدل ان يتوقف وينتظر منك التدخل.
هذا التغيير خفض عدد الجلسات التي تنتهي دون اكمال المهمة إلى النصف.
3. لا تحاول تسريع المهام بعبارات عامة.
عبارات مثل «اجب مباشرة ولا تفكر كثيراً» لم تعد تحقق النتيجة المطلوبة؛ فالنموذج سيظل يفكر حتى مع هذه التعليمات.
إذا كانت المهمة بسيطة وتستغرق وقت اكثر من اللازم، الأفضل تخفيض مستوى الجهد (Effort Level) بدل محاولة اجباره بالكلمات على التفكير بشكل أقل.
4. راجع ذاكرته قبل بدء مشروع جديد.
ملفات الذاكرة والملاحظات القديمة قد تحتوي على تعليمات لم تعد مناسبة، وتؤثر على قرارات النموذج دون ان تنتبه.
مثال، وجود تعليمات قديمة تمنعه من اعادة المحاولة (Never retry) قد يجعله يتوقف عن المحاولة حتى عندما يكون الخطأ قابل للحل.
لذلك، تنظيف الملاحظات القديمة وتحديثها جزء مهم من تحسين ادائه.
5. كن واضح عندما تمنحه الإذن بتنفيذ اجراء.
لا تستخدم موافقات عامة مثل «تمام» او «انطلق» عندما تكون المهمة تتطلب إجراء محدد.
قل له بوضوح: «نعم، نفذ ترحيل قاعدة البيانات على بيئة الاختبار».
كلما كان الإذن محدد، اصبح من السهل عليه فهم الإجراء الذي وافقت عليه دون الخلط بينه وبين خطوات اخرى.
6. استخدم مستوى الجهد المرتفع لمعظم المهام.
توضح Anthropic ان مستوى الجهد المرتفع (High Effort) يحقق معظم التحسن المطلوب في المهام، بينما الانتقال إلى مستويات أعلى لا يقدم مكاسب مماثلة لحجم الزيادة في استهلاك الرموز (Tokens).
بمعنى آخر، ليس من الضروري تشغيل اعلى مستوى تفكير في كل مهمة؛ اختر المستوى بناء على تعقيد العمل.
7. لا تفرض قيود غير ضرورية على طريقة كتابة التقارير.
قد تعتقد ان وضع قواعد صارمة يجعل النتائج افضل، لكن أحيانا يحدث العكس.
مثال، عندما تطلب من النموذج ألا تتجاوز كل جملة 20 كلمة، قد يلتزم بالشرط حرفيا لدرجة ان تقريره النهائي يصبح مجموعة عبارات متقطعة يصعب فهمها.
الأفضل ان تحدد ما تحتاجه فعلا، وتترك له مساحة كافية لصياغة النتيجة بشكل طبيعي.
الخلاصة: مع تطور النماذج، يجب ان تتطور طريقة توجيهها ايضا.
بعض التعليمات التي كانت ضرورية في السابق اصبحت اليوم قيود غير مفيدة، وقد تدفع النموذج إلى التصرف بعكس ما تريده.
بدل ان تملأ الـ Prompt بالتحذيرات والقواعد القديمة، ركز على تحديد الهدف، ومنح النموذج الصلاحيات المناسبة، وتوضيح النتيجة التي تتوقعها منه.
جربت Grok Bot لمدة 24 ساعة، واعطيته 3 مهام مختلفة، والشيء اللي لفت انتباهي ما كان مجرد قدرته على البحث، بل الطريقة اللي غير فيها مفهوم استخدامي للذكاء الاصطناعي.
بدل ما اتعامل معه كمحادثة اكتب فيها سؤال وانتظر الإجابة، بديت اتعامل معه كاوكيل يمديني افويضه مهام كاملة.
في وحده من المهام، طلبت منه يتابع الاحداث في عالم الذكاء الاصطناعي بشكل مستمر:
يرصد المنتجات الجديدة على منصة X والمواقع، يبحث عن تجارب المستخدمين وارائهم الحقيقية، يميز بين النقاشات المفيدة والمنشورات التي هدفها مجرد جمع التفاعل، ثم يقارن المعلومات بين المصادر ويجمع اهم النتائج في تقرير منظم.
والاهم ان العمل ما كان محصور على مهمة وحدة؛ كان يمديني اشغل مسارات اكثر بحث مستقلة بالوقت نفسه، مثل تحليل المنافسين، ومراجعة الاكواد البرمجية، واكتشاف فرص جديدة في السوق.
وهذا يفتح مجال مختلف كليا للاستخدام.
تخيل انك تدير مشروع تقني وتبي تدري وش يسوون منافسينك. بدل ما تبحث عن كل شركة بشكل منفصل، وتتنقل بين المواقع والمنشورات وتجمع المعلومات بشكل دائم، يمديك تفوض وكيل ينفذ المهمة، يبحث ويقارن ويرتب النتائج، ثم تتدخل انت تراجع وش وصل له وتتاخذ قرارك.
هنا يظهر الفرق الحقيقي بين المساعد التقليدي والوكيل الذكي.
قبل ، كنت انت اللى تدير كل خطوة:
تكتب الطلب، تنتظر الإجابة، تنسخ النتائج، ثم تبدأ محادثة جديدة وتكرر العملية.
اما الحين، دورك تغير:
كل اللى عليك تحدد الهدف، توفر له الادوات والبيانات اللازمة، وتترك الوكيل ينفذ المهام، ثم تراجع النتيجة وتتدخل عندما تحتاج إلى حكمك او موافقتك.
بالنسبة لي، هذه هي النقلة التي تستحق الاهتمام في الذكاء الاصطناعي.
الحين ما نحتاج الى ذكاء اصطناعي يجيب على اسئلتنا، بل نحتاج إلى وكلاء يستطيعون تولي المهام، والعمل على عدة مسارات، والوصول إلى نتائج بدون نضطر إلى توجيههم في كل خطوة.
4 نماذج ذكاء اصطناعي حصلت على الطلب نفسه، لكن النتائج كشفت فرق كبير في الجودة والتكلفة وسرعة التنفيذ.
المهمة كانت إنشاء مشهد سينمائي لقطار بخاري يشق طريقه وسط غابة شتوية مغطاة بالثلوج.
النتائج:
🥇 Fable 5.2 — دولار 6 | دقيقتان
🥈 Opus 5.5 — دولار 24 | 7 دقائق
🥉 Kimi K3.1 — دولار 58 | 16 دقيقة
💀GPT-6 Astra — دولار 93 | 23 دقيقة
المفاجأة ان Fable 5.2 لم يكن الأرخص والأسرع فقط، بل قدم ايضا النتيجة الأكثر إبهار بصريا، مع تفاصيل دقيقة للقطار وسحب بخار كثيفة وإضاءة شتوية سينمائية.
في المقابل، انفق GPT-6 Astra نحو 15.5 ضعف تكلفة Fable، واستغرق وقت اطول بنحو 11.5 ضعف، ومع ذلك كانت نتيجته اقل جودة في هذه التجربة.
الاهم من هذي التجربة ان ارتفاع تكلفة النموذج لا يعني بالضرورة الحصول على نتيجة افضل، وان الفارق بين النماذج قد يكون اكبر بكثير مما نتوقع عند تنفيذ المهمة نفسها.
بالنسبة لمن يستخدم هذه النماذج في الإنتاج، فالكفاءة لا تتعلق بجودة المخرجات وحدها، بل بما تدفعه والوقت الذي تستغرقه للوصول إليها.
أعلنت xAI عن Grok Bot 1.0، وهي خطوة باتجاه تحويل الذكاء الاصطناعي من مجرد مساعد شخصي إلى زميل عمل يشارك الفريق مهامه اليومية.
الفكرة أنك تستطيع إنشاء Bots ومشاركتها مع بقية أعضاء الفريق، والتعاون معها مباشرة عبر Slack وMicrosoft Teams، وحتى دعوتها لحضور الاجتماعات.
ومع استمرار استخدامها، تتعلم هذه الروبوتات من سياق العمل وتصبح أكثر فائدة في مساعدة الفريق.
تخيّل مثلًا أن فريقك يعمل على مشروع، ويمكن للجميع الاستعانة بالروبوت نفسه، ومشاركة المهام معه، وإشراكه في الاجتماعات بدلًا من أن يعمل كل شخص مع مساعد منفصل.
التحول المهم هنا هو أن الذكاء الاصطناعي لم يعد مجرد أداة يستخدمها الموظف بمفرده، بل أصبح جزءًا من بيئة العمل الجماعية.
Anthropic تطرح طريقة ذكية لتنظيم العمل داخل Claude Code: بدل ما تعتمد على نموذج واحد لتنفيذ كل شيء، وزع المهام بين ثلاثة نماذج، بحيث يعمل كل نموذج في الدور الذي يناسب قدراته.
الفكرة تقوم على تقسيم العمل كالتالي:
1. Sonnet 5.5: المهندس المسؤول عن التنفيذ
يكون النموذج الأساسي الذي يقود الجلسة، يكتب الكود، يعدّل الملفات، وينفذ الاختبارات. بمعنى آخر، هو المسؤول عن بناء المشروع وتحويل الخطة إلى تطبيق فعلي.
2. Haiku 5.5: فريق البحث والمساعدين
بدل ما يستهلك Sonnet وقته في البحث داخل آلاف الملفات او قراءة التوثيق البرمجي، يتولى Haiku هذه المهام من خلال وكلاء يعملون بالتوازي.
مثل:
البحث عن الملف المسؤول عن ميزة معينة.
قراءة توثيق واجهة برمجية (API).
تحليل بنية الملفات والكود.
جمع المعلومات اللازمة قبل بدء التنفيذ.
3. Opus 5.5: المستشار المعماري
هنا الجزء الأهم. بدل استخدام Opus طوال الجلسة، يبقى متاح لاستدعائه عند نقاط تحتاج إلى تفكير أعمق ومراجعة استراتيجية.
مثل:
قبل اعتماد خطة التنفيذ، يراجع التصميم ويتأكد من عدم وجود أخطاء في بنية النظام أو الصلاحيات.
إذا فشل الاختبار مرتين، يساعد في تحديد السبب الجذري بدل الاستمرار في حلول متكررة.
قبل إنهاء المهمة، يراجع التعديلات للتأكد من عدم إدخال أخطاء او التأثير على أجزاء اخرى من المشروع.
لماذا هذا التوزيع مهم؟
لأن البحث عن ملف او قراءة توثيق لا يحتاجان بالضرورة إلى قدرات Opus، بينما اتخاذ قرار معماري معقد قد يستحق الاستعانه به.
والنتيجة ان النموذج الأساسي يركز على البناء، والنماذج المساعدة تتولى البحث، والنموذج الأقوى يتدخل عندما تكون هناك حاجة فعلية إلى خبرته.
حتى ان Anthropic تقترح إضافة طبقة أخرى لاتخاذ القرارات التنفيذية البسيطة، مثل تحديد الملف الذي يجب فتحه أو الأداة التي يجب استخدامها، دون استدعاء النماذج الكبيرة في كل مرة.
بختصار:
لا تجعل اقوى نموذج ينفذ كل المهام. اجعله يراجع القرارات التي تستحق قدراته، واترك التنفيذ والبحث للنماذج الأنسب لكل مهمة.
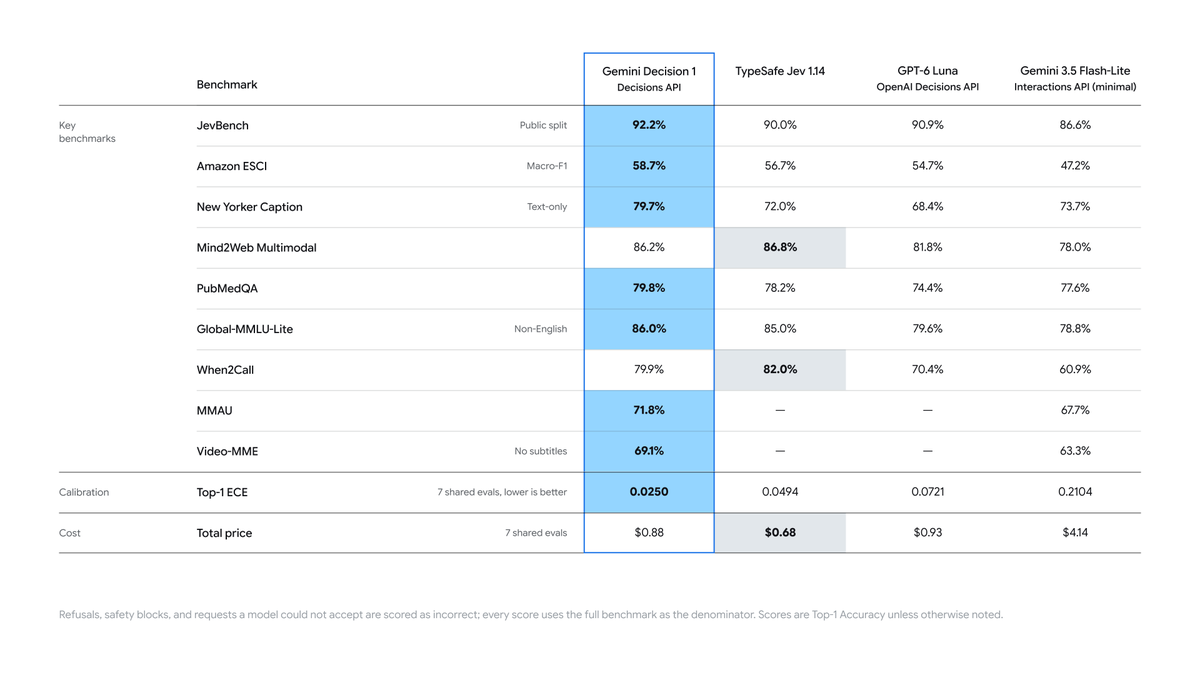
اطلقت Google واجهة Gemini Decisions API، المدعومة بنموذج جديد اسمه Gemini Decision 1، والمصمم للتعامل مع المهام التي تتطلب اتخاذ قرارات بناء على المعلومات المتاحة.
الجديد هنا ان المطورين يقدرون يرسلون الى 1000 سؤال مره وحدة، ويحصلون على قرارات سريعة مع تقديرات لمدى موثوقيتها، بدال من معالجة كل سؤال بشكل منفصل.
والاهم ان النموذج متعدد الوسائط، اي يمديه يتعامل مع النصوص والصور والصوت والفيديو وملفات PDF.
على سبيل المثال، تخيل ان عندك متجر الكتروني وتبي تراجعة 1000 طلب لتحديد الطلبات التي تحتاج الى مراجعة اضافية، او عندك مئات المستندات وتريد تصنيفها بناء على معايير محددة.
بدال ما من ترسل كل حالة للنموذج وانتظار اجابة منفصلة، الحين يمديك ترسل الحالات مره وحدة يعالجها ويتخذ القرارات المطلوبة.
هذا يفتح المجال امام بناء انظمة تتعامل مع الاف الحالات والبيانات بكفاءة اكبر، خصوصا في المهام التي تتطلب تصنيف او تقييم او تختار بين عدة احتمالات.
يمكن للمطورين تجربة الواجهة الان عبر Google AI Studio واستخدامها من خلال Gemini API.
جربت Grok Bot لمدة 24 ساعة، واعطيته 3 مهام مختلفة، والشيء اللي لفت انتباهي ما كان مجرد قدرته على البحث، بل الطريقة اللي غير فيها مفهوم استخدامي للذكاء الاصطناعي.
بدل ما اتعامل معه كمحادثة اكتب فيها سؤال وانتظر الإجابة، بديت اتعامل معه كاوكيل يمديني افويضه مهام كاملة.
في وحده من المهام، طلبت منه يتابع الاحداث في عالم الذكاء الاصطناعي بشكل مستمر:
يرصد المنتجات الجديدة على منصة X والمواقع، يبحث عن تجارب المستخدمين وارائهم الحقيقية، يميز بين النقاشات المفيدة والمنشورات التي هدفها مجرد جمع التفاعل، ثم يقارن المعلومات بين المصادر ويجمع اهم النتائج في تقرير منظم.
والاهم ان العمل ما كان محصور على مهمة وحدة؛ كان يمديني اشغل مسارات اكثر بحث مستقلة بالوقت نفسه، مثل تحليل المنافسين، ومراجعة الاكواد البرمجية، واكتشاف فرص جديدة في السوق.
وهذا يفتح مجال مختلف كليا للاستخدام.
تخيل انك تدير مشروع تقني وتبي تدري وش يسوون منافسينك. بدل ما تبحث عن كل شركة بشكل منفصل، وتتنقل بين المواقع والمنشورات وتجمع المعلومات بشكل دائم، يمديك تفوض وكيل ينفذ المهمة، يبحث ويقارن ويرتب النتائج، ثم تتدخل انت تراجع وش وصل له وتتاخذ قرارك.
هنا يظهر الفرق الحقيقي بين المساعد التقليدي والوكيل الذكي.
قبل ، كنت انت اللى تدير كل خطوة:
تكتب الطلب، تنتظر الإجابة، تنسخ النتائج، ثم تبدأ محادثة جديدة وتكرر العملية.
اما الحين، دورك تغير:
كل اللى عليك تحدد الهدف، توفر له الادوات والبيانات اللازمة، وتترك الوكيل ينفذ المهام، ثم تراجع النتيجة وتتدخل عندما تحتاج إلى حكمك او موافقتك.
بالنسبة لي، هذه هي النقلة التي تستحق الاهتمام في الذكاء الاصطناعي.
الحين ما نحتاج الى ذكاء اصطناعي يجيب على اسئلتنا، بل نحتاج إلى وكلاء يستطيعون تولي المهام، والعمل على عدة مسارات، والوصول إلى نتائج بدون نضطر إلى توجيههم في كل خطوة.
اختبر أحد المطورين قدرات Claude Fable 5.2 بطريقة مختلفة: طلب منه إنشاء لعبة كاملة من الصفر باستخدام توجيه واحد فقط، دون تقديم أي ملاحظات أو تدخل بشري أثناء العمل.
النتيجة كانت لعبة بُنيت جميع عناصرها من الصفر، بما في ذلك النماذج والأصوات والخامات البصرية (Textures).
استغرقت العملية 8 ساعات متواصلة، واستهلكت نحو 445 مليون Token للإدخال و2.7 مليون Token للإخراج، بتكلفة تقديرية تبلغ 550 دولارًا وفق أسعار واجهة API.
أهمية التجربة ليست في اللعبة وحدها، بل في اختبار قدرة النموذج على تحويل فكرة واحدة إلى مشروع متكامل، والتعامل مع تفاصيل متعددة دون الحاجة إلى توجيه الإنسان في كل خطوة.
يمكنك تجربة اللعبة تحت 👇🏻:
Anthropic تطرح طريقة ذكية لتنظيم العمل داخل Claude Code: بدل ما تعتمد على نموذج واحد لتنفيذ كل شيء، وزع المهام بين ثلاثة نماذج، بحيث يعمل كل نموذج في الدور الذي يناسب قدراته.
الفكرة تقوم على تقسيم العمل كالتالي:
1. Sonnet 5.5: المهندس المسؤول عن التنفيذ
يكون النموذج الأساسي الذي يقود الجلسة، يكتب الكود، يعدّل الملفات، وينفذ الاختبارات. بمعنى آخر، هو المسؤول عن بناء المشروع وتحويل الخطة إلى تطبيق فعلي.
2. Haiku 5.5: فريق البحث والمساعدين
بدل ما يستهلك Sonnet وقته في البحث داخل آلاف الملفات او قراءة التوثيق البرمجي، يتولى Haiku هذه المهام من خلال وكلاء يعملون بالتوازي.
مثل:
البحث عن الملف المسؤول عن ميزة معينة.
قراءة توثيق واجهة برمجية (API).
تحليل بنية الملفات والكود.
جمع المعلومات اللازمة قبل بدء التنفيذ.
3. Opus 5.5: المستشار المعماري
هنا الجزء الأهم. بدل استخدام Opus طوال الجلسة، يبقى متاح لاستدعائه عند نقاط تحتاج إلى تفكير أعمق ومراجعة استراتيجية.
مثل:
قبل اعتماد خطة التنفيذ، يراجع التصميم ويتأكد من عدم وجود أخطاء في بنية النظام أو الصلاحيات.
إذا فشل الاختبار مرتين، يساعد في تحديد السبب الجذري بدل الاستمرار في حلول متكررة.
قبل إنهاء المهمة، يراجع التعديلات للتأكد من عدم إدخال أخطاء او التأثير على أجزاء اخرى من المشروع.
لماذا هذا التوزيع مهم؟
لأن البحث عن ملف او قراءة توثيق لا يحتاجان بالضرورة إلى قدرات Opus، بينما اتخاذ قرار معماري معقد قد يستحق الاستعانه به.
والنتيجة ان النموذج الأساسي يركز على البناء، والنماذج المساعدة تتولى البحث، والنموذج الأقوى يتدخل عندما تكون هناك حاجة فعلية إلى خبرته.
حتى ان Anthropic تقترح إضافة طبقة أخرى لاتخاذ القرارات التنفيذية البسيطة، مثل تحديد الملف الذي يجب فتحه أو الأداة التي يجب استخدامها، دون استدعاء النماذج الكبيرة في كل مرة.
بختصار:
لا تجعل اقوى نموذج ينفذ كل المهام. اجعله يراجع القرارات التي تستحق قدراته، واترك التنفيذ والبحث للنماذج الأنسب لكل مهمة.
Anthropic تكشف عن طريقة مثيرة لتحويل Claude Fable 5.2 إلى وكيل ذكي أشبه بالمساعد الشخصي Jarvis
الفكرة ليست مجرد استخدام نموذج قوي، بل بناء نظام متكامل يتولى التخطيط والتنفيذ وتوزيع المهام ومراجعة النتائج، مع الاستعانة بنماذج أصغر لإنجاز الأعمال الروتينية.
كيف يعمل النظام؟
• Fable 5.2: العقل المدبر، يخطط للعمل ويتخذ القرارات ويراجع النتائج.
• Sonnet 5.5: يتولى تنفيذ المهام وكتابة الأكواد.
• Haiku 5.5: يتولى المهام السريعة مثل البحث داخل الملفات وقراءة التوثيق.
• الأدوات والوكلاء الفرعيون: ينفذون المهام التي يوزعها عليهم النموذج الرئيسي.
مثال عملي:
تخيل أنك طلبت بناء تطبيق لإدارة المهام.
بدل تنفيذ كل شيء بنفسه، يستطيع Fable تقسيم المشروع إلى مهام:
يطلب من Haiku البحث عن الملفات والأكواد ذات الصلة.
يكلف Sonnet بتنفيذ أجزاء محددة من التطبيق.
يراجع النتائج ويتأكد من عملها.
يعرض عليك تقريرا بما أنجزه وما تبقى.
والأهم أنه لا يتوقف عند أول عقبة؛ بل يحاول تشخيص الأخطاء وإصلاحها ومواصلة العمل.
هناك أيضا تفاصيل مهمة في طريقة تشغيله:
1. مستويات التفكير
يوفر النظام خمسة مستويات للجهد: Low وMedium وHigh وXhigh وMax.
كل مستوى يناسب نوعًا مختلفًا من المهام؛ فالأعمال البسيطة لا تحتاج إلى تفكير طويل، بينما البرمجة المعقدة والمهام الممتدة تستفيد من مستويات أعلى.
2. توزيع العمل بذكاء
يمكنك جعل Fable هو المسؤول عن المشروع، والاستعانة بوكلاء أصغر لتنفيذ المهام المتوازية، مع تحديد تكلفة كل وكيل ومتى يستحق استخدامه.
3. التحكم في الصلاحيات
لا يحتاج النظام إلى طلب موافقتك على كل خطوة، بل يمكنه مواصلة العمل بشكل طبيعي، مع التوقف عند الإجراءات الحساسة التي تحددها مسبقًا، مثل حذف الملفات أو نشر تحديثات إنتاجية.
4. الذاكرة واستمرارية العمل
يحتفظ بالتعليمات المهمة وسياق العمل، ويقدم تقارير عن التقدم، حتى يتمكن من مواصلة المهام الطويلة دون إعادة شرح كل شيء في كل مرة.
الفكرة هنا أن Claude لم يعد مجرد نموذج تنتظر منه إجابة؛ بل يمكن تحويله إلى نظام عمل متكامل، يخطط وينفذ ويستعين بغيره ويراجع ما أنجزه.
وهذا هو الاتجاه الأهم في تطور وكلاء الذكاء الاصطناعي.
Anthropic تكشف عن طريقة مثيرة لتحويل Claude Fable 5.2 إلى وكيل ذكي أشبه بالمساعد الشخصي Jarvis
الفكرة ليست مجرد استخدام نموذج قوي، بل بناء نظام متكامل يتولى التخطيط والتنفيذ وتوزيع المهام ومراجعة النتائج، مع الاستعانة بنماذج أصغر لإنجاز الأعمال الروتينية.
كيف يعمل النظام؟
• Fable 5.2: العقل المدبر، يخطط للعمل ويتخذ القرارات ويراجع النتائج.
• Sonnet 5.5: يتولى تنفيذ المهام وكتابة الأكواد.
• Haiku 5.5: يتولى المهام السريعة مثل البحث داخل الملفات وقراءة التوثيق.
• الأدوات والوكلاء الفرعيون: ينفذون المهام التي يوزعها عليهم النموذج الرئيسي.
مثال عملي:
تخيل أنك طلبت بناء تطبيق لإدارة المهام.
بدل تنفيذ كل شيء بنفسه، يستطيع Fable تقسيم المشروع إلى مهام:
يطلب من Haiku البحث عن الملفات والأكواد ذات الصلة.
يكلف Sonnet بتنفيذ أجزاء محددة من التطبيق.
يراجع النتائج ويتأكد من عملها.
يعرض عليك تقريرا بما أنجزه وما تبقى.
والأهم أنه لا يتوقف عند أول عقبة؛ بل يحاول تشخيص الأخطاء وإصلاحها ومواصلة العمل.
هناك أيضا تفاصيل مهمة في طريقة تشغيله:
1. مستويات التفكير
يوفر النظام خمسة مستويات للجهد: Low وMedium وHigh وXhigh وMax.
كل مستوى يناسب نوعًا مختلفًا من المهام؛ فالأعمال البسيطة لا تحتاج إلى تفكير طويل، بينما البرمجة المعقدة والمهام الممتدة تستفيد من مستويات أعلى.
2. توزيع العمل بذكاء
يمكنك جعل Fable هو المسؤول عن المشروع، والاستعانة بوكلاء أصغر لتنفيذ المهام المتوازية، مع تحديد تكلفة كل وكيل ومتى يستحق استخدامه.
3. التحكم في الصلاحيات
لا يحتاج النظام إلى طلب موافقتك على كل خطوة، بل يمكنه مواصلة العمل بشكل طبيعي، مع التوقف عند الإجراءات الحساسة التي تحددها مسبقًا، مثل حذف الملفات أو نشر تحديثات إنتاجية.
4. الذاكرة واستمرارية العمل
يحتفظ بالتعليمات المهمة وسياق العمل، ويقدم تقارير عن التقدم، حتى يتمكن من مواصلة المهام الطويلة دون إعادة شرح كل شيء في كل مرة.
الفكرة هنا أن Claude لم يعد مجرد نموذج تنتظر منه إجابة؛ بل يمكن تحويله إلى نظام عمل متكامل، يخطط وينفذ ويستعين بغيره ويراجع ما أنجزه.
وهذا هو الاتجاه الأهم في تطور وكلاء الذكاء الاصطناعي.
Claude يحصل على مجموعة أدوات جديدة تحوله إلى مساحة عمل متكاملة، وليس مجرد مساعد للمحادثة.
التحديث يشمل ثلاث أدوات رئيسية:
1- Claude Whiteboards: حول أفكارك وخططك غير المرتبة إلى لوحة مرئية يمكن لفريقك تعديلها والعمل عليها.
2- Claude Sheets: أنشئ جداول بيانات وميزانيات وأدوات تتبّع بمجرد وصف ما تحتاجه، ثم واصل العمل عليها مع فريقك.
3- Claude Data: حول بياناتك إلى لوحات معلومات وتقارير مرئية، وحتى مقاطع فيديو تشرح النتائج بصوت سردي.
وهناك إضافة مهمة: أصبحت الموصلات التفاعلية تتيح لك فتح النسخة الكاملة من أدوات مثل Adobe وAtlassian وBox داخل Claude، والعمل عليها مباشرة أو بمساعدة Claude.
التوفر:
Whiteboards وSheets: تجريبي للمشتركين في الخطة Ultra.
Data: متاح لجميع مشتركي الخطط المدفوعة.
الموصلات التفاعلية: بدأ طرحها على الويب وتطبيق الكمبيوتر.
بهذي الإضافات، أصبح بإمكانك الانتقال من تنظيم الأفكار إلى تنفيذ المهام وتحليل النتائج، كل ذلك من خلال Claude وفي مساحة عمل واحدة.
Starting to roll out today: Claude Whiteboards, Claude Sheets and Claude Data.
Think a plan through on a board, build a tracker in a sheet, and tell a story with your data.