Salió Claude Opus 5, ya lo están comparando con Fable 5 y con GPT-5.6 Sol, y en dos días te van a llenar el feed de tablas con benchmarks. Antes de que te comas una, pará un segundo.
Los números, rápido: Fable 5 va 10 y 50 dólares por millón de tokens, Opus 5 salió en 5 y 25, Sol está en 5 y 30. Los tres con alrededor de un millón de tokens de contexto. Hasta ahí, todo lindo, todo comparable.
Ahora, ¿qué dice cada uno de sí mismo? Anthropic dice que Opus 5 es lo mejor que hay en coding y knowledge work. OpenAI dice que Sol es lo mejor que hay en coding. Fantástico. Los dos son el mejor. Los dos tienen el gráfico que lo demuestra.
¿Y sabés por qué pasa eso? Porque cada laboratorio corre sus propios benchmarks, con su propio harness, eligiendo contra quién compararse y en qué configuración. Nadie corrió los tres el mismo día con el mismo setup. Un benchmark no es una verdad, es un argumento de venta con formato de ciencia.
Y te doy el ejemplo más concreto que encontré. Los modelos Claude de 4.7 en adelante usan un tokenizer nuevo que genera cerca de 30% más tokens para el mismo texto. ¿Entendés lo que significa? Que cuando comparás precio por millón de tokens entre Anthropic y OpenAI, estás comparando dos unidades de medida distintas. El precio por token no es el precio por trabajo hecho. Y esa tabla circuló por todos lados y nadie leyó la nota al pie.
Entonces, ¿qué hacés? Lo mismo de siempre, lo que no cambia con ningún lanzamiento: agarrá una tarea real de tu proyecto, una que ya sepas cómo termina, y pasásela a los tres. Mirá el resultado, mirá cuánto tardó, mirá cuánto te salió de verdad. Una tarde de trabajo te da más información que veinte hilos de X.
La única data que sirve es la que sale de tu codebase. Todo lo demás es marketing de alguien.
https://t.co/8534iRm21F
Se viene la comparativa, y la hago así.
Éxitos, mis locuritas cósmicas.
@G_Programming @matiasmoreno876 Pfff es una maravilla!!! Igual doy seguimiento a mis agentes de gentle-ai con mi Fold 7, Tailscale y termius. Pero después de tu último video le echaré un ojo a Herdr. Gracias @G_Programming por todo lo que haces por la comunidad 🫶🏻❤️
El mejor mensaje que recibí esta semana no tenía nada que ver con benchmarks ni con releases.
Un dev de la comunidad, en Venezuela, me escribió para contarme que usó gentle-ai, gentle-pi y un flujo de spec-driven development para construir una plataforma que ayuda a gestionar heridos, centros de acopio y ayuda humanitaria en medio de una situación durísima.
La armó él. Sobre la marcha. Con herramientas open source que comparto gratis.
Y acá está lo que me paró en seco:
Llevo semanas posteando sobre gobernanza, export controls, modelos demasiado capaces, el Estado metiendo la mano. Todo eso importa. Pero este mensaje me recordó para QUÉ hacemos todo esto.
La IA no construyó esa plataforma. ÉL la construyó. La IA ejecutó, pero la decisión de usar la tecnología para ayudar a su gente, y el criterio para saber qué pedir y por qué, fue 100% humano. Eso es Tony Stark con Jarvis llevado al lugar donde más importa.
Yo no enseño a usar IA para que armes otra to-do app. Enseño para que, el día que tu comunidad te necesite, tengas la herramienta Y el criterio para construir algo que importe de verdad.
Eso no me lo paga ningún sponsor. Eso vale más que cualquier métrica.
A vos, que armaste eso solo y a pulmón: gracias. Seguí.
https://t.co/D3SYGt4hOG
🚨 Anthropic acaba de bajar Fable 5 y Mythos 5. Para todos. En cuestión de horas.
Y no fue por un bug. Y ojo, tampoco "hackearon a Anthropic". Nadie entró a sus servidores.
Fue el gobierno de Estados Unidos.
El Departamento de Comercio emitió una directiva de control de exportación: ningún extranjero puede acceder a Fable 5 ni a Mythos 5. Dentro o fuera del país. Incluidos los propios empleados extranjeros de Anthropic.
¿El motivo? Un jailbreaker conocido demostró públicamente que podía saltearle los guardrails de seguridad al modelo. Ojo con la diferencia, porque importa: un jailbreak no es un hackeo. La infra de Anthropic quedó intacta. Lo que hicieron fue manipular al modelo desde afuera, con prompts, para que largara cosas que no debía. Eso alcanzó para que el gobierno hablara de seguridad nacional.
Y acá está lo loco: para cumplir la orden, Anthropic tuvo que apagar el modelo para TODOS. No podían filtrar solo extranjeros sin bloquear a media base de usuarios. Así que lo bajaron entero.
Anthropic ni siquiera está de acuerdo. Dicen que la capacidad que se demostró ya existe en otros modelos públicos y que recortar un producto usado por cientos de millones de personas por una vulnerabilidad puntual sienta un precedente peligroso para TODA la industria.
Ahora pensá en el que contrató el servicio esta semana solo para probar el modelo nuevo. Lo pagó. Lo estaba evaluando. Y de un día para el otro: cortado. Sin previo aviso.
Este es el tema que vengo machacando hace meses: la IA NO es magia que vive en una nube infinita y eterna. Es infraestructura. Está sujeta a regulación, a geopolítica, a control de exportaciones, a decisiones que vos no controlás.
¿Y sabés qué significa eso para vos como dev? Que no podés construir tu producto entero atado a un solo modelo, de un solo proveedor, en un solo país. La supervisión humana no es solo revisar lo que escribe la IA. Es entender de qué depende tu stack y qué pasa el día que te lo apagan.
Nosotros dirigimos. La IA ejecuta. Pero el que entiende la arquitectura completa es el único que sigue de pie cuando el suelo se mueve.
¿Vos tenías un plan B si mañana se cae tu proveedor de IA? Te leo. 👇
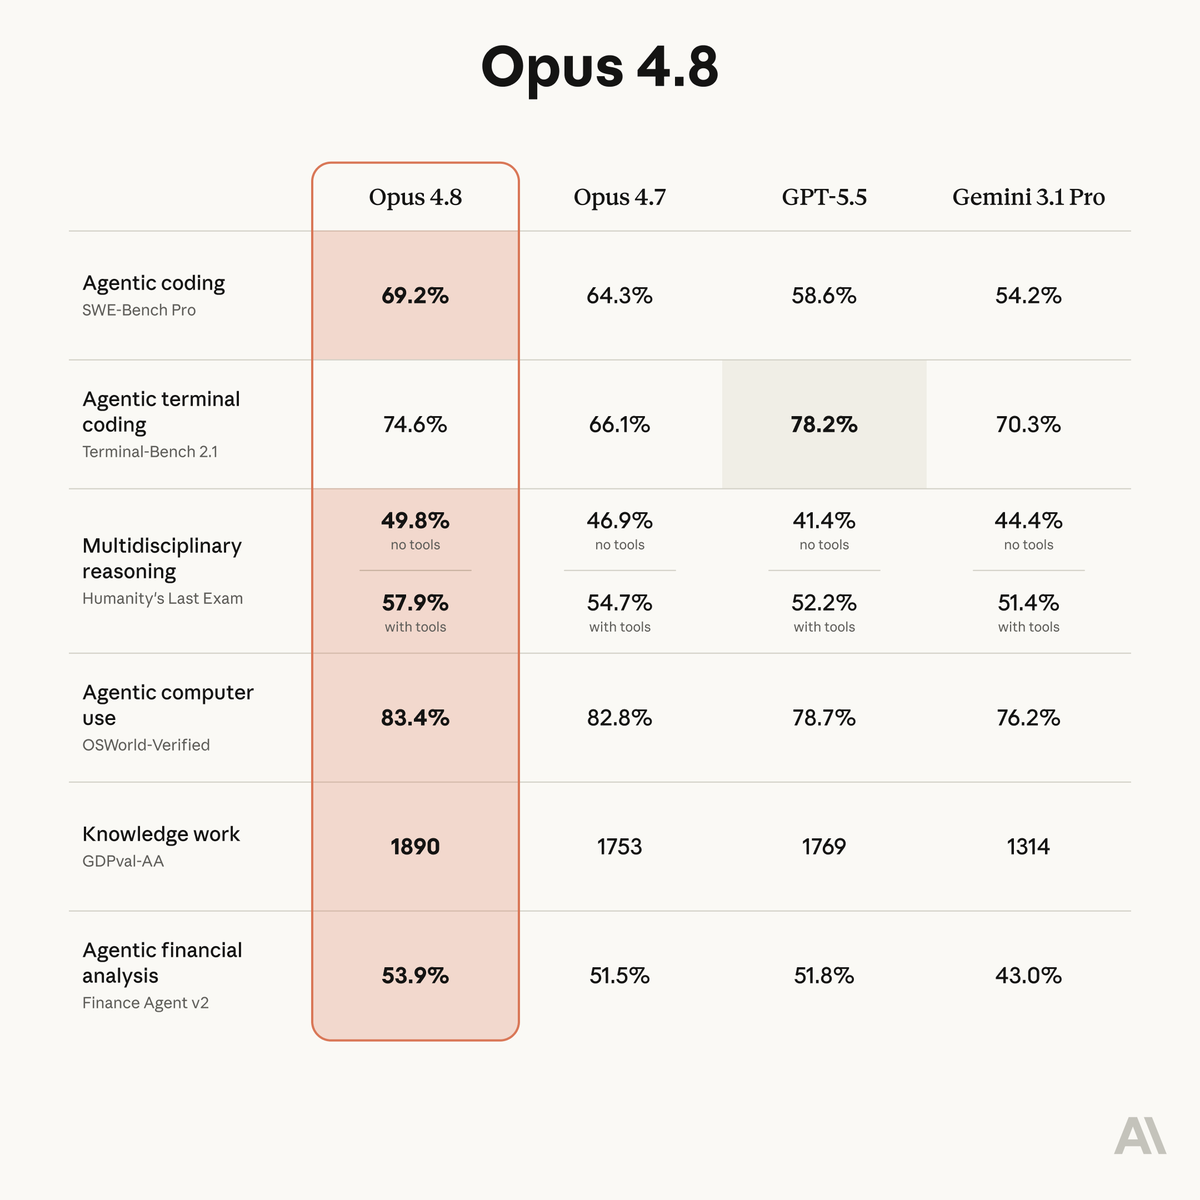
Introducing Claude Opus 4.8: it builds on Opus 4.7 with sharper judgment, more honesty about its own progress, and the ability to work independently for longer than its predecessors.
Available today at the same price.
Estaremos compartiendo con ustedes durante una semana parte de nuestra historia, lo difícil, los logros y las metas 🚀🤯 será una semana de mucho que platicar y además tenemos una sorpresa que el primer día soltaremos! #HICWeek2023
Esperamos puedas seguirnos 🔍👀