API gratuita para extraer toda la info de una IP.
Sin límites ni pagos de ningún tipo.
Funciona en Python, TypeScript y cualquier lenguaje.
→ https://t.co/0YZGs1dGL2
Este proyecto Open Source es BRUTAL: Meetily.
Transcribe y resume tus reuniones con IA.
¡Pero lo hace todo en local! Sin subir tu audio a ningún servidor, totalmente gratis, 100% privado, en segundos.
→ https://t.co/RjZ08yP5y1
Clona voces, dobla vídeos, transcribe y crea audiolibros.
Todo 100% en local. Sin registros ni suscripciones.
✓ +600 idiomas
✓ API compatible con OpenAI
✓ macOS, Linux y Windows
Se llama VoiceStudio y es Open Source:
→ https://t.co/jsLgF14ZRI
¡El compilador de React en Rust ya se puede usar fácilmente en Vite!
Con: react({ compiler: true })
✓ 10-17× más rápido que el de Babel
✓ En un repo de +1000 archivos: 14,3s → 0,81s
Olvídate de useMemo y useCallback:
https://t.co/Uas7in6qEB
¡Llega un nuevo diseño para Firefox!
Se llama Nova y llega el 29 de septiembre.
✓ Pestañas redondeadas y compact mode de vuelta
✓ Pestañas verticales y split view
✓ +Privacidad y controles de IA
¿Lo quieres ya?
about:config: browser.nova.enabled → true
Mis modelos de IA favoritos a día de hoy:
Código → Opus 5.5 + Grok 4.7
Escritura → GPT-6 Sol
Imagen → GPT Image 2.5
Música → Eleven Music 2.5
Vídeo → MiniMax H3
OCR → GLM-OCR
Voz → Cartesia Sonic 3.6
Transcripción → Whisper + Parakeet
Scraping → Firecrawl
IA Local → Qwen 3.8 27B
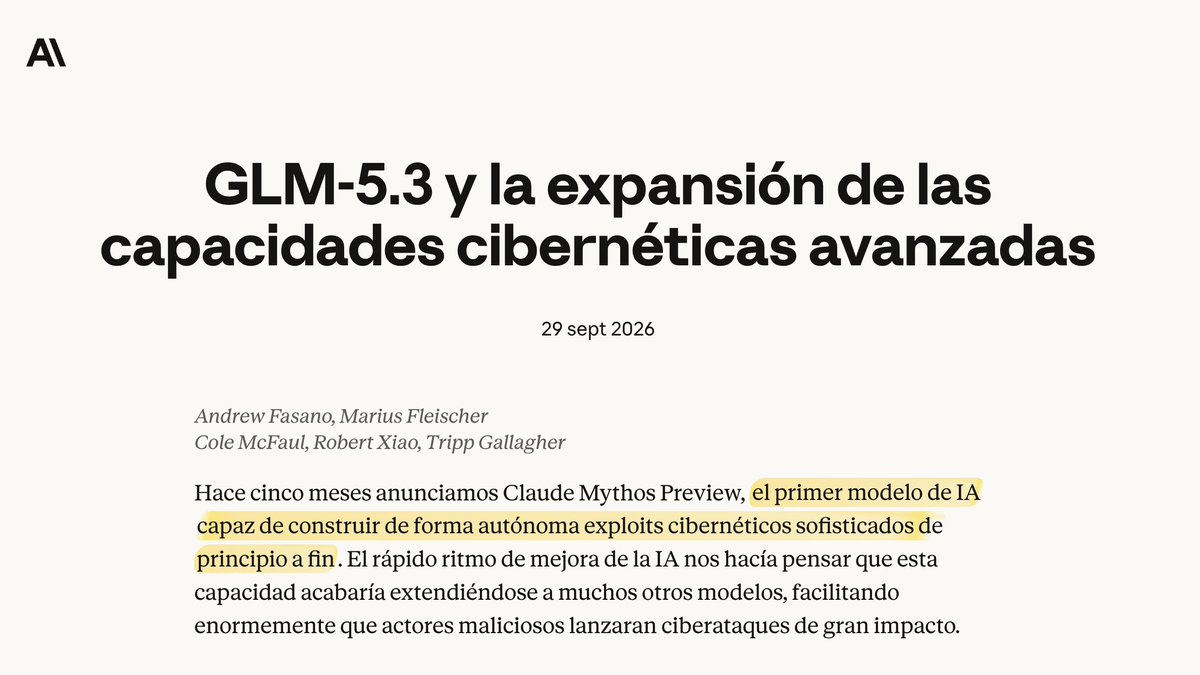
El modelo chino GLM-5.3 está al nivel de Mythos. Y no lo digo yo, lo dice la propia Anthropic.
¡Al menos respecto a ciberseguridad!
En un artículo de seguridad dicen que es un peligro por sus altas capacidades y porque es accesible por todos.
Menuda campaña de marketing gratuita les está haciendo jajaja
No sé si son conscientes pero creo que van a lograr todo lo contrario a lo que esperan.
Además de aumentar el hype para cuando salga GLM-5.4 o GLM-6, claro...
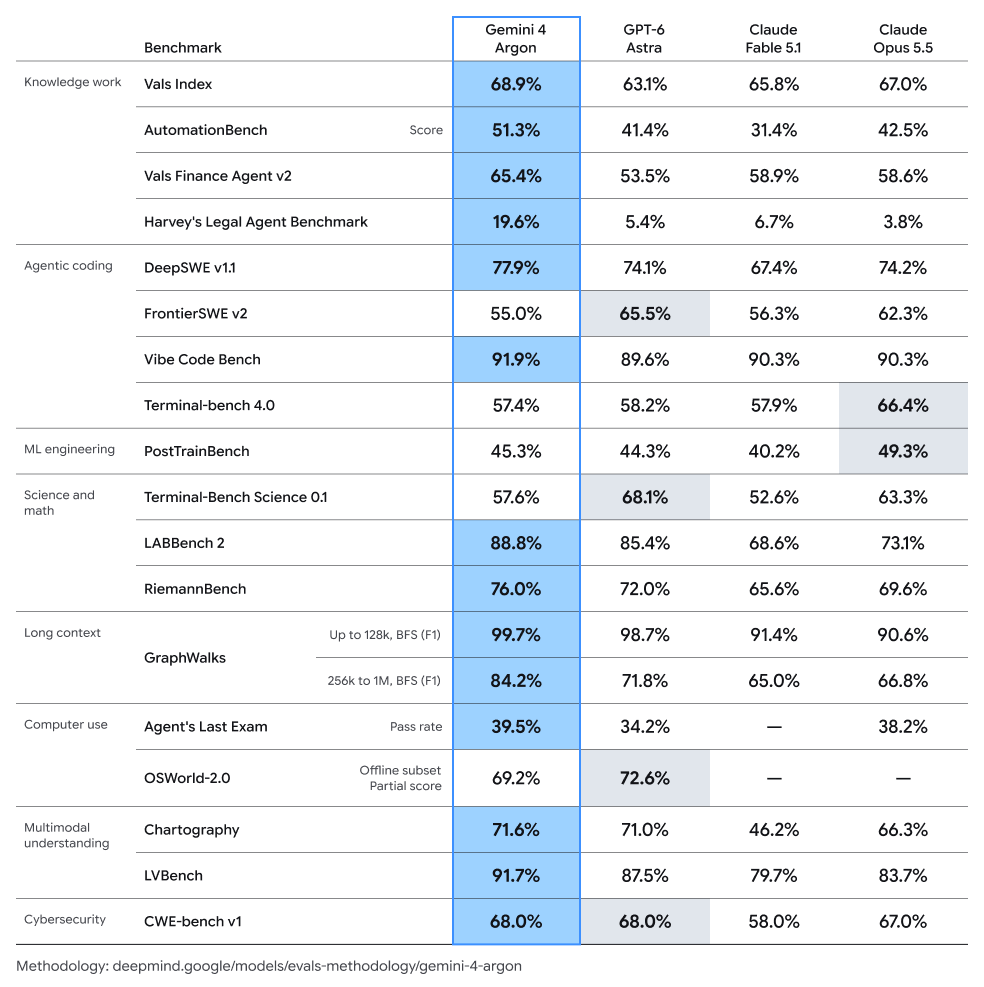
¡Google acaba de anunciar su modelo Gemini 4 Argon!
✓ Al nivel de GPT-6 Astra y Fable 5.1
✓ Sólo disponible bajo invitación
✓ Estrenando nuevo nombre
Vaya carrera la de OpenAI, Anthropic y Google.
¿Quién va ganando?
SpaceXAI engineer (ex-Cursor):
"right now I'm running 10-20 GrokBot agents that automate 90% of my routine
i have a Chief of Staff agent. He knows about all my other bots and manages everything"
in a 50-minutes podcast, a SpaceXAI engineer showed how to build a team of agents that will work for you 24/7
worth more than a $500 course on agentic engineering
watch today, then read how to build a Grok agents team from scratch in the article below
Al declarar `name = "goku"`, se quedó declarado con ese valor. Al usar `name.upper()`, dicho método haría que cambiara a "GOKU", pero jamás se guarda nuevamente con `name = name.upper()`, entonces por eso el valor... no cambia y esa función realmente nunca termina usándose.
Hace unos días puse este ejercicio... El 65% (más de 3.300 personas) respondió mal.
La IA no te está quitando el trabajo, se lo estás regalando.
Por favor, tómate en serio tu aprendizaje 🙏
El creador de Node.js acaba de lanzar Dactyl.
Apps nativas de iPhone y Android desde la web.
Sin Mac. Sin Xcode. Sin Android Studio.
✓ Simulador de SwiftUI en el navegador (WASM)
✓ El mismo código para iOS y Android
✓ Usas TU suscripción de ChatGPT
→ https://t.co/jpkYQzagOE
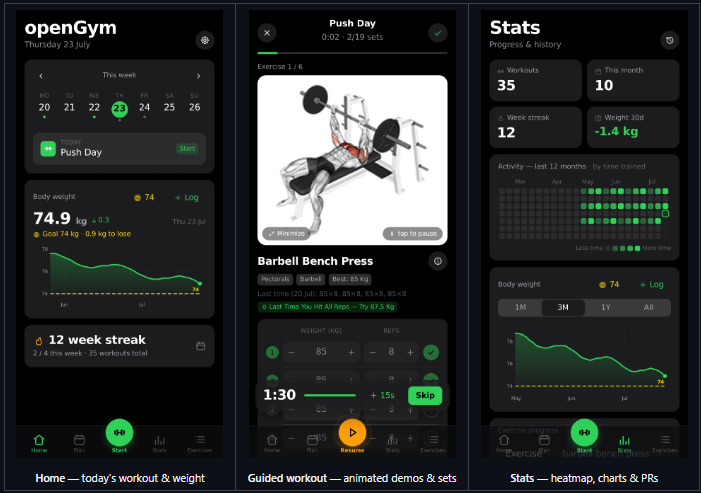
Le tumbaron el github a este dev porque nos dio ABSOLUTAMENTE GRATIS una app para entrenar que no te pide cuenta, suscripción ni guardar tus datos en la nube y que es MUCHÍSIMO MEJOR QUE CUALQUIER OTRA EN LA APP STORE
[openGym]
Un tracker de entrenamiento self-hosted en el que puedes:
• Planificar tu semana
• Seguir entrenamientos guiados
• Registrar cada serie, peso y repeticiones
• Ver PRs, estadísticas y evolución
• Registrar peso corporal
• Crear superseries
• Seguir progresiones automáticas
• Analizar qué músculos estás entrenando
• Usar passkeys / Face ID / Touch ID
• Funcionar offline
• Sin anuncios
• Sin tracking
• Sin suscripción
• Sin depender de los servidores de una empresa
Además, tiene 1.324 ejercicios, importa datos desde FitNotes, Strong y Hevy, y permite exportar todo en JSON.
REPOOO👇
SpaceXAI engineer (ex-Cursor):
"Grok Bot was vibe coded in days. humans weren't reading the code at all"
each agent gets a name and an identity, and you orchestrate them the way you'd run a team
their designers are shipping code through Grok Bot now. they send her a bug they already fixed, she reviews it and stamps
"Grok Bot is for people who are not in tech"
Watch today, then read how to build a Grok bot agents team from scratch in article below
Karpathy never meant for you to automate the LLM wiki. Most people set it up backwards.
Three things are in his file and almost nobody does them.
He ingests sources one at a time and stays in it. He reads the summaries, checks what changed, tells the agent what to emphasise. Everyone else drops a folder and hits compile once.
Answers are supposed to go back in. His words: "good answers can be filed back into the wiki as new pages." A comparison you asked for is worth as much as an article you clipped, and most people leave it to die in chat history.
There is a third operation nobody runs: lint. Ask the agent to health-check the wiki for contradictions, stale claims, orphan pages, missing links.
The wiki compounds through you, not around you. That is the whole design.
DevOps vs. MLOps vs. LLMOps, clearly explained:
Many teams are trying to apply DevOps practices to LLM apps.
But DevOps, MLOps, and LLMOps solve fundamentally different problems.
DevOps is software-centric. You write code, test it, and deploy it. The feedback loop is straightforward, i.e., does the code work or not?
MLOps is model-centric. Here, you're dealing with data drift, model decay, and continuous retraining. The code might be fine, but the model's performance can degrade over time because the world changes.
LLMOps is foundation-model-centric. Here, you're typically not training models from scratch. Instead, you're selecting foundation models and then optimizing through three common paths:
- Prompt engineering
- Context/RAG setup
- Fine-tuning
But here's what really separates LLMOps: The monitoring is completely different.
In MLOps, you track data drift, model decay, and accuracy.
In LLMOps, you're watching for:
- Hallucination detection
- Bias and toxicity
- Token usage and cost
- Human feedback loops
This is because you can't just check if the output is "correct." You need to ensure it's safe, grounded, and cost-effective.
The evaluation loop in LLMOps also feeds back into all three optimization paths simultaneously. Failed evals might mean you need better prompts, richer context, OR fine-tuning.
So it's not a linear pipeline anymore.
One more thing: prompt versioning and RAG pipelines are now first-class citizens in LLMOps, just like data versioning became essential in MLOps.
And the ops layer you choose should match the system you're building.
If you want to go deeper into LLMOps, I wrote a full LLM engineering roadmap a while back.
It walks through the eight pillars of building LLM systems, starting at prompt engineering and ending at observability and safety, with free and open-source resources attached to each one.
You can read it below.
Elon Musk:
"in 6-12 months GrokBot will be #1 tool for building agentic systems. In a year 100% of code will be done by LLM's
at SpaceXAI, more than 70% of engineers already using GrokBot to build self-learning agentic systems"
In a 40-minute talk, Elon with SpaceXAI engineers discuss how the future of AI engineering will look like
worth more than 2 hours of Stanford lecture on AI engineering
watch today, then read the article below on building a self-learning agentic system with GrokBot
J’ai été voir le site de Cyberleek, le hacker de GTA 6, et ce n’est clairement pas un amateur.
Je suis convaincu que ce n’est pas une seule personne, mais bien un groupe de hackers.
Son système de contact fonctionne en deux étapes :
- Il génère d’abord un compte Session (messagerie sécurisée, anonyme et décentralisée) avec une phrase de récupération unique. Ça permet à la personne qui veut le contacter d’avoir un canal de communication jetable et chiffré de bout en bout.
- Ensuite, il génère un montant de donation en Monero (XMR), une cryptomonnaie anonyme. Contrairement à Bitcoin, Ethereum ou Solana, sa blockchain est privée et les montants des transactions sont complètement obfuscés. Personne ne peut donc voir combien tu as envoyé, sauf celui qui possède la clé privée (Cyberleek).
Il demande 400 XMR (165 k$), mais ce qui est vraiment intéressant, ce sont les chiffres APRÈS la virgule.
Il y a 12 décimales qui sont générées en même temps que le compte Session et servent d’identifiant unique. Quand tu envoies exactement ce montant, Cyberleek détecte la transaction sur la blockchain, extrait les décimales, recalcule l’ID Session correspondant et te contacte.
D’après le site, c’est purement mathématique/cryptographique côté client. La page génère un ID de 12 chiffres lié mathématiquement au compte Session. Comme Monero cache les montants, seul Cyberleek peut déchiffrer le montant reçu et retrouver ton Session ID. Aucun stockage serveur de l’ID n’est nécessaire avant le paiement.
Il précise d’ailleurs qu’il faut absolument envoyer les fonds depuis un wallet personnel (Cake Wallet, Feather...) et non depuis un exchange, sinon les décimales risquent d’être arrondies et il ne pourra jamais te retrouver.
Je trouve que c’est un système plutôt élégant, et on retrouve d’ailleurs le même niveau de sophistication au niveau de l’infrastructure.
Leur site ne peut quasiment pas être mis hors ligne durablement, car il est hébergé de façon décentralisée sur Arweave (stockage permanent et immuable sur blockchain) et que son contenu est accessible via de nombreux gateways du réseau ar(dot)io.
Ces gateways sont des portes d’accès qui servent le même fichier HTML stocké sur Arweave. Faire tomber un gateway (ou même plusieurs) ne change presque rien puisque le site restera accessible sur tous les autres, et que de nouveaux miroirs pourront apparaître en quelques minutes.
Tous ces éléments font que je suis convaincu que Cyberleek est un groupe et non une seule personne, et vu le mode opératoire, que ce sont des pros. Leurs connaissances en cryptographie et en utilisation de technologies décentralisées laissent penser qu’on est loin de simples script kiddies ou de hackers qui piratent uniquement via social engineering. Il y a là-dessous une vraie maîtrise technique.
Le côté un peu enfantin / trolling laisse penser le contraire, mais le côté technique ne fait aucun doute.
Même chose dans la manière dont ils gèrent leur communication : tout passe par leur site internet. Ils évitent volontairement tout réseau social qui pourrait laisser des logs et compromettre leur identité.
@scaling01 Agree. People are sleeping on using Opus to hill climb. We use it for optimizing CPU and memory, optimizing CI times, improving frame rates, reducing latency, any other kind of problem in the shape of “iterate on X with a profiler and dataset until it hits Y”