@janhebein Shapelearn Qwen quants look promising. The 3.84 quant is likely the right fit.
https://t.co/96DB27T7hw
Ninfer 4090 for kernel/runtime.
Then OMP or Deepseek harness for using the model.
@sinasensei@ByteShape We only do base model releases based on the model's provider because it takes us a long time to benchmark the different quants, and we want to be precise with our benchmarking. But we appreciate you taking the time to look at our quants! And thanks for the recommendation!
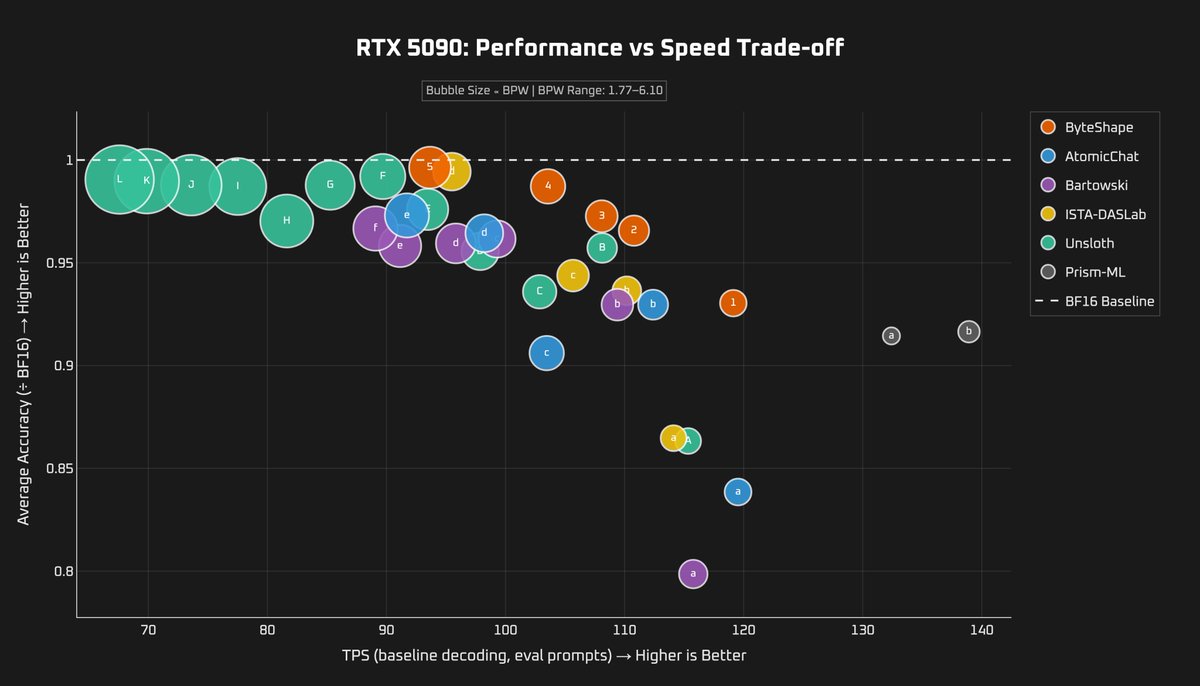
1/3 We updated our Qwen3.8 benchmarks to include Prism-LM’s new Bonsai 2 QAT models.
These are our results, not the benchmark numbers reported by Prism. We ran Bonsai 2 using Prism’s runtime, while keeping the rest of the setup consistent with our other Qwen3.8 evaluations.
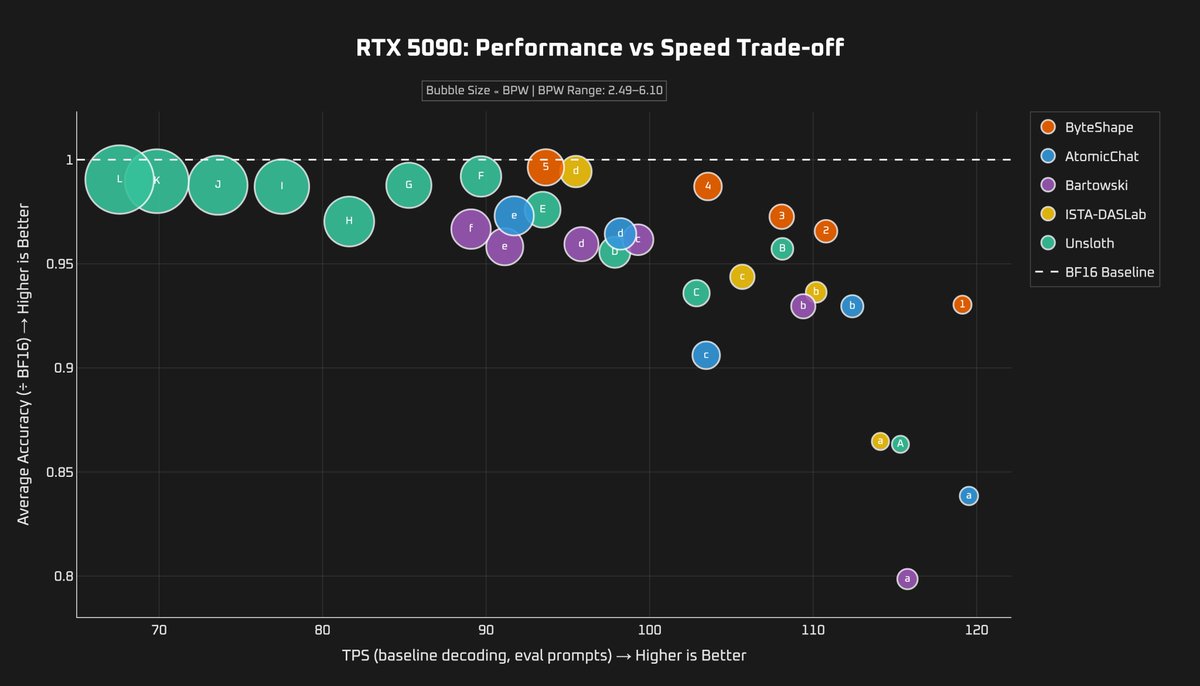
ByteShape Qwen 3.8 27B challenges the consensus that aggressive quantization ruins quality. At 3.84 bpw, it reportedly retains 99.63% of BF16 accuracy, worth testing on a consumer GPU.
@Capetlevrai@BoubouSGC@ByteShape We don’t currently have a preference. We are observing what’s out there and if the community agrees on a harness, we’ll try to include a tutorial with our model selection.
We released ShapeLearn-Lite days after Qwen 3.8 27B, and it already delivered some of the best quality/speed trade-offs we tested.
Now full ShapeLearn is even better: 99.63% of BF16’s aggregate benchmark score at just 3.84 bpw.
Models & results: https://t.co/qVCl3iPD3J
@FaztTech Para máxima velocidad con una perdida de precisión de 0.7% (si, menos de un 1%) yo eligo este: https://t.co/GvKO8SzND0
Pero si quieres probar los más mainstream estos son los más populares:
https://t.co/boJ215MlrQ
Y puedes probar los con BF16, pero presumo irán muy lento.
@FaztTech Para máxima velocidad con una perdida de precisión de 0.7% (si, menos de un 1%) yo eligo este: https://t.co/GvKO8SzND0
Pero si quieres probar los más mainstream estos son los más populares:
https://t.co/boJ215MlrQ
Y puedes probar los con BF16, pero presumo irán muy lento.
@NeutralLayer Por eso hay que tener paciencia y vigilar de cerca lo que se está haciendo, siempre desde una perspectiva crítica, pero desde el punto de vista objetivo donde ahora mismo la hegemonía la tiene USA y un poco más lejos China. Europa ha quedado relegada a usuario.
Utilizar un ranking generado por IA para criticar un proyecto público interesante me parece un poco decadente. Luego que si nos quedamos atrás tecnológicamente. Por algún lado habrá que empezar, ¿no?
@NeutralLayer Lo que importan son los datos de entrenamiento sobre todo. Es bien conocido que todas las empresas de IA utilizan datos que no pertenecen a ellas. Si un proyecto público hiciera lo mismo, sería un absoluto desastre. Lo mínimo que podemos esperar es que esté un poco atrasado.
@javilop Me parece perfecto. Al final sin la participación privada, lo público se estanca a día de hoy. ¿Pero esos proyectos privados son completamente independientes de fuentes de financiación externa/no nacional? ¿Dónde ponemos el límite de lo sovereign y de lo que no lo es?
@javilop Y te lo digo como experiencia propia que llevamos trabajando con estos modelos 7 años. Desde el ámbito de la investigación, más nos vale espabilar en Europa
@javilop Pero es que eso es muy relativo. ¿A qué consideras superior? En specs? Por supuesto. En sovereignty? Para nada. O empezamos a espabilar en Europa o nos quedaremos infinitamente más atrás de lo que estamos. Incluso modelos que vienen de empresas conocidas nacen muertos.