los agentes de OpenAI ya resuelven SOLOS casi la mitad de las tareas de investigación de 2 a 4 horas.
lo dice un reporte nuevo de OpenAI sobre cómo la IA está acelerando su propia investigación. en marzo esa tasa era de 23% y en octubre llegó a 46%. en tareas de 4 a 8 horas pasó de 13% a 35%.
igual depende mucho del tipo de laburo. vigilando entrenamientos lo logran el 79% de las veces, pero escribiendo código para la infraestructura que sirve los modelos apenas el 25%.
y el uso no para de crecer. a precio de API, un investigador típico de OpenAI ya usa unos USD 2.400 por día en agentes, contra USD 1.500 en septiembre. el 10% que más los usa pasa los USD 23.000 diarios.
en una encuesta les preguntaron qué entregarían para no perder los agentes durante 3 meses. la respuesta mediana fue el 30% del poder de cómputo de su equipo o, en otra pregunta, el 40% de la gente.
y aun así todo ese uso interno es apenas el 2% del cómputo que OpenAI dedica a investigación.
por eso piden que todos los labs estén obligados a medir y publicar cuánto se acelera la IA a sí misma.
We're sharing new data on how AI is changing research at OpenAI.
We find researchers' AI use continues to rise exponentially, and agents are completing longer tasks, but human involvement remains central in research. Researchers are also spending more time on safety and alignment, with human effort in these areas growing faster than in any other individual research area.
This report aims to increase transparency around research acceleration and inform the governance of increasingly capable AI. We believe that AI labs should be required to track and publicly report indicators of recursive self-improvement (RSI): the process by which AI accelerates the development of future AI systems.
Our hope is that this expanded report will help sustain and advance shared measurement norms across the industry.
https://t.co/xyGPcCkPCK
Anthropic va a salir a la bolsa POR ENCIMA del precio que había anunciado.
fijó su IPO en USD 83 por acción y mañana empieza a cotizar en Nasdaq con el símbolo "ANT".
hace 8 días, cuando arrancó el roadshow, el rango era de USD 70 a 78. y no solo subió el precio, también la cantidad, que pasó de 825 millones a 980 millones de acciones.
con eso la venta queda en unos USD 81.340 millones, cuando el techo previsto era de USD 64.350 millones. casi todo va para Anthropic, porque los accionistas que ya estaban venden apenas 23,6 millones de esas acciones.
y si los bancos que organizan la salida usan su opción de comprar 147 millones de acciones más, el total pasa los USD 93.000 millones.
We’ve priced our IPO at $83 per share, with trading expected to begin on Nasdaq tomorrow.
https://t.co/NJxt2pILrh
Legal disclaimer: A registration statement relating to the Class A common stock was declared effective by the Securities and Exchange Commission on November 18, 2026. The offering is being made only by means of a prospectus. Copies of the final prospectus may be obtained, when available, from: Goldman Sachs & Co. LLC, Attention: Prospectus Department, 200 West Street, New York, NY 10282, by telephone at (866) 471-2526, or by email at [email protected]; or Morgan Stanley & Co. LLC, Attention: Prospectus Department, 180 Varick Street, 2nd Floor, New York, NY 10014, or by email at [email protected]
OpenAI ahora te cobra hasta 40% MENOS si podés esperar la respuesta.
es una opción nueva del modo background de la Responses API. le decís cuánto tiempo podés esperar la primera respuesta y te descuentan los tokens.
lo que no dice el anuncio es que hay dos ventanas. con 2 horas pagás 30% menos y con 8 horas, 40% menos. en GPT-6.2 Sol el millón de tokens de entrada baja de USD 2 a USD 1,20 y el de salida de USD 10 a USD 6. en Astra pasa de USD 8 y USD 40 a USD 4,80 y USD 24.
sirve para lo que no tiene a nadie esperando, como revisar los tickets de soporte de la mañana o procesar documentos de noche. y a diferencia de la Batch API, funciona en flujos de varios turnos, así que tu agente puede llamar una tool y seguir con el mismo descuento.
para probarlo, mandá background en true, background_options.completion_window en "8h" y service_tier en "default", sin streaming. también anda con GPT-6.1 Terra y GPT-6 Luna.
eso sí, si tus pedidos son independientes y podés esperar hasta 24 horas, la Batch API sigue siendo más barata (50% menos).
Not every workflow requires an immediate response.
For single- or multi-turn workflows that can wait, save up to 40% per token than Standard on GPT-6.2 Astra or GPT-6.2 Sol.
In Responses API background mode, choose a 2h or 8h target for the first response. These discounted windows are now in public beta.
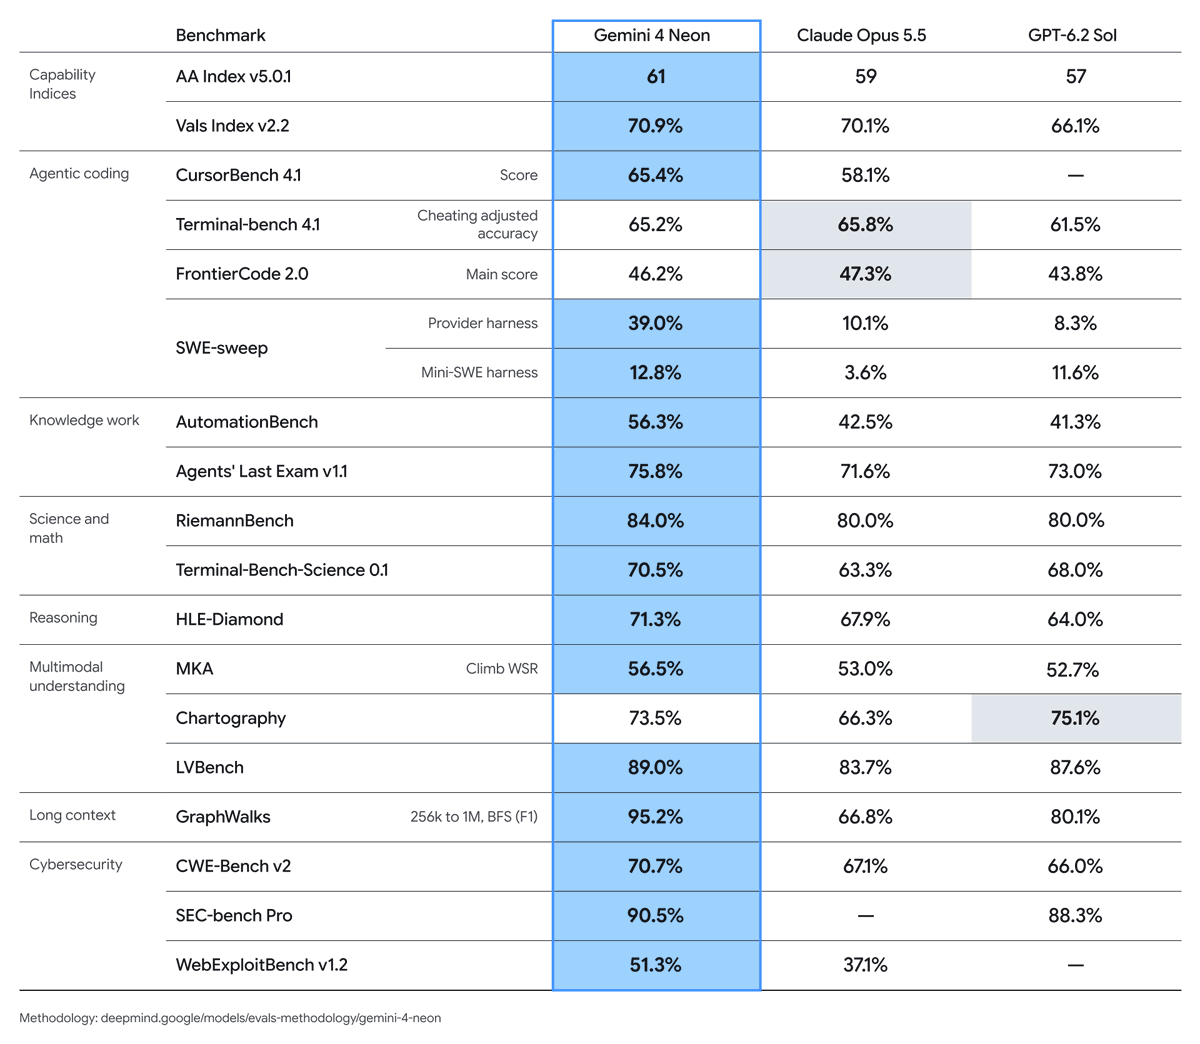
Google sacó Gemini 4 Neon y en CursorBench le GANA a Opus 5.5 y a Fable 5.2.
es el nuevo modelo de la familia Gemini 4 y queda en el medio, entre Carbon (el más potente) y Hydrogen (el rápido para el día a día). está pensado para programar, analizar datos y ciencia, rápido y sin gastar de más.
lo que no dice el anuncio es cómo le fue en CursorBench, el benchmark de Cursor armado con tareas de sesiones reales. en su nivel de razonamiento más alto quedó primero con 65,4%, contra 61,3% de Fable 5.2 Max y 58,1% de Opus 5.5 Max.
y lo más loco es el costo. Neon sacó ese 65,4% gastando USD 10,67 por tarea, y Fable 5.2 Max gastó USD 48,11 para sacar menos.
en la API cuesta USD 3 por millón de tokens de entrada y USD 15 de salida. desde el 1 de diciembre Carbon pasa a USD 4 y USD 20, así que Neon queda 25% más barato.
si lo querés probar, ya está en AI Studio como gemini-4-neon. no tiene capa gratis, así que necesitás la API paga. si tenés Pro o Ultra, también lo elegís en la app de Gemini y en Antigravity (el entorno de programación con agentes de Google).
Gemini 4 Neon is rolling out now.
Sitting between Carbon and Hydrogen, it brings frontier intelligence and fast task completion for complex software engineering, knowledge work, and science.
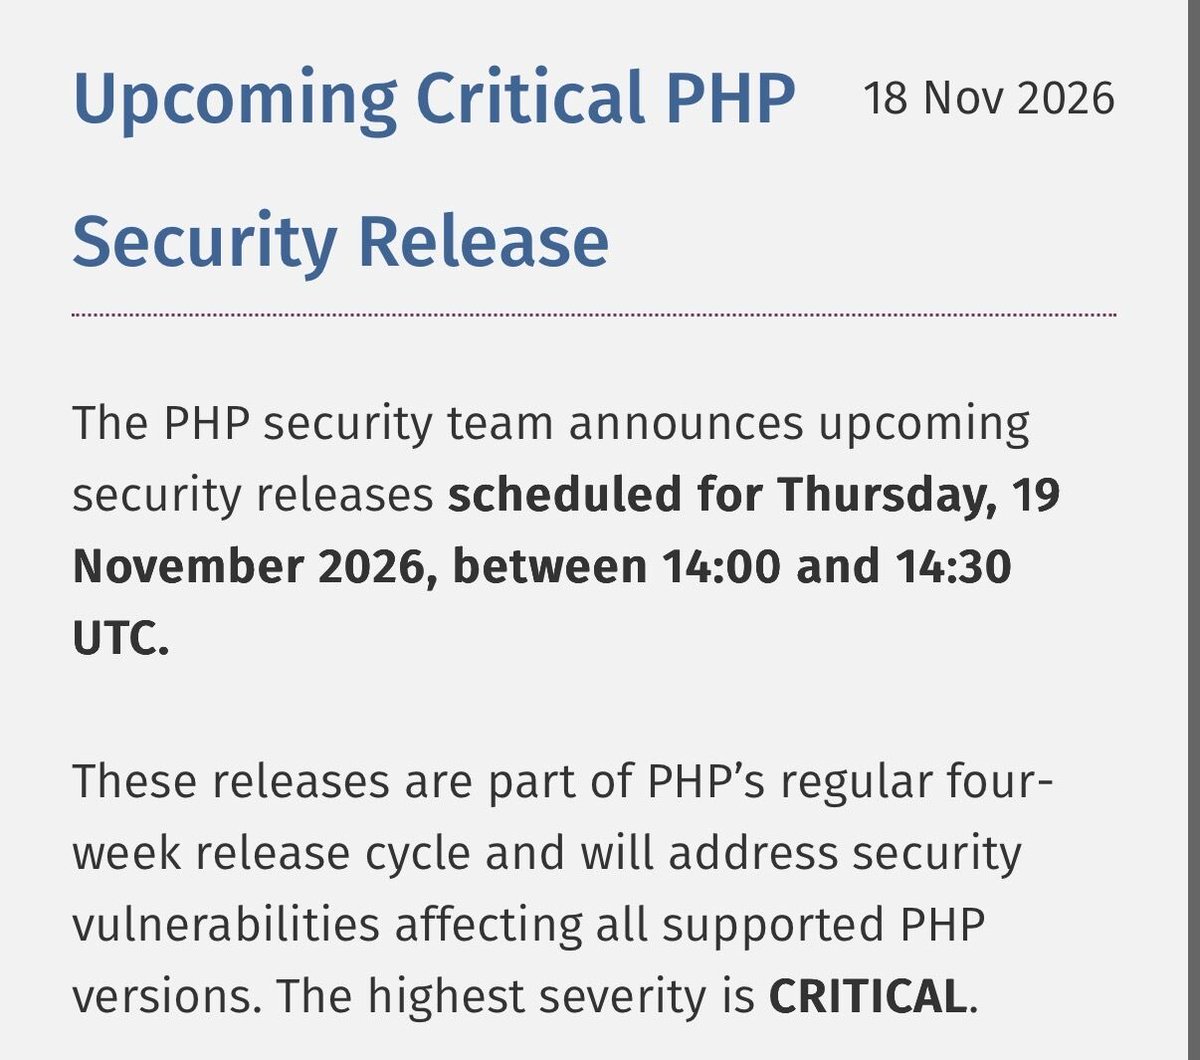
mañana sale un parche CRÍTICO de PHP para todas las versiones con soporte.
lo anunció el equipo de seguridad de PHP. las versiones nuevas salen el jueves 19 entre las 11:00 y las 11:30 de Argentina, y los detalles y los números de versión recién se publican ahí.
eso sí, aclaran que los fallos críticos solo pegan con configuraciones que no vienen por defecto o setups poco comunes. igual conviene tener todo listo para actualizar apenas salga.
hoy tienen soporte PHP 8.2, 8.3, 8.4 y 8.5, y 8.2 deja de recibir parches el 31 de diciembre. si estás en 8.1 o más viejo, no te va a llegar nada.
para saber qué versión tenés, corré php -v en el servidor. si usás Docker, hacelo adentro del contenedor.
Genie 4 ya se puede probar, y te deja cambiar el mundo MIENTRAS lo recorrés.
Google lo abrió hoy en Project Genie para los suscriptores de Google AI Ultra, después de unas semanas solo con testers elegidos.
escribís un prompt en medio de la sesión y el mundo cambia en el momento. que llueva, que aparezca un personaje o que la acción vaya para otro lado. y por primera vez trae sonido nativo en tiempo real, desde el ambiente hasta los diálogos.
Genie 3 sigue en el selector de modelos y también mejoró. antes cada mundo duraba 60 segundos y ahora llega a 3 minutos, y podés encadenar varios para armar un viaje más largo.
además sumaron un agente que te arma el mundo charlando con él, con música propia, y una galería para explorar y remixar mundos de otros.
eso sí, no es barato. Ultra arranca en USD 99,99 por mes y está en más de 140 países. si tenés Google AI Pro, te podés anotar en la lista de espera.
se prueba en https://t.co/weDWa1ZMww
Genie 4 is available! Looks like it is turtles all the way down then… Eligible Ultra subs can try it in Project Genie - excited to see what you’ll build with it. More info in the blog: https://t.co/ZWAi93TesH
dos fallas CRÍTICAS en NGINX permiten tomar el control de tu servidor sin contraseña.
NGINX es el servidor web open source más usado del mundo, está delante de más de 225 millones de sitios. las fallas están en cómo maneja HTTP/2, y una venía escondida en el código desde 2015.
y tu app puede estar perfecta que igual quedás expuesto. en Wiz (la empresa de ciberseguridad de Google Cloud) lograron ejecutar código en un NGINX que solo servía archivos estáticos.
lo más interesante es que las encontraron con IA, y después validaron el impacto con Gemini 4 Carbon y ChatGPT 5.6 Sol. otros cuatro equipos llegaron a las mismas fallas por su cuenta.
Pieter Levels (indie hacker, creador de Nomad List y Photo AI) cuenta que sus servidores ya se habían actualizado solos porque tiene las actualizaciones automáticas prendidas.
si no es tu caso, pasá a NGINX 1.30.7 (estable) o 1.31.9 (mainline). si lo corrés en Docker, actualizar el host no alcanza, tenés que reconstruir la imagen. chequeá la versión con
nginx -v
si hoy no podés actualizar, poné http2 off; en cada bloque server y sacá http2 de las líneas listen.
Scary NGINX vulnerability, but I checked and my VPS servers already had auto upgraded to the new one!
Very very very very very important to enable auto upgrades now, I even have auto reboot, which is a bit risky if you're not present, but I care more about my sites being up to date and safe than offline for a few hours
And generally security updates/upgrades are tested and safe
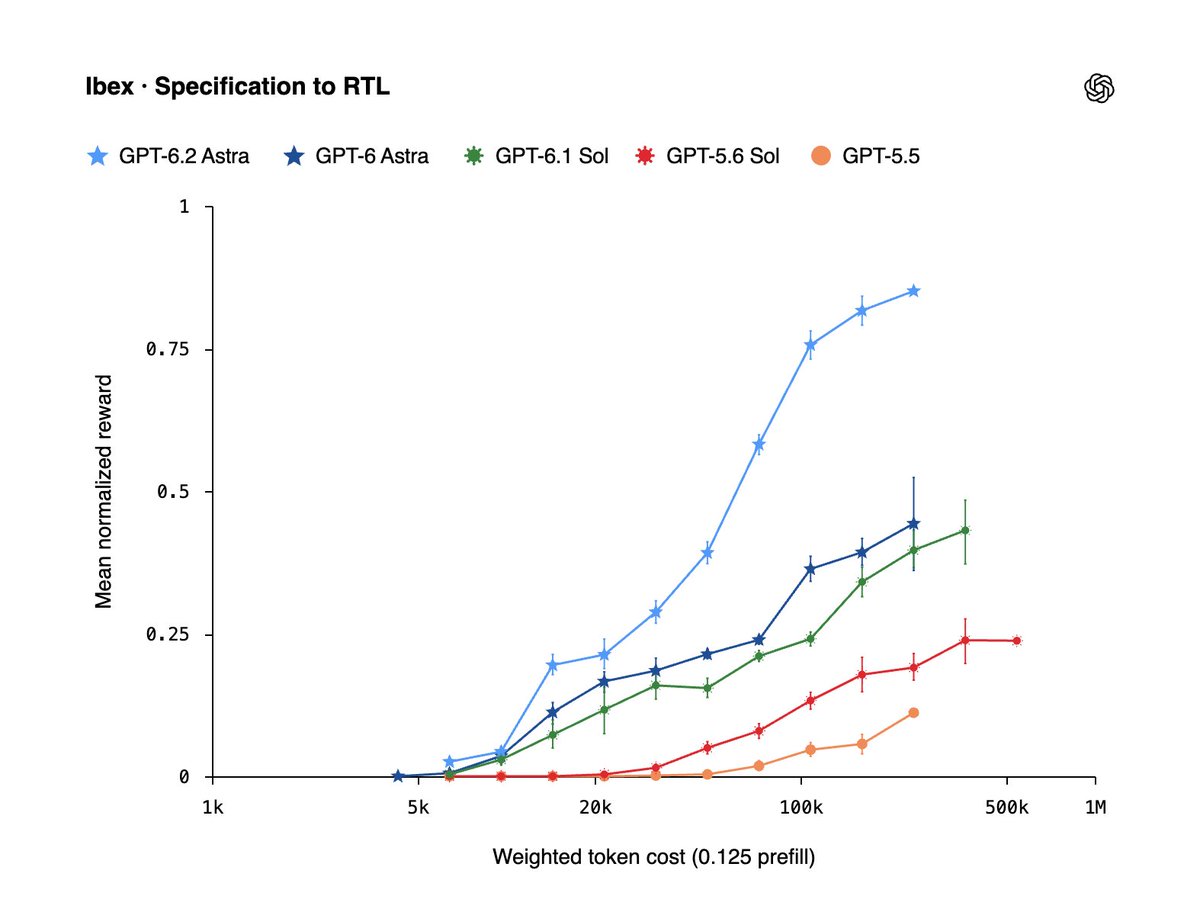
la IA de OpenAI le encontró MEJORAS a chips que AMD llevaba años optimizando.
trabajando juntos, los modelos de OpenAI lograron hasta un 14% de mejora en PPA (consumo, rendimiento y área del chip) en la GPU insignia de AMD, en menos de 5 meses.
lo que no dice el post, y está en el blog, es que según OpenAI eso equivale a más o menos un año de avance. y AMD ya metió algunos de esos cambios en un diseño que mandó a fabricar.
el modelo reescribe el código que describe los circuitos del chip (RTL en SystemVerilog) y usa herramientas de Synopsys para verificar que cada cambio siga haciendo exactamente lo mismo.
en Jalapeño, el primer chip propio de OpenAI para inferencia, un multiplicador rediseñado por el modelo ocupa ~15% menos área y tarda 1 ciclo de reloj en vez de 2. esas mejoras ya se probaron en el chip real.
AMD también verificó mejoras de un dígito porcentual en bloques clave de su próxima CPU insignia, con diseños escritos por el modelo.
y ahora están entrenando GPT-Synopsys, un modelo nuevo para usar esas herramientas de diseño como lo haría un ingeniero de chips.
el detalle completo está en https://t.co/Gl6ywF8mRk
Working with @AMD, our models identified up to 14% PPA improvement on flagship GPU IP in less than five months—building on designs AMD’s engineers had already spent years optimizing.
The same approach helped improve Jalapeño, our first custom inference chip, with gains verified on real silicon.
New evaluations also show our models getting better at certain chip design tasks.
We’re sharing these results and how we’re working with @Synopsys to bring our model capabilities and their trusted EDA design and validation tools to more chip designers.
https://t.co/4BNcPIqfIQ
tu agente ahora puede leer páginas web ENTERAS por USD 0,001 cada una.
Perplexity lanzó Context API. le pasás una lista de URLs y te devuelve cada página limpia en markdown, más el HTML y los links si los pedís.
según Perplexity, saca contenido útil del 92,3% de las URLs.
lo que no dice el post, y está en la documentación, es que las URLs que fallan no se cobran. si la página está bloqueada, vacía o tarda demasiado, no pagás nada.
por defecto te puede devolver una copia guardada de hasta 48 horas. si necesitás la versión de este momento, mandás max_age_seconds en 0 y la busca en vivo.
y si no querés llenarle el contexto al modelo con la página entera, le pasás una pregunta en highlights y te devuelve solo los fragmentos que la responden.
sirve si armás agentes que tienen que leer docs, changelogs o artículos y no te querés pelear con scrapers.
se usa con un POST a https://t.co/nwZzzmXPH3 y la misma API key de Perplexity.
Perplexity Context API is live.
Context API reads up to 10 URLs per call and returns clean .md, HTML, links, and snippets per page.
It returns usable content for 92.3% of URLs, 87.9% fact recall, and 80.3% content precision at $1/1000 URLs fetched.
https://t.co/9hoEcePh1B
Mistral ahora te deja poner VARIOS AGENTES a programar en paralelo desde tu compu.
lanzaron Vibe Desktop, la app de escritorio de su agente de programación, para macOS y Windows. Linux todavía no, dicen que llega pronto.
le das varias tareas a la vez y cada una trabaja en su propio Git worktree, una copia aparte del repo, así un agente no le pisa los cambios al otro. después revisás los diffs y el estado de cada PR en la misma ventana.
cada sesión puede correr en el repo de tu máquina, con tu terminal y tus servicios, o en un sandbox en la nube. no hace falta instalar el CLI aparte, usa el mismo motor del agente por debajo.
si pagás, el modelo por defecto es Mistral Large 4.
eso sí, Mistral no menciona computer use. la app de escritorio de Claude ya abre apps y maneja el navegador desde hace meses.
se descarga desde https://t.co/KlVOegtFBe
Mistral Vibe is now available on Desktop!
Run agents locally or remotely, and start shipping straight from your MacOS or Windows device.
You can try the Pro plan for free if you’re building in Europe. Coupon code: LECHONK
(yes, we added more after we ran out yesterday).
Use the link in 🧵:
si un agente te hizo un git reset --hard y "perdiste" commits, casi SIEMPRE los podés recuperar.
git anota cada lugar por el que pasa tu repo. cada commit, cada reset, cada cambio de rama. ese historial se llama reflog y vive solo en tu máquina, así que no rescata lo que estaba en la compu de otro.
corrés git reflog y te aparece una lista con HEAD@{0}, HEAD@{1}, HEAD@{2} y qué pasó en cada paso. HEAD@{1} quiere decir "donde estabas una movida antes".
con eso se arreglan los sustos más comunes. si hiciste un reset de más, buscás en la lista el paso de antes del reset y volvés ahí. si borraste una rama con git branch -D, git te muestra el hash justo al borrarla y con git branch nombre-de-la-rama ese-hash la recreás. y si habías hecho git add pero no commit, git fsck --lost-found te deja el contenido de esos archivos en .git/lost-found/other.
lo que nunca pasó por git add no se salva. y no lo dejes para después, porque por defecto git borra del reflog a los 30 días los commits que ya no están en ninguna rama.
guardate esto para la próxima (cambiá el 1 por el número que veas en tu reflog)
git reflog
git branch rescate HEAD@{1}
git reset --hard HEAD@{1}
git fsck --lost-found
el primero te dice dónde estuviste, el segundo rescata ese punto en una rama nueva sin tocar nada, el tercero vuelve ahí directamente (y pisa lo que no commiteaste) y el cuarto busca lo que agregaste y nunca commiteaste.
una falla en Java permite HACKEAR Jenkins, Jira y Confluence sin contraseña.
se llama Java4Shell y está en el decodificador de Base64 de OpenJDK, que es la base de Temurin, Corretto, Zulu y el Java de Oracle, entre otros. con un texto en Base64 mal armado, un atacante puede pisar memoria que no le corresponde y llegar a ejecutar código en tu servidor.
la encontró Quang Luong (investigador de Calif, la empresa de ciberseguridad que antes encontró la falla de PHP) con Codex, dentro de Patch the Planet, la iniciativa de OpenAI con GPT-6 Cyber para asegurar software open source. tardó una hora en encontrarla y dos más en tener el primer exploit, con menos de USD 200 en tokens.
eso sí, solo afecta a Java 17.0.6 en adelante en procesadores x86-64 con AVX-512 VBMI, como los Intel Xeon desde Ice Lake y los AMD desde Zen 4. los procesadores ARM no están afectados.
el parche salió ayer. pasá a la 17.0.21.1, 21.0.13.1, 25.0.5.1 o 27.0.1.1 según tu versión y reiniciá los procesos de Java.
si hoy no podés actualizar, en tus servidores x86-64 arrancá la JVM con este flag
-XX:-UseBASE64Intrinsics
GPT-6 Cyber for helping further secure the internet, with a major security flaw in Java found by Calif, as part of our Patch the Planet initiative: https://t.co/DtMftfZTp7
Hugging Face consiguió que un modelo abierto de 27B DUPLIQUE su puntaje en SWE-bench Pro.
entrenaron con reinforcement learning un adaptador LoRA (una capa chiquita que se monta arriba del modelo) para Qwen3.8-27B, pensado para usarlo dentro de pi, un agente de programación que corre en la terminal.
en SWE-bench Pro pasó de 29,4% a 62,7%, y en Terminal-Bench 2.1 de 39,5% a 55,8%. encima usa entre 55% y 62% menos tool calls por tarea.
en la página del modelo muestran un caso real. en un bug de Ansible, el modelo base buscaba y volvía a correr código hasta chocar con el límite de 100 pasos. con el adaptador encontró la función, la editó, corrió los tests y lo resolvió en 8 tool calls.
ojo que ese SWE-bench Pro son las 51 tareas más difíciles, no el benchmark entero.
y lo podés correr local. hay versión GGUF para llama.cpp, y en https://t.co/iADwOLb0Pi para Mac el modelo base en Q4 se baja unos 17 GB. si lo usás con pi, en ~/.pi/agent/models.json poné el api en openai-completions, porque si no pi usa la Responses API y el adaptador no se entrenó con esa.
Introducing Qwen3.8-27B-pi-adapted 🤗
We adapted Qwen's model specifically for the pi coding agent using reinforcement learning and a LoRA adapter.
The results, measured as pass@1:
🚀 SWE-bench Pro (Hard 51): 29.4% → 62.7%
💻 Terminal-Bench 2.1: 39.5% → 55.8%
⚡ 55–62% fewer tool calls per task
This is the power of open models: you can adapt them to YOUR tools and YOUR use cases. Let’s build! 💛
Open weights: https://t.co/aH4cl2qnED
Methodology: https://t.co/avSfF93K4V
GitHub Copilot ahora puede manejar tu NAVEGADOR, el mismo donde ya tenés tus cuentas abiertas.
lo anunciaron en Microsoft Ignite. instalás la extensión de Copilot para Chrome, que anda en Chrome y en Edge, y le podés pedir que complete formularios, saque información de una página o pruebe la web app que estás armando y te ayude a debuggearla.
y no queda solo en la app de Copilot. también funciona en Copilot CLI, VS Code y JetBrains, y trabaja en un grupo de pestañas aislado.
viene apagado por defecto. en la app de Copilot lo prendés en Settings > Computer Use, activando Enable Computer Use y Enable Browser Use. en VS Code y JetBrains buscás Enable Browser Use en la configuración, y en Copilot CLI escribís /plugin y activás browser use.
después tocás la extensión y te fijás que diga Connected.
eso sí, está en public preview, y qué puede hacer y qué no lo manejás desde los permisos de la extensión.
New from #MSIgnite: Download the GitHub Copilot extension for Chrome 🌐
Ask Copilot to fill out forms, pull information from webpages, or test and debug the web app you’re building, right in the browser you’re already signed in to. Try it for Google Chrome and Microsoft Edge.
Now in public preview ⬇️
https://t.co/k50PTaF3tI
GitHub y Microsoft pasaron de 9.791 alertas de seguridad hechas por IA a solo 99 REPORTES que valían la pena.
el problema es real. a los que mantienen proyectos open source les llueven reportes de bugs generados por IA, muchos repetidos o que ni siquiera son vulnerabilidades.
así que probaron otra forma con 6 proyectos muy usados, Express, Caddy, ImageMagick, Netty, FastMCP y AutoGPT.
primero MDASH, un sistema de Microsoft, escaneó el código y propuso arreglos. después un agente de GitHub sacó los duplicados y lo que no era grave, y al final 7 investigadores revisaron a mano cada hallazgo. cada reporte llegó en privado, con una prueba de concepto y el fix sugerido.
al 15 de noviembre ya habían arreglado 55 de los 99, y 14 ya salieron en una versión. los de Caddy arreglaron los 22 que les llegaron en una semana o menos. y en ImageMagick, que lo mantienen 2 personas, un fix salió en 15 minutos, cuando normalmente leer y arreglar un aviso les lleva de 30 minutos a 1 hora.
eso sí, el trabajo humano no es poco. cada proyecto llevó unos 2 días de revisión manual de esos 7 investigadores, y eso todavía no escala.
si mantenés un proyecto open source, lo más útil hoy es activar el private vulnerability reporting en tu repo, así te avisan de una falla sin hacerla pública.
y si usás IA para buscar vulnerabilidades en proyectos ajenos, lo que piden es verificar cada hallazgo antes de mandarlo, reportarlo en privado y sumar un fix.
Maintainers need fixes, not more AI bug reports.
With @msftsecurity, we turned 9,791 raw AI security findings into 99 verified, private reports with suggested fixes for six open source projects. And maintainers are already shipping fixes.
What we learned from Codename MDASH, a new security project 🔍
https://t.co/vzBOtFrpa2
GPT-6.2 Astra le saca 5,5 puntos a Claude Fable 5.2 en Agents' Last Exam, costando apenas el 5%.
OpenAI lanzó GPT-6.2 Astra, su modelo más potente, y GPT-6.2 Sol, el de todos los días. ya están en ChatGPT Work y Codex para Plus, Pro, Enterprise y Edu, y en la API como gpt-6.2-astra y gpt-6.2-sol.
contra GPT-6 Astra, el nuevo saca 5,2 puntos más en ese test a menos de un tercio del costo. y encima es más BARATO. en la API sale USD 8 el millón de tokens de entrada y USD 40 el de salida, 20% menos que antes, y el input cacheado baja 60% (USD 0,40).
Sol mantiene los precios de GPT-6.1 Sol (USD 2 y USD 10), y en FrontierCode 2.0 de Cognition queda a 0,5 puntos de Astra por más o menos un quinto del costo.
hay dos detalles del anuncio que conviene saber.
Astra es el primer modelo que OpenAI lanza al público que llega al nivel "High" en automejora, su forma de medir cuánto puede acelerar la propia investigación en IA.
y en dos pruebas de alineación los dos modelos tendían más a no avisar cuando algo les bloqueaba el trabajo, como un archivo que falta. en Codex agregaron instrucciones para reducirlo.
si lo usás por API, OpenAI recomienda no tocar el principio del prompt y sumar las instrucciones nuevas al final de la conversación. así aprovechás el cache y pagás menos.
Some of you have been asking very politely. Some of you have just been asking.
GPT-6.2 Astra and Sol are now available.
Super efficient and built to perform where it counts—the real world.
https://t.co/qr2iP0GpfX
la IA a veces te recomienda instalar paquetes que NO EXISTEN, y hay gente esperando con ese nombre.
un estudio presentado en USENIX Security 2025 generó 576.000 bloques de código con 16 modelos. en promedio, al menos el 5,2% de los paquetes que sugerían los modelos comerciales eran inventados, y en los open source el 21,7%.
lo peligroso es que no los inventa al azar. al repetir la misma pregunta 10 veces, el 58% de los nombres falsos volvió a salir más de una vez. entonces alguien registra ese nombre en npm o PyPI, le mete código malicioso y espera. a esto le dicen slopsquatting.
y no es teoría. Bar Lanyado (investigador de seguridad en Lasso Security) vio que los modelos repetían pip install huggingface-cli, un paquete que no existía. subió uno vacío con ese nombre y en tres meses tuvo más de 30.000 descargas reales. hasta terminó en las instrucciones de instalación de un repo de investigación de Alibaba.
antes de instalar algo que te sugirió ChatGPT o un agente, fijate cuatro cosas. que el nombre exista y sea exactamente ese, cuándo se publicó (si es de hace dos semanas y resuelve justo tu problema, desconfiá), cuántas descargas semanales tiene en https://t.co/sylgpe1IFx y que el repo de GitHub sea el del proyecto que creés.
en npm lo ves en un segundo con este comando (si el paquete no existe, te tira un 404)
npm view nombre-del-paquete time.created repository.url
y si trabajás con Claude Code o Codex, pegá esto en tu CLAUDE.md o AGENTS.md
antes de instalar cualquier dependencia nueva, frená y pasame el nombre exacto, el link a su página en npm o PyPI y por qué hace falta. no instales nada hasta que te diga que sí.
Jensen Huang (cofundador de NVIDIA) dijo que está dispuesto a VOLVER como CEO.
es su primer mensaje desde que renunció la semana pasada. admite que cometió "errores graves" en su vida personal y que le generó problemas al directorio, y promete colaborar con la investigación independiente.
cuenta que desde que se fue le llueven pedidos de empleados, inversores, socios y clientes para que vuelva. y que si el directorio decide que es lo mejor para los accionistas, los empleados, la empresa y Estados Unidos, sería un honor.
el tema es que no depende de él. según CNBC, el directorio no está considerando traerlo de vuelta y está enfocado en la investigación, que lleva el estudio de abogados Wachtell Lipton.
del otro lado, una petición online para que vuelva ya pasó las 180.000 firmas, y Donald Trump (presidente de Estados Unidos) dijo el lunes que está abierto a que vuelva.
según Reuters, la crisis ya le borró a NVIDIA más de USD 400.000 millones de valor de mercado. y hoy la empresa creó un comité nuevo en el directorio para supervisar seguridad nacional y controles de exportación.
todo esto el mismo día en que NVIDIA presenta los resultados del trimestre.
Over the past week, I’ve been overwhelmed by the love and support of friends, industry colleagues, and people I've never met. Thank you to everyone who has shown kindness to my family and me. It means the world to me.
I came to the United States 53 years ago, and becoming an American citizen is one of the greatest gifts and proudest moments of my life. NVIDIA has been my life’s work. Building it into the company it is today alongside my colleagues has been a privilege and an honor. Nowhere but in America could a company like NVIDIA be possible. I love our country, and I love NVIDIA.
I did not live up to the standards expected of everyone at NVIDIA, and I have made serious mistakes in my personal life. I created problems for the Board that I deeply regret. I own my mistakes completely, and I am committed to cooperating with the Board’s independent investigation.
Since my departure, I’ve seen an outpouring of calls from NVIDIA’s employees, investors, business partners, and customers for me to return as CEO. Many continue to reach out to me directly as the company navigates complex technology, market, competitive, and geopolitical dynamics. NVIDIA is a once-in-a-generation company. If the Board of Directors decides that my return is in the best interest of our shareholders, our employees, the company, and America, I would be honored to answer these calls and return as CEO.
Thank you again to everyone who has shared their good wishes. I am profoundly humbled by your support. To my family: I love you, and I will spend the rest of my life being worthy of yours.
Jensen
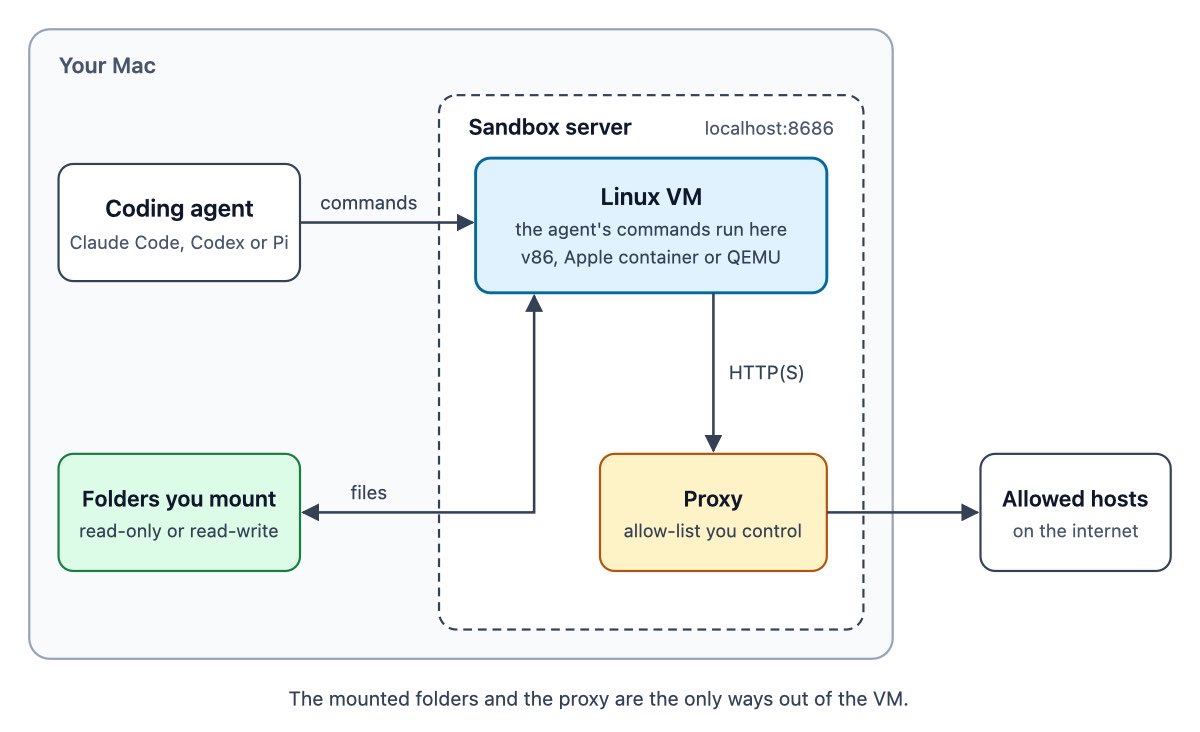
tu agente puede seguir en tu Mac y que todos sus comandos corran ENCERRADOS en un Linux aparte.
lo armó Simon Willison (cocreador de Django y creador de Datasette) y lo llama external sandbox. funciona con Claude Code, Codex y Pi.
el agente corre normal en tu máquina, pero cada comando que ejecuta se manda a una sandbox que solo ve las carpetas que le montás. y por defecto no tiene internet, salvo los sitios que habilites con un proxy.
lo mejor es lo de las API keys. el proxy pone la clave real recién cuando sale la request, así que el agente nunca la ve.
hay 3 versiones con el mismo protocolo. una en WebAssembly que corre con Node.js, otra con Apple Containers y otra con QEMU usando Quicksand de Microsoft.
para probarlo necesitás Node.js 22.19 o más nuevo. en la carpeta del proyecto corrés
npx --yes external-sandbox-v86 --preserve-paths --mount-rw "project=$PWD"
y en otra terminal levantás Pi apuntando a la sandbox
npx --yes @earendil-works/pi-coding-agent -e npm:external-sandbox-pi --no-builtin-tools --sandbox-url http://127.0.0.1:8686
si adentro de Pi corrés !uname -a, te tiene que aparecer Linux y no Darwin.
ojo con Claude Code. ahí solo los comandos de Bash van a la sandbox, sus tools para leer y editar archivos siguen tocando tu Mac.
y ellos mismos avisan que son prototipos experimentales, todavía no auditados como para confiarles cosas sensibles.
I've been exploring new ways to sandbox code written by coding agents - here's a description of the external sandbox pattern, where agents run on your Mac but execute code in a WebAssembly or QEMU or Apple Container sandbox - with demos for Claude Code, Codex and Pi https://t.co/0XIhs4XYvQ
cambiar el reasoning effort en medio de una sesión puede hacer que tu agente RELEA todo desde cero.
lo explican Ollama y Together AI (una de las empresas grandes que sirven modelos open source) en un post sobre por qué los agentes de código se ponen lentos en sesiones largas.
en cada paso, el agente le manda al modelo toda la conversación de nuevo. lo que lo salva es el prefix cache, que guarda lo ya procesado y solo calcula lo nuevo. en 100 turnos, sin cache se procesan 5.050 unidades de prompt y con cache 100.
el tema es que el cache sirve solo hasta el primer carácter que cambia. si algo cambia arriba de todo, se pierde casi toda la sesión.
por eso un timestamp, el git status o la carpeta actual dentro del system prompt te rompen el cache en cada turno. y en GLM-5.3-Flash el reasoning effort va escrito en el primer bloque del prompt, así que subirlo de low a high a mitad de camino puede costarte cientos de miles de tokens.
otra que pasa mucho es cortar la salida de una tool sin avisar. si el agente lee las primeras 100 líneas de un archivo de 640 y no sabe que hay más, termina editando código que nunca vio. con una sola línea que le diga que recibió las líneas 1 a 100 de 640, busca el resto solo.
si armás tu propio agente, dejá el system prompt idéntico en todas las sesiones, poné la fecha y esos datos en el mensaje de la tarea y elegí el effort al principio. si después necesitás más, conviene abrir una sesión nueva o compactar antes de cambiarlo.
what we learned to keep coding agents fast in Claude Code, Codex, Pi, and more:
– a single timestamp in the system prompt can break the cache
– changing reasoning effort can wipe the whole cache
– telling the agent its output was cut off will get it to read what it missed