这个号写两样东西:工作日白天写 AI 实操,工作日傍晚写中国书画。
AI 这边写的是新东西到手以后怎么用、哪一步还得人来把关。写过的有 Grok 和 Grok Bot 的新功能、Cursor 的模型和订阅变化、智能体怎么搭和怎么设安全边界、在 Mac 上本机跑开源大模型、NVIDIA 的新硬件和软件,也有 AI 用在新药研发这类科学问题上。每条都以官方页面和原帖为依据,核不到的数字不写,文末附来源链接。
书画这边,工作日傍晚发一幅馆藏原作,目前大多来自克利夫兰美术馆的公开馆藏。每条写明作者、年代、材质、尺寸和馆方编号,再讲一个看画时可以留意的地方,比如皴法、米点、飞白,或者画上的一方印。周六把这一周的几幅放在一起回看。周日换成生活版,从一杯咖啡冒出的热气这样的小事,说回笔墨。最近还开了一个新系列「五色周一」,第一期讲「青」。
你最近在用哪个 AI 工具,或者在看哪幅画?欢迎在评论里说一说。
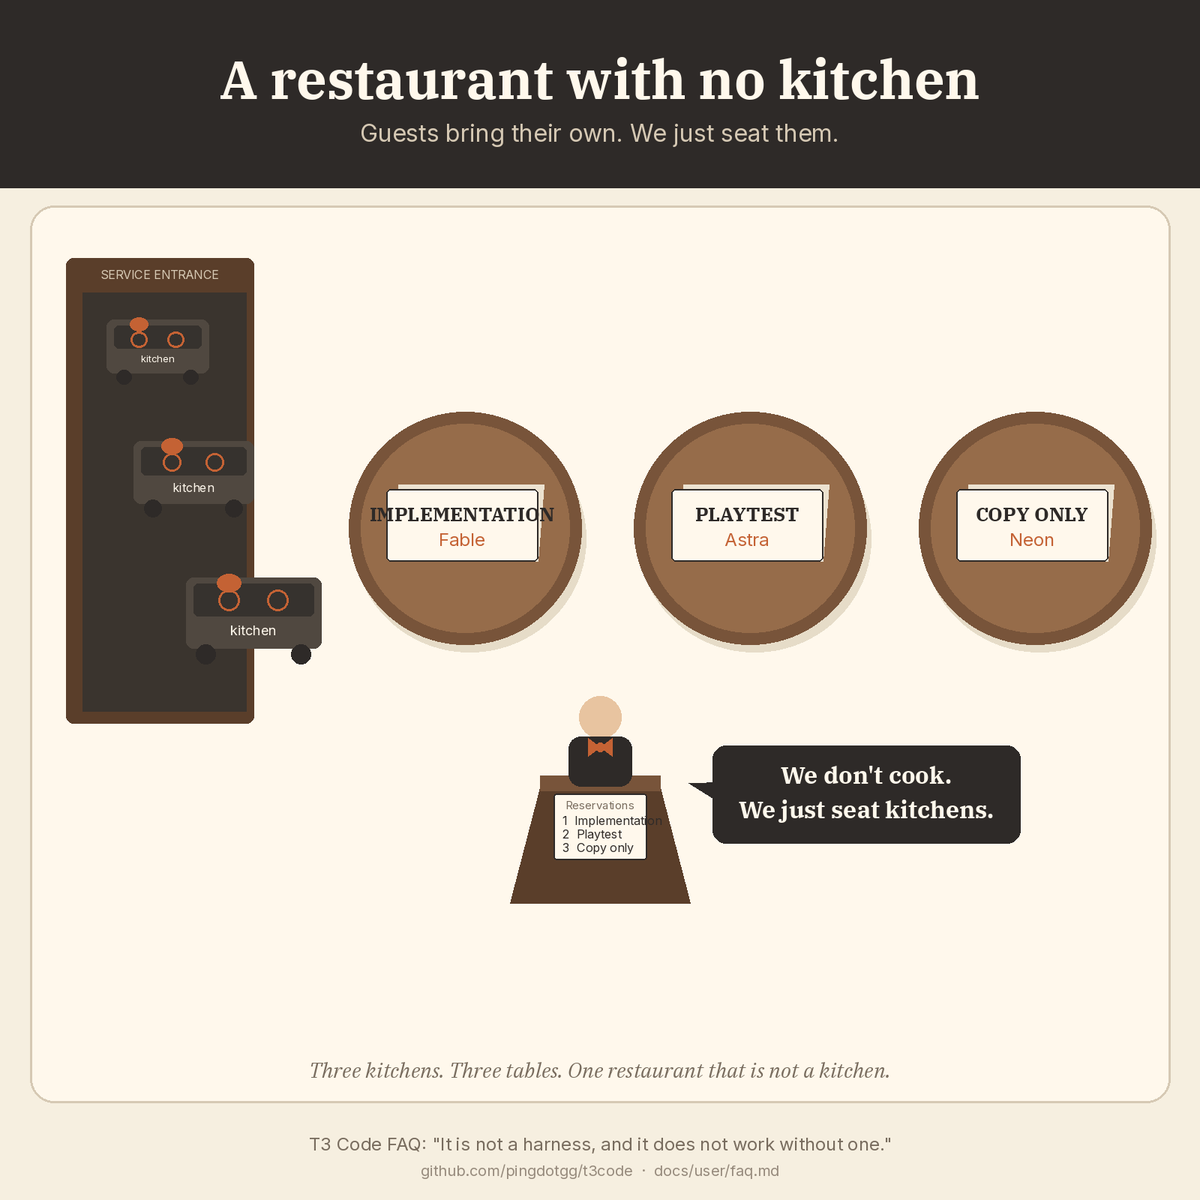
@theo T3 Code's own docs say it is not a harness, and it does not work without one. It drives the agents you are already signed in to. The choice here is the seating chart: Fable on implementation, Astra on playtesting, and Neon only on copy.
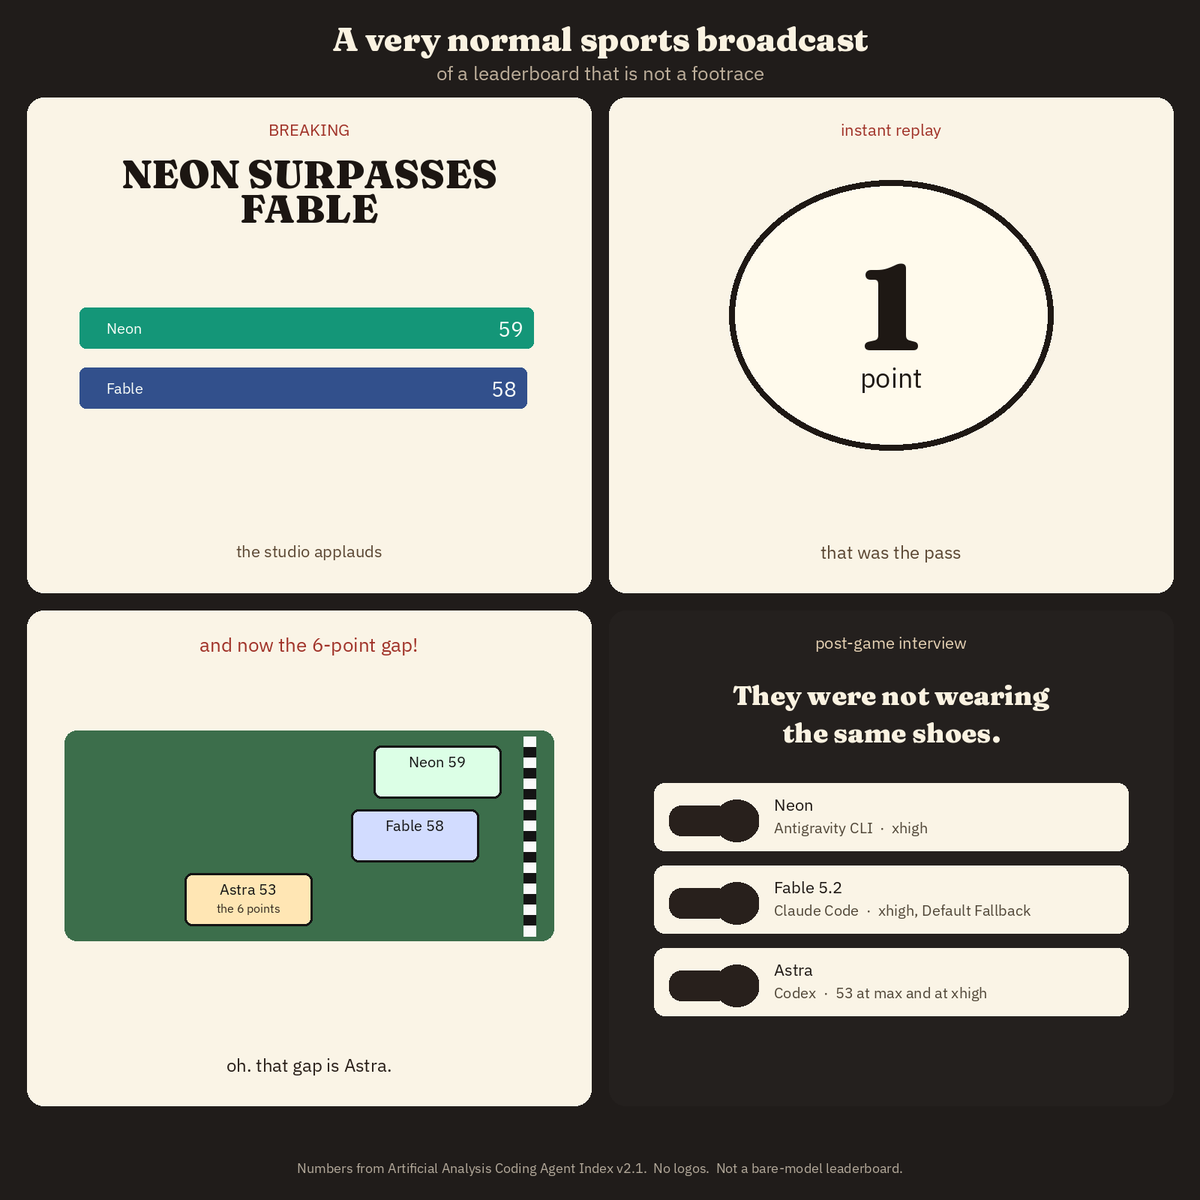
@kimmonismus The index compares stacks, not bare models. Neon is 59 with Antigravity CLI at xhigh, Fable 5.2 is 58 with Claude Code at xhigh and Default Fallback, and Astra with Codex is 53 at both max and xhigh.
@OpenAI Surveyed participants estimated that the same work, at the same quality, would have taken 1.9 times as long without AI. The report also notes that this productivity figure is self-reported.
@ArtificialAnlys Seven of the 23 record days came after the May 26 delay, so the delay alone covered almost a third of them. Which lab set the most of those seven?
让编码智能体「只改最小的那一处」,省下的是这一次的工夫,代价可能落在整个代码库上。这个周末我把几条相关讨论对着读了一遍,大家都不赞成一味打补丁,差别在于各自管到哪一层。
第一种看法来自 Lauren Tan(@poteto),她在 Grok Bot 团队。她这条帖子的开头是「quick fixes considered harmful」:你要求最小、最快的改动,反而可能让智能体写出更差的代码。她的理由是,一个看似无害的创可贴,会被下一个智能体当作范式复制,「before you know it that pattern has spread everywhere」。她还写道,过去人手写补丁,是因为很少有时间把事情做对,而智能体改变了这笔账,「sometimes you want it to fix the root cause instead even if it’s more invasive」。
https://t.co/H2Kyp8rQM1
第二种看法是在她的基础上补了一层:问题不只出在人怎么下指令,模型自己也偏爱小改。Kinopee(@kinopee_ai)引用她的帖子时写道,AI 也许是为了避免破坏性改动,也许是为了节省 token,总是倾向于「最小変更」,所以一个已经往坏方向走的代码库,不会自然变好。他的结论是,要看情况做根本改进和重构。
https://t.co/2GfFj3d1ZQ
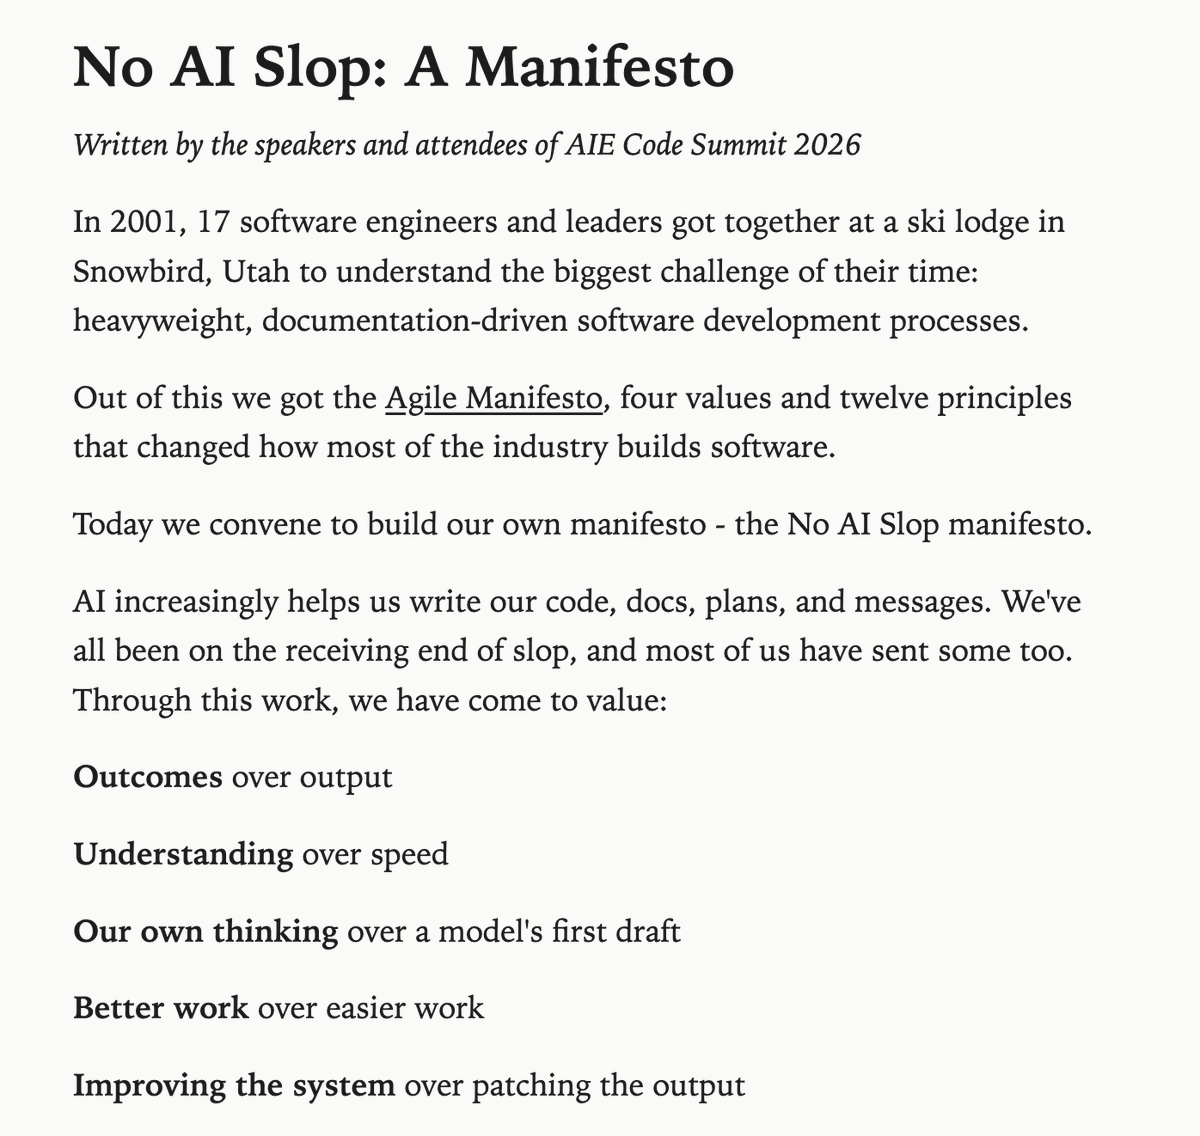
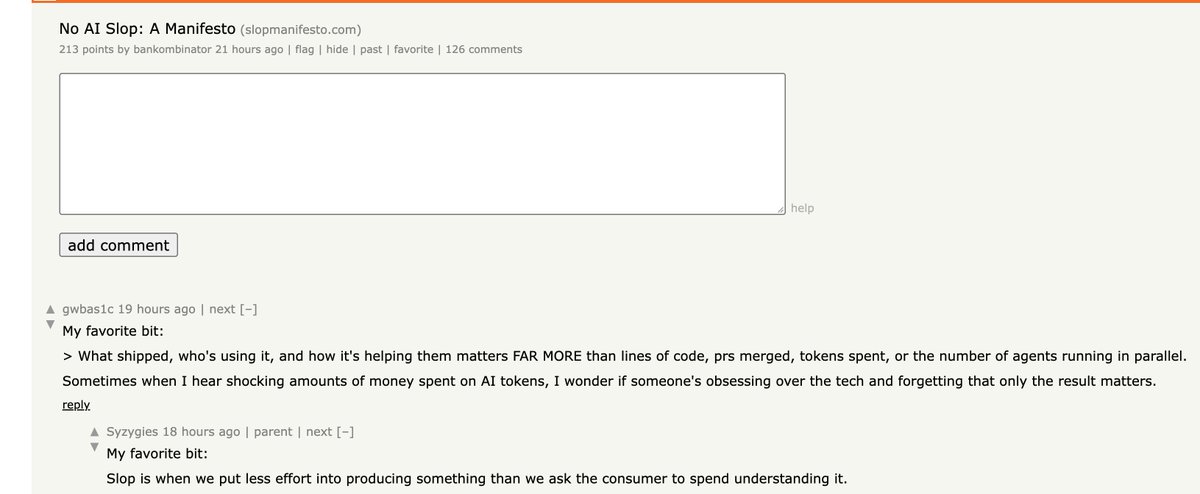
第三种做法是把它写成大家共同遵守的守则。@dexhorthy 介绍说,《No AI Slop》宣言是在 AIE Code Summit 上和许多讲者、与会者一起写成的,Lauren 也在署名者里。宣言的五条价值之一是「Improving the system over patching the output」。第 6 条说,早在 AI 之前,反复绕开问题而不正确解决,就会让 slop 蔓延;第 8 条说「The more slop sits in our knowledge base, in chat, in code, the more of it the next agent reads and copies」。第 21 条给了一个触发点:同一个错误出现第二次,就去改进系统和护栏,凡是 linter、类型检查或自动检查能抓到的,就交给它们去抓。
https://t.co/h4mHwuKtd7
https://t.co/K2C2CZktK8
三方的共同点是,都不把补丁当成可以随手留下的东西。Lauren 和宣言都明确说了,下一个智能体会读到并照抄它。差别主要在管到哪一层。Lauren 管的是这一次的指令,提醒人别再顺口要求最小改动。Kinopee 管的是模型的默认倾向,意思是光不说「最小」可能还不够,有时要主动要求它去做根本改进。宣言管的是团队和流程,同一个错误第二次出现时,不只改这一处代码,还要补上护栏和自动检查。至于什么时候该改深,Lauren 写的是「sometimes」,Kinopee 写的是看情况,宣言给出的门槛最具体,就是第二次。
我的理解是,派修 bug 的活时,可以先让智能体说明同样的写法在别处还有没有,再决定是就地补,还是从根上改。同一类问题第二次出现时,就不再接受补丁。
你给智能体派修 bug 的活时,通常怎么说?回 A 只改这一处,B 找到根因再改,C 先让它报改动范围再定,D 看情况。
a few days ago we published the "No AI Slop Manifesto" at @aiDotEngineer Code Summit in SF, written in collaboration with many of the speakers and attendees
It already hit the front page of hacker news, has 300+ signatures including folks from Baseten, SpaceX, OpenAI, PostHog, Shopify, Glean, ZoomInfo, and legendary builders including
@swyx@poteto@kentcdodds@mihail_eric@audreyt@altryne@traviscline@philipkiely@TejasKumar_
read and sign it at slopmanifesto dot com
some of my favorite points
> AI cannot replace human judgement, it can only amplify our judgement (or lack thereof).
> We own the intent, taste, and consequences of what we ship, however much AI helps us make it.
> There will always be alpha in reviewing *something*. As models improve, we may stop reading most of the code. We may still review a plan, design, or result, because if we don't, we just get the same output as everyone else.
@OpenAI Craig writes in the post that the method is "far more an answer in principle than an answer in practice," and that "much work lies ahead to make it useful for realistic lattice simulations."
I don't write code, but I run a whole team of Grok Bots. Too many "just do it quickly" patches, copied again and again, and the rules file did nothing. Last week I fired my chief of staff bot. Had to promote the posting-test bot into the job. Next time it's a root-cause fix — I'm not doing another firing.
怎么读一件画·回看
这一周我按四种办法读画。册页当一趟路来翻,长卷顺着工序看,群像先看谁挨着谁,仿作先看眼前的山势。
周二是册页。明沈周《虎丘十二景图》第1开,馆藏号1964.371.1。这一开馆方没有单独的中文题名,英文题名是 Distant View of Tiger Hill from the Canal Mooring,可以意译为《从运河泊舟处远望虎丘》。我看时先注意到岸边的船,再看到山上的屋宇。整册像一趟路,每翻一页,都要再看自己是从哪里望出去。
https://t.co/4gftSBH8Bc
周三是长卷。传梁楷《耕织图》的蚕织部分,馆藏号1977.5。馆方说全卷分三段,画了从养蚕到织成丝绸的十四道工序;一个屋顶下的几组人,不一定是在同一时刻。我看这类长卷,会先找一组人在做什么,再比较下一组的动作。作者栏写的是 attributed to,这里仍是「传梁楷」,并不是已经确认的真迹。
周四是群像。清方士庶、叶芳林1743年的《九日行庵文讌图》,馆藏号1979.72。馆方把它称为纪念一次文人聚会的群像,地点是扬州一座私人园林。我看时会先看谁和谁坐在一起,再去认名字。
https://t.co/I9dztexO4S
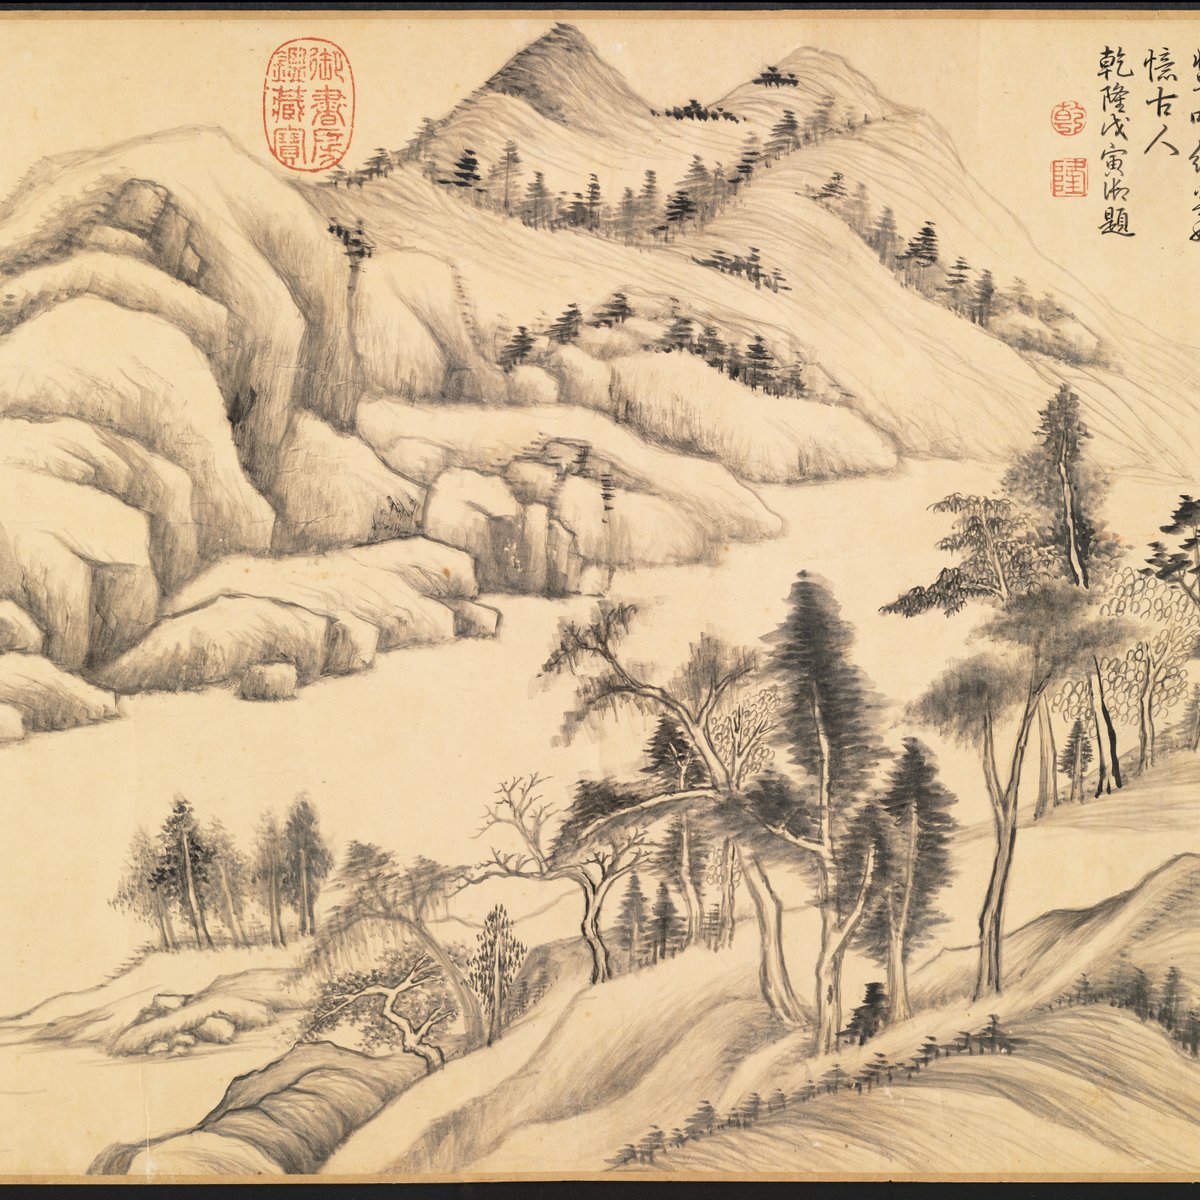
周五看的是「仿」不是抄。明董其昌《江山秋霁图》,馆藏号1959.46,馆方定年约1624至1627年。馆方说明写,他把抽象化的山水斜向布置在画面中,既让人想起早期名家的画法,也表达了个人风格。自题里有黄公望的名字,并不等于已经找到可以逐笔比对的底本。
https://t.co/Yyogzv9E0b
册页看一页一页的路,长卷看工序怎样往下走,群像看谁挨着谁,仿作先看眼前的山,再问它和古画像在哪里。
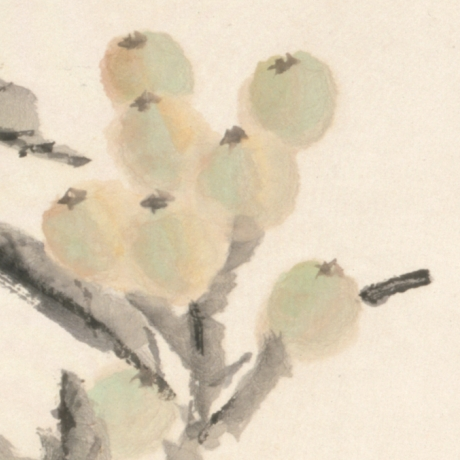
本周之色是「黄」。周一清虚谷约1888到1889年的《枇杷图》里,馆方写枇杷初夏结黄色的果子,我看画上却有的偏橙红,有的带着青绿。明天的生活版,会把这种黄放到日常里再看一看。
https://t.co/6Euk1lChvN
册页、长卷、群像、仿作,你最愿意花十分钟看哪种?
图一:本周原作拼图,The Cleveland Museum of Art Open Access (CC0);图二:本周 AI 想象复原拼图,非原作。
The blog says SatWeave updates hourly and thus allows WeatherNext 3 to produce new global predictions, in contrast to models initialized on analysis data refreshed every six hours.
(博客写明:SatWeave 每小时更新,WeatherNext 3 因此能给出新的全球预报,不像按分析场初始化、每六小时才更新的模式。)
看董其昌这张山水,我会先看山势怎样安排,再找它与古画的相似之处。
董其昌《江山秋霁图》,克利夫兰美术馆藏,馆藏号1959.46,馆方定年约1624至1627年。我想借这件作品看看:他参考了哪些古人的画法,又作了怎样的安排。
馆方说明说,董其昌把抽象化的山水构成斜向布置在画面中,既让人想起早期名家的画法,也表达了个人风格。我想先看这些山怎样连在一起。
我看原图时,画心里的山体一段段相接,岸边树木连着山脚。我会沿着山势的转折看过去。这是我的观看感受,不能据此认定画家照着哪一张原作落笔。
至于参考了哪位古人,馆方说明提到:董其昌的自题说到了黄公望,他也可能想到了董源的一件作品。自题中有黄公望的名字,并不等于已经找到可以逐笔比对的底本;关于董源的说法,也仍是推测。
我会先自己看一会儿,再读馆方说明,核对刚才留意的地方。
如果有两张图可以并排看,你想先做哪一步?A 先看眼前这张,B 马上找它参考的古画。
图一:原作《江山秋霁图》,The Cleveland Museum of Art Open Access (CC0);图二:原作局部;图三:AI 想象复原,非原作;图四:纸感插画(AI 生成)。