Beranda
Bahasa
English
Türkçe
Bahasa Indonesia
Tentang
Kebijakan Privasi
Syarat Layanan
Harga
Masuk
Unduh Semua
Membagikan
hexsecurity
@hexsecurity
Ikut December 2011
111
Mengikuti
34
Pengikut
4.8K
Postingan
hexsecurity
di-retweet
王长富
@wangchangfu88
sekitar 13 jam yang lalu
Vibe Coding 现状 很形象...
hexsecurity
di-retweet
Amto
@XAMTO_AI
sekitar 16 jam yang lalu
统计学教材满页公式,会写代码的人也常常卡住。 《Think Stats》反着来:拿 Python 把分布、检验这些概念直接跑出来。第三版的 notebook 就在这个仓库里,官网可以直接读,Colab 上也能开。 探索性分析、pmf/cdf、假设检验、回归、时间序列、生存分析都有涉及,例子多取自公开数据。 需要一点 Python 基础。把它当成能跑的讲义来用,而不是零公式的速成班。 https://t.co/q0TsvSQsOk
hexsecurity
di-retweet
沐阳
@yyyole
1 hari yang lalu
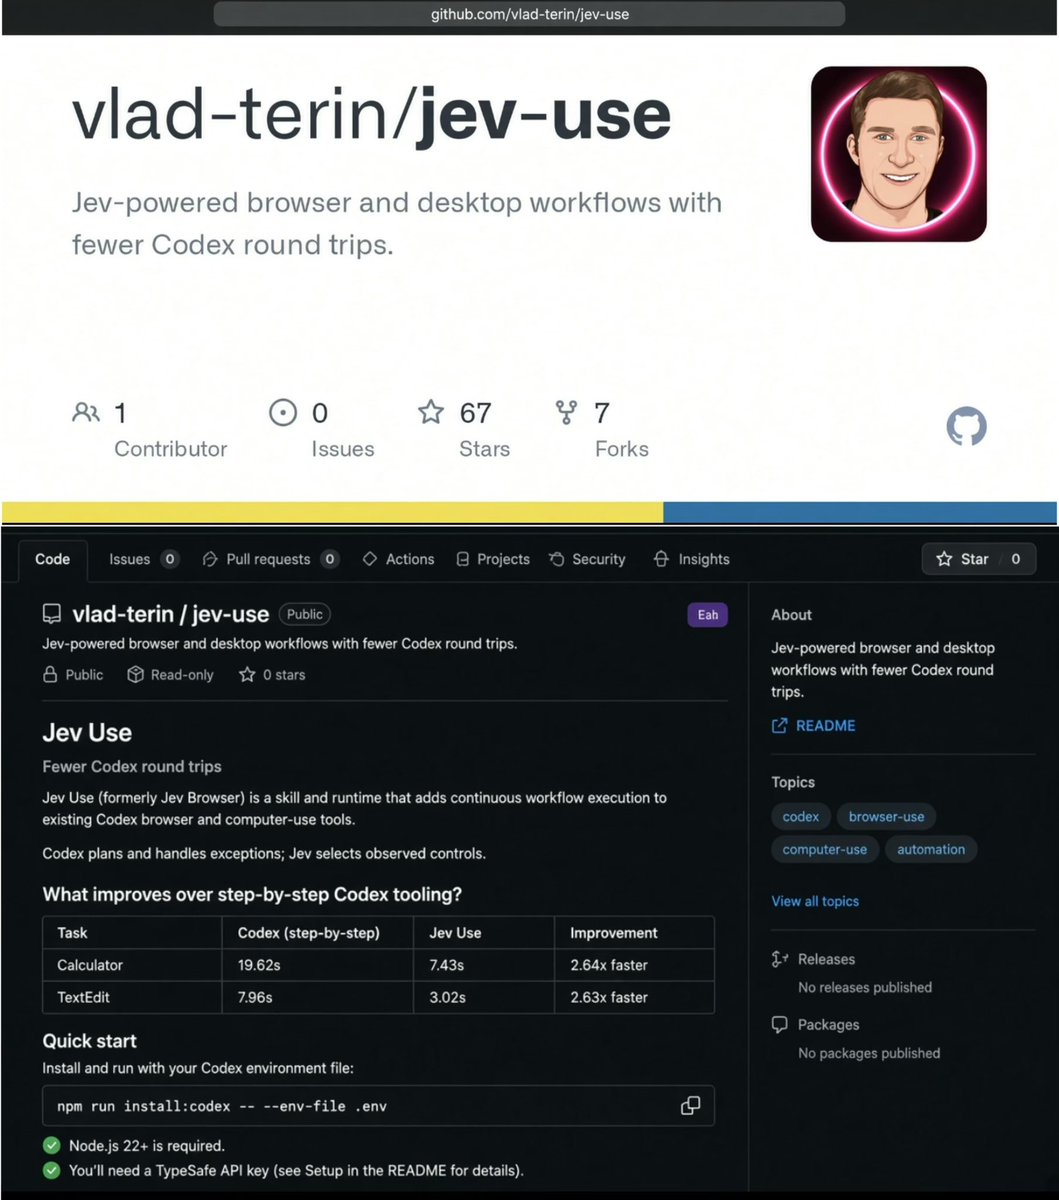
舆情监测的 Skill,这不就呼之欲出了吗! 工作流非常简单,并且成本会低一大截,Agent 每天自动围绕品牌名、产品名、竞品、行业关键词,去搜索新闻、公众号、社媒、论坛等信息源; 抓回来以后,先去重、聚类,把同一件事合并; 再交给 Jev 做判断,正面、负面、中性,分别是什么情绪,负面到了什么程度,有没有扩散风险; 最后再让 Agent 做一层处理: 普通信息进入日报,重点信息生成摘要,高风险负面直接预警,然后出应对建议。 还能继续往下做!! 负面舆情不只是告诉你“负面增加了”,而是进一步��解,负面从哪里开始、核心争议是什么、谁在传播、扩散速度怎么样、和过去 7 天相比发生了什么变化。 同样的一套工作流,成本降低,速度增快,也是一次了不得的进步!
Lihat Selengkapnya
hexsecurity
di-retweet
撸毛小白
@xiao92666
2 hari yang lalu
Siapa yang Harus Diikuti
ToadFx
@xToadFx
Streaming on tiktok at https://t.co/xK7NAnDNyB | A god at losing | Road to Cod challengers
Starkwang
@_WeijiaWang_
Product Lead @TencentCloud CloudBase / Agent Infra / Node.js Collaborator Emeritus / Shenzhen, China.
Bak İşineee
@BurcakSb
Her Rt katıldığım anlamına gelmez😏
hexsecurity
di-retweet
三个三
@3three_AI
1 hari yang lalu
Reddit疯传! 最近在 Reddit 的看到一段高赞的“深度思考” Prompt, 我拿 Codex 试了几次,彻底改变了我和 Codex 的沟通方式。 Prompt: “请先不要回答我的问题。 在给出答案之前,请先完成以下分析: 1、指出我在这个问题中没有明确说出、但已经默认成立的假设; 2、告诉我还缺少哪些关键信息,以及这些信息可能如何改变你的答案; 3、指出人们在处理这类问题时最常犯的一个错误。 然后,请只向我��出一个最关键的问题。这个问题应该能够帮助你理解我的真实目标和具体情况,让最终答案真正对我有用,而不是一份谁都能套用的通用建议。 等我回答以后,你再给出最终输出。 我的问题是:[粘贴你的问题]”
Lihat Selengkapnya
hexsecurity
@hexsecurity
1 hari yang lalu
面向切面的开发
非著名程序员
@KengGuangLong
1 hari yang lalu
Grill Me Skill 的作者 Matt Pocock 在访谈时也是这么认为的,软件工程很重要。 他说在折腾 AI 编程的过程中,碰到一个很烦人的问题。 Agent 写代码的时候,它会先把整个数据库层写完,再写整个应用层,最后写整个前端。每一层单独看还行,但拼到一起就出问题。因为数据库里的设计会影响前端展示,你得让这些层早一点对上才知道合不合理。可 Agent 总是最后才开始组装。 他觉得这样不行。然后他翻出了书架上一本一直没拆封的《程序员修炼之道》。 他说这本书他买了之后一直没看,还包着塑料膜。翻开以后,几乎每一页都觉得像是写给今天的。里面有一个概念叫 tracer bullet,追踪子弹。意思是做一个功能的时候,不要按层来,要纵向切一刀,从数据库到应用逻辑到前端,先把一条窄窄的路径跑通,确认可行之后再往两边扩展。 他把这个词写进了给 Agent 的提示词里。然后他发现了一件有意思的事:Agent 开始在自己的推理过程中主动使用这个词了。它会说「好的,我把这个做成一个 tracer bullet」。 他管这个叫 leading word,引导词。因为这些经典编程书籍几乎肯定在模型的训练数据里,当你在 prompt 里用了这些专业术语,就相当于激活了模型脑子里对应的那片知识。 他又从《软件设计哲学》里捞出了 deep modules 这个概念,从《领域驱动设计》里拿到了 ubiquitous language 的思路。他发现这些二三十年前的老概念,到了 AI 时代反而更好用了。
Lihat Selengkapnya
hexsecurity
di-retweet
非著名程序员
@KengGuangLong
1 hari yang lalu
Grill Me Skill 的作者 Matt Pocock 在访谈时也是这么认为的,软件工程很重要。 他说在折腾 AI 编程的过程中,碰到一个很烦人的问题。 Agent 写代码的时候,它会先把整个数据库层写完,再写整个应用层,最后写整个前端。每一层单独看还行,但拼到一起就出问题。因为数据库里的设计会影响前端展示,你得让这些层早一点对上才知道合不合理。可 Agent 总是最后才开始组装。 他觉得这样不行。然后他翻出了书架上一本一直没拆封的《程序��修炼之道》。 他说这本书他买了之后一直没看,还包着塑料膜。翻开以后,几乎每一页都觉得像是写给今天的。里面有一个概念叫 tracer bullet,追踪子弹。意思是做一个功能的时候,不要按层来,要纵向切一刀,从数据库到应用逻辑到前端,先把一条窄窄的路径跑通,确认可行之后再往两边扩展。 他把这个词写进了给 Agent 的提示词里。然后他发现了一件有意思的事:Agent 开始在自己的推理过程中主动使用这个词了。它会说「好的,我把这个做成一个 tracer bullet」。 他管这个叫 leading word,引导词。因为这些经典编程书籍几乎肯定在模型的训练数据里,当你在 prompt 里用了这些专业术语,就相当于激活了模型脑子里对应的那片知识。 他又从《软件设计哲学》里捞出了 deep modules 这个概念,从《领域驱动设计》里拿到了 ubiquitous language 的思路。他发现这些二三���年前的老概念,到了 AI 时代反而更好用了。
Lihat Selengkapnya
hexsecurity
@hexsecurity
1 hari yang lalu
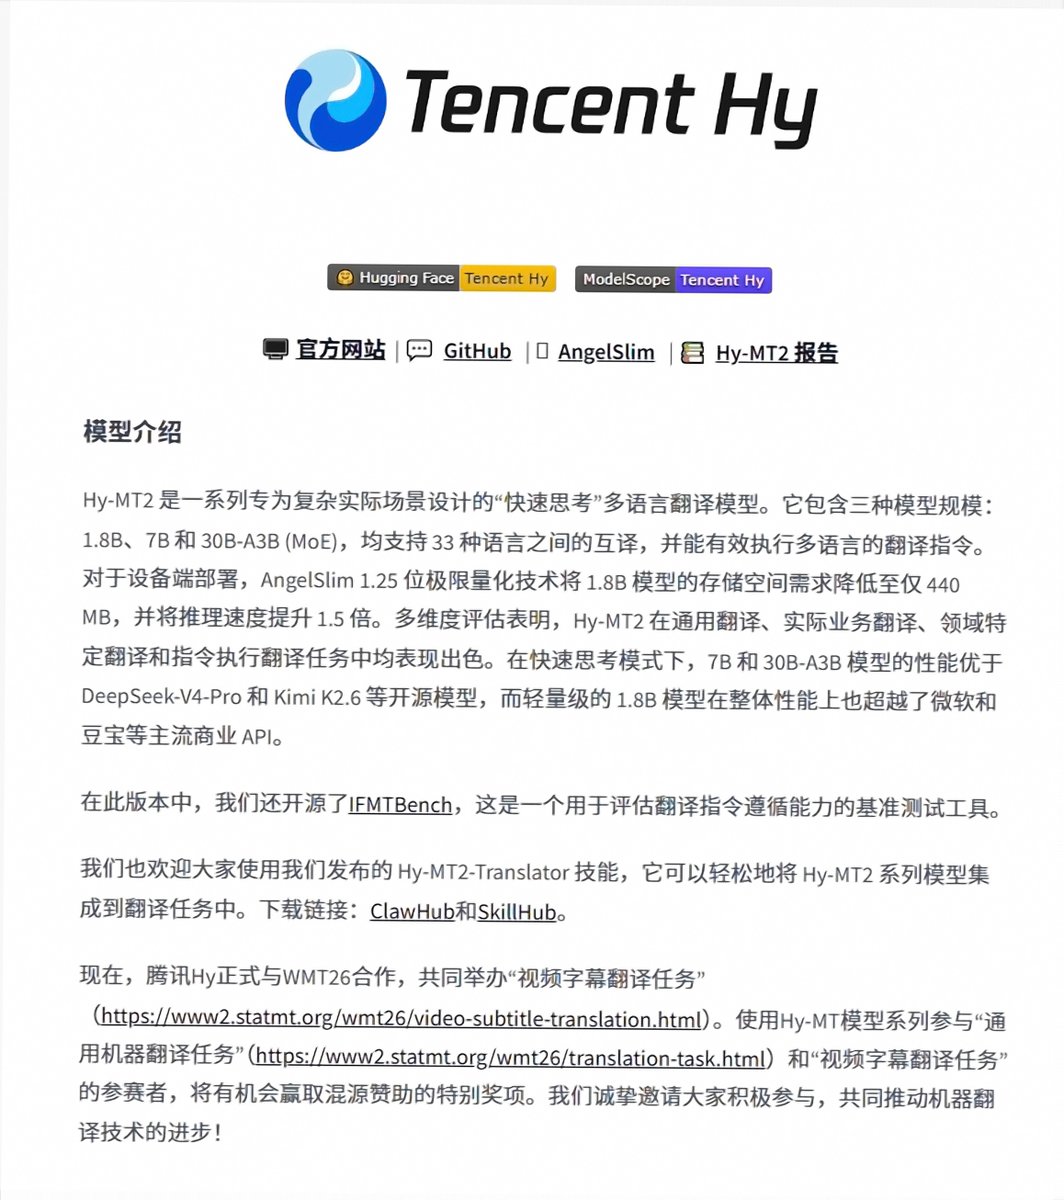
Hy-MT2 440MB这玩意对于专有名词应该不行吧?
Awab_Ehemer
@awabx7
2 hari yang lalu
一台入门款 Mac mini,就能在本地运行腾讯新开源的翻译模型。Hy-MT2 把高质量机器翻译的门槛压到了 440MB。 它的轻量版本参数量为 1.8B,通过自研 1.25-bit 量化大幅缩小体积,推理速度达到上一代的 2 ���,翻译效果已超过微软、豆包等商业 API。 更大的 7B、30B 版本,表现也领先 DeepSeek-V4-Pro 等开源模型。 无需联网、不用按量付费,文本留在自己的设备上处理。对个人用户来说,本地翻译终于不再是高配机器的专属能力。 🔗 https://t.co/ua656e1nKu
hexsecurity
@hexsecurity
1 hari yang lalu
@NekoNibbles
@Balder13946731
可以在海外提供广告位啊。
hexsecurity
@hexsecurity
2 hari yang lalu
双边、多对多的平台更容易形成长期壁垒。 滴滴、美团这类平台的核心不是简单撮合,而是同时连接大量供给方和大量需求方。 8. 高频业务比低频业务更容易形成独立产品和用户入口。 一个比较理想的标准是用户至少每周使用一次;频率太低,很难长期占据用户心智。
陈思远Yosef
@YosefBlockchain
2 hari yang lalu
转帖:朱啸虎昨晚北大演讲核心总结 1. 技术领先只是阶段性优势��长期竞争最终还是回到商业。 技术进步快的时候拼技术;技术扩散快的时候,拼渠道、品牌、供应链、成本、用户入口和运营效率。 2. 判断创业项目最重要的是 3S: Size:市场足够大 Scalable:能够快速规模化复制 Sustainable:能够长期防御,不容易被大厂复制或吞掉 3. 高度定制化的业务很难 Scale。 如果每个客户都需要重新部署、重新开发、重新服务,本质上更接近服务公司,而不是可规模化的产品公司。 4. 最好的增长是用户主动带来用户。 社交网络、社区和双边平台的优势,在于网络效应和自然传播,而不是长期依赖买量。 5. AI 创业最危险的是做成一个“大厂可以免费集成的功能”。 如果只是一个简单 AI Feature,没有入口、数据、网络效应等壁垒,很容易变成给大厂“打样”。 6. 用户入口往往比单纯的技术领先更加重要。 腾讯能够不断后发追赶,一个重要原因就是微信、QQ 这样的流量入口长期存在。 7. 双边、多对多的平台更容易形成长期壁垒。 滴滴、美团这类平台的核心不是简单撮合,而是同时连接大量供给方和大量需求方。 8. 高频业务比低频业务更容易形成独立产品和用户入口。 一个比较理想的标准是用户至少每周使用一次;频率太低,很难长期占据用户心智。 9. 创业公司最好不要教育市场。 最好的切入点,是用户本来就存在需求、已经形成习惯,只是原来的解决方案不够好。 10. 用户数量本身并不等于商业价值。 更重要的是用户是否愿意付费、是否有留存、是否能够升级到更高价值的服务。 11. 交易越标准化,越容易规模化。 像打车这种“A 点到 B 点”的标准需求,更容易形成大平台;高度非标的家政、美容等服务则更难 Scale。 12. 留存比单纯增长更重要。 朱啸虎提到,其看 AI 产品时,希望看到大致次月留存 50%+、六个月留存 20%+。 13. AI 正在从 Token Maxing 转向 Value Maxing。 未来不是所有任务都要使用最强模型,而是选择最合适、性价比最高的模型完成任务。 14. 开源模型可能逐渐成为 AI 基础设施的重要形态。 朱啸虎将其类比 Linux:随着模型能力趋同和成本下降,开源模型可能获得越来越大的市场空间。 15. 真正成熟的 AI 产品应该把模型和 Prompt 隐藏起来。 用户不需要关心 GPT、Claude、DeepSeek,也不需要自己选择模型,只需要提出需求,系统自动完成任务。 16. AI 最好的创业机会之一,是“旧需求 × 10 倍体验”。 不一定需要创造全新的需求,而是找到已经被市场验证的需求,再利用 AI 把体验提升 10 倍甚至 100 倍。 17. 朱啸虎目前重点提到的 AI 应用方向包括角色扮演、Coding 和视频。 这些场景具有高频、强需求,以及 AI 相比传统技术明显提升体验的特点。 18. 中国 AI 软件出海,开源可能是一种重要获客方式。 相比传统依赖海外���售团队的 SaaS,开源可以通过产品本身和开发者社区直接触达全球用户。 19. 机器人创业不一定追求“通用”,而应该优先解决高价值的具体任务。 相比大量同质化的人形机器人,更值得关注的是水下清洗、工业装配等“高价值、任务明确、泛化要求低”的场景。 总结:技术先进只是入场券。随着技术快速普及,真正决定公司长期价值的,还是市场规模、规模化能力、用户留存、入口、商业模式和壁垒。
Lihat Selengkapnya
hexsecurity
di-retweet
Russell
@Russell3402
2 hari yang lalu
很多人其实根本没做过用户调研 嘴上会说,我这个月访谈了 100 个客户,我做了多少轮用户调研,我收集了多少反馈 这些都没问题 但真正的问题是,你到底有没有把用户当回事 真正做用户调研,就是要把腰弯下去 你可以直接找一个客户过来,我给你付钱也好,请你吃饭也好,你就坐在我旁边用这个产品 我不急着问你“你有什么需求” 我先看你怎么用 你第一步点哪里,哪里停住了,什么地方你会犹豫,什么东西你完全没看懂,哪个功能我觉得很重要,但你根本没点 然后听他说的每一句话 有时候他随口说的一句话,可能比一张几百人的问卷更值得你回去想半天 因为用户不是一个“样本”,也不是后台里的一行数据 他是一个具体的人 很多现在OPC做产品最���的问题就在这里 东西做出来,卖出去,然后就觉得任务完成了 但卖出去根本不是终点 用户买完以后有没有真的用起来? 他为什么不用? 他在哪一步觉得麻烦? 他最后有没有真的因为你的产品得到价值? 这些东西才决定你的产品到底是不是真的成立 所以所谓用户第一,不是说是一句价值观而已,喊喊口号 它应该体现在很多特别小的事情里 你愿不愿意坐在用户旁边看两个小时 愿不愿意认真听一句你觉得“不重要”的抱怨 愿不愿意在产品已经卖出去以后,继续追着问一句: 你现在到底用得怎么样? 这才是对被调研用户真正的尊重
Lihat Selengkapnya
hexsecurity
di-retweet
小盖
@xiaogaifun
2 hari yang lalu
看来很多人没注意到Anthropic这个论文。 Anthropic 这公司很多事情做得确实细致和严谨。今天周五,下午没什么事,我把他们刚发的这篇论文完整看了一遍。 整篇 57 页,系统研���了如果未来几年 AI 能力继续快速提高,而且真的开始大规模进入工作,到 2030 年,GDP、工资、就业和整个社会的收入分配会发生什么变化。 这套分析框架做得非常好,反正我看完还是有很多收获。它设计了几种不同的 AI 发展情景,然后看每一种情况下,经济和就业的影响。下面是我的笔记。 还有时间的话,我还是强��推荐看一看,主要是看他们的分析逻辑。同时在看这个的过程中,也确实能够直观地感受到 AI 可能会带来的影响。 1、论文把工作粗略分成了两类。一类是认知型工作,包括管理、专业人士、销售、办公室工作这些,程序员、律师、研究人员基本都在里面。 另一类是其他工作,比如建筑、电工、运输、现场服务这些。 他们先假设,2030 年以前 AI 主要直接影响第一类工作,暂时不考虑机器人快速进入体力工作的情况。 所以后面论文里讨论 AI 对工作的冲击,核心讨论的其实都是今天这些知识工作和办公室工作。 2、论文设计了三种情景,温和、显著和极端。 温和情景下,AI 的发展和普及都比较慢。到 2030 年,GDP 只比没有 AI 的情况高 1.6%。显著情景下,AI 已经成为比互联网影响更大的新技术。 到 2030 年,GDP 比没有 AI 的情况高 8.3%。极端情景下,AI 开��大规模完成原来由人做的认知工作。到 2030 年,GDP 比没有 AI 的情况高 32.4%。 注意,这三个数字不是作者对 2030 年的预测。他们也没有说哪一种情况概率最高。这些都是假设。 3、AI 对工作的影响,主要有两种情况。一种是 AI 帮人提高效率。比如程序员、律师、销售用了 AI,同样时间能完成更多工作,人还留在原来的岗位里。 另一种是 AI 已经可以独立把任务做完。这个时候,人开始退出,原来支付给人的那部分工资,会更多转到模型、算力这些资本上。 4、论文认为,AI 对就业和收入分配影响最大的变量是自动化比例。AI 参与的任务越多,其中由 AI 独立完成的比例越高,人需要参与的工作就越少,收入也会更多流向资本。 拿刚刚提到的显著情景来说。到 2030 年,AI 能影响整个经济大约 30% 的任务,但真正部署到工作里的只有 40%。 算下来,大概有 12% 的经济任务真正用上了 AI,相当于今天认知工作任务的五分之一左右。 更关键的是,这些已经用上 AI 的任��里,四分之三都已经可以由 AI 独立完成,只有四分之一还是 AI 辅助人。 这种情况下,AI 会让这些任务的生产率提高大约 57%。整个经济也明显加速,到 2030 年,GDP 比没有 AI 时高 8.3%,当年的经济增速达到 5.4%。 这个增长速度已经很快了。1999 年美国互联网最繁荣的时候,实际 GDP 增速也只有 4.7%。 5、但经济增长以后,这些新增收入并不会平均落到劳动者和资本身上。 显著情景下,到 2030 年,GDP 比没有 AI 的情况高 8.3%,平均工资却只高 2.1%。 再拆开看,差别更明显。认知型工作的工资反而低了 0.3%,其他职业工资高了 5.9%。所有劳动者加起来拿到的总收入,只比没有 AI 时高 1.4%,但资本收入却高了 18.9%。 原因就在前面讲的自动化。 这个情景里,已经用上 AI 的任务中,有四分之三可以由 AI 独立完成。 原来需要支付工资给人完成的一部分工作,开始交给模型、算力和其他资本完成,对应的收入也更多流向资本。 所以虽然整个经济增长了 8.3%,劳动收入占 GDP 的比例却从 60% 降到了 56.1%,资���收入占比从 40% 升到了 43.9%。 这也是论文一个很重要的结论。AI 可以让整个经济增长得很快,但 GDP 增长多少,和普通劳动者的收入增长多少,是两回事。 6、再具体一点,假设原来的 GDP 是 100,劳动者拿其中的 60。现在 GDP 增长到 132,但劳动者只能拿其中的 45%。 132 乘以 45%,还是差不多 60。 也就是说,整个经济大了三分之一,但所有劳动者加起来拿到的总收入几乎没增加。新增出来的这部分收入,基本都去了资本端(AI 公司)。 7、AI 还会重新抬高那些暂时无法被替代的工作的价值。 极端情景下,认知型工作的工资比没有 AI 时低 11.5%,其他职业的工资却高出 33.6%。 背后的逻辑是,AI 把大量认知任务的成本降了下来,整个经济的产出也随之快速增加。 但经济要多生产这么多东西,依然需要建筑、电工、运输、现场服务这些 AI 暂时完成不了的工作。 于是一个很有意思的变化出现了。 认知工作这边,AI 可以直接补充供给,企业对人的需求下降,工资受到压制。 其他工作这边,AI 暂时补不上,但整个经济扩张以后,对这些工作的需求反而增加。即使一部分认知工作者转过去,也未必能完���补上新增需求,所以工资会上涨。 这也是为什么 AI 越强,不同职业的工资不一定一起上涨或者一起下降。 越容易被 AI 完成的工作,人的价值越容易受到压制;越难被 AI 接手的工作,反而可能因为整个经济增长而变得更值钱。 8、前面说了,AI 会减少一部分认知工作的需求,同时整个经济增长,又会增加建筑、电工、运输、现场服务这些工作的需求。 问题是,人没法跟着岗位变化立刻完成转行。 论文举了一个很形象的例子。一个软件工程师失去工作以后,很难马上转去做电工。换一个行业,需要重新学习,需要寻找岗位,过去积累的很多经验也未必还能直接用。 当然不一定是电工,也可以是保险经理等等服务行业的工作。 所以即使整个经济里还有新的工作机会,中间依然可能出现失业。AI 接管旧工作的速度越快,劳动者转换职业的速度越慢,这批暂时找不到新工作的人就会越多。 9、同样一次 AI 冲击,最后可能表现成两种结果,一种是降薪,一种是失业。 论文专门做了一个对比。AI 的能力、自动化程度都保持不变,只看企业在用人变少以后,工资能不能跟着下降。 如果工资可以快速下降,企业会继续保留���多人。结果是,认知工作者的工资比没有 AI 时低 42.2%,但失业率只有 2.6%。 如果工资很难下降,企业需要的人已经变少了,工资却降不下来,那最后只能少招人、裁更多人。 这个情况下,认知工作者的工资甚至还能比没有 AI 时高 2.8%,但失业率会升到 24%。 所以 AI 减少用工需求以后,结果不一定只表现成失业。工资越容易下降,更多影响会落在收入上。工资越难下降,更多影响就会落在就业上。 10、还有一个我觉得很有启发的概念,叫 so-so automation,可以理解成收益不高的自动化。 比如以前一个人完成某项工作需要花 100 块钱,现在 AI 可以把任务接过去,成本变成 95。 对公司来说,人确实可以不用了。但从整个社会来看,这项技术其实只创造了 5 块钱的效率提升。 原来支付给劳动者的那一大块收入,却已经随着任务一起转到了资本端。这种 AI 会替代很多工作,但整个社会并没有因此多创造多少财富。 11、AI 越能独立完成工作,企业就越需要更多算力来承接这些任务。 如果算力供给能快速跟上,企业需要更多算力,市场也能及时增加,价格就不会被明显推高。这样一来,资��因为稀缺拿走的收益不会太多,劳动者也能通过工资分到更多。 如果算力供给跟不上,情况就反过来了。所有公司都在争抢有限的算力和设备,需求越高,价格就越容易上涨,更多收益也会流向资本所有者,留给工资的部分自然就会减少。 当然,这个模型也做了很多简化。它把算力这些都放进了一个统一的资本项里,没有单独去算模型价格、推理成本持续下降这些变化。现实里,这些因素可能会缓解一部分资本稀缺。 但如果未来模型的长程任务能力已经非常强,AI 真正开始大规模接手工作,那接下来一个很现实的问题就是,有没有足够多的算力、数据中心和电力,把这些能力真正跑起来。 到那个阶段,算力供给很可能会成为一个重要瓶颈。 12、不过即便在最极端的情况下,AI 创造的新增收益,依然远远高于认知工作者损失的收入。 论文算下来,整个经济增加的收益,大约是认知工作者收入损失的三倍。 理论上,只要拿出相当于 GDP 9% 的收入,就可以让受影响的认知工作者维持原来的收入水平。而剩下的人,整体收入依然能比没有 AI 时高 20% 以上。 所以真正麻烦的地方,可能不是 AI 创造的财富不够多,而是这些财富最后怎么分。 论文也专门提到,过去无论是技术变革还是贸易冲击,受益的人很少会主动补偿那些受到���击的人。 AI 如果真的走到极端情景,最后要解决的可能就是这个问题,怎么让那些被 AI 替代、降薪的人,也能分到 AI 创造出来的增长。 13、AI 加速科学研究这条路径,在 2030 年以前反而没有贡献特别多的经济增长。 即使在极端情景里,AI 确实可以帮助科研,但很多研究最终还受到实验、物理世界这些环节限制。 所以他们算下来,通过加速科研带来的额外劳动生产率提升,在三种情景里都不到 1%。 当然作者自己也承认,这部分模型没有把 AI 帮助 AI 研究之后的递归反馈完整算进去,所以这个结果很可能偏保守。 挺有意思,推荐大家去看看。Anthropic 官方还做了一个漂亮的解析网页,论文链接我放评论区了。
Lihat Selengkapnya
hexsecurity
@hexsecurity
2 hari yang lalu
最近天天吹Jev,也不知道能代替全浏览器吗?能阻止浏览器的防爬虫检测吗?
SuSu_酥酥👅
@NFT_Chen
2 hari yang lalu
🔥推荐!让 Codex 搭配 Jev 成双王炸,浏览器操作速度提升 5–10 倍! 痛点很简单:Codex 自己点页面时,每一步都要读 DOM、推理、再调工具,来回一卡就是半天。 现在让 Jev 把「点、跳、切、滚」抢走,Codex 只负责想、输入、看图验收。 主要亮点: 🔹Jev 连续跑动作,Codex 只在需要打字/看图时接手 🔹少一轮模型往返,就少一截延迟和用量 操作步骤: 1️⃣准备 Codex(带浏览器/CUA)+ Node.js 22+ + TypeSafe API Key 2️⃣装 Skill:把仓库交给 Codex,或跑 npm run install:codex -- --env-file .env 3️⃣加载 jev-use,让 Jev 接管点击/跳转/滚动 4️⃣需要判断或输入时交回 Codex,处理完 Jev 接着跑 5️⃣用真实产品页/自动化测试验收,别盯着它慢慢点 独立开发、天天跑页面测试的,值得试一把。 已开源 Skill:https://t.co/KI1B4lja2I #AI工具 #Codex #Jev #开源项目 #浏览器自动化 #独立开发 #agentskill #GPT6ComputerUse
Lihat Selengkapnya
hexsecurity
@hexsecurity
2 hari yang lalu
Migrate Your MCP Server to the 2026-07-28 Spec: https://t.co/fd1ETtoqad
泊舟
@bozhou_ai
2 hari yang lalu
做一个商业化软件,最麻烦的,我觉得就是管理后台的配置、运营模块太复杂了 我现在的处理方式是,直接重构成一个为AI而做的运营后台,将大部分配置接口全部预留出来,做成一个CLI,然后加一个Skill。为了保证安全性,我做了三重防护。 一是有一个登录的认证,并且有时效性,只有超级管理员能够使用这个 CLI 进行���作。 二是所有增改查操作,在执行之前都要获得批准。 三是一些敏感操作,比如修改用户数据,会有一个专门的审核入口,里面会有 AI 提交的修改原因,只有批准以后才会生效。
hexsecurity
di-retweet
宝玉
@dotey
4 bulan yang lalu
https://t.co/lAEXOJD7uW
hexsecurity
di-retweet
宝玉
@dotey
3 hari yang lalu
Jason Wei 在 Stanford AI Club 做了一场约 30 分钟的演讲,围绕三个他认为理解 2025 年 AI 格局最基本的思维框架展开。Jason Wei 目前在 Meta Superintelligence Labs 做研究,此前在 OpenAI 参与创建了 o1 和 Deep Research,更早在 Google Brain 推动了 chain-of-thought prompting 和 instruction tuning 的研究,累计被引超过 9 万次。 一、智能正在变成大宗商品 他把 AI 的进步分成两个阶段:第一阶段是推前沿,模型还做不好某件事,你在解锁新能力;第二阶段是一旦能力达成,它就会迅速被商品化。用 MMLU 基准测试的数据看,每一年达到同等智能水平所需的花费都在下降,这个趋势在他看来还会持续,核心原因是深度学习历史上第一次"自适应计算"真正跑通了。过去不管问题多简单多难,推理用的算力是固定的;现在从 o1 开始,模型可以根据问题难度动态调整推理时的算力投入,这意味着简单任务的成本可以被���到极低。 另一个维度是获取公开信息的时间。他画了一条时间线:从前互联网时代到互联网时代、聊天机器人时代、再到 AI 智能体时代,找到一条信息所需的时间在指数级缩短。他举了一个例子——"1983 年韩国釜山有多少对夫妇结婚?"——o3 回答不了这个问题,但 OpenAI Operator 可以,因为它能打开韩国统计数据库 KOSIS,一路点击操作直到查到答案。OpenAI 内部用一个叫 BrowseComp 的基准来衡量这种"知道答案就秒验证,但找答案极耗时"的任务,人类平均每题花两小时以上,很多题根本做不出来,而 Deep Research 能解决大约一半。 这个趋势带来几个推论:过去靠知识门槛建立壁垒的领域会被民主化,vibe coding 和个人健康管理是典型例子;公开信息近乎免费之后,私有内部信息的相对价值反而上升了——比如你知道哪些房子没上市但可以卖,这种信息会更值钱;最终每个人将拥有一个"个性化互联网",想知道什么就有一个为你定制的页面呈现给你。 二、验证者定律:能衡量的就能被 AI 攻克 第二个框架是他所说的"验证不对称性"。有些任务,生成一个解比验证一个解难得多——数独是经典例子,写出能跑 Twitter 的代码需要大量工程师,但验证它能不能用只要打开网页点几下。另一些任务则相反:写一篇看起来有道理的事实性文章很快,但逐句核实极其费时;宣称"最好的饮食是只吃野牛肉"只花 10 秒,但验证这个说法需要大样本和长期跟踪。 他在一个二维平面上把这些任务画出来:X 轴是生成难度,Y 轴是验证难度。关键洞察是,你可以通过提供"特权信息"来改变任务在这个平面上的位置——竞赛数学题如果给了答案就秒验证,写代码如果给了测试用例(像 SWE-bench 那样)验证也变得简单。 由此他提出了 Verifier's Law:AI 训练出来在某个任务上的能力,基本上与该任务的可验证程度成正比。具体来说,可验证性取决于五个因素:是否有客观正确答案、验证速度多快、能否大规模并行验证、噪声大不大、以及奖励信号是连续的还是二元的。几乎所有 AI benchmark 本身就是因为容易验证才被设计出来的,而这些 benchmark 确实在过去几年被逐一攻破,这恰好是 Verifier's Law 的实例。 他特别推荐了 DeepMind 的 AlphaEvolve 作为利用验证不对称性的范例。AlphaEvolve 挑选满足上述五个条件的问题——比如找到 11 个六边形的最优排列使外接六边形最小——然后用大语言模型采样大量候选解,自动评分,把最优解作为下一轮采样的灵感,不断迭代。关键技巧在于它绕过了泛化问题:训练集和测试集是同一道题,你就是想知道这一道题的最优解。 这个框架的实际推论是:最先被自动化的任务一定是验证成本最低的任务;而一个正在崛起的创业方向是——发明新的衡量方法,把原本难以验证的任务变得可验证,从而让 AI 去优化它。 三、智能的锯齿状边缘 对于"AI 将如何改变世界"这个问题,他看到的观点光谱极广。他的一个量化交易员朋友觉得 ChatGPT 跟自己工作无关,而他在顶级实验室的同事则认为再过两三年 AI 就会取代他们自己的工作。 他明确反对"快速起飞"假说——即一旦 AI 跨过某个临界点就会突然变成超级智能。他的理由是,AI 的自我改进不是一个二元开关,而是一个渐进光谱:从跑不起来代码,到能训练但结果一般,到能自主训练但不如顶尖研究者,再到偶尔还需要人工干预。更重要的是,自我改进的速度应该按���务来看。AI 的能力图谱是一条锯齿���:在某些任务上已经达到山峰(竞赛数学、部分编程),但在另一些任务上仍是低谷(比如 ChatGPT 曾长期认为 9.11 大于 9.9,或者说一门只有几百人会的原住民语言 Tlingit)。 他给出了判断 AI 在某个任务上进步速度的三条启发式规则。第一,AI 擅长数字化任务,核心原因是迭代速度——数字环境可以轻松扩展算力,而物理机器人的实验扩展成本高得多。第二,人类觉得容易的任务 AI 也往往容易,但有一类例外是"人类因生理限制做不到但 AI 可以做到"的任务,比如读过一千万张乳腺影像后发现某个人类注意力无法捕捉的模式来预测乳腺癌。第三,数据充足的任务 AI 表现好——数学推理在不同语言上的表现和该语言的训练数据量高度相关;而如果一个任务有单一客观指标,就可以通过强化学习生成合成数据来突破数据瓶颈,AlphaEvolve 和 AlphaZero 都是这个路线。 ��用一张表把这些启发式规则应用到具体任务上:主流语言翻译已经完成;调试基础代码 2023 年搞定;竞赛数学 2024 年搞定;AI 研究本身大概 2027 年;化学研究因为不是纯数字任务会更晚;拍电影大概 2029 年;修水管和理发因为高度物理化,短期内不太可能;乌兹别克传统地毯编织需要一组人花一个月、非数字化且缺数据,AI 不太可能碰到;至于"带女朋友约会让她满意"——他的判断是"impossible,非数字化,缺数据",人类还能保住饭碗。 https://t.co/CIbwKE5n3X
Lihat Selengkapnya
dotey's tweet video.
hexsecurity
di-retweet
iGeekbb
@igeekbb
3 hari yang lalu
当你发现自己是房间里最富的人,别犹豫,赶紧走。
hexsecurity
di-retweet
Ming
@PandaMing88
3 hari yang lalu
广州一家企业给销售团队上 AI 助手。 系统能自动整理客户资料、提醒跟进,还能生成拜访建议。 上线两个月后,日活不到 30%。 老板第一反应:系统不好用。 后来 FDE 跟着销售跑了几天,才发现老销售根本不愿把客户资料完整录进去。 原因很直接:“客户是我十年攒的,我全录进去,公司换个人也能接。” 年轻销售愿意用,但经理开会还是让大家交 Excel。 AI 没坏。 人的利��、习惯、权力结构都没动。 这也是 FDE 真正难的地方。 模型可以调,流程可以改。 人的算盘,一般都比较难调。
hexsecurity
di-retweet
金尘马
@jinchenma_ai
3 hari yang lalu
这段时间,看了不少大佬的分享以及和正在做fde的朋友沟通。 得到了FDE三不做: 1.不是一把手牵头不做 2.甲方没预算不做,连咨询费都不想出说明没有转型决心 3.上来就要用Agent去实现裁员的不做,进不去,活着出不来
hexsecurity
di-retweet
AYi
@AYi_AInotes
4 hari yang lalu
腾讯有点牛逼啊,他们刚开源的 BrowserSkill,把做浏览器 Agent 最恶心的一道坎给做穿了:不再给 AI 开一个干干净净的空白浏览器,而是直接借你正在用的标签页,干完活再还给你(MIT 协议,全本地)。 对天天用 Cursor、Claude Code 写代码的人来说,这个工具值得先翻一遍,省得自己在浏览器自动化上反复踩坑。 以前所有工具的思路,都是在后台偷偷起一个没有 Cookie、没有登录记录的虚拟���盒。 看似安全干净,结果一进真实业务,全卡在登录墙和验证码前面。 BrowserSkill 的逻辑变了:既然你人就坐在屏幕前,为什么不直接让你给它开个门。 1️⃣ 标签页即借即还 原来的麻烦是,想让 AI 去内网系统查条数据,你得把 Cookie、Token、请求头从头配置一遍,过期了又得重来; 现在的机制是,它通过底层接口直接挂进你现有浏览器的一个打开窗口,你在哪登录着它就在哪干活; 干完该退的步骤自动退掉,把标签页完整交还给你,既不用在本地存明文密码,也不用重新走一遍繁琐的鉴权。 2️⃣ 人机验证当场回弹 以前是让爬虫去硬解滑块验证码,解不开就全流程崩溃; 现在变成了关键节点人类介入,一碰到双重验证或安全弹窗,窗口直接浮现给你,你花两秒点完确认,模型立刻接手后面的长链路; 比较克制的一点是,AI 每次借标签页之前必须弹窗向你确认,而且这个总开关焊死在你的浏览器原生设置里,不是运行时的命令行参数,模型再怎么产生幻觉,也没法靠提示词把自己偷摸放出来。 3️⃣ 做成 CLI 而不是 MCP 这是全篇最聪明的一步。 现在大家都扎堆做臃肿的 MCP 服务,结果各个客户端支持程度参差不齐; 腾讯直接把它做成了一个纯粹的命令行工具,只要你的 Agent 能在终端里跑 Shell,不管是 Cursor 还是本地脚本,调一行指令就能把浏览器拉起来,每一条执行逻辑在终端日志里看得清清楚楚。 大模型解析网页代码的能力已经足够过剩, 但真正卡住自动化的,从来不是模型读不读得懂 HTML,而是它跟人类真实工作软件之间的那道信任边界。 选自动化工具时��看它怎么在权限和效率之间留出安全断点,可能比看它声称能全自动做多少事重要得多。
Lihat Selengkapnya
Pengguna Terakhir Terlihat di Sotwe
Phim Gây Việt
Dilihat dari
Vietnam
BBC♠️SMsissy
Dilihat dari
United States
EVG
Dilihat dari
Turkey
Steelkarma🇮🇹🏳️🌈☮️🎸
Dilihat dari
Switzerland
Dylan Kingswood
Dilihat dari
United States
不吃鲨鱼吃辣椒
Dilihat dari
Vietnam
Any 🪐
Dilihat dari
United States
story tiktok
Dilihat dari
Indonesia
outdoor✊💦
Dilihat dari
Thailand
지은
Dilihat dari
Korea
Tren untuk Anda
1
Sunderland
Di bawah 10 ribu tweet
2
Good Sunday
Di bawah 10 ribu tweet
3
Wirtz
Di bawah 10 ribu tweet
4
Isak
Di bawah 10 ribu tweet
5
#AskFFT
Di bawah 10 ribu tweet
6
Blaney
Di bawah 10 ribu tweet
7
Jacquet
Di bawah 10 ribu tweet
8
Yom Kippur
Di bawah 10 ribu tweet
9
Valverde
Di bawah 10 ribu tweet
10
Moscow
Di bawah 10 ribu tweet
Pengguna Paling Populer
1
Elon Musk
@elonmusk
241.7M pengikut
2
Barack Obama
@barackobama
119M pengikut
3
Cristiano Ronaldo
@cristiano
114.3M pengikut
4
Donald J. Trump
@realdonaldtrump
111.8M pengikut
5
Narendra Modi
@narendramodi
107.2M pengikut
6
Rihanna
@rihanna
98.7M pengikut
7
NASA
@nasa
92.4M pengikut
8
Justin Bieber
@justinbieber
91.8M pengikut
9
KATY PERRY
@katyperry
89.9M pengikut
10
Taylor Swift
@taylorswift13
83.9M pengikut
11
Lady Gaga
@ladygaga
75.4M pengikut
12
Virat Kohli
@imvkohli
73.3M pengikut
13
Kim Kardashian
@kimkardashian
70.9M pengikut
14
YouTube
@youtube
68.8M pengikut
15
Neymar Jr
@neymarjr
66.3M pengikut
16
Bill Gates
@billgates
65.1M pengikut
17
Selena Gomez
@selenagomez
63M pengikut
18
The Ellen Show
@theellenshow
62.3M pengikut
19
CNN
@cnn
61.8M pengikut
20
X
@x
60.7M pengikut
Olivia
Online
✨
⭐
💫