Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
西厢记
@hunterhellowd
名人 影視 國際 政治 情色 探索精神和肉体的完美融合 酒精和高潮通往体验神秘的神的国度 三人行寻觅有趣灵魂 FFM MMF VOYEUR 最爱双性恋女子
Los Angeles, CA
Joined February 2017
339
Following
335
Followers
567
Posts
西厢记
@hunterhellowd
2 months ago
在这样的风景之中谁会不期待一次在窗前的狂野之爱呢?当她坐在沙发边吮吸我,我看着她迷离的双眼。当她跪在沙发上将神秘的隐私湿润地暴露给我,吸引着我的坚硬之物长驱直入。而她的闺蜜,正喝着葡萄酒在沙发边盯着我们结合处,咬着香唇带着微笑呼吸急促地并紧了双腿。她等待着我喷射而出的时候......
西厢记
@hunterhellowd
6 months ago
future
yibie
@yibie
6 months ago
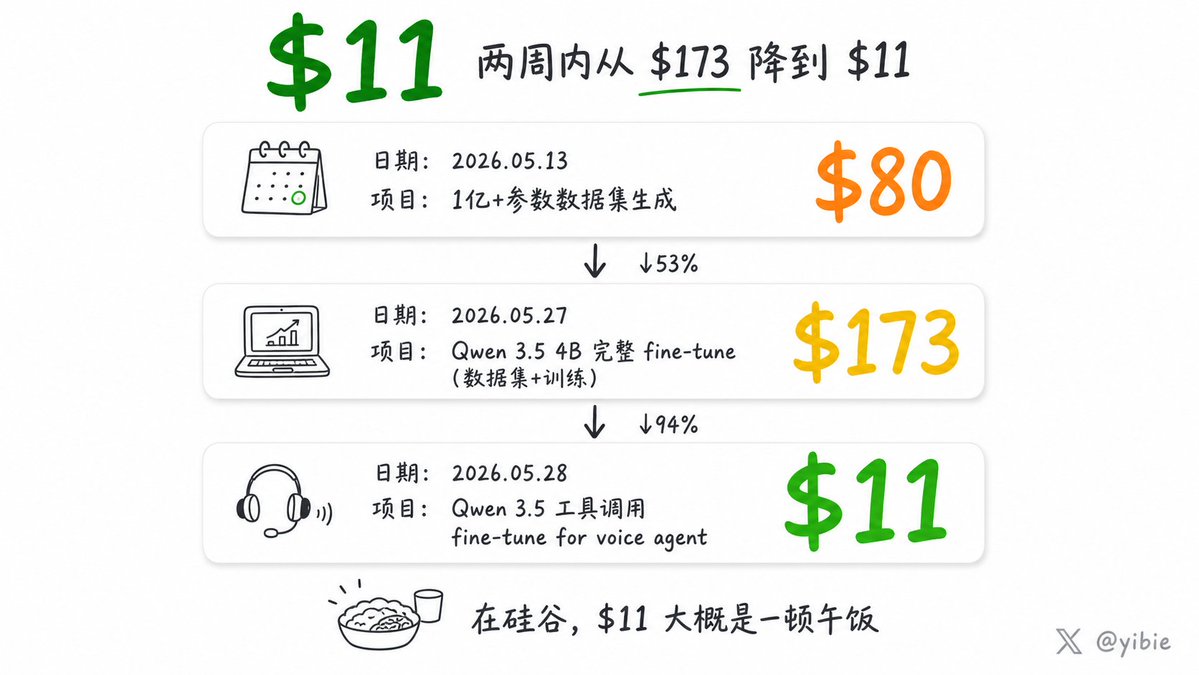
训练小模型:2026 年最被低估的 AI 技能 2026 年 5 月 11 日,一个叫 CJ Zafir 的人发了一条推文。他想教普通人 fine-tune 开源模型。 2538 个赞,316 次转发,178,000 次观看。这条推文炸了。不是因为他发明了什么��东西——Unsloth 早在 2023 年就开源了,Hugging Face 上的 fine-tuning 教程有几百篇。炸了是因为他在一个所有 AI 公司都在比赛造「更大模型」的时候,反手指向了完全相反的方向:小模型。你自己训练的。在 Colab 上。花几十美元。 两个月过去了。CJ 没有停。 他把这条推文变成了一套完整的方法论:Codex 5.5 做大脑规划工作流,DeepSeek v4 Pro 做肌肉批量生成数据,Unsloth 做训练引擎,Qwen 3.5 4B 做基座模型。然后他用这套方法论,花了 $173 训练出一个 4B 模型,在垂直任务上精度 96%+,击败了 20 倍大的模型。 再后来他做了个 voice agent 的工具调用 fine-tune——成本 $11。 从 $80 到 $173 到 $11。这不是渐进式优化。这是在重���整个 AI 部署的经济学。 一、CJ 方法论:为什么值得认真对待 CJ 不是第一个倡导 fine-tuning 的人。但他做对了一件事:他把整个流程的成本打到了个人开发者可以承受的水平,并且公开了每一步。 工具链 | 角色 | 工具 | 成本 | |------|------|------| | 规划(Orchestrator) | Codex 5.5 | 订阅内 | | 数据生成(Generator) | DeepSeek v4 Pro | API 按量 | | 训练框架 | Unsloth | 免费开源 | | 训练硬件 | Google Colab Pro A100 80GB | ~$0.60/hr | | 推理部署 | llama.cpp / Ollama | 免费 | 数据流水线 CJ 最核心的洞察不是「用什么工具」,而是「怎么造数据」: 「"Low quality data = Low quality model performance"」 他的流水线是自进化的:Codex 设计工作流 → DeepSeek 批量生成数据行 → 每批次过 Quality Gates → Codex 根据上一批结果优化生成规��。结果是越跑越快、越便宜、质量越高。 $80 生成了 1 亿+参数的高质量数据集。 不是简单 paraphrase,是「手工打造」每一行——Codex 设计的多样化 prompt 模板 + DeepSeek 的高速执行 + 可编程的质量门槛。 模型选择 CJ 实测了 Gemma 4 和 Qwen 3.5 全系列后,结论很明确: 「Qwen 3.5 9B 和 4B 是垂直训练的完美基座模型。Gemma 4 在垂直任务上不及 Qwen 3.5。」 他的 Qwen 3.5 4B fine-tune 在精度和延迟上击败了 20 倍大的模型。不是什么小众 benchmark——是他自己在垂直任务上实测的结果。 二、这不是 CJ 一个人的实验——行业数据在同时发声 CJ 的方法论看起来像「个人黑客技巧」,但独立的数据正在从各个方向验证同一个趋势。 市场规模 SLM(Small Language Model,1B-13B 参数)市场 2024 年达到 65 亿美元,年复合增长率 25.7%。SLM 在大多数企业任务上���经匹配或超过 GPT-3.5 级别性能,只需一小部分成本。 性能 阿里巴巴的 Qwen 3.5 9B 在 MMLU-Pro、GPQA Diamond 和 multilingual MMMLU 三个基准上击败了 OpenAI 的 gpt-oss-120B——13 倍参数差距,小模型胜。 另一项独立的 brand normalization 案例中,一个小模型达到了 90.6% 准确率,超越了 GPT-5.2 和 Gemini 3 Pro。 企业已经在省钱——真正的省钱 | 公司 | 方案 | 效果 | |------|------|------| | Knowunity | 用 Distil Labs fine-tune SLM | 推理成本降 68% | | 某客服 agent | 从通用大模型切换到 fine-tuned SLM | 月成本从 $13,000 降到 $400 | | EliseAI | 专门训练的垂直小模型用于住房和医疗 | 推理成本降 60%,延迟降 80% | | AT&T | 专用 SLM 做客服和欺诈检测 | 数百万美元节省 | 400 美元一个月。一个客服 agent。这是几个工程师的年收入可以覆盖无限次 API 调用的部署方案。 三、「数据集工厂」才是真正的护城河 CJ 在 5 月 22 日发了一条推文,八个词: 「"The moat might not be the fine-tune itself. It might be the dataset factory."」 这是整个小模型运动最重要的洞察。Fine-tuning 技能本身正在被民主化——Unsloth 已经能在 3GB VRAM 上训练,Colab 免费提供 GPU,CJ 连 prompt 模板都公开了。当人人都能做 fine-tune 的时候,差异化从「会不会做」转移到了「数据从哪里来」。 中文社区的 AKIRAXCLAW 在一篇分析里补了一个关键观察: 「「CJ 的工作流在 2026 年多数是业界共识,但真正难点不是工具——而是你有没有 200 笔干净数据 + 自动评估脚本。」」 在 CJ 的体系里,Codex 的核心角色是 orchestrator,不是因为它比 DeepSeek 聪明,而是因为它能设计数据流水线、构建 Quality Gates、自进化优化生成规格——它在管理数据生产的质量系统���而不仅仅是生产数据。 四、从边缘到生产线:部署已经在发生 SLM fine-tune 的部署门槛已经降到消费级硬件。Unsloth 2.0 支持 GGUF 量化导出 + llama.cpp / Ollama 部署。一个 3B 参数量化到 INT4 后占用 1.5-2GB 内存,可以在树莓派 5 上运行。Qwen 3-0.6B 在 Pixel 8 和 iPhone 15 Pro 上实现约 40 tokens/s 推理。 2024 年你可能需要一台 A100 才能跑 fine-tune。2026 年你可以在 Colab 上训练、在手机上推理。这种从「数据中心才能碰」到「个人设备上运行」的变化,是 Platform Shift 级别的。 而 NVIDIA 在推动的「Data Flywheel Blueprint」——用生产流量持续生成训练数据,自动 fine-tune,自动部署——正在把这个流程变成企业基础设施。NVInfo AI 用这个方案在三个月内把内部知识助手的质量提升到覆盖 30,000 名员工。 五、成本轨迹:从「公司预算」到「午饭钱」 CJ 的公开成本记录是最好的注脚: | 日期 | 项目 | 成本 | |------|------|------| | 05-13 | 1 亿+参数数据集生成 | ~$80 | | 05-27 | Qwen 3.5 4B 完整 fine-tune | ~$173 | | 05-28 | Qwen 3.5 tool calling for voice agent | $11 | $11。这在硅谷大概是一顿午饭。在印度、东南亚、非洲,是一个独立开发者完全负担得起的预算。fine-tune 已经从「大公司才有资格做的研发项目」变成了「个人开发者用午休时间能完成的 side project」。 六、结论:学会训练你的第一个模型 CJ 给的学习路线图异常简单: 1. 从 1B-4B 小模型开始,不要一上来就搞大模型 2. 用 Colab Pro(A100 ≈ $0.60/hr),不要急着买 GPU 3. 先 fine-tune 7-10 个模型积累经验(SFT → LoRA/QLoRA → GRPO/DPO) 4. 用 Codex 做规划,DeepSeek 做数据生成 5. 理解量化(GGUF)、本地推理(llama.cpp)、KV 缓存 他甚至在 5 月 23 日直接发布了一个「复制粘贴就能��」的 prompt——把整个学习路径封装成一段对话,扔进 Codex 或 ChatGPT,让 AI 带你从 beginner 到 advanced。 这就是 2026 年 AI 技能民主化的真实面貌:不是每个人都需要学会训练模型。但学会训练小模型的人,不再需要 10 人团队和 10 万美元预算。 通用大模型的军备竞赛还在继续。GPT-5、Claude Opus 5、Gemini 3 会越来越强。但越来越多的真实场景正在证明:一个花了 $173 训练的 4B 小模型,在你自己的数据上,比你花 $200/月订阅的通用大模型更好用。不是因为小模型更聪明。是因为它只做了你需要的那一件事。 参考来源:CJ Zafir X 推文系列 (2026.05.11-05.28);AKIRAXCLAW 中文分析;Alibaba Qwen 3.5 benchmark (VentureBeat);Unsloth 2.0 文档;NVIDIA Data Flywheel Blueprint;AT&T / EliseAI / Knowunity / https://t.co/7r0fApoHPJ 企业案例;Manicode / Arendil 独立 benchmark;SLM Market Report 2024-2026
See More
西厢记
@hunterhellowd
6 months ago
Useful skills
Mr. Buzzoni
@Mr_Buzzoni
6 months ago
https://t.co/E8GJ7yfZEM
西厢记
@hunterhellowd
9 months ago
真不错 一学就会很好用的一篇入门
阿川 | AI thinking
@AI_jacksaku
9 months ago
https://t.co/AqOk2mYX1l
Who to follow
雪美 えみる(結夜)恵比寿マスカッツ
@yui1122ribbon
初めまして❁*⋆ฺ。*ティーパワーズ所属女優 #初代恵比寿マスカッツ 7期生(結夜) @iroha_PR 公式アンバサダー (iroha部2期生)✩雑誌 #anan 付録付きDVD(愛とSEX)に出演💓
Kaar Investments
@kaarinvestments
Stocks & Sports Zealot!
三藏大法师
@wangchao0215
坐标北京 不爱墨迹 喜欢风骚的
西厢记
@hunterhellowd
9 months ago
@daqian474
@meirisheying
@BBBBTTTCC
@SexytoDoll
@SexytoGirl
@SexytoBaby
@GetXBot
西厢记
@hunterhellowd
10 months ago
@meijiangAI
@grok
整理好发我
西厢记
@hunterhellowd
10 months ago
@YouTuPreneur gemini
西厢记
@hunterhellowd
10 months ago
@Merkle3sCapital
Crypto and AI are best buddies in the future. They all based on tokens and supplied by power.
西厢记
@hunterhellowd
11 months ago
@eriktorenberg
@grok
西厢记
@hunterhellowd
12 months ago
午后的时光总是容易勃起,在办公室看着女同事想着被口交并射精给她吃,不自觉就想要在半梦半醒中射出
西厢记
@hunterhellowd
about 1 year ago
风险在累积
Rocky
@Rocky_Bitcoin
about 1 year ago
今天对冲基金巨头Citadel掌门人Kenneth Griffin访谈的警告,意味深长!🧐 他说:尽管当前正处于牛市高潮期,但历史经验表明,市场调整往往来得极其迅速,且毫无征兆。 尤其讲到1987年股灾那天,媒体头条其实不是“市场暴跌”,而是“Nancy Reagan 被诊断出乳腺癌”。��外,还有一条“伊朗或伊拉克的小船袭击了美国军舰”的新闻,完全不算什么大事。可那天,美股在没有明显导火索的情况下,一天之内跌掉了将近25%。 重点他提到了 #AI,他承认 #AI 会改变世界,就像当年的个人电脑、互联网一样。问题是,这类变革从来不是线性的。 个人电脑的革命用了五十年才走到今天,互联网也经历了dot-com 泡沫破裂之后的淘汰与重生。今天AI的火爆,确实让人想起2000年那一幕——没人怀疑技术的方向对,但太多人忽视了周期的节奏。 整体来说,这个时间节点,Citadel掌门人的公开警告,要值得重视——市场崩盘从来都不需要一个“完美的理由”。真正的暴跌,往往就是在大家最不相信会跌的时候发生的。🧐
See More
Rocky_Bitcoin's tweet video.
西厢记
@hunterhellowd
about 1 year ago
follow
汉松
@Yonah_x
about 1 year ago
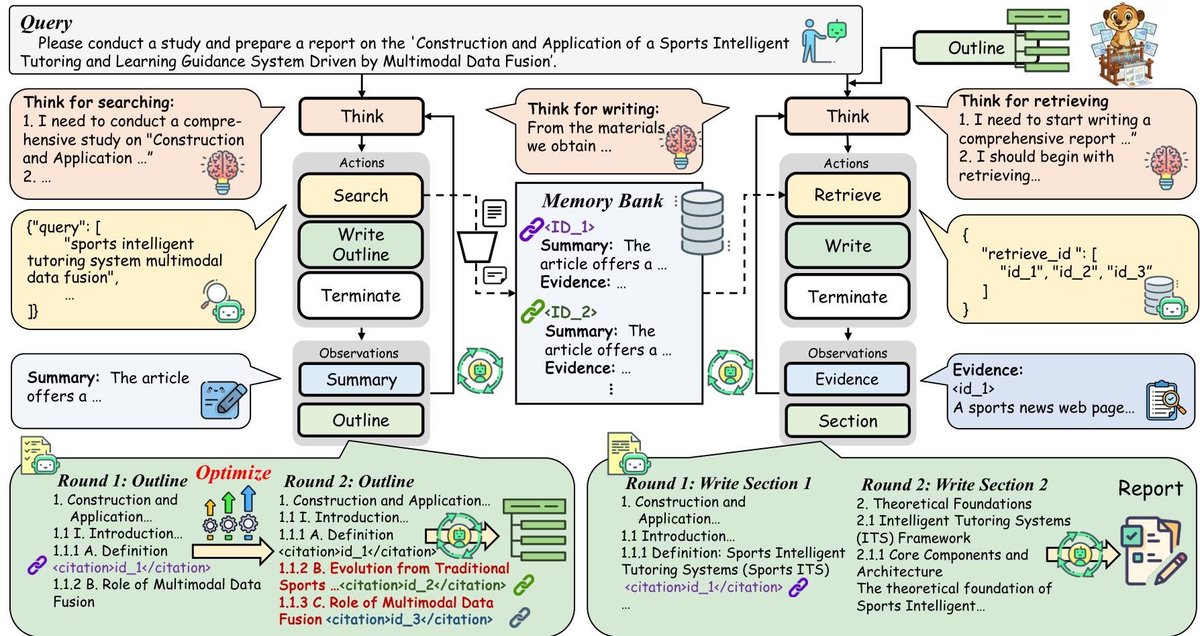
通义发布的 DeepResearch Agent 六篇论文我都看完了,最喜欢的一篇是《WebWeaver》,它压缩上下文的方法非常有启发,所有需要 AI 长文写作的场景都可以参考。 一般让 AI 写长文都是把资料一股脑放到上下文里面,这会导致模型注意力错乱,因为参考的资料太多,上下文太长,模型不可避免会忽略一些重要信息或者被无关信息误导。 WebWeaver 的解法是分而治之,在写作大纲里面放入引用的资料 id,然后让模型一个个章节写,写每个章节的时候都只提供当前这个章节的资料,这样就避免了上下文太长的问题,保护了模型的注意力。 上面的写作过程也是 Agentic 的,不需要硬编码让模型按顺序写,而是直接把整个大纲提供给它,让它自己调用查询资料的工具一步步写出来。这里还有个压缩上下文的技巧是在写最新的章节的时候,把之前的章节的资料都隐藏,只保留写作结果,这样模型既有全局的信息,又能节省上下文。 大纲示例 ``` 1. Hoehn and Yahr Scale Classifications <citation>id_2, id_6, id_9, id_12, id_13, id_14, id_15, id_17, id_20, id_21</citation> ``` 资料查询工具示例 ``` {"name": "retrieve", "arguments": {"url_id": ["id_2", "id_6", "id_9", "id_12", "id_13", "id_14", "id_15", "id_17", "id_20", "id_21"], "goal": "Gather comprehensive information about Hoehn and Yahr scale classifications and disease staging systems for Parkinson’s disease"}} ``` 这种利用查询工具传递 id 的方式来压缩上下文,我在 DeepResearch 的阅读工具里面也用过,主要是用来减少模型生成 url 比较慢的问题,但用在写报告的阶段我确实没想到,对我很有启发。 但这种 Agentic 的方式相比用 Workflow 的方式效果好多少,我是存疑的,因为你让模型自己调用FunctionCall 可能会有幻觉,用代码的方式手动解析大纲然后用 Workflow 的方式可能更可靠。后续我也会做实验对比看看。
See More
西厢记
@hunterhellowd
about 1 year ago
好玩好刺激
西厢记
@hunterhellowd
about 1 year ago
谁能不期望这样被伺候呢
西厢记
@hunterhellowd
about 1 year ago
诱惑满满中午午睡勃起
西厢记
@hunterhellowd
about 1 year ago
I like these suggestions
Inspiration Wiz
@Inspirationwiz
about 1 year ago
Testosterone is what keeps men alive and dominant. Here are 10 real and natural strategies to rebuild your testosterone (save it) 1. Direct sun
西厢记
@hunterhellowd
about 1 year ago
模型能力越来越强是个必然趋势,CoT带来的价值也会让推理更加严谨和靠谱,Chain of Agents 让协同更加全面,如果再优化Memory of Attention,我们利用大模型探索世界本质的能力将得到质的飞跃。 大家期待的通用超级智能是一个Hero形式的幻想,如同人类创造上帝一般。Agent网络中涌现的智能才更加智慧
Dongxi 东锡 NLP
@dongxi_nlp
about 1 year ago
我其实没觉得模型不行。我觉得非常行,一天比一天厉害。 在没有thinking模型的时候,做Agent手写trajectory CoT + GPT-3.5 能解决的问题的准确率就非常高了。 现在满桌子都是好模型,拿起来随手就能打。我想知道到底要解决什么复杂问题,说模型能力不行? 最后,我想说,Manus这种形态是好的Agent形态么?真正好的的Agent是跟SaaS复杂API的结合解决真正的商业问题,而不是在��里规划个旅游路线,编一个投资分析,一键生成PPT等各种垃圾内容。
西厢记
@hunterhellowd
about 1 year ago
I think so
AB Kuai.Dong
@_FORAB
about 1 year ago
·
Minato-ku
Coinbase CEO 表示,正在让团队,每天超 12 小时工作,全力加急推进 Everything Exchange (万物交换)项目。 根据之前电话会议的透��,该功能是把加密货币 + 股票代币 + 衍生品 + 预测市场等,全部集成在一个平台 APP 内,做到 7 x 24 小时,可多资产交易。 也就是华尔街这波,全美金融资产上链。 重大的叙事。 目前市场猜测,这个上线时间点预计在 9、10 月之间,内部有多个小组,正在赛马比拼,高强度办公。 怀疑 Coinbase 最近应该招了不少华人。 面对 Robinhood 的危机感。
西厢记
@hunterhellowd
about 1 year ago
对话很精彩令人勃起有欲望
西厢记
@hunterhellowd
about 1 year ago
我也特别想知道这样玩的感受,有谁能详细给我一些看法和视频的反馈呢?
Last Seen Users on Sotwe
Arap Murat
Seen from
Turkey
红中
Seen from
Vietnam
Hard Sex Kings
Seen from
United States
منسقه مهاء
Seen from
United Kingdom
ManusiaBiasaSaja🥀
Seen from
Indonesia
محمود
Seen from
Egypt
Taron Fuckerton
Seen from
United States
فحل مشعر ملتحي
Seen from
Singapore
DİYARBAKİR PASİF
Seen from
Turkey
kamam
Seen from
Qatar
Trends for you
1
Gane
Under 10K tweets
2
Utah
Under 10K tweets
3
#AEWFullGear
Under 10K tweets
4
Nunes
Under 10K tweets
5
Lane Kiffin
Under 10K tweets
6
Fifita
Under 10K tweets
7
Texas
Under 10K tweets
8
Sark
Under 10K tweets
9
#HookEm
Under 10K tweets
10
Daniel Bray
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
240.8M followers
2
Barack Obama
@barackobama
118.7M followers
3
Cristiano Ronaldo
@cristiano
114.5M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.2M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.4M followers
13
Kim Kardashian
@kimkardashian
70.8M followers
14
YouTube
@youtube
68.7M followers
15
Neymar Jr
@neymarjr
66.4M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.2M followers
19
CNN
@cnn
61.7M followers
20
X
@x
60.6M followers
Olivia
Online
✨
⭐
💫