Fascinante noticia. La primera vez que fui consciente del potencial de la reprogramación celular fue con el trabajo de Sinclair y su equipo (publicado en Nature en 2020): lograron mejorar la visión en ratones haciendo que las células de la retina recuperasen características juveniles, sin convertirlas en células madre.
Oliver Brüstle, en la Universidad de Bonn, aporta ahora otra pieza: transformar células sanguíneas humanas en células madre neurales con una edad epigenética mucho menor. Son avances distintos, pero complementarios.
Todavía hablamos de células en laboratorio, no de rejuvenecer personas, pero aquí es donde la IA puede transferir su avance exponencial a este campo y traernos terapias factibles en humanos antes de lo que creemos.
Vivimos tiempos extraordinarios y fascinantes.
@thsottiaux Ideally 2x weekly usage with 5h ample limits but with 2-3 weekly resets for the 5h window. Or, better, one reset / day of the 5 hour window even if it expires every day and is not cummulative.
Introducing Griffin, the first model to pass the video Turing test.
48% of people who talked to it live thought it was a real human. Previous systems have had a pass rate <3%. It is #1 on NVIDIA's benchmark for full-duplex AI video.
It’s the first Human Interaction Model (HIM).
Si os suena que hay un nuevo modelo llamado Jev, pero aun no tenéis muy claro qué hace y para qué sirve, tal vez este resumen os sea útil.
🧠 1. ¿Qué es Jev?
Jev no es un modelo de lenguaje tradicional (LLM) ni un chatbot conversacional. Sus creadores lo definen como el primer “modelo de Sistema 1” o un modelo generalista de decisión.
A diferencia de los LLM autorregresivos, que generan texto palabra por palabra —token por token—, Jev no genera texto libre.
En vez de eso, Jev procesa todo el contexto en un único pase de inferencia en paralelo y devuelve decisiones estructuradas y probabilidades: clasificaciones, puntuaciones o selecciones entre un conjunto de opciones.
⚡ 2. ¿Por qué es relevante?
Jev no pretende reemplazar a los grandes modelos de razonamiento. Pretende resolver algunos de sus mayores cuellos de botella.
Lo hace sobre tres pilares:
→ VELOCIDAD
Funciona entre 20 y 200 veces más rápido que los modelos tradicionales, con tiempos de respuesta de apenas 100–150 ms.
→ COSTE
Los tokens de salida son gratuitos, ya que no existe generación autorregresiva.
Solo cobra por los tokens de entrada: $0.042 por millón de tokens ($42 por mil millones). Es decir, más de 400 veces más barato que modelos ligeros como Haiku o Luna.
→ SALIDAS ESTRUCTURADAS
Mantiene una tasa de 0% de alucinaciones en formatos de salida estructurados y un 0% de error en llamadas a herramientas, ofreciendo resultados deterministas dentro de las opciones asignadas.
🛠️ 3. ¿Para qué sirve?
Al reducir drásticamente la latencia y el coste, Jev permite utilizar IA en aplicaciones donde antes resultaba demasiado lenta o cara. Estos son algunos de los posibles casos de uso:
1️⃣ Model Routing
Puede evaluar un prompt en milisegundos y decidir a qué LLM —Haiku, Sonnet, Opus, etc.— enviarlo según la complejidad de la tarea.
Resultado: hasta un 70% de reducción del gasto en tokens.
2️⃣ Hojas de cálculo predictivas
Puede clasificar, etiquetar o determinar la urgencia de cientos de filas de datos prácticamente en tiempo real mientras el usuario trabaja.
3️⃣ Calificación instantánea de candidatos y leads
Evalúa las respuestas de un formulario web en ~100 ms y puede decidir inmediatamente si mostrar una agenda de citas, priorizar el lead o filtrar la solicitud.
4️⃣ QA automatizado en CI/CD
Permite ejecutar agentes adversarios que navegan por una interfaz, interactúan con ella y buscan errores antes de publicar cada nueva versión del software, por apenas unos céntimos.
5️⃣ Computer Use
Puede controlar navegadores y aplicaciones web —por ejemplo, buscar y seleccionar vuelos— a velocidades muy superiores a las de los agentes basados exclusivamente en LLM, minimizando además errores en las acciones.
6️⃣ Agentes en tiempo real y videojuegos
Puede tomar decisiones en bucles extremadamente rápidos: por ejemplo, 10 decisiones por segundo para controlar personajes o jugar a videojuegos como Doom o Melee.
❌ 4. ¿Para qué NO sirve?
También es importante entender sus limitaciones:
→ No redacta texto ni mantiene conversaciones.
No es el modelo adecuado para escribir correos, artículos, documentos o resúmenes extensos.
→ No programa software desde cero.
No sustituye a un agente de programación capaz de desarrollar una aplicación completa.
→ No realiza razonamiento profundo paso a paso.
No está diseñado para resolver problemas lógicos o matemáticos complejos mediante largas cadenas de razonamiento.
→ Depende de opciones predefinidas.
Su función es clasificar, puntuar o elegir entre alternativas estructuradas que el desarrollador proporciona.
🌐 5. Alternativas y futuro del mercado
La idea detrás de Jev también está empezando a aparecer en otros proyectos.
→ DiffusionGemma / “DiffusionGemma as Jev”
Una alternativa open source desarrollada por la comunidad que añade capacidad multimodal —visión—, permitiendo tomar decisiones instantáneas sobre lo que el modelo “ve” en pantalla.
→ Routing integrado en los grandes laboratorios
Es razonable esperar que compañías como OpenAI o Anthropic incorporen cada vez más arquitecturas de este tipo para decidir internamente qué modelo debe resolver cada petición.
Y aquí está, para mí, lo realmente interesante de Jev:
No intenta construir otro modelo que “piense más”.
Intenta hacer que millones de decisiones sencillas dejen de necesitar un modelo que piense durante segundos.
Y, lo que me parece realmente potente, es combinar modelos de decisión rápidos como Jev y con modelos de lenguaje y pensamiento profundo como Claude, ChatGPT o Grok. Esta combinación abre infinidad de nuevos casos de uso potenciales.
Anthropic acaba de publicar un PDF de 13 páginas sobre memoria para agentes de IA
5 capas para reducir un 90% el coste en tokens y hacer que tu agente aprenda de verdad👇
1. MEMORIA DE TRABAJO: lo que ve ahora
La ventana de contexto. Todo lo que el agente tiene delante en este momento
Cuando se llena, el contexto antiguo se pierde. La mayoría de los agentes se quedan aquí y luego nos preguntamos por qué fallan
2. MEMORIA EPISÓDICA: lo que pasó
El historial completo de interacciones, con fecha y hora
El agente recuerda que el despliegue falló el martes a las 3 de la mañana porque el script de migración tenía una errata
No tienes que explicárselo otra vez
3. MEMORIA SEMÁNTICA: lo que sabe
Hechos, entidades y relaciones guardados en un grafo de conocimiento
«El usuario prefiere TypeScript» vive aquí
Y no desaparece cuando termina la sesión
4. MEMORIA PROCEDIMENTAL: cómo hacer las cosas
El agente prueba 3 enfoques. Uno funciona
Ese método se convierte en una habilidad reutilizable
La próxima vez va directamente a lo que funcionó
5. OLVIDO: lo que debe borrar
Un agente que nunca olvida acaba acumulando contradicciones
Las preferencias antiguas se imponen a las nuevas. Te mudas de ciudad y sigue recomendándote restaurantes donde vivías antes
Recordar importa. Saber qué olvidar, también
¿El resultado?
→ Mem0 almacena 1.800 tokens por consulta en lugar de 26.000
→ Snowflake añadió una capa de ontología: un 20% más de precisión y un 39% menos de llamadas a herramientas
La memoria compensa su coste desde el primer día
Este PDF de 13 páginas marca la diferencia entre un chatbot y un agente que aprende de verdad
No lo pases de largo ↓
Hace unos días comentaba que el avance de los modelos open-weights era real, pero con un matiz importante: Kimi K3 podía competir cerca del frontier, sí, pero el hardware necesario para inferirlo con buen rendimiento podía rondar los $2M.
Qwen3.8-27B cambia radicalmente esa conversación.
Es un modelo open-weights de sólo 27B parámetros que, cuantizado, puede correr localmente en una única RTX 3090 de 24 GB.
Y sus resultados en Artificial Analysis son difíciles de creer:
• Intelligence Index: 52/63. Supera a Gemini 3.1 Pro Preview (48) e iguala a GPT-5.6 Luna a max effort (52).
• Agentic Index: 51/59. Supera a GPT-5.6 Terra max (50), Luna max (47), Claude Opus 4.8 max (49) y Gemini 3.7 Flash high (45). Gemini 3.1 Pro Preview, el modelo “Pro” actual de Google, obtiene 23.
Ya no estamos hablando ya de un modelo abierto gigantesco que requiere un datacenter. Estamos hablando de capacidades que empiezan a competir con modelos frontier propietarios… en una GPU de consumo de hace 6 años a unos 45 tokens/s.
Esto sí cambia, para mí, la discusión sobre la democratización real de la IA.
¿Significa que voy a sustituir OpenAI o Claude por Qwen? No en el uso general. Para mí el ecosistema —herramientas, agentes, integración, producto, fiabilidad— pesa tanto o más que el modelo, y ahí OpenAI y Anthropic siguen a mucha distancia.
Pero la competencia de los open-weights está elevando brutalmente el suelo y obligando a los modelos frontier a innovar más rápido.
https://t.co/lIipyWynBj
🚨¡Esto es ORO PURO!
Las MEJORES 2 horas de ingeniería de grafos que existen en internet.
Andrew Ng te explica desde cero cómo construir knowledge graphs agenticos de verdad:
⏰ 9:14 → Tu primer agente funcionando
⏰ 33:11 → Cómo funcionan realmente los loops
⏰ 1:02:46 → Convertir loops en grafos que sí trabajan
⏰ 1:30:15 → Agentes que mejoran su propio código
⏰ 1:49:05 → Un sistema completo que lo ejecuta todo por ti
He visto cursos de $500 que enseñan MENOS que este video solo.
Míralo YA y después llévalo al siguiente nivel
Guarda y comparte antes de que se pierda.
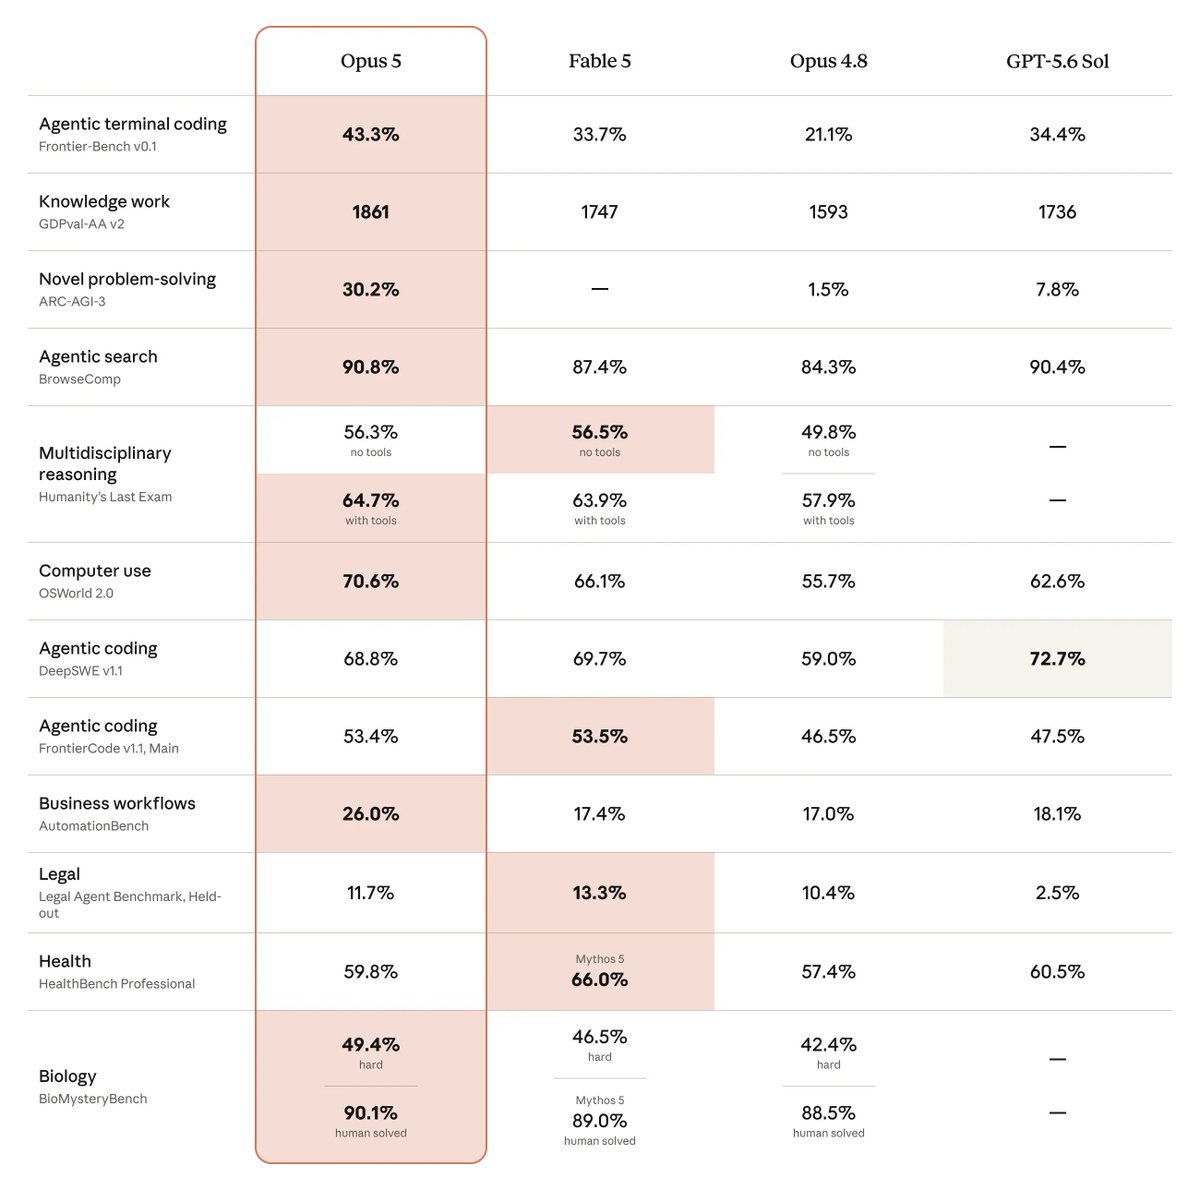
Anthropic just released Opus 5, a big jump in intelligence as compared to Opus 4.8, even surpassing Fable 5 in several relevant benchmarks.
This was a much-needed move for Anthropic since they had been struggling to handle the inference compute requirements of Fable 5 and that's why they made Opus 5 so good: so that most users will opt using Opus 5 instead of Fable 5.
Fable is still in its infancy and has much more optimization potential than smaller models such as Opus 5. But I think we will not see a new, significantly more powerful version of Fable / Mythos until Anthropic catches up in compute (and optimizes its classifiers for more intelligent model guardrails).
Este benchmark (https://t.co/NXpL6oQroR) es un poco antiguo, pero me parece muy interesante porque muestra que la elección del arnés puede tener un impacto incluso mayor que el propio modelo en el rendimiento de las tareas asignadas.
En él se comparan los resultados de cuatro benchmarks —Artificial Analysis Coding Agent Index, DeepSWE, Terminal-Bench v2 y SWE-Atlas-QnA— ejecutados con Claude Opus 4.7 en tres arneses diferentes: OpenCode, Cursor y Claude Code.
Uno podría imaginar que, al ser Claude Code y Claude Opus 4.7 del mismo fabricante, Claude Code ofrecería un mayor rendimiento. Sin embargo, ocurre justo lo contrario: en todos los benchmarks, el mejor resultado lo obtiene OpenCode, seguido de Cursor, mientras que Claude Code queda por detrás, a una distancia significativa del resto.
En conclusión, estos resultados ponen de manifiesto que la infraestructura y el arnés de ejecución no son un detalle secundario, sino un factor determinante en el rendimiento final de los agentes de codificación. Elegir el modelo adecuado es importante, pero elegir el entorno en el que se ejecuta puede ser igual o incluso más decisivo.
La cuestion no es si un modelo open weights va a superar a los modelos de frontera comerciales cerrados (Fable 5, GPT-5.6) sino si se pueden considerar una alternativa razonable, incluso para los casos de uso más exigentes. Y modelos como Kimi K3 están empezando a demostrar que sí. No obstante, para la inmensa mayoría, este modelo solo estará disponible comercialmente como lo están los de OpenAI y Anthropic: en suscripciones, o por API, ya que -con 2.8 trillones (americanos) de parametros- se requeriría una inversión de unos 2 millones para el equipo que lo pueda mover (con de 1,7 a 7,5 TB de VRAM en funcion de la cuantificación), más unos 200k de opex.
I’ve been using Fable 5 for a few hours since it became available again and, unfortunately, I don’t think it is usable for serious IT or life-sciences work in its current form.
Prompts that worked shortly before the previous version was retired no longer work. Fable 5 was also excessively restrictive at launch, but its guardrails later became more reasonable. Right now, the false positives appear to be back: legitimate requests involving software, technical systems, or scientific topics are often blocked.
In the non-trivial projects I tested, Fable 5 eventually triggered a fallback to Opus 4.8. That may preserve continuity, but it also makes it difficult to know which model is actually doing the work and whether Fable 5 can complete a serious project on its own. I ultimately disabled automatic fallback, since what I was looking for was the additional intelligence Fable 5 is expected to bring to the table. That is the whole point of Fable, isn’t it?
Safety guardrails are necessary. But when valid professional work repeatedly triggers refusals or silent model substitution, the product becomes unpredictable and ultimately unusable. I really hope the classifier that identifies potentially risky requests—and determines when prompts are blocked or routed to another model—is significantly refined over the next few days.
Estos modelos -al menos inicialmente- solo estarán disponibles para una selección arbitraria de empresas.
Limitar las capacidades más peligrosas me parece razonable. Lo preocupante es crear un acceso desigual a los modelos más capaces. Si las mismas limitaciones se aplican a todos, se puede seguir compitiendo mediante el producto, el caso de uso, el modelo de negocio y la ejecución. Pero si unas empresas acceden a una inteligencia sustancialmente superior y otras no, la desventaja puede ser insalvable y la competencia deja de ser justa.
@OpenAI I really hope this isn’t the beginning of the end of fair access to frontier intelligence for startups and SMEs. If only selected corporations receive exclusive access to frontier models, competition will become fundamentally unfair.
Sin duda es positivo que un gobierno regule e intervenga cuando algo que se lanza al mercado pudiera suponer un riesgo. Pero dicha intervención tiene un coste: muchos usuarios están considerando migrar desde OpenAI y Anthopic a modelos chinos como GLM-5.2 y similares.
OpenAI va a lanzar GPT-5.6 de forma escalonada. Inicialmente estará disponible solo para empresas aprobadas por el gobierno americano. Los motivos que aducen son similares a los de la intervención de Fable y Mythos: potenciales riesgos de seguridad.