@gaxeliy@sergeax Нет, просто маржа на API больше, а на подписках маленькая. Низкая маржа != субсидии. Нетфликс ведь не субсидирует никого, если я посмотрю 2 фильма с подпиской за 8 евро, хотя прокат или билет в кино стоил бы 8 евро за штуку?
Это справедливо только тогда, когда ты сравниваешь недавно вышедшие открытые модели со старыми моделями Anthropic и только на узком наборе бенчмарков.
Ну и что такого в тарифах Anthropic - неужели $20/$100 это какая-то заоблачная цена для разработчиков?
Мне кажется, главные факторы - это скорость и точность, и тут по моим замерам модели Anthropic выигрывают.
Я недавно попробовал сделать клон цивилизации, но вместо конвенционального AI попробовал разные модели - Haiku 4.5 был на голову выше и быстрее всех альтернатив. Проблема только в цене (что не является проблемой при наличии подписки).
Да какие субсидии, эти подписки сами по себе выгодные провайдерам и никто ничего не субсидирует. Кто-то один придумал "субсидии" и все говорят о них день и ночь.
И сейчас можно потратить примерно 4к долларов в месяц в подписке за 200 долларов. Цена за токены снижается - сравни стоимость токенов в Opus 4 и Opus 4.8.
По твоей логике Netflix тоже субсидирует и должен вот-вот начать продавать фильмы по 10 долларов за штуку? Spotify тоже? Это просто модель монетизации такая.
Ты же разработчик, посмотри на стоимость подписок на почти любой продукт - личные ��одписки всегда дешевле корпоративных тарифов. При этом прибыль приносят оба варианта, просто маржа с бизнесов больше. Нет "субсидий".
Дело не в "субсидиях", это просто такая модель монетизации - для обычных пользователей тарифы $20/$100/$200, а для корпоративных (которые и платят per-token) цены сильно больше.
Ничего нового в этом нет - сравните цены за JetBrains IDE для Individuals и Organizations, и там разница будет такая же - корпоративные лицензии в 3 раза дороже. Аналогично с ассетами для игровых движков - см. Fab, там разница в 2 раза обычно.
Просто корпы тебе могут за��латить с маржой в несколько раз, а обычные смертные максимум $100-$200, да и то нехотя. Но прибыльны оба варианта
@doxa_journal > Женщины пользуются ИИ в четыре раза реже, чем мужчины
> Оказалось, что женщины используют нейросети на 10-40% меньше, чем мужчины, а если округлить цифры по регионам, получится разрыв примерно в 25%
Понятно, всё сходится
She dumped me last night.
Not because I don't listen.
Not because I'm always on my phone.
Not even because I forgot our anniversary (twice).
But because,
in her exact words:
"You only pay attention to the parts of what I say that you think are important."
I stared at her for a moment and realized...
She just perfectly described the attention mechanism in transformers.
Turns out I wasn't being a bad boyfriend. I was being mathematically optimal.
See, in conversations (and transformers), you don't give equal weight to every word. Some words matter more for understanding context. Attention figures out exactly HOW important each word should be.
Here's the beautiful math:
Attention(Q, K, V) = softmax(QK^T / √d_k)V
Breaking it down:
Q (Query): "What am I looking for?"
K (Key): "What info is available?"
V (Value): "What is that info?"
d_k: Key dimension (for scaling)
Think library analogy:
You have a question (Query). Books have titles (Keys) and content (Values). Attention finds which books are most relevant.
Step-by-step with "The cat sat on the mat":
Step 1: Create Q, K, VEach word → three vectors via learned matrices W_Q, W_K, W_V
For "cat":
Query: "What should I attend to when processing 'cat'?"
Key: "I am 'cat'"
Value: "Here's cat info"
Step 2: Calculate scoresQK^T = how much each word should attend to others
Processing "sat"? High similarity with "cat" (cats sit) and "mat" (where sitting happens).
Step 3: Scale by √d_kPrevents dot products from getting too large, keeps softmax balanced.
Step 4: SoftmaxConverts scores to probabilities:
"cat": 0.4 (subject)
"sat": 0.3 (action)
"mat": 0.2 (location)
"on": 0.1 (preposition)
"the": 0.1 (article)
Step 5: Weight valuesMultiply each word's value by attention weight, sum up. Now "sat" knows it's most related to "cat" and "mat".
Multi-Head Magic:Transformers do this multiple times in parallel:
Head 1: Subject-verb relationships
Head 2: Spatial ("on", "in", "under")
Head 3: Temporal ("before", "after")
Head 4: Semantic similarity
Each head learns different relationship types.
Why This Changed Everything:
Before: RNNs = reading with flashlight (one word at a time, forget the beginning)
After: Attention = floodlights on entire sentence with dimmer switches
This is why ChatGPT can:
Remember 50 messages ago
Know "it" refers to something specific
Understand "bank" = money vs river based on context
The Kicker:Models learn these patterns from data alone. Nobody programmed grammar rules. It figured out language structure just by predicting next words.
Attention is how AI learned to read between the lines.
Just like my therapist helped me understand my focus patterns, maybe understanding transformers helps us see how we decide what matters.
Now if only I could implement multi-head attention in dating...
Still waiting for "scaled dot-product listening" to be invented.
Очень много текста. Я не претендую на истину в первой инстанции на завайбкодив больше 120к строк кода для нескольких проектов. Могу поделится некоторыми мыслями, в том числе я опробовал и то что писали другие в комментариях. Показываю на примере курсора, но разово настроив одни правила, можно промптом перенастроить под любой другой или дать в правилах учитывать правила, а claude code при первом скане проекта это даже сам под себя перенастроит.
Я промчу на английском. Русский длинный и на нем лаконично и коротко не получится мысли формулировать, удобные для ��одели + это будет дольше и жрать токенов будет больше так как язык тупо длинее.
Даже самая хреновая модель типа нищенской от копилота будет ок +- на простых проектах (ее просто надо зажимать жестче). 4.1 например ок может дебажить.
Каждый проект уникален (если из разных областей от хром экстенщена, до nextjs) и требует тюнинга под проект.
Если язык один как например у меня typescript (тут я не пишу про работу у нас большая кодбаза от котлина джавы до питона хотя там принципы похожие просто команда работает над улучщением правил) мы всегда делаем маст: линтер (тут главное не переборщить с правилами иначе агент будет тратить время на фикс очень много, основное покрываем чтобы уж совсем ugly не было все в any i.e. ). Моя рекомендация линтер настроить разово руками самому (я это сделал еще года три назад и тупо копипащу между проектами иногда улучшая). Можно взять с условного опенсорса, главное смотрите чтобы под ваш стиль подоходило, чтобы по-минимуму оттюнить: дальше агенту пишем промпт вначале: “добавь правило в .cursorrules после генерации либого кода обязательный вызов линтера можно даже команду дать” в этом и парадокс что он поймет и опишет все для себя в удобном ему формате.
Тесты, это я начал недавно практиковать (но покрываю только прямо вот важные с моей точке зрения куски). Т��чно также говорим, после генерации кода запускай тесты.
Обязательно, добавить после генерации запускать билд (это для typescript проектов важно)
Потом у меня стоит вот такое правило. Это я у кого-то утащил:
-----------
## Code Modification Rules
**CRITICAL: When updating or fixing code provided by the user, make changes ONLY where strictly necessary.**
- Do not add new comments or change whitespace anywhere outside sections you are directly changing
- Do not make stylistic changes anywhere else in the code
- Do not fix inconsequential mistakes such as spelling or missing semicolons (unless they cause actual errors)
- Do not change the order or arrangement of variables, properties, methods, etc.
- Keep diffs minimal and focused on the actual changes needed
- **Exception**: Non-breaking spaces (" " characters) should NEVER be used for indentation - replace them with regular spaces, as browsers sometimes replace spaces with non-breaking spaces when pasting
**Note**: It is allowed to point out mistakes separately from the updated code blocks, but do not fix them in the code unless they are part of the requested change.
----------
Когда после итераций видите, что его несёт не туда несколько раз, не надо ругаться, что он ничего не умеет. Запомните главное правило: глупые/простые вопросы порождают глупые/простые ответы. Посмотрите, что он делает не так, и, применяя свою экспертизу, не бойтесь добавлять ему новые правила, зажимая его ещё жёстче. Не делай так или делай так (это зависит от проекта).
Про зажим — это, кстати, очень прикольная ловушка. Тут чисто выяснил эмпирическим путём, зависит от агента. Например, Claude Code умеет сам дообогащать контекст, а вот Cursor и Copilot надо чётко проговаривать, что включить в контекст (всё с опытом). Обязательно создать правила сохранения всех планов в условный docs/spec, результаты — docs/impl. Если документация нужна, создайте третью папку, где правило (для нетехнических чуваков сохрани документаци�� по поведению/использованию программы — конечно, это можно сделать по завершению проекта или какой-то майлстоун, но инкрементально он делает лучше). Делаем в md. Для следующих задач референсим всю папку с spec или impl или по файлам, можно также в правило добавить. Народ также для контекста советует использовать тесты.
Про команды. Агенты поддерживают их. Но я не использую — я правилами прописываю шаг/текст и что надо сделать. Например: "sync" — сделай commit, push, argo sync. Слово проще и быстрее, чем помнить все команды.
Ну и ключевое: агентов больше чем один (если вы н�� на Claude с Opus) вам всё равно — с более мощной моделью один нужен. У меня правило: 2-3 итерации на фикс, и потом summary — как пробовали фиксить и чё сделали — и скармливаем другому агенту (работает безупречно).
Сейчас я копаю в сторону независимых агентов и синхронизацию между ��ими и spec-driven-dev. Ах, ну я и не за "КРАСИВЫЙ КОД", так как в большинстве это будет править та же машина.
Если есть вопросы, спрашивайте. Это больше базовый подход. Ессно, у меня есть опыт и с MCP, и есть опыт разработки MCP и агентов для кровавого энтерпрайза. Но спросили — как тюнить.
@ahmetb Table tests make more sense when you have 5+ test cases (depends on test case complexity). You can cherry-pick examples that prove any point of view.
Btw in your screenshots it's better to call Run to make test cases more visible.
@ohmypy 6 is the best, 1st is the second best.
I would try to tweak a font on 6th cover a little bit to find the best possible option. Maybe you can reduce font size just a little or move gopher to the "O" in the first row?
Claude has been holding back on you.
There's a hidden 'thinking mode' that makes it 10x better at solving hard problems and it's just one setting away.
Here's how to unlock Claude's actual brain:
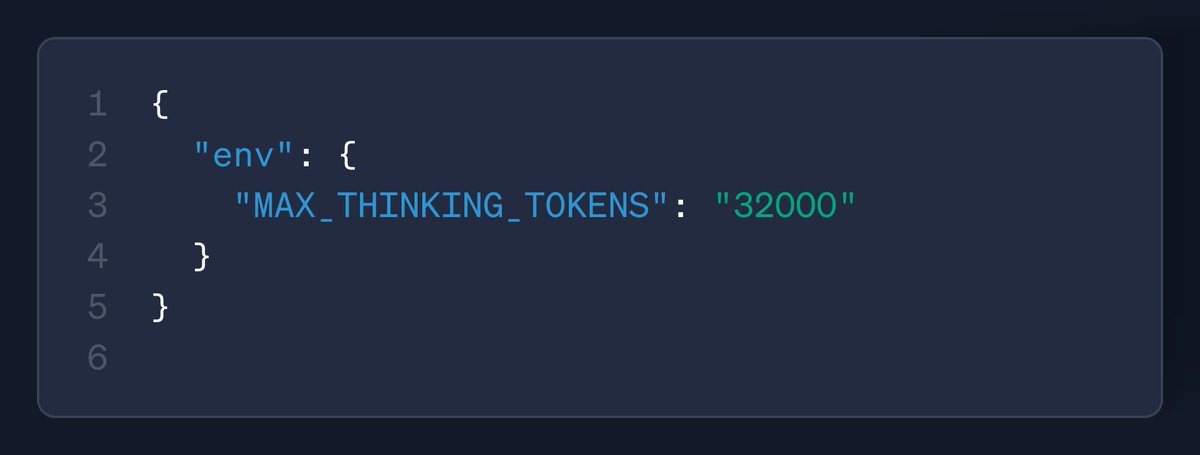
enabling MAX_THINKING_TOKENS in your .claude/settings.local.json
Я почитал issues и код официального SDK мессенджера Max для написания ботов на Go:
- нормальной обработки ошибок нет, ошибки просто игнорируются
- нормального логирования нет, используется просто log.Printf везде
- в API методы принимают контекст, в example.go - код без контекстов
- линтеров нет, CI нет
- код в репозитории не собирается, т.к. в одном файле неиспользуемый импорт, а в Go это приводит к ошибке компиляции
- куча ошибок, которые легко обнаруживаются линтерами