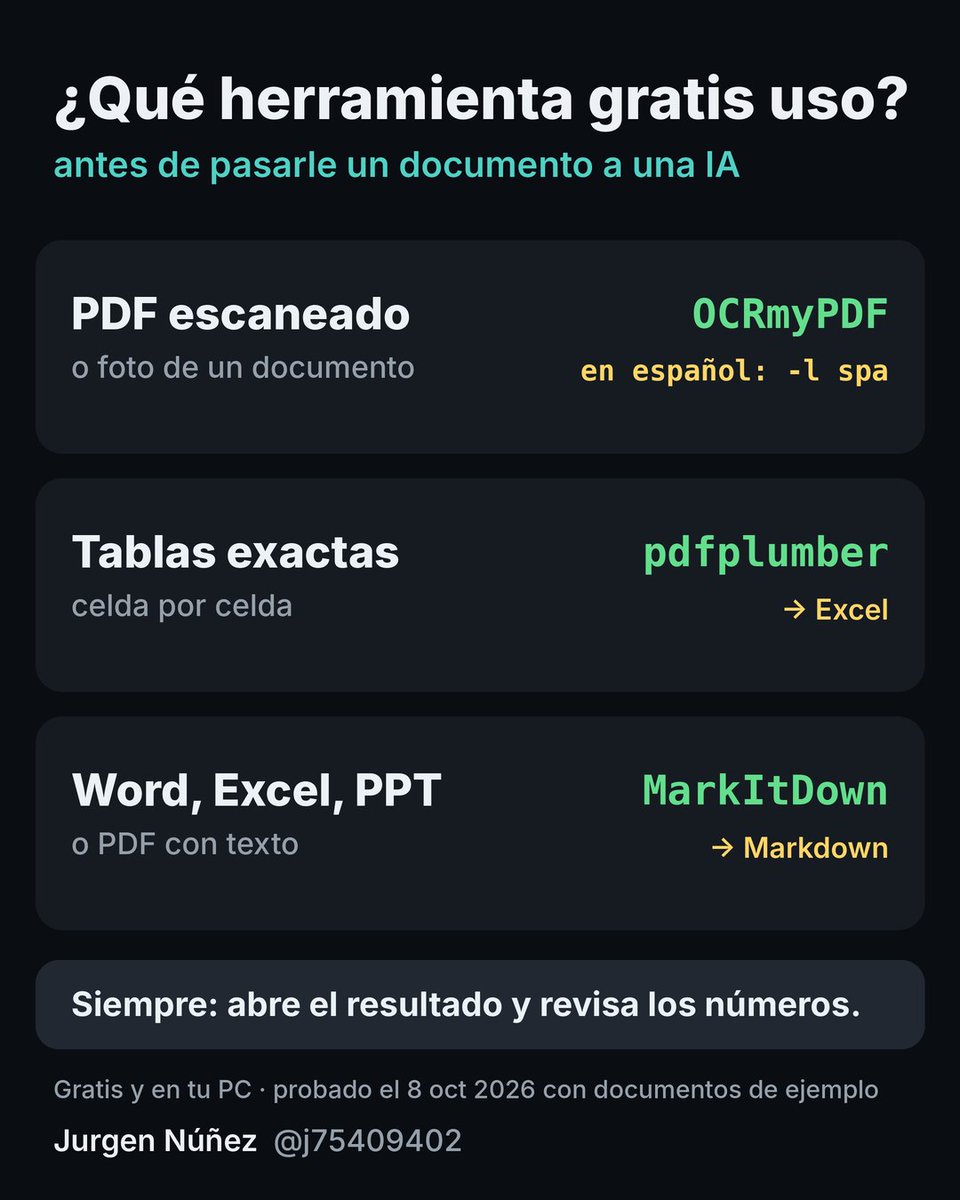
Guárdalo para la próxima vez que le pases un documento a ChatGPT o Claude.
Escaneo → OCRmyPDF
Tablas exactas → pdfplumber
Lo demás → MarkItDown
Y siempre: abre el resultado y revisa los números. Todo gratis y en tu PC.
@AlientoB@nayaradlatorre Si automatizas con los mismos documentos, súbelos a un Proyecto: según la ayuda de Claude, quedan en caché y reutilizarlos te ahorra uso.
Y en Ajustes › Uso ves cuánto llevas gastado de la sesión de 5 horas y del límite semanal, antes de que te corte.
30 facturas llamadas "scan_XXXXX.pdf", renombradas a fecha_cliente_número en 0,24 s con Python.
Funciona cuando todas tienen el mismo formato. Si a una le falta un dato, el script se detiene ahí: haz una copia antes.
Facturas de ejemplo · Python 3.13 + pdfplumber
@sinGPU_ar Buenísima la metáfora. Un matiz: el tamaño del mate también depende del largo y la complejidad de la conversación, según la ayuda de Claude.
Para una tarea independiente, abrir otro chat puede ayudar a no arrastrar contexto innecesario.
@santtiagom_ En Gmail + Drive, limita los scopes OAuth:
gmail.readonly permite leer, no enviar ni borrar.
drive.file limita los archivos accesibles a la app.
Eso reduce el alcance de una inyección, pero no evita que se filtren datos que el agente sí puede leer.
@guillermodols Gracias a ti. Un matiz: la prueba fue con MarkItDown directo, no con MdPipe.
Una forma de detectarlo sin OCR: si el PDF tiene páginas pero el texto extraído sale casi vacío, avisar "¿es un escaneo?" y sugerir OCRmyPDF.
¿Lo verías mejor como aviso al final o antes de convertir?
Mismo contrato escaneado (de ejemplo), mismo OCR (OCRmyPDF). Solo cambia el idioma:
Español (-l spa): 0 palabras mal de 72.
Inglés (-l eng): 11 mal. "Núñez" → "Nufiez", "Cláusula" → "Cldusula".
Si tu OCR pierde tildes y eñes, revisa el idioma antes que el escaneo.
Tablas de PDF a Excel sin copiar y pegar: pdfplumber + 8 líneas de Python.
En la prueba, MarkItDown juntó cantidad y precio en una columna; pdfplumber separó las 5.
Ojo: los números llegan como texto. Conviértelos antes de sumar.
pip install pdfplumber openpyxl
Antes de que un script renombre tus archivos:
1. Copia la carpeta
2. Primero, que solo muestre los nombres nuevos
3. Incluye un dato único (n.º de factura): sin nombres repetidos
4. Si falta un dato, que se detenga
30 facturas de ejemplo: 0,24 s. El riesgo es renombrar mal.
@seguia81 Un detalle si la info sale de PDFs: al extraer tablas, los importes suelen quedar como texto ("1,240.00").
En Excel, SUMA ignora las celdas con texto: el total sale corto o en 0, sin error. Conviene pasarlos a número (ojo con el separador decimal) antes de dárselos a Claude.
Antes de pasarle un documento a una IA:
1. Convierte
2. Guarda como archivo.pdf.md, no archivo.md (si no, factura.pdf y factura.docx se pisan)
3. Revisa tablas y números
4. Si sale vacío, es un escaneo: OCR primero
5. No conviertas archivos de origen desconocido
Fallo 2, el más peligroso: un PDF escaneado dio un archivo vacío. Sin aviso.
Solución gratis: pasarlo antes por un OCR local como OCRmyPDF. Así, en la prueba, MarkItDown sí leyó el texto.
Su plugin de OCR usa un modelo de IA por API: requiere configuración y puede costar.
Prueba con 4 archivos de ejemplo:
– Word: títulos, listas y tabla correctos
– Excel: cada hoja, una tabla con su nombre
– PowerPoint: texto por diapositiva
– PDF: la tabla salió, pero juntó cantidad y precio en una sola columna
Fallo 1: revisa las tablas en PDF.
Si le pasas PDFs, Word o Excel a ChatGPT, Claude o a tus automatizaciones, hay una herramienta gratis de Microsoft que los convierte en texto limpio (Markdown) con un solo comando: MarkItDown.
Cómo usarla y los 2 fallos que conviene revisar antes de confiar en ella:
¿Tú dejarías que un agente publique directo desde tu cuenta o le pondrías un paso de aprobación antes de cada acción?
Si ya lo usas, ¿qué control le pusiste?
Dejé que un agente de IA publicara un hilo por mí en X.
A medio camino la pestaña se congeló, el editor se cerró y la pestaña acabó en el post de otra persona.
Si el foco sale del editor, las teclas pueden ejecutar acciones fuera del texto.
Qué pasó y cómo lo controlo ahora 🧵
El protocolo que uso ahora:
1. Antes de cada tramo, comprobar que el foco sigue en el editor. Si no, parar
2. Escribir en tramos cortos
3. Comparar con el texto aprobado antes de publicar
4. Revisar la actividad de la cuenta al terminar
5. Nada se publica sin mi aprobación