Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
corleone jack(互关版)
@jackcorleone19
学习
Joined July 2026
66
Following
35
Followers
225
Posts
corleone jack(互关版)
@jackcorleone19
34 minutes ago
一档 AI 视频播客 45 天只更了 6 期,小宇宙订阅就破了 1 万。 做内容不一定要日更:每期给出一手经验,栏目名和更新节奏固定下来,听众才有理由点订阅。 你会因为什么订阅一个播客?
#内容创业
#播客
jackcorleone19
retweeted
宝玉
@dotey
about 4 hours ago
https://t.co/BzYVEGcn4B
corleone jack(互关版)
@jackcorleone19
34 minutes ago
DeepSeek 把线上同源的推理框架 DeepInfer 开源了,Apache 2.0,兼容英伟达和昇腾,这次聚焦离线推理。 小团队别急着自建:调用量不大直接用 API 更省;数据不能出内网,或 API 账单吃不消了,再研究自部署。 https://t.co/sRz6B5QwuM
meng shao
@shao__meng
about 1 hour ago
DeepSeek 居然把支撑他们大规模生产服务的高性能推理框架开源了:DeepInfer 这是 DeepSeek 线上真实跑 DeepSeek 服务的同源技术栈首次对外公开,本次发布聚焦离线推理,采用 Apache 2.0 许可证,主要基于
@vllm_project
构建,并借鉴了
@sgl_project
和 TensorRT-LLM。 开源地址:https://t.co/QZEDlDjbRW DeepSeek 此前已陆续开源了推理栈的“零件”:FlashMLA(MLA 注意力内核)、DeepGEMM(矩阵乘法内核)、DeepEP(MoE 通信库)、EPLB(专家负载均衡)等,但一直缺少把它们组装成完整引擎的“骨架”。DeepInfer 补上了这一环:它是这些内核的集成者,加上调度、并行、投机解码等系统层的完整实现。配合本次同时出现的 DeepSeek-V4.1-Flash 模型,构成了“模型 + 引擎”的完整开源推理方案。硬件层面同时支持 NVIDIA SM100 GPU 和华为昇腾 950 NPU,双平台支持是它的一个鲜明特征。 # 核心技术拆解 1. 内核与运行时。 集成 FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect,以及用 TileLang 编写的自定义内核(位于 deepinfer/model_executor/layers/tilelang_ops)。这些是吞吐和延迟的底层保障。 2. 并行策略:Attention 与 MoE 分治。 注意力部分采用 DP(数据并行)或均衡的 CP(上下文并行,处理超长序列);MoE 部分采用 EP(专家并行)加 EPLB(专家并行负载均衡),并支持冗余专家(默认 32 个,向上取整到能被 EP 数整除)来缓解专家负载不均。这种“注意力 DP/CP + MoE EP”的组合是 DeepSeek 生产验证过的架构。 3. DSpark 投机解码。 基于 MTP(multi-token prediction)draft token 加速解码,亮点是“置信度调度验证”;按置信度决定接受多少 draft token,而非固定规则。默认最大 draft 长度 5。这是推理加速比的主要来源之一。 4. YoCo SWA 有界重放。 针对 YoCo 式解码器 + 滑动窗口注意力(SWA)的优化:prefill 时只保留并重放有界的 token 后缀(默认 140 个,需覆盖 SWA 窗口加最大回溯长度),大幅削减 decoder prefill 的计算量。仓库还专门提供了 YoCo mask/compact 等价性验证。 5. 异步调度。 CPU 上的批调度与 GPU/NPU 上的执行重叠,做到“零开销调度器”,默认开启。 6. 批不变与确定性推理。 开启 DEEPINFER_BATCH_INVARIANT=1 后,不同批次组合下结果完全一致;再配合固定 seq_seed、关闭 MTP varlen,可实现逐 token 确定性的采样输出。这对可复现评测和回归测试(仓库用逐样本精确对比的 PPL 基线来把关)很关键,目前仅限 NVIDIA 平台。 7. 结构化输出。 原生支持 regex、JSON schema、EBNF 三种约束生成,通过 SamplingParams 的 so_args 传入。
See More
corleone jack(互关版)
@jackcorleone19
35 minutes ago
让模型给自己的作品打分,参考价值不大,它很容易高估自己。 比较模型更靠谱的办法:先写 3 到 5 条评分标准,把两个模型的输出匿名打乱,再由你或第三个模型按标准逐条打分。 你平时怎么判断哪个模型更好用?
#大模型
#AI工具
jackcorleone19
retweeted
Orange AI
@oran_ge
about 6 hours ago
AI Agent 的两极分化越来越严重: 1. 技术是通向完全的自动化,取代人,终点没什么人的事情 2. 产品则是满足人的需求,帮助人,终点是一种普通人的全新生活方式 这也是之前 Agent 和现在 Personal Agent (我更喜欢 Personal AI 这个词)在方向上的差异 尽管现在看起来还不明显,但两条直线的交叉点已过,未来会渐行渐远 我们在方向2上探索了很久,在4月最早推出了 Cola 1.0,而现在行业已成共识,全新的 Cola 2.0 也将在 11 月上线,敬请期待。
corleone jack(互关版)
@jackcorleone19
35 minutes ago
有博主让 Codex 拿着营业执照、身份证和模板,10 分钟填完一套报备材料。 把证件交给 Agent 前做三件事:单独建一个文件夹,只授权它;能打码的号码先打码;办完就删本地副本和对话记录。 你敢让 AI 碰证件吗?
#AI安全
#Agent
corleone jack(互关版)
@jackcorleone19
about 3 hours ago
一次写作、多处分发,是个人内容最省力的杠杆。关键是先有一个自己能掌控的主仓库(博客或文档),再往各平台同步,平台规则变了内容也不会丢。 https://t.co/OS4TYjxodt
向阳乔木
@vista8
about 4 hours ago
搭建一套自己的内容发布工作流很有必要。 1. 写稿用飞书,方便写作点评修改 2. 用 Skill 检查格式,发布到自己的博客 3. 再从自己博客一键发布公众号草稿箱 如果要发 X, Chrome 插件同步博客列表,选择发送即可
jackcorleone19
retweeted
SuSu_酥酥👅
@NFT_Chen
about 4 hours ago
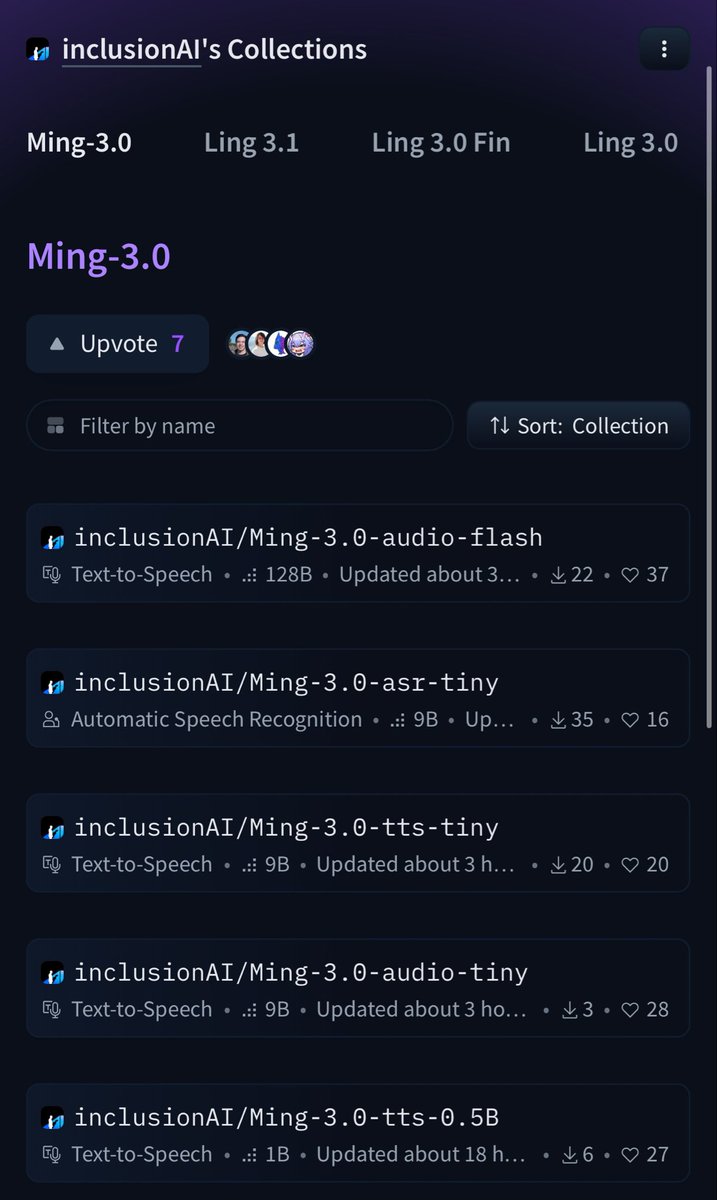
🔥重磅!蚂蚁百灵开源Ming-3.0语音系列,5款模型一次到位! 覆盖语音合成、音频理解与对话、语音识别,MIT协议已上HF/ModelScope。 核心亮点: 🔹TTS:文字描述音色 + 导演模式控情绪/重音/节奏 🔹Audio:长音频直接理解+结构化输出 🔹ASR:方言+热词+上下文感知 快速上手: 1️⃣打开集合下载权重:https://t.co/xO01Js8T2i 2️⃣TTS推荐克隆仓库:https://t.co/KlH3RiTt1H 3️⃣安装依赖后按README跑推理(0.5B最轻量) 4️⃣音频理解可直接进Ling Studio Chat体验 #蚂蚁百灵 #Ming3 #开源模型 #AI语音 #TTS #阿里巴巴
See More
corleone jack(互关版)
@jackcorleone19
about 3 hours ago
蚂蚁开源了 Ming-3.0 语音系列,TTS、语音识别、音频理解都有。 拿开源模型做商业项目前,先看三样:许可证能否商用、权重和代码协议是否一致、克隆声音有没有授权。开源不等于随便商用。 你选开源模型会先看协议吗?
#开源模型
#AI语音
jackcorleone19
retweeted
meng shao
@shao__meng
about 6 hours ago
我把给孩子做的键盘打字游戏开源了 Keyboard Island · 键盘小岛 https://t.co/KUcD1z65tc 前面发布到 ChatGPT Sites,收到一些留言说访问不了,还有一些朋友想知道是怎么实现的。 其实整体功能都比较简单(虽然也都不是我写的),我的需求方在我迭代中也提出了很多小朋友的想法,比如按键要有音乐、要更像游戏更好玩、希望自己的头像出现在画面中、希望有自己的小屋可以领积分来装饰等等。所以就有了现在的版本。 感兴趣的朋友,欢迎多多交流,当然也欢迎 ⭐️ 一下 😄
corleone jack(互关版)
@jackcorleone19
about 3 hours ago
有博主晒了 AI 视频流水线的成本:主力模型 20 美元月订阅能出约 80 条,配音和字幕用本地模型,不花钱。 做 AI 内容副业,先算单条成本:订阅费 ÷ 月产量,再对比单条能带来的播放和收益,算得过来再放量。 你做一条内容大概花多少钱?
#AI创作
#副业
corleone jack(互关版)
@jackcorleone19
about 5 hours ago
@eth2060
已关注
jackcorleone19
retweeted
宝玉
@dotey
about 8 hours ago
Notion Business 和 Enterprise 的 AI 不再不限量:每人每月 1,500 个 Standard 积分加 500 个 Select 积分,现有工作空间 11 月 2 日切换 Notion 的 Business 和 Enterprise 套餐,此前宣传 AI 不限量使用,现在改成按积分算:每位成员每月 1,500 个 Standard 积分和 500 个 Select 积分。10 月 19 日起新建的工作空间已经用上新规则,现有工作空间 11 月 2 日切换。官方说额度可能因套餐和采购协议不同,签了合同的企业以合同为准。 两种积分的区别在于谁选模型。让 Notion 自动挑模型(Auto 模式)时扣 Standard 积分,日常的写作、翻译、问答、AI 公式都走这里。自己手动指定模型,或者运行给自己用的自定义智能体(Custom Agent),扣 Select 积分。 官方给了估算:Auto 模式下,简单任务约 5 个积分,复杂任务约 25 个。手动选 Opus 5.5 做同样的事,要 50 到 150 个。所以 1,500 个 Standard 积分够做几百次日常任务;500 个 Select 积分如果全用顶级模型,简单任务十次左右,复杂任务三次多就见底。Notion 说绝大多数用户每月用不完。 两种积分各算各的,不能合并,不能转给同事,也不能换成别的积分,每月重置,没用完的不结转。Select 用完、Standard 还有,可以把 Notion Agent 切回 Auto 继续用。 用完会被扣钱吗?默认不会。积分耗尽后,相关 AI 功能暂停,等下个月重置。管理员可以在设置里打开一个开关,让成员用完后继续消耗工作空间另外购买的 Notion 积分,这个开关默认关闭。另外,个人的 Notion Agent 现在可以接入自己的 ChatGPT Plus、Pro 或 Go 账号,用 ChatGPT 的额度代替 Notion 积分。 容易漏掉的是会议记录。AI Meeting Notes 从 12 月 1 日起开始扣 Standard 积分,官方估算一小时会议约 10 个。单算会议,一个月的额度够录 150 小时,但它和日常 AI 用的是同一笔额度。常开会又常用 AI 的团队,管理员最好在切换后先看看成员的实际用量,再决定要不要打开额外积分的开关。 官方用量规则:https://t.co/s8bG4WJRPW 产品公告:https://t.co/zJfSFVS8Wz
See More
corleone jack(互关版)
@jackcorleone19
about 7 hours ago
Notion 把 Business 和企业版的 AI 从「不限量」改成按积分算了。 做 AI 产品的启示:别轻易承诺不限量。把用量分成「自动选模型」和「手动选顶级模型」两档,默认走便宜的,用户想要强模型再单独计费,成本和体验都好控。 你的产品怎么给 AI 定价?
#AI产品
#独立开发
corleone jack(互关版)
@jackcorleone19
about 7 hours ago
同一批 AI 视频发 10 天:抖音单条最高 30 万播放,B站 12 万,小红书只有 6000。 平台差距能到几十倍。做内容别凭感觉押一个平台,先多平台小量测,再把精力压到数据好的那边。 https://t.co/3RSBxRB8Bx
Gorden Sun
@Gorden_Sun
about 8 hours ago
我的大肥鱼视频在国内平台发了10天了,数据情况: 抖音,涨粉1400,单视频最高30万播放 视频号,涨粉800,单视频最高5万播放 B站,涨粉1200,单视频最高12万播放 小红书,涨粉80,单视频最高播放6000
corleone jack(互关版)
@jackcorleone19
about 7 hours ago
在 Codex、Cursor、Claude 之间换着用,最费时间的是重新交代背景。 一个零成本办法:项目根目录放一份交接文档,写目标、当前进度、踩过的坑、下一步。换工具时让新 Agent 先读它,收尾时让它更新。 你换 Agent 时怎么搬上下文?
#AI工具
#Agent
jackcorleone19
retweeted
meng shao
@shao__meng
about 8 hours ago
Meta 工程团队
@Meta_Engineers
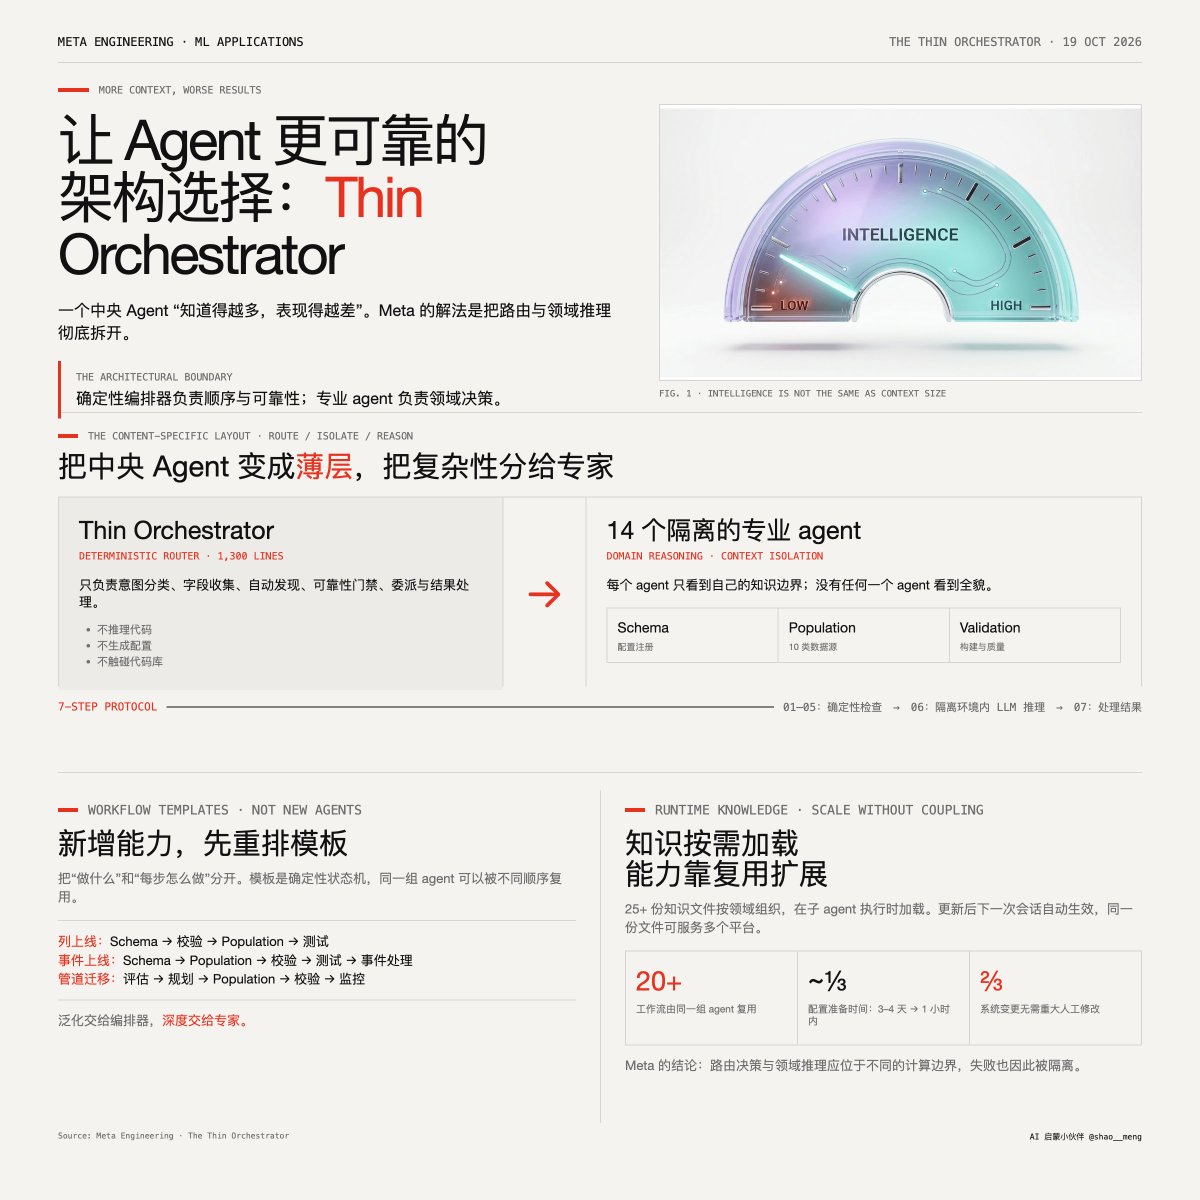
发布了 Agent 架构实践:一个让 Agent 更可靠的架构选择「Thin Orchestrator」 一个中央主 Agent “知道得越多,表现得越差”;这不是提示词问题,是架构问题! Meta 团队最初用单个“全能 Agent”自动化推荐系统的数据列上线流程:它同时装载了所有领域知识、schema、代码生成规则、路由逻辑和校验要求。结果在演示中正常,在生产环境中开始产生幻觉。具体表现为知识交叉污染:把 A 子系统的命名规范套用到 B 上,把适用于某数据源的代码生成模式用错对象。 这一现象有实证支撑:他们引用 Mount Sinai 的研究,多 Agent 编排系统在 80 任务批次下保持 65.3% 准确率,而单 Agent 仅 16.6%,token 消耗最多降低 65 倍。原因在于任务隔离阻止了上下文互相干扰,上下文超过某个阈值后,更多知识反而降低性能。 解决方案:两层架构 + 严格的职责边界 第一层:确定性的瘦编排器(约 1300 行代码),零领域工作。 它把 20+ 工作流路由到 14 个专业 Agent,自己只做三件事:意图分类、收集必要字段、执行可靠性检查。它从不推理代码、不生成配置、不触碰代码库。 第二层:14 个上下文隔离的专业 Agent。 如 schema 管理 Agent、population Agent(负责 10 种数据源的代码生成)、校验 Agent 等。关键设计是,没有任何一个 Agent 看到全貌,这是刻意为之。 每个请求走固定的 7 步协议:读取子 Agent 指令文件 → 查重 → 收集用户字段 → 自动推断(repo 类型等)→ 可靠性门禁检查 → 委派子 Agent → 处理结果。其中第 1–5 步和第 7 步全部是确定性逻辑,只有第 6 步涉及 LLM 推理,且推理发生在只装载自身领域知识的隔离环境中。 最有工程价值的洞察:模板复用而非新增 Agent 他们把“做什么”(workflow 模板)与“每步怎么做”(子 Agent)分离。模板是确定性状态机,例如: · 列上线:Schema → 校验 → Population → 测试 · 事件上线:Schema → Population → 校验 → 测试 → 事件处理 · 管道迁移:评估 → 规划 → Population → 校验 → 监控 支持管道迁移这个全新能力时,只需新增一个模板重新排列现有 Agent,“零新增 Agent 代码,完整生产能力”。所有子 Agent 结构统一(知识源、预收集清单、工作流步骤、错误-解决方案映射),第 15 个 Agent 与第一个在结构上完全一致,新增能力变成模板化工作。 知识在运行时按需加载而非内嵌:25+ 知识文件按领域组织,每份通常几千 token,更新后在下一次会话自动生效,且同一份文件可服务多个平台实现。 博客地址 https://t.co/1tFxv7yYtf
See More
corleone jack(互关版)
@jackcorleone19
about 7 hours ago
Addy Osmani 新文讲 Agent 验证:测试正在变成 Agent 判断「做完没」的传感器。 一个反直觉的坑:flaky 测试比没测试更糟。重跑偶尔能过,Agent 就学会「重试」而不是「修」。主套件里不稳定的用例,发现就先隔离。 你的 CI 里有几条时灵时不灵的测试?
#AI编程
#Agent
corleone jack(互关版)
@jackcorleone19
about 10 hours ago
有开源项目用 MCP 把 AI 助手直接接进 Unity 编辑器,用自然语言改场景、调资源。 让 AI 动工程文件前做好两件事:项目先进 Git,让它小步改、改完就提交;先给只读权限看它怎么理解项目,再放开写。 你会让 AI 直接改你的工程吗?
#AI编程
#MCP
jackcorleone19
retweeted
Gorden Sun
@Gorden_Sun
about 18 hours ago
Viggle JST-2:一秒生成可探索的3D虚拟世界、角色和动作的AI模型 市面上的很多世界模型只盯着画面像素去学习,只能拼凑出表面长什么样,很难真正理解真实世界里的三维空间和物理规律。 为了解决这个问题,Viggle团队开发了全新的JST-2模型。这个模型把世界拆解成一个个带有空间位置和物理属性的“3D原子”,直接从底层学习物体的空间结构和运动规律。 速度非常快,只需要1秒钟、花不到1美分,就能生成出一个完整的3D场景,生成的场景直接在浏览器里就能打开,你可以随便拖动视角在里面逛,一边逛还能一边实时向外扩建新的区域。如果上传几张真实房间的照片,它也能自动把照片里没拍到的死角补全,还原出一个完整的3D空间。 另外在做3D人物和动作上也很强: · 角色自带骨骼,直接能动:你只需要输入文字或者传一张人物图(哪怕图片被裁切过或者有遮挡也没关系),JST-2就能直接生成3D角色。由于生成时已经把运动变形的规律写了进去,省去了传统3D制作里繁琐的“绑骨骼”步骤,造出来的人直接就能动。 · 文字和视频直接转3D动作:你可以用文字描述动作,或者上传一段真人视频,它就能生成对应的全身3D动作(连被遮挡的身体部位和精细的手指动作都能推算出来)。这些动作不用额外调整就能直接套在生成的角色身上,也能兼容标准的3D软件骨骼。 模型未开源,可以在线使用或API调用,实际应用于生产,还得再多些验证。 官方介绍:https://t.co/Zr889Zv83v
See More
Last Seen Users on Sotwe
Aile İçi Fantaziler
Seen from
Turkey
Jajaka99
Seen from
Indonesia
啊嘞嘞
Seen from
Vietnam
Couple Pak
Seen from
Pakistan
pecintaibu2434
Seen from
Indonesia
023杜克s
Gà tre
Seen from
Vietnam
yerli Türk gay video🇹🇷🏳️🌈🇹🇷🏳️🌈
Seen from
Sweden
juevilxx 🌸top 5 onlyfans
Seen from
India
PLAYGIRLVIRGO🍭
Seen from
New Zealand
Trends for you
1
Jalen
Under 10K tweets
2
49ers
Under 10K tweets
3
Paris
Under 10K tweets
4
Macron
Under 10K tweets
5
Angel Reese
Under 10K tweets
6
Good Tuesday
Under 10K tweets
7
New America
Under 10K tweets
8
Slotkin
Under 10K tweets
9
#WWERaw
Under 10K tweets
10
Europe
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.5M followers
2
Barack Obama
@barackobama
118.8M followers
3
Cristiano Ronaldo
@cristiano
114.6M followers
4
Donald J. Trump
@realdonaldtrump
111.8M followers
5
Narendra Modi
@narendramodi
107.1M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.3M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.5M followers
13
Kim Kardashian
@kimkardashian
70.9M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.5M followers
16
Bill Gates
@billgates
65.3M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.2M followers
19
CNN
@cnn
61.7M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫