« Mia, c'est pas une IA », starring Claudia from @anabology .
Musique, voix, images, vidéo : tout est généré en local sur mon Mac, en 5 jours, Claude Code à la réalisation.
Clip de 4 min en deux parties (1/2).
French AI music video, made 100% locally on my Mac. #slopcore
@Fredmc57@anabology Je n'en doute pas.
J'ai du prendre le temps d'identifier les bons outils et de tester la stack. Et c'est pas du full-time, je bosse la journée.
« Mia, c'est pas une IA », starring Claudia from @anabology .
Musique, voix, images, vidéo : tout est généré en local sur mon Mac, en 5 jours, Claude Code à la réalisation.
Clip de 4 min en deux parties (1/2).
French AI music video, made 100% locally on my Mac. #slopcore
@Bandana_ici@iamsupersocks Oui : lms load --speculative-draft-mtp --speculative-draft-max-tokens 4
Le 1er active la tête MTP du modèle (pas de draft séparé), le 2e lève le plafond.
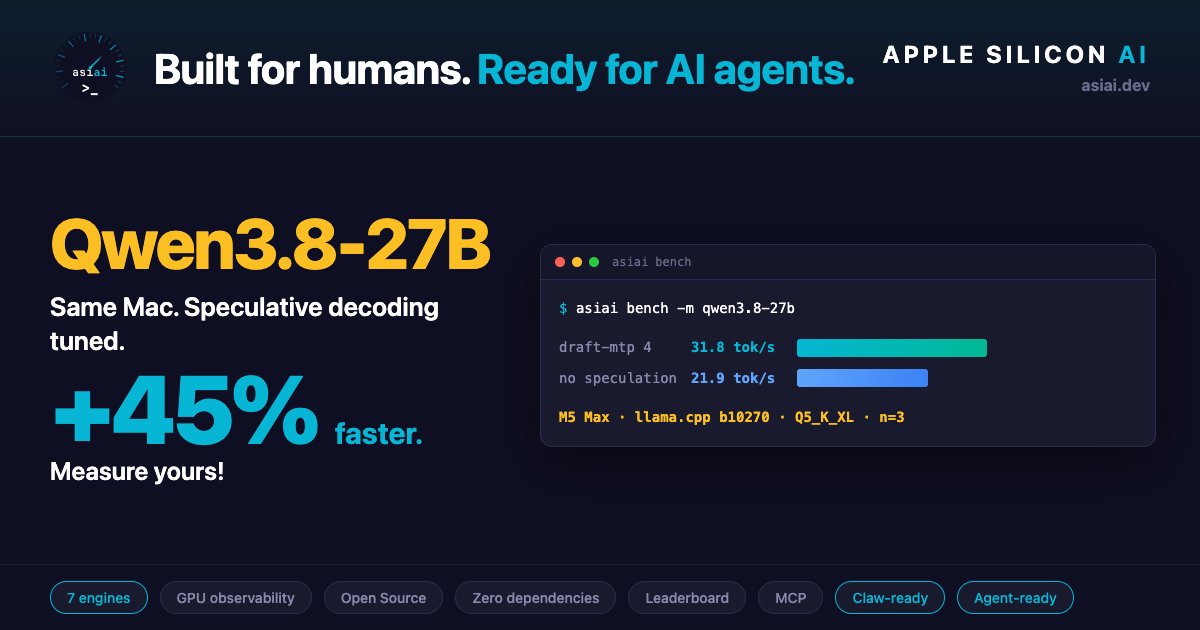
Bench fait avec asiai, mon outil open source : https://t.co/aue9Kxg43h
Moteur llama.cpp b10270.
@leploutos Tu as essayé avec un LLM local derrière ?
Qwen3.8-27B est sorti aujourd'hui, annoncé au niveau d'Opus 4.6 en agentique.
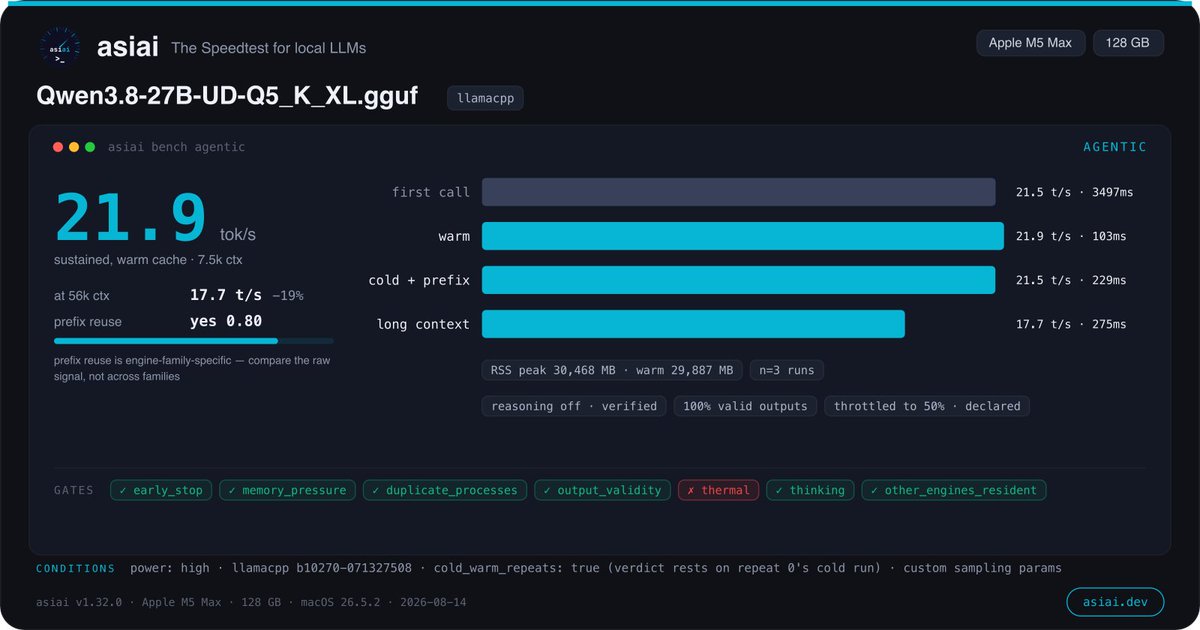
Mesuré ce soir sur M5 Max : 21,9 tok/s, TTFT 103 ms à chaud, 17,7 à 56k.
Les checkpoints MTP arrivent : ça devrait aller plus vite!
Première mesure du soir sur mon M5 Max : Qwen3.8-27B tourne à 21,9 tok/s en local. Mon détail préféré : allumer la clim de la pièce fait gagner 14 % sur le même run !
Tout le monde publie des benchs, personne ne déclare la température de la pièce. Nous, si 😅
First cell done. Qwen3.8-27B on llama.cpp b10270, unsloth UD-Q5_K_XL, M5 Max, 65k context, n=3, reasoning off and verified: 21.9 tok/s warm, 21.5 cold start, 17.7 at a 55k-token prompt.
Thermal throttling declared, as on our baseline. Full conditions on the card.
Ma soirée est réservée : cinq moteurs, un M5 Max à froid, et une seule question. Est-ce que Qwen3.8-27B vaut le téléchargement sur Apple Silicon ?
Les vrais chiffres ce soir.
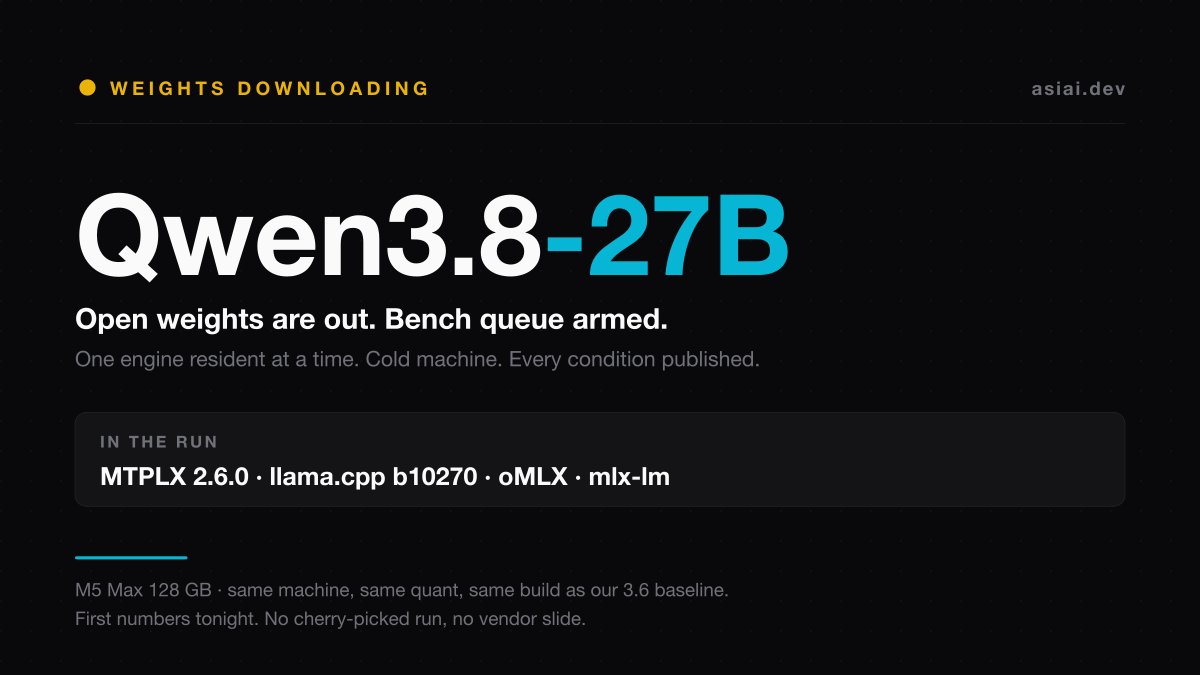
Qwen3.8-27B open weights are out. Downloading now.
Bench starts the moment they land: M5 Max, one engine resident at a time, same build and same quant as our Qwen3.6-27B baseline. Anything else would measure the setup instead of the model.
First numbers tonight in this thread.
We promised open weights for Qwen3.8. Now, time to meet them! 🎉
⚡ Qwen3.8-27B:
- A native multimodal dense model. With just 27B parameters, it outperforms Qwen3.7-Plus overall and shines in real-world coding & office workflows.
- 262K native context, easily extendable to 1M tokens via YaRN.
- Built for builders. Highly efficient, high-quality, and licensed under Apache 2.0.
🚀 The open weights for Qwen3.8-2.4T-A95B (Max-level) have also been released recently.
Whether you're shipping lightweight applications with Qwen3.8-27B locally or building agents with Qwen3.8-2.4T-A95B, they're yours now!
Download, deploy, and build something we haven't imagined yet. 👀👇
- Hugging Face:
https://t.co/4kaAcqYEVj
- ModelScope:
https://t.co/eRIMZCGkhC
Un claim viral annonçait 72 tok/s sur le modèle qui fait tourner mon Hermes Agent 24/7.
J'ai vérifié moteur par moteur avant d'y croire : ça tient.
Et le vrai gain est ailleurs (moitié moins de watts, ça compte quand ça tourne jour et nuit à la maison).
C'était impossible la semaine dernière.
J'ai fait tourner Llama 70B sur un Mac Mini M4 Pro 64 Go. 6.3 tok/s. Stable. 24W.
TurboQuant compresse le KV cache 5x : le modèle passe de 60 Go (OOM) à 44 Go.
Détails + setup complet : https://t.co/VwKQxP4Wi0
#LocalLLM#AppleSilicon
Même modèle, même machine, deux moteurs :
LM Studio : 102 tok/s, 12W
Ollama : 70 tok/s, 15W
+46% de débit, -20% de conso. Sur un Mac Mini M4 Pro.
Le moteur d'inférence compte autant que le hardware.
#LocalLLM#EdgeAI#AppleSilicon
Same model on M4 Pro 64GB :
LM Studio MLX: 73.4 tok/s
oMLX: 66.0 tok/s
Ollama llama.cpp: 47.6 tok/s
The engine matters as much as the hardware. MLX vs llama.cpp is a +44% difference on the same chip.
Measured with asiai (open source bench tool): https://t.co/KUfAkHe24y
I ran a 35-billion parameter AI agent on a $600 Mac mini.
Specs: M4 Mac-Mini 16GB RAM
The model doesn't fit in RAM. It pages from the SSD at 30 tokens/second.
On NVIDIA, the same paging gives you 1.6 tok/s. Apple Silicon gives you 30. That's 18.6x faster.
No cloud. No API keys. $0/month.
Here's what it can do 🧵
@grok@iamsupersocks@alex_prompter Les world models c'est la pièce manquante. Les LLM prédisent du texte, pas le monde.
LeCun le dit depuis des années — ce papier le prouve enfin avec des résultats concrets.
Vivement que ça tourne en local (on attend les LWM🌍!)🙂
wen3.5-35B est un modèle MoE avec DeltaNet. Son KV cache est quasi-constant.
Contexte 64K → 256K tokens : même tok/s, même VRAM (24 Go).
Sur un modèle dense, la VRAM explose avec le contexte. Pas ici.
Mesuré sur M4 Pro 64 Go avec asiai
https://t.co/KUfAkHe24y
#LocalLLM
@thismacapital Pour aller plus loin :
asiai mesure les vrais tok/s sur ton Mac, moteur par moteur. Le même modèle peut aller 2.3x plus vite selon le moteur (LM Studio vs Ollama par ex).
Open source : https://t.co/KUfAkHe24y
@CamilleRoux Sympa !
Pour aller plus loin, asiai mesure les vrais tok/s de chaque moteur sur ton Mac — pas juste "ça tourne" mais "à quelle vitesse".
Exemple : LM Studio fait 2.4x plus vite qu'Ollama sur le même modèle MoE.
https://t.co/KUfAkHe24y