Ya esta funcional la pagina de la academia de binary gecko de reversing
https://t.co/knkcGNNgSI
Pueden bajarse el desafio de alli y intentar solucionarlo para lograr entrar a la segunda version del curso gratuito
Si estáis empezando a trabajar con Linux, como @diegomarino, os recomiendo esta web donde aprenderéis los comandos básicos de forma divertida 👉 https://t.co/EqE6cm24u0
✨ xAI publicó ayer el algoritmo de X y no entiendo cómo nadie se ha dado cuenta de lo que realmente tiene en sus tripas
Me he fundido 500 pavos en Claude analizando hasta la última línea
Esto es lo que he descubierto (POST LARGO, guárdatelo para luego):
0/ Cada cuenta tiene un "embedding" asociado que te describe como lo hacen los modelos de IA: en el espacio latente. Es la huella digital interna que el modelo guarda de cada usuario, un vector de números que resume cómo se comporta tu cuenta (qué temas tocas, qué engagement generas, con quién interactúas). El modelo lo usa cada vez que decide a quién enseñar tus posts. Si tu historial es bueno, queda limpio y el modelo te empuja. Si vas acumulando señales negativas (bloqueos, mutes, reports, not_interested), se vuelve tóxico y empieza a penalizarte automáticamente. Y la trampa: NO se resetea. Lo que hagas hoy sigue dentro durante semanas, contaminando todo lo que publiques después, aunque sea bueno.
Por eso salir de un shadowban o de épocas de bajo alcance se siente en X como intentar mover una gigantesca rueda oxidada: no es tu imaginación, es así tal cual. Limpiar/mejorar tu embedding es algo lento y farragoso, es como la impresión que tienes de alguien que te cae mal: por muy simpático que se vuelva contigo, va a pasar bastante tiempo hasta que te fíes de él.
Otro descubrimiento importante: el embedding no decae con un reloj. Decae con engagement NUEVO entrando al sistema. Si dejas de postear, las señales malas viejas se quedan congeladas dentro: nadie las sobrescribe. Si comienzas a crear contenido que al algoritmo le gusta, notarías mejora a partir de las 6-8 semanas y un cambio decente sobre las 12-16 semanas, asumiendo que no acumulas más señales malas en medio.
¿Por qué nadie está hablando de esto? Me parece tremendo y por fin una confirmación de esa sensación de "estoy en una mala racha" por la que todos hemos pasado.
1/ Los primeros 30 minutos lo son TODO
Si tu post no recibe interacciones rápido, Grok ni siquiera lo evalúa. Sin nota de calidad, sin análisis profundo, sin posibilidad de llegar a quien no te sigue. Muerto y enterrado
2/ La edad del post tiene un cap de 80 horas:
POST_AGE_MAX_MINUTES = 4800, en buckets de 1 hora. Después estás en el "overflow bucket" que se traduce como "antiguo, ignorar"
Mejor ventana: las primeras 0 a 12 horas. Pasadas las 24 ya estás en un bucket peor
Vamos, lejos de incentivar el contenido "evergreen", X quiere carnaza fresca continua (todo lo contrario que YouTube)
3/ MI MAYOR MIEDO ERA INFUNDADO (se supone): vivir en EU y postear en inglés para audiencia US: CERO penalización directa en teoría:
El struct PostCandidate no tiene NINGÚN campo de país del autor, IP ni localización. Gizmoduck (el servicio de identidad de X) solo devuelve follower count + screen name. El transformer de Phoenix solo ve un hash de tu author_id
Lo que sí te jode indirectamente: el huso horario (tu post envejece mientras US duerme) y el idioma DEL POST
Vamos, que usar una VPN para "postear desde US" no hace literalmente nada (a diferencia que en TikTok o Instagram, por cierto)
4/ Las 5 señales negativas que matan tu alcance:
El modelo predice 22 acciones por post. 5 son pesos negativos que se RESTAN de tu score:
- not_interested
- block_author
- mute_author
- report
- not_dwelled (gente haciendo scroll sin pararse en tu post)
Esa última es brutal la verdad. Un post que se ignora es matemáticamente PEOR que uno que nunca se llegó a publicar
5/ Los shadowbans existen 100%. Hay 4 tipos distintos:
- Hard drop. X borra tu post del feed de todo el mundo sin avisarte. Se aplica a posts con contenido grave (abuso infantil, etc.) o cuentas suspendidas. Tú ni te enteras
- Etiqueta DO_NOT_AMPLIFY. Es literalmente un campo en el código que dice "no amplificar este post". Si te la ponen, los anuncios dejan de aparecer al lado de tus posts → X deja de ganar dinero mostrándote → el sistema deja de pushearte. Apagón en seco
- Reglas de BotMaker. Es el panel interno desde el que los empleados de X pueden limitar a una cuenta concreta a mano. En el código se ven las categorías que existen (Content, ContentLimited, Safety, Grok) pero NO se ve a quién se las aplican ni por qué. La herramienta está documentada, los usos no
- Embedding envenenado. El más jodido como ya vimos antes. El modelo tiene una "memoria" interna por cada cuenta. Si tu cuenta acumula suficientes "no me interesa" + bloqueos + silencios + reports a lo largo del tiempo, esa memoria se vuelve tóxica. A partir de ahí, incluso tus buenos posts futuros se penalizan automáticamente. Nadie lo decidió. El modelo simplemente aprendió que tu cuenta da mal engagement, y se autocorrigió
6/ Solo los posts ORIGINALES pasan por el "Banger Screen"
Las respuestas y retweets nunca entran en el clasificador de calidad de Grok. Si te pasas el día respondiendo a cuentas virales, estás optimizando para el Reply Ranker, NO para la amplificación
¿Quieres que te descubran fuera de tu red? Escribe posts originales, no hay otra
7/ Las respuestas a cuentas pequeñas pasan por escáner anti-spam. Las respuestas a cuentas grandes pasan por Grok
Dos clasificadores distintos. El SpamEapiLowFollowerClassifier pega a las respuestas a cuentas pequeñas. El ReplyRanker puntúa de 0 a 3 con Grok las respuestas a cuentas grandes
"¡Primero!" o respuestas solo con emojis sacan un 0. El rollo tipo "Sir, this is a Wendy's" se penaliza. Vamos, que si escribes respuestas, más te valen que aporten algo, si no, mejor ni te molestes
8/ El 50% de todas las peticiones al feed son "tráfico shadow"
is_sampled(request_id, 0.5) marca como shadow la mitad de cada feed request. Muchas features contextuales (inferencia de género, demografía, preferencias de topics Grok) solo se activan en shadow O con un feature flag
Traducción: literalmente no puedes saber qué versión del algoritmo está viendo cualquier usuario. La mitad de tu audiencia está en un experimento en cualquier momento
9/ El dwell (el tiempo que un usuario se queda mirando tu post antes de hacer scroll) es 5x veces mejor que recibir likes
El scorer tiene 5 señales distintas de dwell (dwell, cont_dwell_time, click_dwell_time, etc.) pero solo 1 señal de favorito.
- Un post con un montón de likes pero la gente lo lee 1 segundo y sigue scrolleando → score bajo
- Un post con pocos likes pero la gente se queda 8 segundos leyéndolo → score alto
¡Optimiza por tiempo pasado en tu post, no por likes!
10/ Cosas que sí funcionan:
- Engagement en los primeros 10 min. Manda DM a tus colegas, pingea a tu comunidad, lo que sea
- Postea en la zona horaria de TU AUDIENCIA, no en la tuya. Para targetear US: 8 a 11am ET (14 a 17 hora Madrid)
- No postees 5 cosas seguidas. El AuthorDiversityScorer multiplica cada post siguiente tuyo por decay^position. Para el post 4 ya estás en el suelo
- Vídeo ≥ 10 segundos. Por debajo de MinVideoDurationMs pierdes el peso VQV entero
- Vídeos con audio. Grok corre ASR (speech to text) en cada vídeo. Sin audio = señal en blanco
- Cita virales de tu nicho. El modelo ya sabe que el original engancha, tu valor añadido se apila encima
11/ Cosas que te destrozan el alcance:
- DESCUBRIMIENTO DE LA HOSTIA: hilos de más de 10 tweets. El DedupConversationFilter solo deja 1 tweet por conversación por feed. Los megahilos son matemáticamente un desperdicio
- Repostear el mismo contenido. Los bloom filters lo deduplican
- AI slop. Hay literalmente un campo slop_score en el output del BangerScreen. Lo detectan explícitamente
- NSFW/violencia/odio sin etiquetar. Auto MediumRisk = sin ads = shadowban estructural
- Spamear respuestas a cuentas pequeñas. Hay un clasificador específico para eso
12/ Lo que NO han publicado los muy pillines:
El esqueleto es público. Los diales no
- Los valores numéricos exactos de cada peso (FavoriteWeight, ReplyWeight, OonWeightFactor, AuthorDiversityDecay). Viven en xai_feature_switches::Params, config externa
- Los prompts reales de Grok (los 7 prompts de policy PToS, BangerMiniVlmScreenScore, SafetyPtos). Pueden tener literalmente cualquier framing
- Las reglas de BotMaker que aplican DO_NOT_AMPLIFY a cuentas concretas
- util/phoenix_request.rs, que construye la llamada final al modelo
- 25+ crates xai_* referenciados pero no incluidos
- Los pesos del Phoenix de producción. Solo han publicado la versión mini
Mi teoría: nos han puesto un esqueleto algo escuchimizado del total que tienen. El músculo (los pesos) y el cerebro (los prompts y las reglas de BotMaker) son completamente opacos. Se han reservado lo mejor, está claro
13/ Chuleta resumen para no olvidar:
- Los primeros 30 min importan más que cualquier otra cosa
- Tu ubicación es irrelevante, tu timing y tu idioma no
- Los shadowbans existen en 4 sabores. El peor es el modelo envenenándote el embedding de autor en silencio a partir de señales negativas pasadas, levantar caveza limpiando tu embedding te va a costar horrores, pero se puede
- Las respuestas y retweets no pasan por el clasificador de calidad. Los originales sí
- El dwell (que alguien se quede mirando tu post) le gana al like 5 a 1
- La mitad del tráfico está en algún experimento en cualquier momento
- Se han reservado lo mejor del algoritmo, pero bueno, algo es algo
¡Esta colección de SKILLS lo está petando!
Basadas en la experiencia real de Matt Pocock.
Comandos para:
✓ reducir tokens y quitar paja
✓ diagnosticar bugs con método
✓ mejorar la arquitectura del proyecto
De código abierto:
→ https://t.co/NsUxRRw4nr
Este simulador web te deja probar arquitecturas reales antes de implementarlas: APIs, bases de datos, cachés…
Identifica cuellos de botella y fallos antes de gastar horas en debugging.
¡Este proyecto clona cualquier voz en segundos!
Se llama Voicebox, es Open Source y corre en local
✓ 23 idiomas
✓ 5 motores TTS disponibles
✓ Rendimiento Top: Tauri + Rust
Privacidad real y mucho potencial para apps con voz
→ https://t.co/7GnJ3kMEU3
> be me, 34 años, funcionario A1 de los Altos Cuerpos del Estado en Zamora
> lunes por la mañana, 08:05 am
> llego a la diputación y ficho. La tranquilidad que da saber que ya estoy facturando
> me siento en mi silla ergonómica comprada con los fondos Next Generation (la pedí por evaluación de riesgos laborales el año pasado)
> enciendo la torre Acer negra de 2012. el ventilador suena como un Boeing 747 despegando
> Windows 7 tarda 12 minutos en cargar el escritorio. tiempo efectivo que aprovecho para mirar los resultados de 2a división en el móvil
> 08:30. abro el gestor de expedientes
> tengo que revisar la licencia de un cerramiento de aluminio negro forja para un nuevo gastrobar de tequeños que han abierto unos venezolanos en el casco antiguo
> le falta el anexo B-4 compulsado: denegado
> suena el teléfono fijo de la mesa. extensión 402
> es Rosario. Jefa de Negociado de Padrón y Licencias, C1 consolidada. el final boss del funcionariado
> lleva 35 años acumulando trienios. podría cogerse una baja por depresión o dolor lumbar crónico mañana mismo, pero viene cada día por que ama el juego
> pure love for the game
> "Luis, baja que ya tengo mesa en el bar"
> 10:15. bajo a la plaza Mayor caminando con el pecho palomo bajo mi chaleco de patagonia
> soy literalmente rey del municipio, el soltero de oro de la provincia
> paso por el mercado. las abuelas literalmente me tiran a sus nietas a los brazos
> "ay Luis, a ver si mi Carmencita pilla a un chico tan apañao como tú, que el novio que tiene está en madrid compartiendo zulo con tres peruanos por 1200 euros"
> sonrío con suficiencia. El prestigio social de un A1 no se paga con dinero
> llego a bar Los Soles. Le digo al dueño: "jefe, lo de siempre"
> me pone un pincho de tortilla poco cuajada y un cortado
> Rosario me cuenta que el concejal de Urbanismo se está divorciando de su mujer
> mientras me lo cuenta saco el móvil, abro el tuiter y veo a un notas que dice que los funcionarios cobramos poco
> el tal Mihura sube una captura de ChatGPT. Veo que no ha tenido en cuenta los complementos de productividad
> el honor del cuerpo superior está en juego
> tecleo furiosamente con los dedos manchados de aceite de girasol de la tortilla: "Seguramente no sabes ni mirar los sueldos. los complementos no son públicos, la IA está a por uvas. 70k me levanto yo. Y no hablemos de las condiciones"
> le doy a enviar. la administración pública española respira tranquila
> el café se alarga hasta las 11:45
> "uy, cómo pasa el tiempo cuando una trabaja", dice Rosario con sorna mientras deja 1,20€ de propina
> vuelvo al despacho. apruebo un vado permanente
> 14:00. ya no se puede empezar ningún trámite nuevo, que luego me pilla el toro
> mientras abro el idealista para hacer tiempo
> miro unos adosados que podría pagar a tocateja, pero me da pereza mudarme
> 14:55. voy cerrando el outlook
> 15:00 en punto. el boli cae a la mesa. La estampida de los ñus en El Rey León se queda en una anécdota comparada con la salida del edificio de urbanismo
> 15:10. estoy en casa
> me hago unos macarrones con tomate y atún
> me siento en chaiselong del sofá Kivik de mi piso de 120m2
> silencio absoluto en el salón
> la tarde entera por delante. todos los días. durante los próximos 30 años
> miro por la ventana cómo el sol pega en los tejados de uralita de Zamora
> me acuerdo de mi yo de 13 años
> soñaba con diseñar naves espaciales, con descubrir cosas, con comerme el mundo
> quería dejar mi huella en la historia
> recuerdo cuando acabé la carrera y se me acabaron las prácticas
> mis padres me sentaron y me dijeron: "hijo, no te compliques, sácate la plaza"
> les hice caso. Me encerré tres años en mi cuarto a memorizar el BOE
> lo conseguí: he ganado el juego
> He alcanzado la cúspide de la pirámide de Maslow
> he salido del matrix español
> pero una angustia rara me recorre el pecho
> me doy cuenta de que mi vida ya se ha escrito
> que mi mayor hazaña ya fue
> ya no hay dragones que matar
> no hay riesgo, ni gloria
> tan solo quedan días de asuntos propios, acumular trienios y pinchos de tortilla con Rosario hasta la jubilación
> suspiro
> "bueno, podría ser peor"
> pongo Saber y Ganar y me echo a dormir
El tweet de
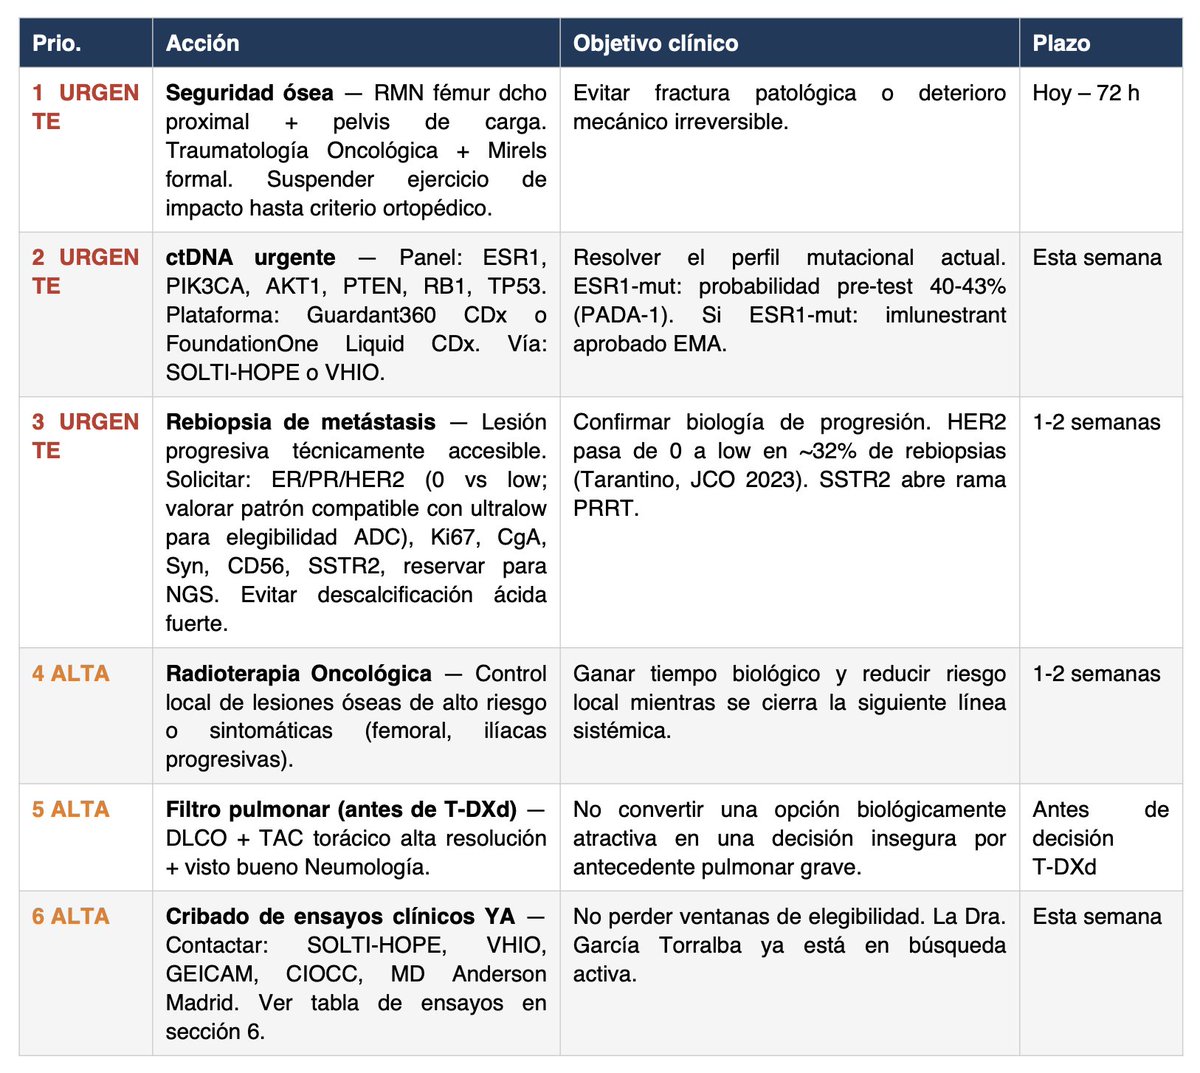
@miriamgonp me empujó hacia la IA orientada a la salud. @javilop pasó una semana aplicando IA al historial médico de Míriam y compartió su metodología. Yo lo hice app. MedSynth: análisis adversarial para historiales médicos complejos. https://t.co/xcY9km97dj
🔴 NECESITO TU ATENCIÓN
Llevo una semana ayudando a Miriam en su caso de cáncer metastásico y quiero compartir la metodología que he estado usando porque es absolutamente replicable.
Pienso que, con suerte, puede ser ÚTIL A OTRAS PERSONAS con cáncer (o con cualquier otra enfermedad).
Los resultados que hemos conseguido no son un milagro, pero pensamos que son realmente útiles y pueden significar una diferencia crucial en un caso médico de vida o muerte.
Aquí va paso a paso el método:
1/ Usar los modelos más avanzados del momento (por desgracia de pago, y no son baratos, opino que Sanidad Pública debería invertir en esto):
- ChatGPT Pro + Extended (40min de pensamiento aprox por llamada)
- Claude Opus 4.6 MAX
Pendientes de probar a fondo:
- Perplexity Sonar Pro
- Notebook LM
2/ Dárselo MUY MASCADO a la IA todo el historial. Esto parece una tontería pero es muy importante.
- Lo primero que pido, con Claude Cowork que tiene acceso al disco duro, es que entre en la carpeta en la que está TODO EL HISTORIAL (pueden ser más de 100 pdfs) y lo unifique todo en:
- Un único PDF (puede ser de más de 1000 páginas o lo que sea necesario)
- Un único txt legible, que debe hacer correctamente usando un script con OCR y luego comprobar con lupa que está bien hecho.
Insisto: no saltar al siguiente paso antes de tener muy bien hecho lo anterior, sobre todo el txt.
3/ Una vez tenemos lo anterior utilizar este prompt junto con el txt y el PDF como archivos de entrada y lanzarlo en AMBOS modelos (y en más si es posible) a la vez.
👉 Os lo dejo aquí, este prompt es increíble complejo/avanzado: https://t.co/KEEWc8WNvW Está pensado para el caso concreto de Miriam, pero con los modelos del punto 1/ podrías adaptarlo a tu caso particular sin problemas.
4/ La PUNTA DE FLECHA enfrentando un modelo al otro: esta metodología no la he escuchado a nadie, pero funciona increíblemente bien. La sensación es la de ir afilando una estaca hasta que adquiere una punta reluciente.
Funciona así: con paciencia y en sucesivas iteraciones (aconsejo mínimo 5 veces, y en en cuenta que si ChatGPT tarda 40min te va a llevar un buen rato) enfrenta el resultado (el PDF) de un modelo a otro. Con un prompt sencillo del estilo:
"Otro comité de expertos opina esto. ¿Cómo lo ves? Si estás de acuerdo o lo contrario dime por qué, y genera un nuevo PDF si lo ves preciso".
El resultado se lo cruzas al modelo contrario. Así, en sucesivas iteraciones, búsquedas de internet, papers, etc. irán encontrando y afilando más cosas.
¿Cuándo acabar? Cuando AMBOS modelos digan que está perfecto y no puedan mejorar más el trabajo del contrario. Esto es tan absurdamente rompedor que pienso que los resultados de TODOS los modelos actuales mejorarían si siguieran esta metodología (apoyándose en una espiral rollo "adversarial model". No entiendo por qué nadie se ha dado cuenta de esto, si lo ha hecho, por qué no se le da más bombo. Funciona impresionantemente bien en cualquier ámbito, inclusive programación y matemáticas.
Es mas, mi teoría es que esto podría hacerse todavía mejor haciéndolo no solo con dos modelos: sino con una mayor combinatoria, añadiendo quizás Perplexity Sonar Pro, etc.
RESULTADOS
Increíbles. Obviamente no puedo saber si mejores que el mejor de los comités científico-sanitarios del mundo, pero le están dando a Miriam una nueva dimensión del caso, tests adicionales que hacer, posibles pruebas, etc.
Obviamente la IA milagros no hace, pero pienso que puede ya, a día de hoy, ayudar a muchos pacientes. Y Sanidad Pública debería invertir mucho, pero mucho, en esto.
Voy a preguntarle a Miriam si puedo poner el PDF completo de resultados más avanzado que conseguimos, para que os hagáis una idea de su calidad. Ya me ha dado más o menos permiso, pero quiero asegurarme 100%.
Don't think I've heard any other CEO describe agent use in such detail before. @pedroh96 out here running a $5bn company on OpenClaw
Full episode with lots more detail in the replies
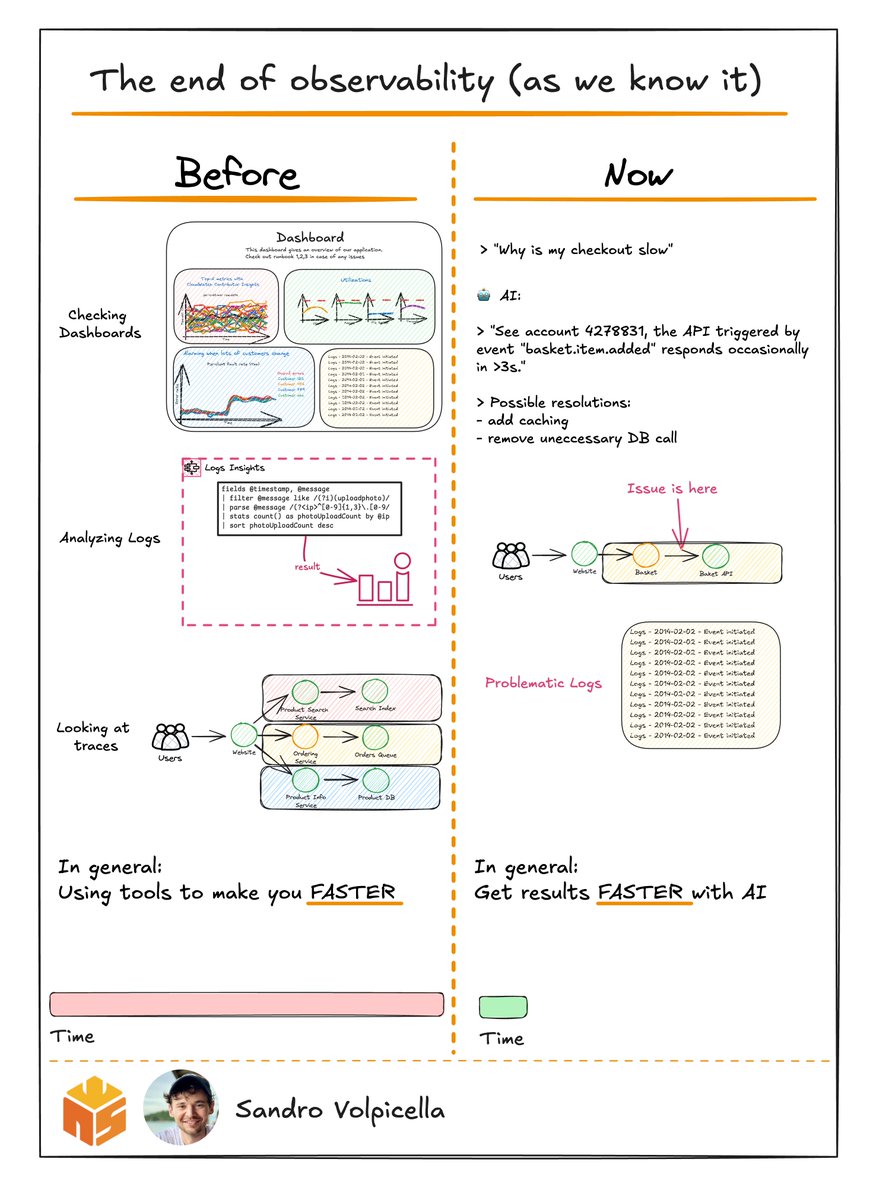
Honeycomb published a blog post called "The End of Observability as We Know It."
I've been using observability tools for years now. Heck, I wrote a book about CloudWatch ⛅
And honestly? I like the take of this post.
Let's see a typical daily observability issue:
- You have 5 AWS accounts.
- Each account runs different services that interact with each other.
To be able to find issues you use tools that observability providers have built for you like:
📜 Logs
📊 Dashboards
🕸️ Traces
Every feature is there for you to help you find the problem FASTER.
This is what Austin states: SPEED MATTERS.
And I like that take. In the end, you want to get results fast. You don't care how you get the results.
This is where AI & LLMs come in.
They're just much faster at digging through tons of data.
Let's say you have a production issue like your checkout is slow.
As a developer, you don't care about which tool you use to find the issues.
You care about finding the solution.
With proper AI it could look like that:
> "My checkout is slow for some customers, why?"
…🤖
> "Account 42783330 has occasional spikes over 3s. Could you use caching? Or I saw two database calls that aren't necessarily needed at this part of the code."
Sounds good at a first glance.
But I want to actually see the root cause.
Maybe caching is just fixing the symptom.
But the actual root cause is something completely else.
I think AI shouldn't be 100% only text-based.
It should also show you the exact investigation path in the tools you already know how to use.
You need to use it in a combination. If it helps you get to the goals faster, that's great!
I've always loved Honeycomb's resources on observability 📚
Before writing my CloudWatch book, I read their "Observability Engineering" book. It's amazing.
Their blog is also a gold mine for understanding that observability is more than just dashboards and three pillars 😉
Thank you to Honeycomb for inviting me to explore their solutions and sponsoring this content.
🔗 Check out the blog post (includes real-world examples): https://t.co/Mi6qZpUgDp
¡AWS tiene SimuLearn gratis hasta el 6 de enero!
✓ Simulaciones de casos reales para aprender Cloud
✓ Sin tarjeta de crédito ni miedo a sobrecostes
✓ EC2, NoSQL, Cloud, arquitectura, picos de tráfico...
De los mejores recursos:
→ https://t.co/io2hyYXZKk
10/
I hope this helps!
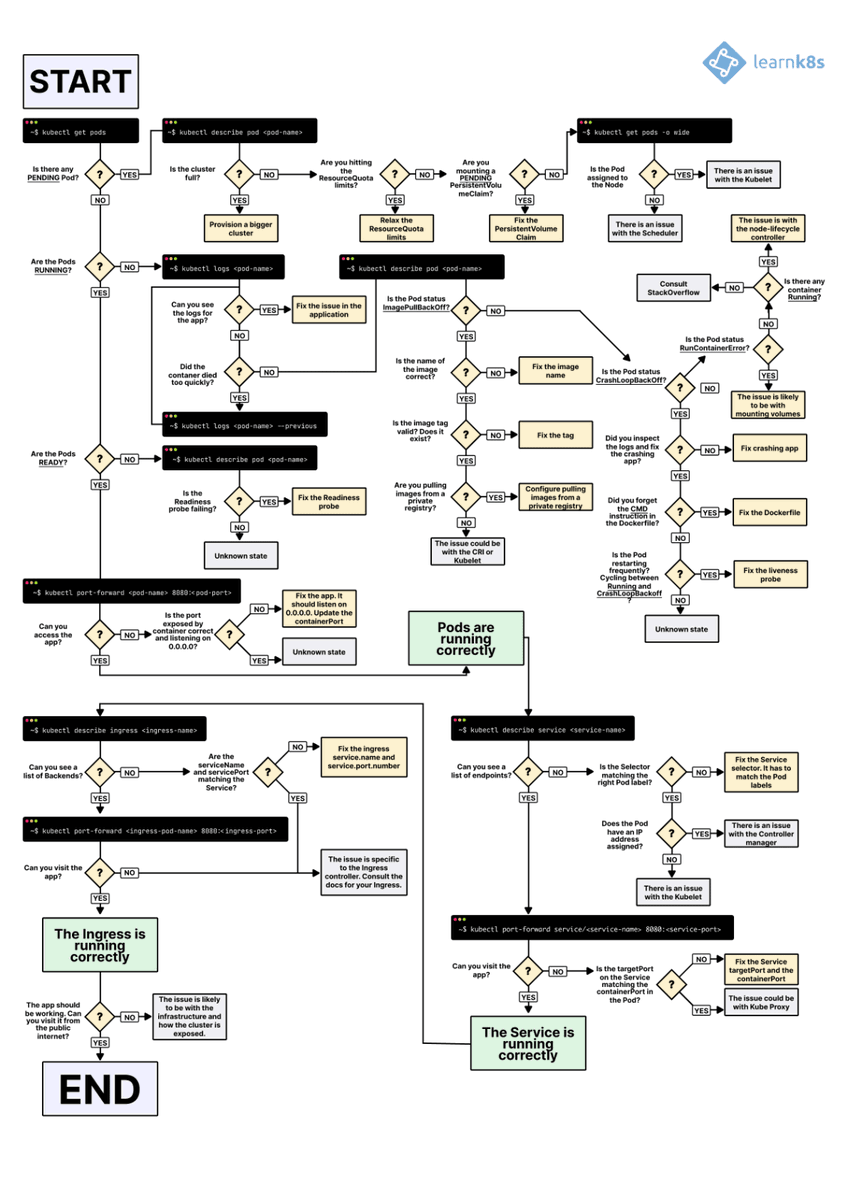
If you need more help to troubleshoot your deployments in Kubernetes, you should check out my flowchart:
https://t.co/TWJAVggNyR
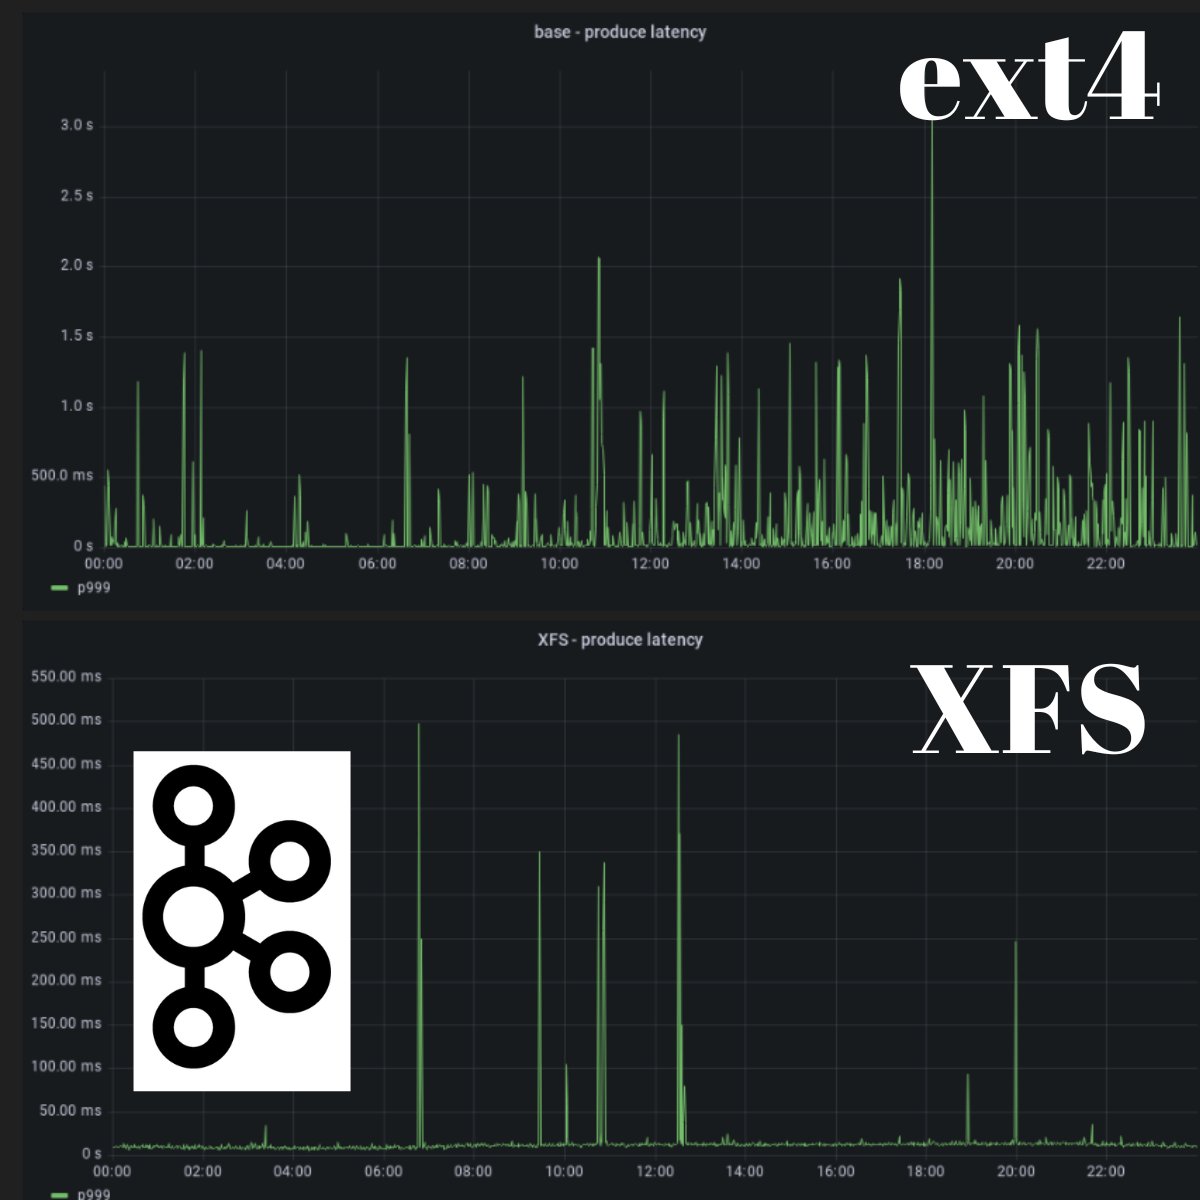
I love reading such detailed technical articles, those guys took Kafka apart and managed to understand the cause of their 3 seconds write latency in Kafka producers. Turns out it was caused by the flush/commit of the ext4 file system journal metadata. Of course doesn't mean ext4 is bad it's just not a fit for Kafka's workload. So they end up switching to XFS and improve the writes by 82%!
The way they discovered this is interesting, all the tooling they wrote for Java/Kernel is just amazing, recommend you guys checking it out.
full article
https://t.co/WxcsWoHPgm
I'll make a video covering this in details once I get a chance, I want to learn more about XFS and ext4, my knowledge there is limited.
I did a brief summary on the article on my second channel for those interested https://t.co/CZFOsrNxL9
Two months ago, I created a System Design repo on Github, and I'm excited to share that it recently reached over 3000 stars.
Thanks to everyone who has starred or forked the repository!
The repository contains a collection of resources to study:
- Around 40 System Design concepts
- Around 50 System Design problems categorized by difficulty level
My goal with this repo is to curate the best resources to learn System Design and prepare for interviews.
If you find it valuable, consider giving it a star.
Check it out here: https://t.co/pkVpi6LxSV
5 Investment Shows to watch over the Christmas Break.
I love watching shows. Here are some great ones on the Investing and Finance Industry.
1. The Industry
A young group of graduates competes for permanent positions at a prestigious London investment bank.
Holy shit, it finally happened!
Cognito has addressed a long-standing issue and lets you customize its access tokens 😍
You don't have to use id tokens anymore for custom attributes, yay!
https://t.co/haNl5aCxQI