Mi hot take sobre el futuro de la industria del software
Todo lo que diga aquí es mera interpretación desde mi punto de vista. No pretendo hacer futurología ni sentar cátedra, pero sí mojarme.
Creo que es indudable que la llegada de la Inteligencia Artificial a la programación la ha cambiado por completo. Quizás todavía no de la forma radical que algunos promulgan, pero sí la ha cambiado. Eso ya es una realidad.
Ahora bien, los cambios estructurales no se producen de la noche a la mañana. No nos vamos a levantar un día con la mitad de los puestos de trabajo desaparecidos. Pero ese día llegará. Las cosas pasan de forma gradual, a lo largo de meses o unos pocos años, como la inflación. No notas nada hasta que, de repente, te das cuenta de que los huevos cuestan el doble que hace un par de años.
Creo que algo muy parecido va a pasar con la programación.
La primera fase: el silencio
En una primera fase empezarán a moverse las grandes estructuras.
Lo primero no serán despidos masivos, sino **congelaciones de contratación**. Las empresas intentarán absorber las nuevas demandas de crecimiento con el mismo personal. Será una especie de layoffs silenciosos.
Y lo interesante es que nadie se dará cuenta. Nadie dirá que perdió su trabajo. La industria seguirá creciendo, pero sin aumentar proporcionalmente el número de personas. El output crecerá, el headcount no.
Cuando este modelo esté más controlado y, sobre todo, cuando empiecen a sentirse presionados por la aparición de equipos muy pequeños capaces de generar una competencia brutal contra los grandes actores establecidos, empezarán los layoffs progresivos.
No de golpe. Poco a poco.
Qué perfiles "sobreviven"
Desde mi punto de vista, quedarán básicamente dos tipos de perfiles.
Por un lado, los ultraespecializados. Gente muy senior, con muchísima experiencia, absolutamente fuera de serie en un área concreta. Ese nivel de expertise todavía va a tardar en ser sustituido, si es que llega a serlo del todo.
Y por otro lado, los orquestadores. Personas multidisciplinares de altísimo nivel. Y aquí hago énfasis en lo de alto nivel: no vale ser “un poco de todo” con poca profundidad. Hablo de gente que entiende producto, tecnología, infraestructura, negocio y trade-offs reales. Roles que hoy ocupan muchos CEOs o CTOs fuertes.
La gente de producto seguirá existiendo, pero cada vez más cercana a la tecnología real. Menos PowerPoint y más comprensión profunda de lo que se construye.
Los grandes perdedores: el middle management
Creo que los perfiles más afectados serán los middle managers.
Su trabajo se basa en ser piezas dentro de estructuras de procesos jerárquicas. Aportan valor principalmente desde la gestión, no tanto desde la construcción directa del producto.
No encajan en la ultraespecialización, pero tampoco en el perfil transversal fuerte.
Quedan en tierra de nadie.
¿Aplica la paradoja de Jevons a la programación?
Aquí es donde siempre tengo la duda.
Podría plantearse un escenario optimista: si baja el coste de crear software, si hacer una aplicación pasa de costar 100.000 dólares a costar 3.000, la demanda podría dispararse. Muchísima más gente podría permitirse crear software. La industria, en lugar de contraerse, crecería.
Este razonamiento encaja muy bien con la paradoja de Jevons: cuando un recurso se abarata, su consumo total aumenta.
El problema es que, objetivamente, tengo la sensación de que en software no aplica del todo.
Y no porque el software vaya a desaparecer. Todo lo contrario: el software va a estar más presente que nunca en todos los aspectos de nuestra vida. Todo será software. Y la otra mitad hardware. Y la otra mitad experiencias físicas.
La pregunta no es si habrá software, sino si necesitamos tanto software nuevo.
El elefante en la habitación: ¿queda innovación real?
Esto es algo que ya venía de antes de la IA.
Llevamos un par de décadas creando grandes categorías digitales:
- Comunicación y redes sociales
- Movilidad, logística y servicios bajo demanda
- Economía digital personal
- Productividad, trabajo y software utilitario
- Salud, fitness y bienestar
- ...
La pregunta es: ¿independientemente de la IA, dónde acaba esto?
¿Por qué necesitamos otra app de notas más? ¿Cuándo necesitamos una nueva red social?
¿Necesitamos el nuevo Facebook? ¿El siguiente Notion?
¿Hay hueco para más innovación a esta velocidad?
Tengo la sensación de que los grandes conceptos ya se han creado. Hay players muy fuertes en cada categoría y no veo un futuro de hiperfragmentación infinita en miles de nichos absurdamente específicos.
No veo el escenario de "una app de notas para creadores", "una app de notas para futbolistas", ...
Y aunque la IA abarate el coste y haga viable cualquier micro-nicho desde el punto de vista económico, aparece otro problema enorme: la distribución.
El problema de la distribución no es nuevo. Lo único que hace la IA es agravarlo.
Aquí entra de lleno la attention economy: el recurso escaso ya no es el código, ni el talento técnico, ni siquiera el capital. Es la atención humana.
Si existen 10 millones de aplicaciones de notas, da igual lo buena que sea la tuya: competir por atención se vuelve casi imposible. La abundancia extrema no libera, satura.
Por eso tiendo a pensar que la IA no va a generar una explosión de nuevos productos exitosos, sino acelerar la comoditización de la tecnología que ya estaba en marcha.
Quedarán dos mundos: gigantes y artesanos
Aquí encaja muy bien el marco clásico de Porter: comoditización vs diferenciación.
Cuando el coste de producción se desploma, solo sobreviven dos extremos:
1. Los grandes: Grandes empresas tecnológicas con músculo, capacidad de amortiguación y, sobre todo, distribución. Plataformas que te dan correo, notas, pagos, almacenamiento, lo que sea. Aquí aplica claramente un modelo winner takes most: pocos ganan mucho, muchos compiten por migajas.
2. Los artesanos: Pocos, selectos, casi artesanos del software. Productos muy curados, muy especializados, o con una ventaja clara de autoridad, marca o distribución propia.
El término medio, el grueso de productos y empresas "correctas pero no extraordinarias", desde mi punto de vista, desaparece.
Esto nos lleva a pensar en que existe un cambio estructural de fondo
Hasta ahora, el crecimiento de la industria tecnológica se basaba en una limitación clara: no había suficientes ingenieros.
Muchísima demanda para muy poca oferta. Eso elevaba salarios, atraía inversión y generaba ese clima de abundancia, de "dinero fácil", de crecimiento casi automático.
Con el abaratamiento masivo del trabajo intelectual técnico, la pregunta clave es:
Si reducimos el coste de creación por diez, ¿se multiplica la demanda por diez?
Y la verdad es que tengo mis dudas.
Esto no va a pasar de golpe. Será lento, silencioso. Un día te despertarás y te darás cuenta de que todo ha cambiado. Siempre pasa así.
Si seguimos tirando del hilo, esto nos lleva más allá del software: la comoditización del trabajo intelectual
Y aquí ya no hablamos solo de programadores.
Mi apuesta es que esto forma parte de algo mucho más grande: la comoditización del trabajo intelectual.
Nos tranquiliza pensar que la IA "no es realmente inteligente", pero la mayoría de trabajos del planeta no requieren inteligencia en el sentido humano. Requieren conocer un conjunto de datos, saber consultarlos y devolver respuestas coherentes.
La auténtica revolución es poder consultar bases de datos semánticamente y poder obtener respuestas ad-hoc y de forma instantánea.
Ese es el gran avance. No la inteligencia, sino la búsqueda semántica real.
Antes necesitábamos un experto intermedio que tradujera una pregunta humana a un lenguaje técnico, consultara la base de conocimiento y devolviera una respuesta. Ese intermediario ya no es imprescindible.
Esto no es algo que vaya a pasar. Esto ya ha pasado.
¿Y ahora qué?
No voy a aventurarme a predecir qué ocurrirá en 10, 15 o 20 años. No tengo ni idea.
Pero ya que me estoy enfangando, hagámoslo hasta el fondo.
Hay algo que sí tengo claro: esta conversación no va solo de software, ni de ingenieros, ni siquiera de tecnología. Va de qué hacemos cuando el trabajo deja de ser el eje central de la vida.
Vamos a vivir, queramos o no, debates profundos sobre rentas básicas universales, sobre el valor social del trabajo, sobre el propósito, sobre identidad.
Para mí, la pregunta no es si ocurrirá. La pregunta es: ¿en qué momento vamos a empezar a hablar de esto en serio?
Si has llegado hasta aquí, me encantaría conocer tu opinión.
Todo lo que he expuesto, no es más que un divague manifestado en voz alta de algo a lo que llevo dando la vuelta hace meses, y para lo que todavía no tengo respuesta con certeza.
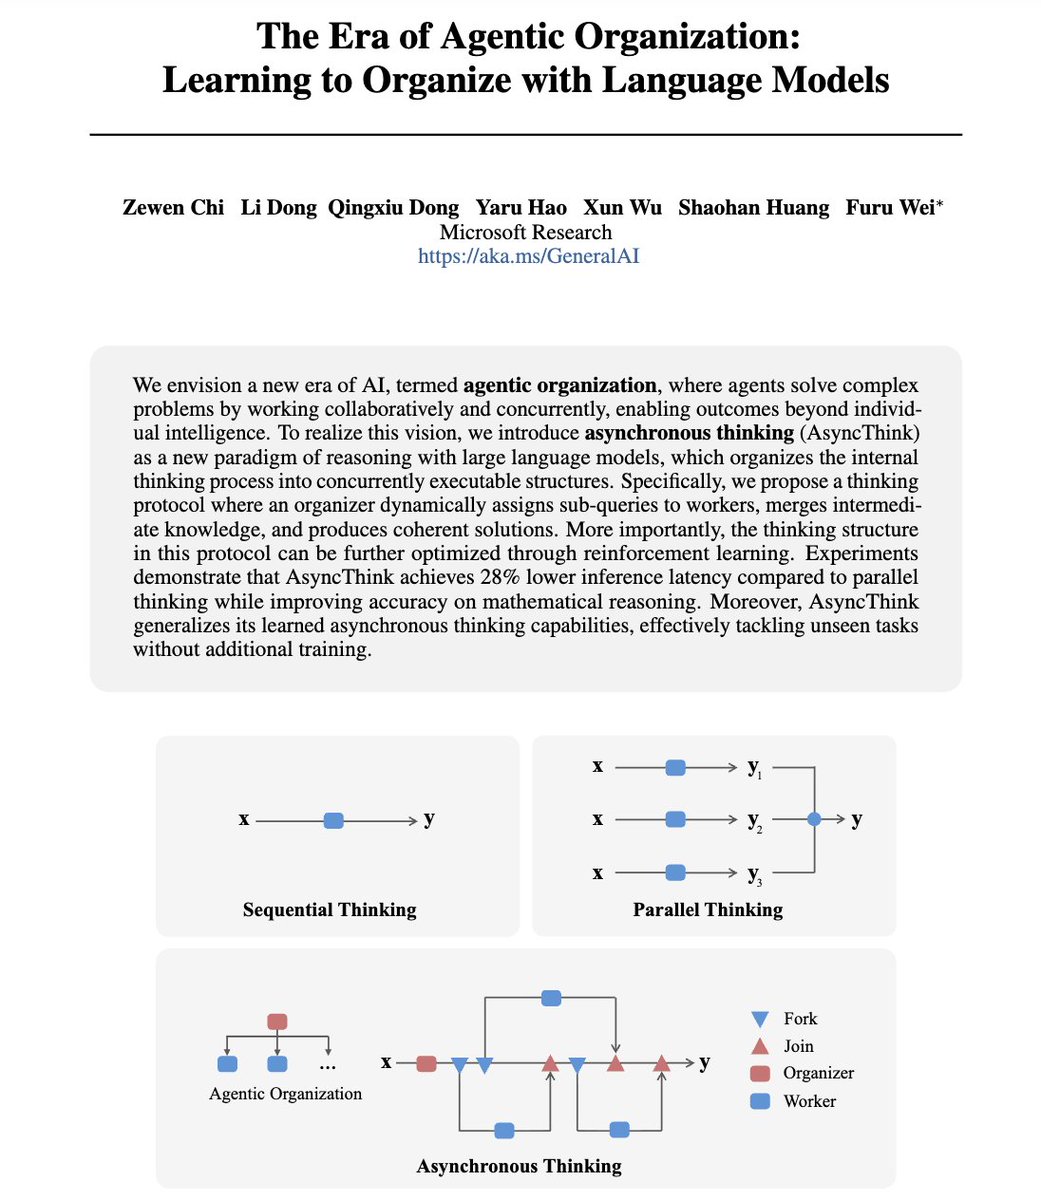
🚨 Microsoft Research just launched something that might define the next era of AI systems.
They call it 'Agentic Organization' and it’s not just a new model. It’s a new way for intelligence itself to organize.
Here’s what’s wild:
Most large language models still “think” like a single brain.
Step-by-step. Linear. Slow. Even “parallel thinking” just runs the same process twice and merges answers later.
Agentic Organization changes the entire game.
They built a new reasoning protocol called AsyncThink, where a model plays both roles an Organizer that breaks a complex problem into sub-queries, and Workers that solve those sub-parts at the same time.
Think of it like this:
Instead of one mind grinding through steps, AsyncThink forms a mini civilization of minds delegating, merging, adapting in real time.
And it learns this behavior through reinforcement learning literally learning how to organize its own thoughts.
The results are insane:
→ 28% lower inference latency than parallel thinking
→ Higher accuracy on math reasoning tasks
→ Zero-shot generalization to unseen problems like Sudoku
→ Learned organizational policies that evolve dynamically during reasoning
It’s like scaling from “an intelligent agent” → to “an intelligent organization.”
AsyncThink models don’t just reason faster they reason like teams do.
Fork. Think. Join. Verify. Iterate.
This is a glimpse of post-LLM intelligence systems that don’t just think, they coordinate thought.
And if that holds, the future of AI might look less like a single brain… and more like a company of minds.
Paper: The Era of Agentic Organization: Learning to Organize with Language Models
@elonmusk Please improve the algorithm further so it stops rewarding accounts giving crap stuff in exchange of a retweet and follow, I did that a couple of times and now my feed is full of gurus promising I'm going to mars if I comment "Mars"
RAG-Anything: #1 on GitHub Trending!
A huge thank you to the open-source community for your incredible support—clearly, the demand for multi-modal RAG is immense!
Easy-to-use: https://t.co/HFO0K4xykl
Try RAG-Anything: The ultimate All-in-One RAG Framework
🌟 Key Features of RAG-Anything 🌟
🧩 Unified Multimodal Retrieval
- Supports text, images, tables, and equations in a single unified framework.
- Seamlessly integrates diverse data formats into a cohesive retrieval pipeline.
🌐 Dual-Graph Construction
- Builds cross-modal and text-based knowledge graphs.
- Accurately aligns textual and non-textual data for deeper insights.
📚 Structured Context Injection
- Enhances long-document understanding with hierarchical structures.
- Efficiently captures dispersed multimodal evidence for more comprehensive analysis.
🔍 Hybrid Retrieval
- Combines structural navigation with semantic similarity matching.
- Balances explicit relationships with nuanced semantic connections.
🔧 Scalable & Generalizable
- A unified design eliminates the need for modality-specific architectures.
- Easily adapts to various domains and data types.
- Linux is free.
- Docker is free.
- Kubernetes is free.
- Git and Github are free.
- GitHub Actions is free.
- Python is free.
- AWS, GCP, Azure are free (limited use).
- Terraform is free.
- ArgoCD and Flux are free.
- Prometheus and Grafana are free.
Your laptop and internet connection: That’s all you need to start.
No expensive bootcamps. No fancy certifications.
Just you, your determination, and these free tools.
While others are complaining about job markets and layoffs, DevOps engineers are getting multiple offers.
Companies are desperate for people who can automate, deploy, and manage infrastructure.
The same skills that took me from X to 3X salary, All learned using free tools.
Every successful DevOps engineer started exactly where you are right now. Zero experience. Zero connections. Just curiosity.
They didn’t wait for the “perfect” time. They didn’t make excuses about not having money for courses.
They downloaded Docker, broke things, fixed them, and repeated.
Start today. Your future self will thank you.
AWS released an open-source framework that lets you orchestrate multiple AI agents and handle complex conversations.
Can be deployed locally on your computer.
She dumped me last night.
Not because I don't listen.
Not because I'm always on my phone.
Not even because I forgot our anniversary (twice).
But because,
in her exact words:
"You only pay attention to the parts of what I say that you think are important."
I stared at her for a moment and realized...
She just perfectly described the attention mechanism in transformers.
Turns out I wasn't being a bad boyfriend. I was being mathematically optimal.
See, in conversations (and transformers), you don't give equal weight to every word. Some words matter more for understanding context. Attention figures out exactly HOW important each word should be.
Here's the beautiful math:
Attention(Q, K, V) = softmax(QK^T / √d_k)V
Breaking it down:
Q (Query): "What am I looking for?"
K (Key): "What info is available?"
V (Value): "What is that info?"
d_k: Key dimension (for scaling)
Think library analogy:
You have a question (Query). Books have titles (Keys) and content (Values). Attention finds which books are most relevant.
Step-by-step with "The cat sat on the mat":
Step 1: Create Q, K, VEach word → three vectors via learned matrices W_Q, W_K, W_V
For "cat":
Query: "What should I attend to when processing 'cat'?"
Key: "I am 'cat'"
Value: "Here's cat info"
Step 2: Calculate scoresQK^T = how much each word should attend to others
Processing "sat"? High similarity with "cat" (cats sit) and "mat" (where sitting happens).
Step 3: Scale by √d_kPrevents dot products from getting too large, keeps softmax balanced.
Step 4: SoftmaxConverts scores to probabilities:
"cat": 0.4 (subject)
"sat": 0.3 (action)
"mat": 0.2 (location)
"on": 0.1 (preposition)
"the": 0.1 (article)
Step 5: Weight valuesMultiply each word's value by attention weight, sum up. Now "sat" knows it's most related to "cat" and "mat".
Multi-Head Magic:Transformers do this multiple times in parallel:
Head 1: Subject-verb relationships
Head 2: Spatial ("on", "in", "under")
Head 3: Temporal ("before", "after")
Head 4: Semantic similarity
Each head learns different relationship types.
Why This Changed Everything:
Before: RNNs = reading with flashlight (one word at a time, forget the beginning)
After: Attention = floodlights on entire sentence with dimmer switches
This is why ChatGPT can:
Remember 50 messages ago
Know "it" refers to something specific
Understand "bank" = money vs river based on context
The Kicker:Models learn these patterns from data alone. Nobody programmed grammar rules. It figured out language structure just by predicting next words.
Attention is how AI learned to read between the lines.
Just like my therapist helped me understand my focus patterns, maybe understanding transformers helps us see how we decide what matters.
Now if only I could implement multi-head attention in dating... 🤖
Still waiting for "scaled dot-product listening" to be invented.
DeepMind built a simple RAG technique that:
- reduces hallucinations by 40%
- improves answer relevancy by 50%
Let's understand how to use it in RAG systems (with code):
ChatGPT needs a 'fork chat' feature. I want to be able to branch a conversation from any point like git branch -> explore alternate timelines without ruining the main thread. or copy pasting like a freak
@kineticquant@growing_daniel This is the way to go on 2025 + Coolify huge oss library, issue with this setup is getting a prod ready app for enterprise clients
@nizzyabi Self host your git. The only reason to put ito b public is for other people to notice you.
Screw them. Build your server in your basement with RAID and self host.
Stop making people on the coast billionaires for providing services you can do in your own.