Applied AI Consultant.
Ph.D in AI and OR. AI Engineer Focused on LLMs, RAG, search, and building AI-powered software. Sharing my real-world experiences.
Abrimos la Cohorte 3 de AI Engineering: Fundamentos de Construcción de Aplicaciones de IA.
Son nueve semanas, 100% online, una sesión en vivo por semana los martes, y consultorías los jueves. Durante todo el programa construyes una aplicación de IA real y la llevas hasta producción.
Lo que vas a dominar:
- Fundamentos de LLMs y extracción de structured data
- RAG: embeddings, vector databases, hybrid search y chunking
- AI agents con tool use y razonamiento multi-step
- Evals y observability
- Memory, guardrails y despliegue de LLM applications en producción
Cohorte pequeña, máximo 20 estudiantes, para que puedan hacer preguntas, interactuar, y que cada uno reciba tiempo dedicado sobre su proyecto.
Arranca el martes 23 de junio. Las primeras 10 inscripciones tienen precio early bird.
Cupos limitados. Te dejo el link en los comentarios.
Si trabajas con software y quieres especializarte en AI Engineering, esta cohorte es para ti.
Cohorte 3 de Majup Labs: 9 semanas, de los fundamentos hasta un proyecto de IA en producción. Formato en vivo, con consultorías de soporte y cupos limitados (solo 20 cupos) para mantener el acompañamiento cercano.
Empezamos la última semana de junio / primera semana de julio. Quedan muy pocos cupos.
Más información e inscripciones en los comentarios
3ra cohorte del curso AI Engineering: Fundamentos de Construcción de Aplicaciones de IA Cuatro semanas intensivas online.
Pasas de cero a una aplicación de IA lista para producción, con sesiones en vivo, proyectos prácticos y consultorías semanales para destrabar tu código.
Los agentes de AI fallan silenciosamente. Pasa constantemente con prácticamente todos los agentes. Estos son fallos/errores que se dan durante la ejecución del agente, pero que no necesariamente se ven reflejados en la respuesta final que el agente entrega. Algunos fallos silenciosos son:
- Un agente puede entregarte la respuesta correcta, pero pudo haber llegado a ella por un camino ineficiente. Ejemplo: un agente se está ejecutando y llama tres veces la herramienta equivocada antes de encontrar la correcta. Al final responde bien, pero gasta tokens, tiempo y compute de más.
- Acumulación de errores. Por ejemplo, un agente que tiene una fase de document retrieval. En su ejecución, realiza un mal retrieval y trae documentos irrelevantes respecto a la pregunta del usuario. Se envían estos documentos como contexto al LLM y el LLM razona sobre "basura", lo cual luego produce una alucinación que parece lógica. El resultado final parece coherente, pero está mal. Le preguntas por el clima en París y te responde con datos sobre el clima en Nueva York.
Para poder detectar estos fallos silenciosos y empezar a corregirlos, necesitamos implementar observabilidad en nuestro sistema. Sin observabilidad ni tracing de los agentes, nadie se entera de estos errores silenciosos. Al momento de implementarla, hay que evaluar la trayectoria completa de lo que hace cada agente, pues evaluar solo el output final no es suficiente. Cada decisión, cada tool call, cada resultado intermedio, tenemos que tener traces de todo esto. Si no tenemos visibilidad de cada paso, el debugging se convierte en adivinar dónde puede estar el error.
En una de las cohortes anteriores del curso de AI engineering pusimos a funcionar un sistema RAG agéntico de búsqueda de hojas de vida con tracing activado. En cuestión de minutos encontramos que el sistema enviaba texto duplicado al LLM (gastando tokens sin razón), no traía candidatos que sí cumplían los requisitos, y los scores del retrieval no reflejaban la calidad real de los resultados. Nada de eso se ve si uno solo mira la respuesta final. Se ve cuando uno abre los traces y revisa paso por paso qué hizo el agente. Esto es lo que te permite distinguir entre "funciona" y "funciona bien".
Si quieres aprender más de esto, en nuestra 3ra cohorte del curso de fundamentos de AI engineering lo vamos a trabajar. Te dejo el link al curso para más información en los comentarios
Tercera cohorte del curso de AI Engineering en Majup Labs. Inicia en julio de 2026 y por primera vez ustedes votan el horario.
Las dos cohortes anteriores las hicimos lunes y miércoles a las 6 PM hora Colombia. Funcionó bien para quienes están en Bogotá, Medellín, Lima o Quito. Para los que viven en España, esa hora ya es casi madrugada. Para los que están en oficina en México, a veces no cuadraba.
Para la cohorte 3 abrí un formulario donde se pueden votar varios horarios:
Mañana en Colombia, 10 u 11 AM. Tarde temprana en España.
Mediodía u "horario de oficina", entre 1 y 4 PM hora Colombia.
Tarde noche, el horario clásico de las cohortes anteriores.
También cambia un poco la estructura: clases los lunes y jueves, office hours los miércoles. Antes eran cuatro días por semana, ahora son tres. Lo justo para que la gente pueda aplicar lo que se vio en clase antes del siguiente office hour.
El curso sigue siendo lo mismo: 4 semanas, 9 sesiones en vivo, máximo 20 cupos. Trabajamos LLM APIs, extracción estructurada con validación, RAG con retrieval híbrido (BM25 más dense vectors), agentes con tool use y observabilidad con trazas, Evals, etc. Nada de "monta tu agente/chatbot en 30 minutos".
Precio normal 430 USD. Early bird 300 USD para los primeros 10 que confirmen inscripción. Si se inscriben en grupo de 3 o más, hay descuento adicional.
Si tienen interés, llenen el formulario de preinscripción y voten por el horario que mejor les funcione. No se demoran ni 5 minutos diligenciándolo.
RAG empieza por retrieval, no por la base vectorial
RAG suele confundirse con meter documentos en una base vectorial y esperar que el modelo resuelva el resto. Ese malentendido lleva a diseñar sistemas frágiles. La pieza central es el retrieval: qué evidencia recuperas, cómo la filtras y cómo decides si sirve para responder.
Si tu aplicación busca información relevante y se la entrega al LLM como contexto, estás haciendo RAG. Ese retrieval puede apoyarse en vectores, BM25, búsqueda lexical, SQL, grafos, APIs internas o una combinación de varias fuentes. La herramienta importa menos que la calidad de la evidencia que recuperas para el caso de uso.
Gran parte del trabajo en AI Engineering está en decidir qué índice construir, qué metadata extraer, qué método de búsqueda usar, cómo fusionar resultados, qué contexto enviar al LLM y cómo medir si el retrieval está mejorando. Todo esto ni siquiera depende del modelo de LLM que uses.
Un LLM responde con la calidad del contexto que le entregas. Si el retrieval es débil, el modelo puede sonar convincente mientras usa evidencia incorrecta, incompleta o irrelevante.
RAG en producción exige diseñar un sistema de búsqueda que entienda el caso de uso, sea medible y se pueda depurar cuando falle. Conectar documentos a un chatbot es apenas una parte del trabajo.
Si quieres entender estos sistemas, y aprender a construirlos, desde integraciones de BM25 hasta hybrid search y evaluación de retrieval, en el curso de AI Engineering de Majup Labs te enseñamos todo esto y más.
Más info sobre el curso en los comentarios.
[🚨 POR FAVOR AYÚDAME A DIFUNDIR — BUSCO UN ENSAYO CLÍNICO EN CUALQUIER PARTE DEL MUNDO 🌍]
Mi nombre es Selva Alvarez, tengo 35 años, vivo en Colombia y soy Científica de Datos 📊. Hoy no les escribo solo como una paciente con cáncer gástrico avanzado (Estadio IV) 🎗️, sino como alguien que acaba de encontrar un dato científico único en su propio cuerpo que podría cambiarlo todo 🧬.
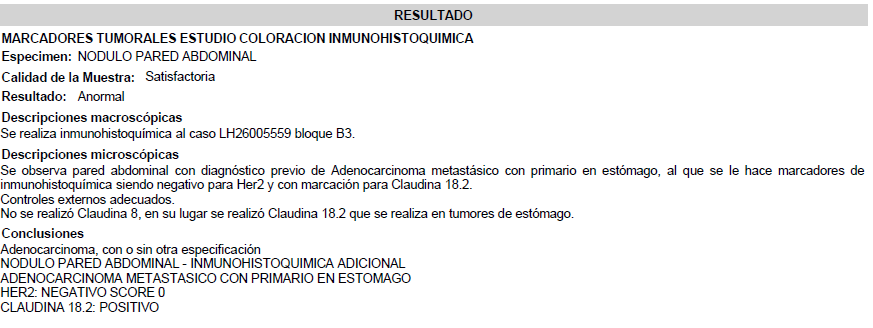
Ayer, 21 de mayo de 2026, mi reporte de patología reveló algo extraordinario y muy escaso en el mundo: mi tumor dio POSITIVO para una proteína llamada CLAUDINA 18.2 🔬.
Para explicarlo de forma sencilla: la Claudina 18.2 es como una "cerradura" 🔐 muy rara que solo tienen algunos tumores en el mundo. La ciencia médica ya inventó una "llave" 🔑 exacta para esa cerradura (un medicamento avanzado llamado Zolbetuximab o Vyloy), que es capaz de atacar directamente las células enfermas sin destruir el resto del cuerpo 🎯.
El problema es que este medicamento no es comercial en Colombia 🇨🇴. Mi oncólogo me confirmó que mi única oportunidad real de acceder a esta "llave" es que una farmacéutica o un centro de investigación me reciba en un Ensayo Clínico Nacional o Internacional o en un programa de acceso expandido ✈️.
Al ser un perfil de paciente tan escaso y específico en el planeta, sé que hay laboratorios y científicos en el mundo buscando activamente a personas como yo para sus estudios de medicina de precisión 🩺.
Quiero que el mundo sepa que estoy lista 💪: mis órganos vitales (hígado y riñones) están completamente sanos, fuertes y funcionando a la perfección, listos para resistir el tratamiento 🫁. Tengo la juventud, la fuerza biológica y la determinación absoluta de pelear por mi vida y aportar a la ciencia 🦾.
Hago un llamado directo a la comunidad científica global (#OncoTwitter 🩺), a laboratorios como @AstellasUS 🏢, y a investigadores de cualquier país que lideren estudios sobre Claudina 18.2: Aquí hay una paciente joven con el biomarcador idóneo 📑.
Por favor, ayúdenme con un RT (compartir) 🔁. Un solo clic de ustedes puede hacer que este mensaje cruce fronteras y llegue al comité científico o a la farmacéutica que me pueda patrocinar 💌.
Mis mensajes directos (DM) están abiertos para enviar de inmediato mi historial médico, resultados de los marcadores, bloques de patología o cualquier cosa que se necesite 📤.
Colombia 🇨🇴 | Contacto: DM abierto 📩.
#GastricCancer #Zolbetuximab #ClinicalTrials #PrecisionMedicine #OncoTwitter #Claudina18 #CancerGastrico #EnsayosClinicos #MedicinaDePrecision #Vyloy
Hola, buenas tardes. Sigo disponible para nuevos proyectos y oportunidades como desarrollador de software.
Cuento con conocimientos y habilidades en:
- Desarrollo de aplicaciones web (landing pages, aplicaciones y dashboards).
- Desarrollo móvil con React Native para Android e iOS.
- Construcción de APIs y servicios backend con Node.js.
- Integración de funcionalidades de IA en aplicaciones (automatización, asistentes, procesamiento de información).
Abierto a trabajos freelance o colaboraciones profesionales.
Si conoces a alguien o a alguna empresa que esté contratando, o si te interesa iniciar un proyecto, escríbeme por mensaje directo.
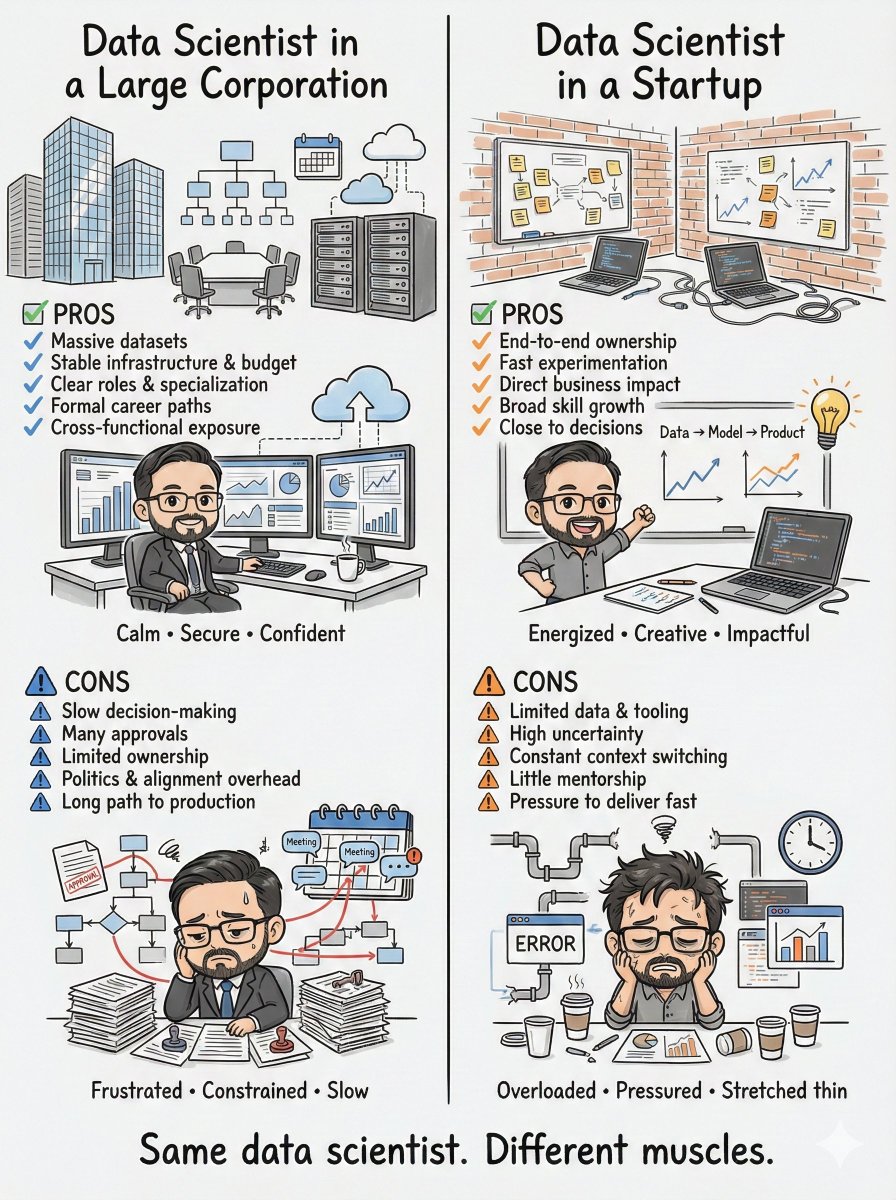
Estoy convencido de que todos los Data Scientists deben pasar tanto por startups como por corporaciones para realmente entender el valor de los datos en el negocio.
En una empresa grande, el trabajo suele sentirse estable. Hay datos masivos, infraestructura sólida, equipos especializados y caminos de carrera bien definidos. Es un gran entorno para aprender a operar a escala y profundizar en problemas muy específicos.
El costo suele ser el ritmo: decisiones lentas, muchos aprobadores, poco margen de maniobra y la sensación de que las ideas tardan demasiado en llegar a producción.
En una startup, el péndulo se va al otro extremo. El impacto es inmediato. Tocas todo: datos, modelos, despliegue y producto. Aprendes rápido, decides rápido y ves cómo tu trabajo mueve a la empresa casi en tiempo real.
Pero esa velocidad también cobra factura: menos datos, menos herramientas, más incertidumbre, más presión y muchas veces resolver cosas “con lo que hay”.
Lo interesante es que el Data Scientist es el mismo.
Lo que cambia es el contexto y, con él, los músculos que entrenas.
Las corporaciones entrenan profundidad, especialización y operación a escala.
Las startups entrenan velocidad, criterio, versatilidad y cercanía al negocio.
Ninguno es mejor por definición.
Ambos son necesarios para formar un perfil completo.
Mismo rol. Mundos distintos.
Y entender ambos hace una enorme diferencia.
"No eval-driven development!"
I absolutely agree with you when it comes to the fully subjective evaluations for errors that can only be known after you implement the system and see where it fails.
BUT there is a common domain where I think eval-driven development should almost always be entailed – data extraction.
Let's say that I'm having an LLM grab business metadata out of small business websites. They only way I would begin implementing a workflow for something like that is when I have a golden set of websites and the hand-labeled data that they extract.
There's also a virtuous cycle in this domain (and similar) where you can
1. create the human labeling tool to get the original golden set
2. create the extraction workflow
3. integrate the extraction workflow into the human labeling too to speed up labeling and to get better golden samples (e.g. the ones where the data extraction was incorrect)
4. the workflow-augmented labeler gets to see first hand how well the workflow is doing and build some intuition about how to fix it