@raedaawawdeh "فالذكاء الاصطناعي قد يخفض تكلفة تنفيذ خطتك، لكنه لا يضمن أن خطتك هي الأنسب للسوق... "
فما الحل ..!؟
حتى اغلب معادلات وقواعد السوق في عالم الأعمال تأثرت وتغيرت بسبب الدكاء الاصطناعي
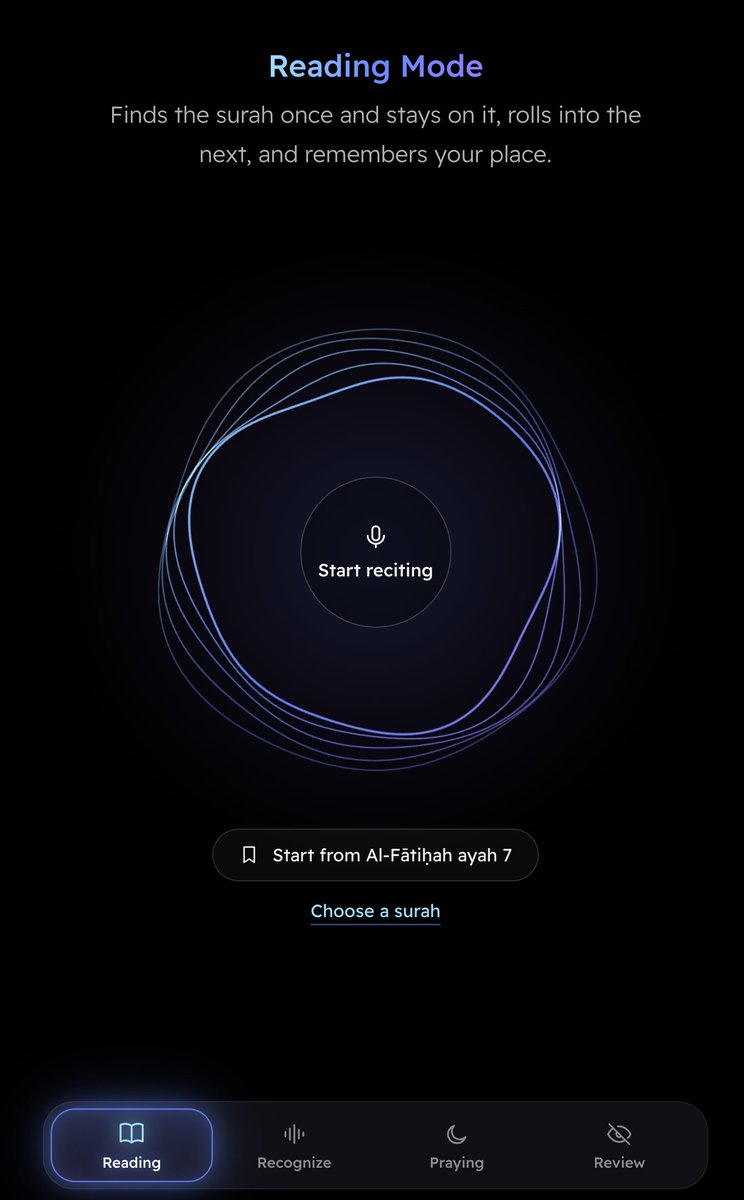
I built a Quran prompter that listens.
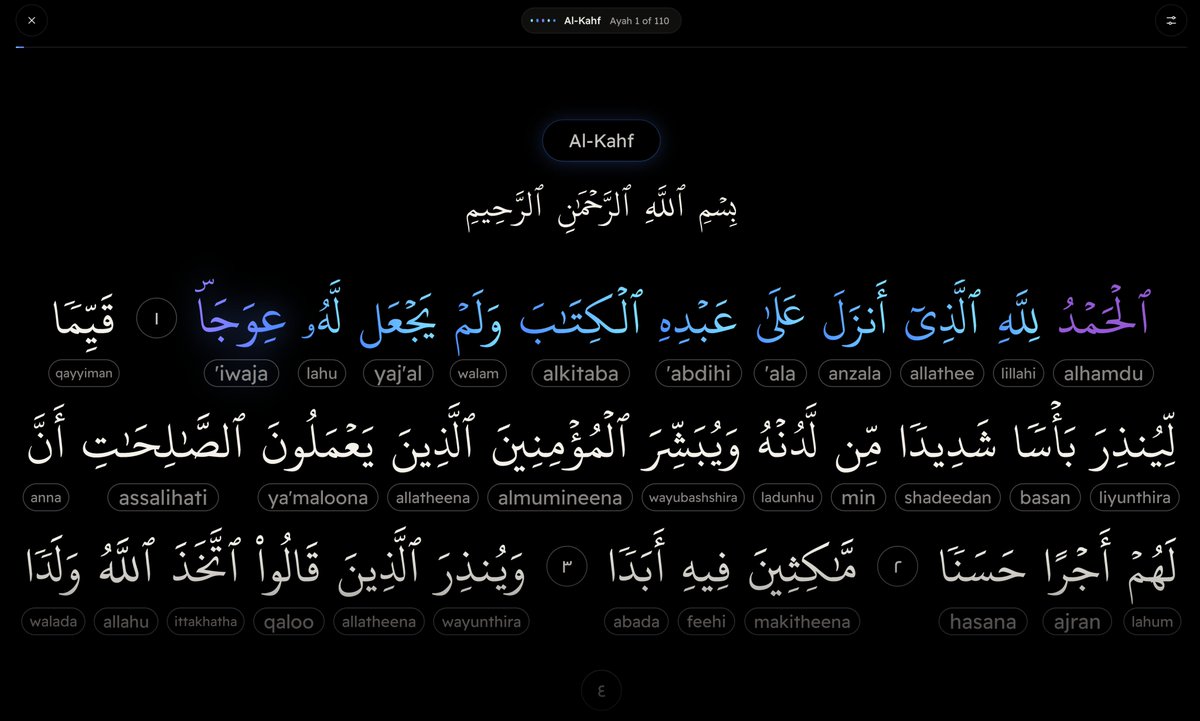
Open it, start reciting from anywhere in the Quran, and it finds your place, lights up each word as you say it, and scrolls the ayahs with you. Hands-free.
ملقّن القرآن — Quran Prompter
What it does:
• Finds where you are from your voice alone: any surah, any ayah
• Colours every word as you recite it, and keeps the page moving with you
• Prayer mode: set the phone in front of you in Taraweeh and it keeps pace, counting your rak'ahs
• Review mode: the words stay hidden until you recite them, a quiet partner for memorization
• Latin letters under each word for anyone who doesn't read Arabic well, and a tap on any word plays its recitation
What I care about most:
🔒 Your voice never leaves your phone. The speech model runs entirely in the browser. No server listening, no account, and it works offline once loaded.
🤲 It's free, with no ads, and it will stay that way. It runs on Quran Lab's open-source recognition model, whose license forbids ever charging for it.
✅ When it isn't sure, it says nothing. Telling someone they recited wrongly when they didn't is the worst mistake it could make, so it's built to stay quiet rather than risk a false correction.
Built on the work of the Quran Lab team, and I'm proud to be part of it.
Try it: https://t.co/VG5a0n1ENO
English: https://t.co/Yo1iFIQUFQ
#Quran #AI #OnDeviceAI #EdgeAI #IslamicTech #WebDevelopment
حدث شيء قبل أيام يبدو وكأنه مشهد من الخيال العلمي:
باحثة في OpenAI تركت وظيفتها لتعمل على تقنية تحاول تحويل الأفكار إلى نص من دون جراحة.
ومن دون شريحة داخل الدماغ.
اسمها ناومي باشكانسكي.
كانت باحثة في فريق المواءمة والسلامة في OpenAI لمدة عام ونصف تقريبًا.
وفي 23 يوليو 2026 استقالت.
وفي اليوم التالي بدأت العمل كباحثة مؤسسة في شركة ناشئة اسمها Conduit.
مهمتهم؟
بناء ما يسمونه ببساطة:
«التخاطر».
نماذج ذكاء اصطناعي تحاول تحويل الإشارات العصبية غير الجراحية إلى نص. (https://t.co/7EYc7iLsH9)
وما يحدث داخل مقر الشركة في سان فرانسيسكو أغرب.
يأتي مشاركون مدفوعو الأجر.
يرتدون خوذات استشعار تزن قرابة أربعة أرطال.
ثم يقضون نحو ساعتين في محادثة نموذج ذكاء اصطناعي، بالكتابة أو الكلام أو الاستماع، بينما تسجل أجهزة متعددة الإشارات العصبية بالتزامن مع ما يفعلونه. (https://t.co/xucwHoQauc)
الإشارة ضعيفة جدًا.
فالـEEG مثلًا لا «يسمع خلية عصبية واحدة وهي تطلق»، بل يلتقط نشاطًا كهربائيًا ضعيفًا جدًا عبر فروة الرأس، وسط كمية هائلة من التشويش.
في بداية التجربة، كان التشويش الكهربائي في المبنى مشكلة كبيرة لدرجة أن الفريق استخدم البطاريات بدل مقابس الكهرباء، بل وأوقف الطاقة عن جزء من المبنى لتحسين الإشارة.
بعد جمع آلاف الساعات، وجدوا أن زيادة حجم البيانات أصبحت تساعد النموذج على التعامل مع الضوضاء بصورة أفضل. (https://t.co/xucwHoQauc)
حتى الآن، تقول Conduit إنها جمعت نحو:
10,000 ساعة من البيانات العصبية واللغوية
من آلاف الأشخاص المختلفين.
وبحسب الشركة، فهي أكبر مجموعة بيانات من هذا النوع جمعتها جهة واحدة حتى الآن. (https://t.co/xucwHoQauc)
والجزء المثير فعلًا هو أن النموذج لا يحتاج دائمًا إلى التدرب مسبقًا على الشخص نفسه.
نشرت الشركة أمثلة «zero-shot» لأشخاص جدد.
مثلًا:
كانت الفكرة الأصلية:
«بدت الغرفة أكثر برودة.»
وكان تخمين النموذج من الإشارات العصبية:
«كان هناك نسيم، حتى هبة لطيفة.»
وفي مثال آخر:
«هل لديك تطبيق أو موقع مفضل؟»
أصبح:
«هل لديك روبوت مفضل؟»
ليست قراءة حرفية للأفكار.
لكن المعنى العام بدأ يظهر أحيانًا. (https://t.co/xucwHoQauc)
وفي تقرير سابق، قالت الشركة إن نموذجها يصل إلى نحو 45% من «التطابق الدلالي» بين النص المتوقع والمعنى المقصود، حتى مع أشخاص جدد.
وهنا يجب أن نكون دقيقين:
هذا رقم تعلنه الشركة، وليس حتى الآن نتيجة مثبتة في دراسة محكّمة مستقلة.
كما أن الشركة لم تنشر بعد تقييم عام مفصل لأداء النموذج في قراءة الأفكار الحرة. (Forbes)
لكن الرهان الذي تقوم عليه Conduit واضح:
البيانات.
تخيّل أن Whisper، نموذج تحويل الكلام إلى نص من OpenAI، تدرب على 680,000 ساعة من الصوت.
Conduit جمعت حتى الآن نحو 10,000 ساعة من البيانات العصبية.
والفريق يراهن على أن ما حدث مع الصوت واللغة قد يحدث جزئيًا مع الدماغ أيضًا:
بيانات أكثر.
نماذج أكبر.
ثم قدرة أفضل على استخراج الإشارة من الضوضاء. (OpenAI)
لكن لا أحد يعرف بعد ما إذا كان هذا الرهان سيعمل بالطريقة نفسها.
الدماغ ليس ميكروفون.
والإشارات العصبية غير الجراحية أصعب وأكثر ضوضاء بكثير من الصوت.
ولهذا لا يمكن ببساطة القول:
إذا وصلنا إلى 680 ألف ساعة، سنقرأ الأفكار بدقة Whisper.
هذا استنتاج لم يُثبت بعد.
باشكانسكي نفسها تصف المرحلة الحالية بعبارة لافتة:
«نحن في عصر GPT-2.»
أي أنها ترى أن التقنية ما تزال بدائية مقارنة بما تعتقد أنه قد يأتي لاحقًا. (https://t.co/7EYc7iLsH9)
وتوقعاتها أكثر جرأة.
في رؤيتها لعام 2027:
تضع عصابة على رأسك، وتنظر إلى الكود، وتتحول نواياك التقريبية مباشرة إلى أوامر ترسل إلى وكيل ذكاء اصطناعي.
في 2030:
تتخيل أن نماذج الذكاء الاصطناعي ستتعلم التعامل مباشرة مع التمثيلات العصبية، بدل تحويل كل شيء أولًا إلى كلمات.
وفي 2035:
تتخيل أن الذكاء الاصطناعي قد لا يعود يشعر وكأنه «شيء خارجي».
بل كأنه حاسة إضافية أو طرف آخر من جسدك.
لكنها تؤكد أن هذه سيناريوهات مستقبلية متفائلة تتوقعها، وليست منتجات موجودة أو مواعيد إطلاق مؤكدة. (https://t.co/7EYc7iLsH9)
وهنا تصبح القصة أكبر من مجرد شركة ناشئة.
طوال تاريخ الحوسبة، كنا نبحث عن طريقة أسرع لنقل ما في رؤوسنا إلى الآلة:
لوحة المفاتيح.
الفأرة.
شاشة اللمس.
الصوت.
ثم جاء الذكاء الاصطناعي.
والآن هناك من يحاول إزالة آخر وسيط:
الكلمات نفسها.
قد يفشل هذا الرهان.
وقد تصطدم التقنية بحد فيزيائي لا تستطيع إشارات الدماغ غير الجراحية تجاوزه.
لكن إذا نجح فلن يكون السؤال فقط:
«كيف سنتحدث مع الكمبيوتر؟»
بل:
كم من أفكارنا نريد أصلًا أن يكون الكمبيوتر قادر على سماعها؟
CTO: We lost our strongest backend engineer today.
Founder: The one handling infra and outages?
CTO: Yes.
Founder: Did a bigger company hire him?
CTO: No.
Founder: Then why quit?
CTO: He said he was exhausted.
Founder: From the workload?
CTO: Not exactly. From watching the same database bottleneck, same queue lag, same deployment mistakes come back every month.
Founder: That happens in fast moving teams.
CTO: He agreed. What he could not accept was that every fix was temporary because nobody wanted to slow down and clean the system properly.
Founder: We had deadlines.
CTO: He had standards.
Founder: So he left because the work was hard?
CTO: No. He left because he was not doing engineering anymore. He was just containing damage.
The best engineers do not hate hard problems.
They hate preventable problems that management keeps normalizing.
Dirty industry secret: nobody really knows the best way to use AI for software development 📢
- 24 months ago, we copy-pasted from ChatGPT
- 18 months ago, we jumped between ask mode and agent mode
- 12 months ago, we told AI "you are a senior developer"
- 9 months ago, we built MCPs
- 6 months ago, we switched to plan mode
- today, we're obsessed with skills
All of this (and much more) are just early experiments and temporary hacks in a very young and quickly evolving field.
So when someone says their workflow is the optimal one, they're confused at best.
Stay curious, stay open, stay in control and stick to the fundamentals, and you'll come on top in this amazing tech revolution. Enjoy the ride!
My CTO friend texted me: "Your gstack is crazy. This is like god mode. Your eng review discovered a subtle cross site scripting attack that I don't even think my team is aware of. I will make a bet that over 90% of new repos from today forward will use gstack."
#تحدي_مرسال
كل سنة و انتم طيبين، ان شاء الله زي كل سنة مشاركين في تحدي مرسال.
كل لايك وشير في خلال ٢٤ ساعة ان شاء الله حيبقى قصادها تبرع بدولار لمؤسسة مرسال @Mersalcharity
تقبل الله منا و منكم صالح الأعمال