أخيرًا... نمــــاء رسميًا على منصة 𝗫! 🌿
نفتح مساحة جديدة لمجتمع #NAMAA، نشارك فيها أبحاثنا ومشاريعنا وأفكارنا في الذكاء الاصطناعي ومعالجة اللغة العربية، ونتواصل مع كل من يؤمن بأن للعربية مكانًا في مستقبل التقنية.
شاركونا الحوار، وأعيدوا نشرها لكل مهتم بالذكاء الاصطناعي العربي.
🔗 https://t.co/66c2u8XYF5
بكم تنمو نماء 🌱
#نماء #NAMAA #الذكاء_الاصطناعي #معالجة_اللغة_العربية #ArabicNLP #ArabicAI
ليش هالمعيار مهم؟ الورقة تحدد تحديات لغوية تتعثر فيها أنظمة الترجمة الحالية:
▪️ مصطلح يتغير معناه حسب المجال، زي 𝘀𝘁𝗮𝘁𝗲 بين الفيزياء والرياضيات
▪️ مصطلحات تقنية بلا ترجمة موحّدة، زي 𝗱𝗶𝗺𝗲𝗻𝘀𝗶𝗼𝗻𝗮𝗹 𝗰𝗿𝗼𝘀𝘀𝗼𝘃𝗲𝗿
▪️ أدوات التحوّط العلمي، زي 𝗺𝗮𝘆 𝘀𝘂𝗴𝗴𝗲𝘀𝘁 و𝗮𝗽𝗽𝗲𝗮𝗿𝘀 𝘁𝗼
▪️ اختصارات وتراكيب منسوبة لأسماء علماء، زي 𝗪𝗮𝘀𝘀𝗲𝗿𝘀𝘁𝗲𝗶𝗻 𝗱𝗶𝘀𝘁𝗮𝗻𝗰𝗲 و𝗚𝗿𝗲𝗲𝗻'𝘀 𝘁𝗲𝗻𝘀𝗼𝗿، وما لها مقابل عربي موحّد
صُمم 𝗔𝗦𝗖𝗔𝗧 لدعم تقييم جودة الترجمة العلمية من الإنجليزية إلى العربية. والورقة تحدده كمعيار تقييم قبل أن يكون مصدر تدريب واسع: 𝟱𝟬𝟬 ملخص بالتصميم، لأن التدقيق البشري العميق ما يتوسع بلا حدود، وتوزيعه بين المجالات غير متساو.
لكن 𝗕𝗟𝗘𝗨 لحاله ما يكفي علشان نفهم الصورة بشكل أوضح .
𝗥𝗢𝗨𝗚𝗘 مقياس ثاني يقيس التداخل مع المرجع:
𝗥-𝟭 على الكلمات المفردة،
و𝗥-𝟮 على أزواج الكلمات المتتالية،
و𝗥-𝗟 على أطول تسلسل مشترك.
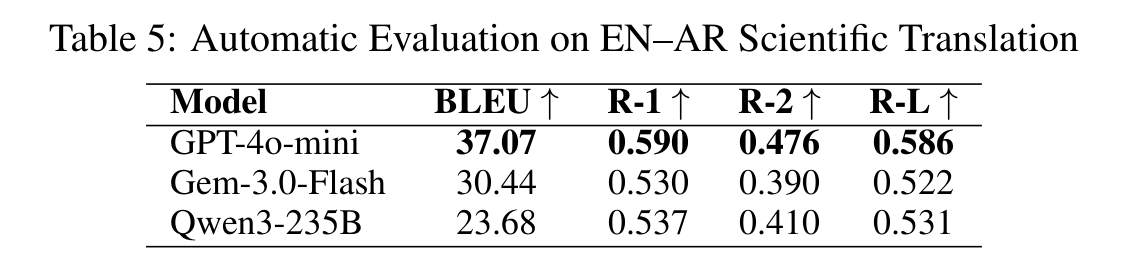
𝗤𝘄𝗲𝗻𝟯 جاء آخر في 𝗕𝗟𝗘𝗨، لكنه تقدّم على 𝗚𝗲𝗺𝗶𝗻𝗶 بفارق صغير في الثلاثة:
𝗥-𝟭: 𝟬.𝟱𝟯𝟳 مقابل 𝟬.𝟱𝟯𝟬،
𝗥-𝟮: 𝟬.𝟰𝟭𝟬 مقابل 𝟬.𝟯𝟵𝟬،
𝗥-𝗟: 𝟬.𝟱𝟯𝟭 مقابل 𝟬.𝟱𝟮𝟮.
الورقة تقترح أن ترجمة 𝗤𝘄𝗲𝗻𝟯 قريبة من المرجع في المفردات وبعيدة عنه في التركيب، وتذكر احتمال اختلاف أسلوب العربية في بيانات تدريبه.
هذا احتمال مو نتيجة مثبتة. وكمان 𝗕𝗟𝗘𝗨 و𝗥𝗢𝗨𝗚𝗘 ما يلتقطون كل شي، زي الكفاية الدلالية والدقة المصطلحية، وتذكر التقييم البشري الواسع ضمن أعمالها المستقبلية.
وش رأيكم: هل 𝗕𝗟𝗘𝗨 كافي لتقييم الترجمة العلمية للعربية؟
اختبرنا المعيار على ثلاثة نماذج لغوية كبيرة: طلبنا من كل واحد يترجم الملخصات الإنجليزية، وقارنّا الناتج بالمراجع العربية اللي راجعها البشر.
𝗕𝗟𝗘𝗨 مقياس يعتمد على تطابق تسلسلات الكلمات مع الترجمة المرجعية، وكل ما ارتفع الرقم كان الناتج أقرب للمرجع:
𝗚𝗣𝗧-𝟰𝗼-𝗺𝗶𝗻𝗶: 𝟯𝟳.𝟬𝟳،
𝗚𝗲𝗺𝗶𝗻𝗶-𝟯.𝟬-𝗙𝗹𝗮𝘀𝗵-𝗣𝗿𝗲𝘃𝗶𝗲𝘄: 𝟯𝟬.𝟰𝟰،
𝗤𝘄𝗲𝗻𝟯-𝟮𝟯𝟱𝗕-𝗔𝟮𝟮𝗕: 𝟮𝟯.𝟲𝟴.
الفرق 𝟭𝟯.𝟰 نقطة بين الأول والأخير.
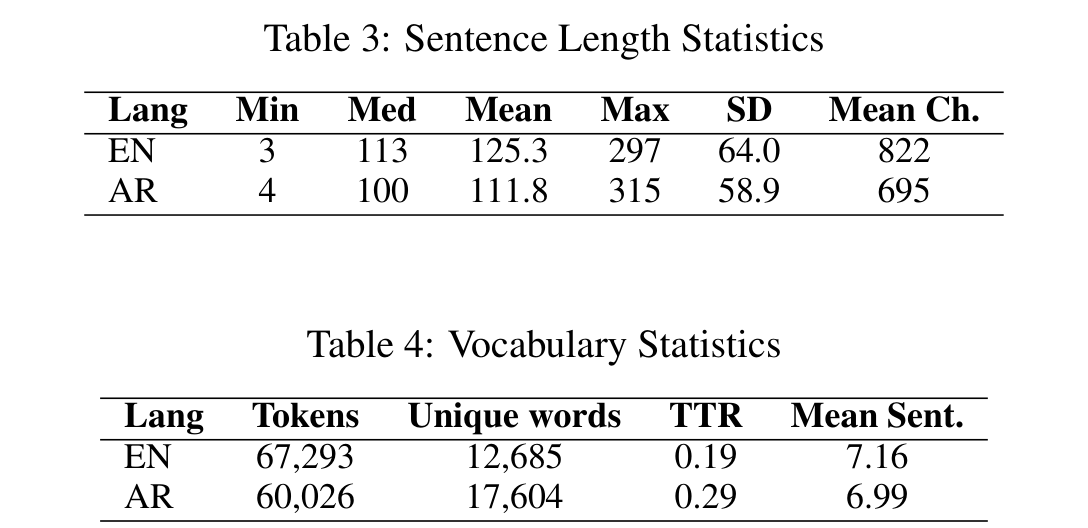
الأرقام تكشف شي عن العربية. متوسط الملخص 𝟭𝟮𝟱.𝟯 كلمة بالإنجليزية و𝟭𝟭𝟭.𝟴 بالعربية، يعني العربية أقصر. لكن مفرداتها أوسع:
𝟲𝟳,𝟮𝟵𝟯 توكن إنجليزي مقابل 𝟲𝟬,𝟬𝟮𝟲 عربي،
و𝟭𝟮,𝟲𝟴𝟱 كلمة فريدة بالإنجليزية مقابل 𝟭𝟳,𝟲𝟬𝟰 بالعربية.
𝗧𝗧𝗥 (نسبة الكلمات الفريدة إلى إجمالي الكلمات، ويقيس تنوع المفردات):
𝟬.𝟮𝟵 للعربية و𝟬.𝟭𝟵 للإنجليزية.
الورقة تربط هالنمط بغنى الصرف العربي: الجذر الواحد يولّد عشرات الصيغ بالاشتقاق والتصريف.
فنماذج الترجمة العربية تحتاج مفردات أكبر أو تقسيم الكلمات لوحدات جزئية (𝘀𝘂𝗯𝘄𝗼𝗿𝗱).
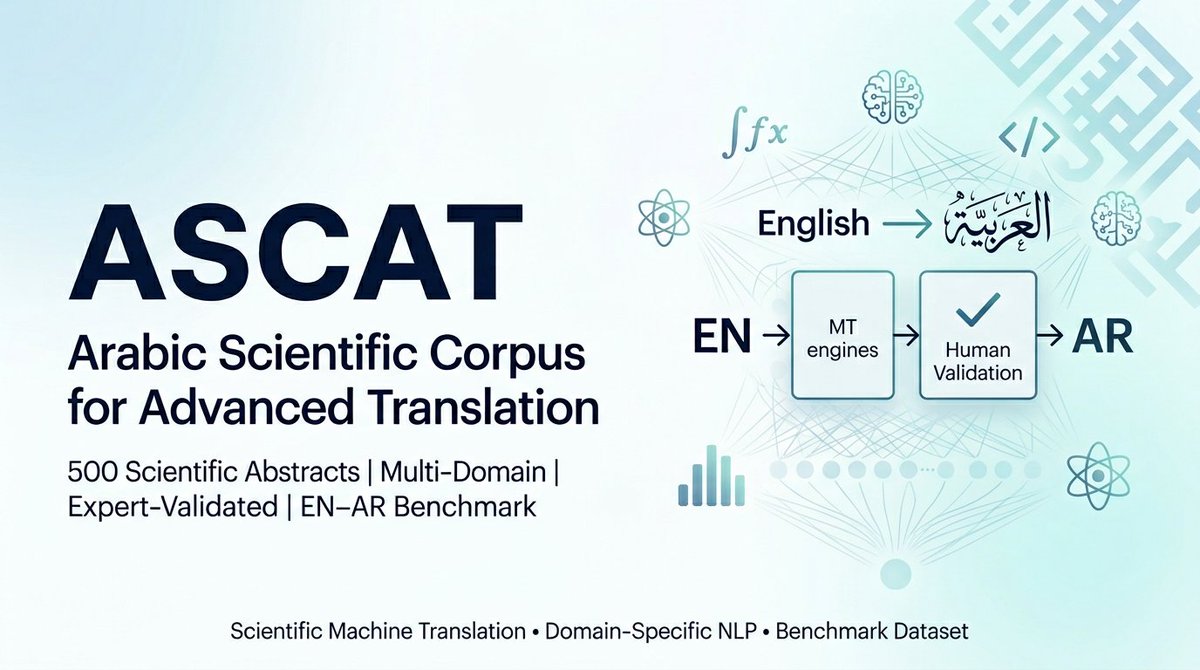
كيف بنيناه؟ ثلاث مراحل.
أول شي جمعنا ملخصات اخترناها عشوائيًا من أوراق في خمسة مجالات: الفيزياء، الرياضيات، علوم الحاسب، ميكانيكا الكم، والذكاء الاصطناعي.
بعدها ترجمنا كل ملخص بثلاث بنى مختلفة:
نموذج توليدي (𝗚𝗲𝗺𝗶𝗻𝗶)،
ونموذج قائم على الترانسفورمر (𝗾𝘂𝗶𝗰𝗸𝗺𝘁-𝗲𝗻-𝗮𝗿 من 𝗛𝘂𝗴𝗴𝗶𝗻𝗴 𝗙𝗮𝗰𝗲)،
الترجمة التجارية API (𝗚𝗼𝗼𝗴𝗹𝗲 𝗧𝗿𝗮𝗻𝘀𝗹𝗮𝘁𝗲 و𝗗𝗲𝗲𝗽𝗟).
وأخيرا راجع 𝟳 خبراء الترجمات، كل واحد ضمن تخصصه، وكلهم بشهادة دراسات عليا في اللسانيات العربية أو أحد العلوم المعنية.
عملوا باستقلال بقائمة تدقيق منظمة، وصححوا أخطاء المصطلحات والتركيب والمعنى، والخلاف انحسم بالنقاش لين الاتفاق.
من ال𝗱𝗮𝘁𝗮𝘀𝗲𝘁𝘀 المعروفة للترجمة بين الإنجليزية والعربية:
𝗗𝗘𝗔𝗦𝗧 مبنية على عناوين رسائل جامعية، بمتوسط حوالي 𝟵 كلمات،
و𝗣𝗘𝗔𝗖𝗛 على جمل في المجال الصحي، بمتوسط حوالي 𝟭𝟬–𝟭𝟮 كلمة.
لكن النصوص بهذا القِصر لا تعكس التحديات الموجودة عند ترجمة ملخص علمي كامل، حيث تصبح بنية الجمل أكثر تعقيدًا، وترتبط الأفكار ببعضها عبر النص.
لذلك بنينا 𝗔𝗦𝗖𝗔𝗧: 𝟱𝟬𝟬 ملخص علمي كامل بالإنجليزية والعربية، راجعها خبراء على ثلاثة مستويات: المفردات، والتركيب، والمعنى.
وصُممت ك𝗯𝗲𝗻𝗰𝗵𝗺𝗮𝗿𝗸 لتقييم الترجمة العلمية الآلية.
🔗 الورقة: https://t.co/pqlZPhrUce
🔗 البيانات: https://t.co/iNvTiZAOVQ
لغات زي العربية معظم النصوص الحقيقية فيها، الأخبار والقوانين والمحتوى الديني والموسوعي، أطول من الحد التقليدي لنماذج ال𝗕𝗘𝗥𝗧 القديمة، اللي توقف عند 𝟱𝟭𝟮 توكن بس.
طورنا 𝗔𝗿𝗮𝗠𝗼𝗱𝗲𝗿𝗻𝗕𝗘𝗥𝗧: ضبط لمعمارية 𝗠𝗼𝗱𝗲𝗿𝗻𝗕𝗘𝗥𝗧 للعربية، بسياق يوصل 𝟴,𝟭𝟵𝟮 توكن. البحث نُشر في 𝗔𝗯𝗷𝗮𝗱𝗡𝗟𝗣 𝟮𝟬𝟮𝟲 (ورشة تابعة ل𝗔𝗖𝗟)، الرباط، المغرب 🇲🇦.
🔗 النموذج: https://t.co/x19sRpNbXV
🔗 الورقة: https://t.co/U7nNbDUtBC
ليش هذا مهم عمليًا؟ 𝗔𝗿𝗮𝗠𝗼𝗱𝗲𝗿𝗻𝗕𝗘𝗥𝗧 حجمه 𝟭𝟰𝟵 مليون parameter بس، يعني أرخص وأسرع بكثير من استدعاء نموذج توليدي ضخم لمهام زي التصنيف والبحث الدلالي وال𝗥𝗔𝗚، خيار عملي جاهز للإنتاج مو مجرد نتيجة بحثية.
استخداماته المباشرة زي ما أثبتتها الورقة نفسها: كشف الكلام المسيء، قياس التشابه الدلالي بين الأسئلة، استخراج الكيانات المسماة، والبحث والاسترجاع الدلالي. أي فريق يقدر يستخدمه كطبقة تمثيل جاهزة داخل محرك بحث أو نظام تصنيف عربي بدل ما يدرب نموذج من الصفر.
سياقه الطويل (𝟴,𝟭𝟵𝟮 توكن بدون تقطيع) استخداماته: فهرسة وبحث كامل في مستندات عربية طويلة زي الأخبار والعقود القانونية والمحتوى الديني والموسوعي، من غير ما تقسمها لقطع صغيرة أول.
𝘄𝗲𝗶𝗴𝗵𝘁𝘀 النموذج مفتوحة على 𝗛𝘂𝗴𝗴𝗶𝗻𝗴 𝗙𝗮𝗰𝗲 وكود التقييم منشور، فأي فريق يقدر ياخذه كنقطة بداية ويضبطه (𝗳𝗶𝗻𝗲-𝘁𝘂𝗻𝗲) على بياناته الخاصة، أو يبني عليه نظام 𝗥𝗔𝗚 عربي كامل يستغل السياق الطويل.
القراءة الآلية للنص العربي المُشكّل من أصعب مسائل الـ𝗢𝗖𝗥، بسبب الخط المتصل والتشكيل وتعدد الخطوط.
طورنا 𝗤𝗔𝗥𝗜-𝗢𝗖𝗥: نموذج مفتوح المصدر بحجم 𝟮𝗕 فقط، مبني على 𝗤𝘄𝗲𝗻𝟮-𝗩𝗟-𝟮𝗕-𝗜𝗻𝘀𝘁𝗿𝘂𝗰𝘁، ودربناه على ثلاث نسخ متتالية.
𝘃𝟬.𝟭 على نص نظيف بلا تشكيل كخط أساس،
𝘃𝟬.𝟮 بتشكيل كامل و𝟭𝟬 خطوط عربية مختلفة،
و𝘃𝟬.𝟯 على صفحات بتخطيطات واقعية وهياكل 𝗛𝗧𝗠𝗟.
تفاصيل كاملة في الصورة
🔗 الورقة: https://t.co/z4RpasJRey
🔗 النماذج: https://t.co/42N9C6xIWK
@nzl3reb وصف الشغل بـ«دربتوه شوي» ما يغني عن قراءة المنهجية. لقينا الـloss ينخفض 39% والخطأ يزيد 7 نقاط، وحسّنّا محاذاة النص مع الصوت وشاركنا الدرس للمجتمع. والأساس وحدود المقارنة معلنة. إذا عندك خلل في التقييم حدّديه؛ «قلتوا أحسن ناس» عبارة منك، مو منا 🙏🏻
«عندكم نموذج يتكلم سعودي… طيب متى يفهمنا ويفرّغ كلامنا؟» 🎙️😄
قلنا: أبشروا!
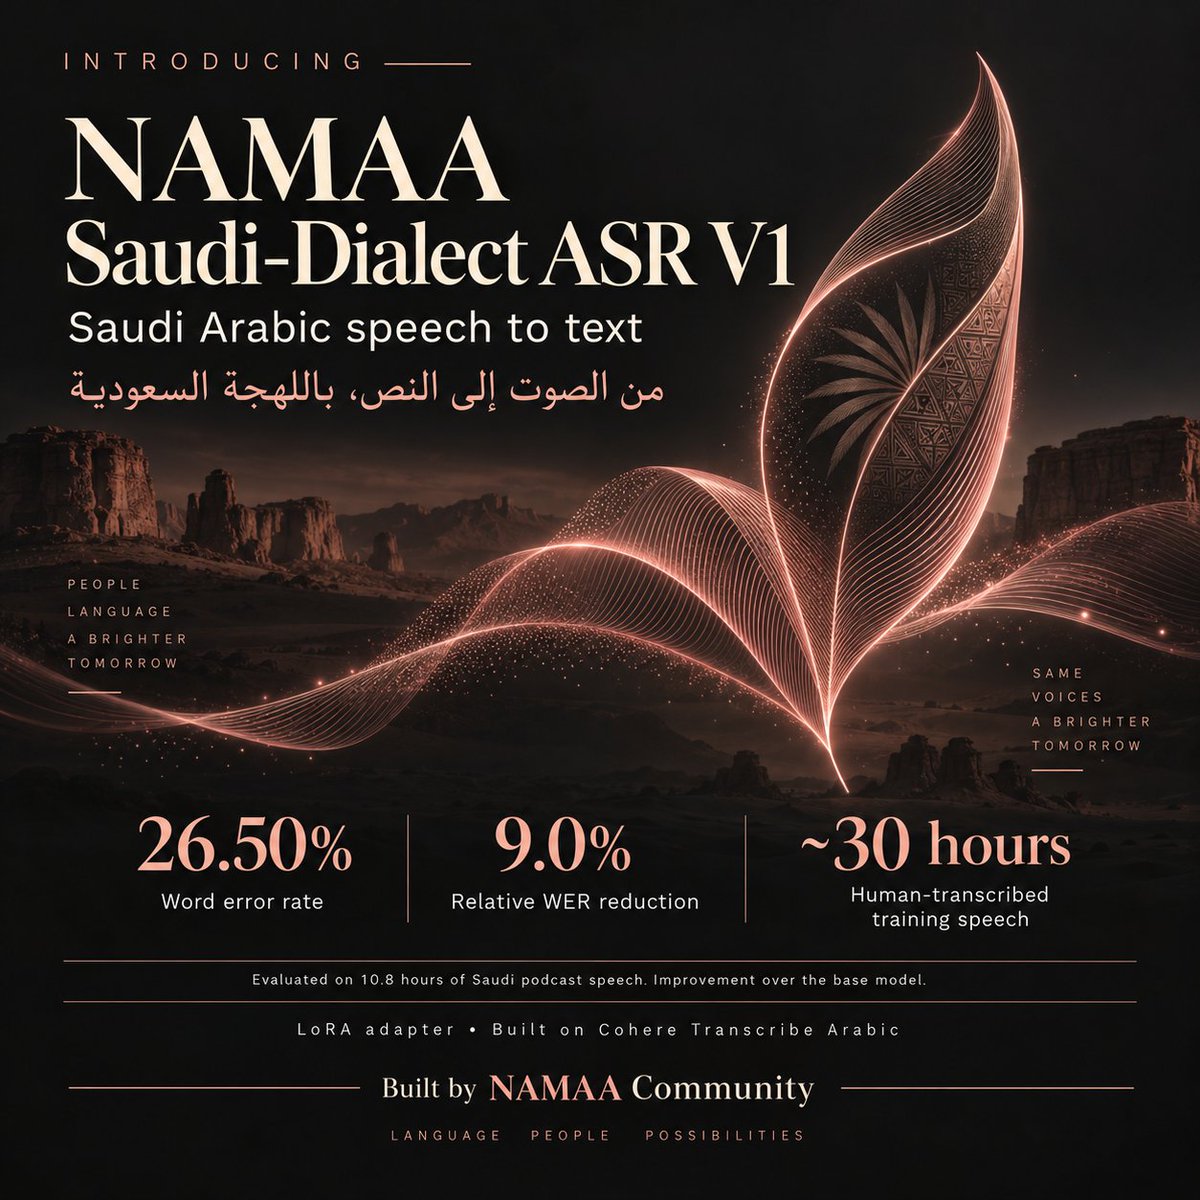
نعلن في مجتمع #نمــــاء عن 𝗡𝗔𝗠𝗔𝗔 𝗦𝗮𝘂𝗱𝗶-𝗗𝗶𝗮𝗹𝗲𝗰𝘁 𝗔𝗦𝗥 𝗩𝟭 🇸🇦
إصدارنا الأول لتحويل الكلام باللهجة السعودية إلى نص.
خلّونا نوريكم وش سوّينا 👇
هذا أول إصدار، وتركيزنا فيه على البودكاست والمقابلات السعودية 🎙️
جرّبوه وعلّمونا: وين ضبط معكم؟ ووين لخبط؟
تجاربكم تساعدنا نعرف وش نحسّن في الإصدار الجاي 💚
النموذج والتفاصيل:
https://t.co/jIIVzZMKDR
#نماء#NAMAA#الذكاء_الاصطناعي
أغرب درس تعلّمناه؟ 🤔
في تجربة أولية، خسارة التدريب نزلت 39%… لكن أخطاء التفريغ زادت 7 نقاط مئوية!
المشكلة كانت في تقسيم النص على المقاطع الصوتية. لما حسّنّا المحاذاة، تحسّن التدريب.
الدرس: لا تفرح بالـloss قبل ما تسمع وتشوف الناتج 😅
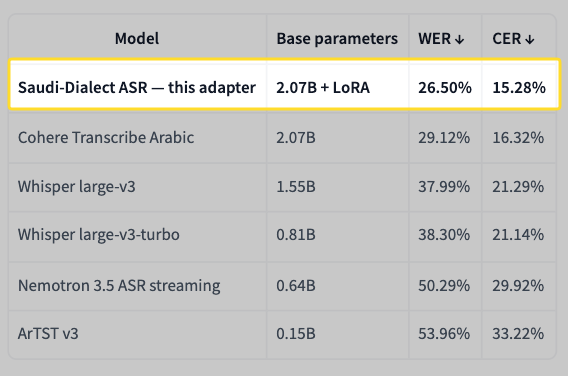
وعلى نفس مجموعة الاختبار، حقق إصدارنا أقل خطأ كلمات بين النماذج اللي اختبرناها، ومنها:
• Whisper large-v3
• Whisper large-v3-turbo
• Cohere Transcribe Arabic
نفخر بالنتيجة، بس ما بنقول «الأفضل في كل شيء» 😄
المقارنة هنا على بودكاست سعودي تحديدًا.