« Technohooligan » — dixit la TV russe.
« Scathing » — dixit Forbes.
« Séparatiste » — dixit Blanquer.
« Dont on ignore les compétences » — dixit la Bâtonnière.
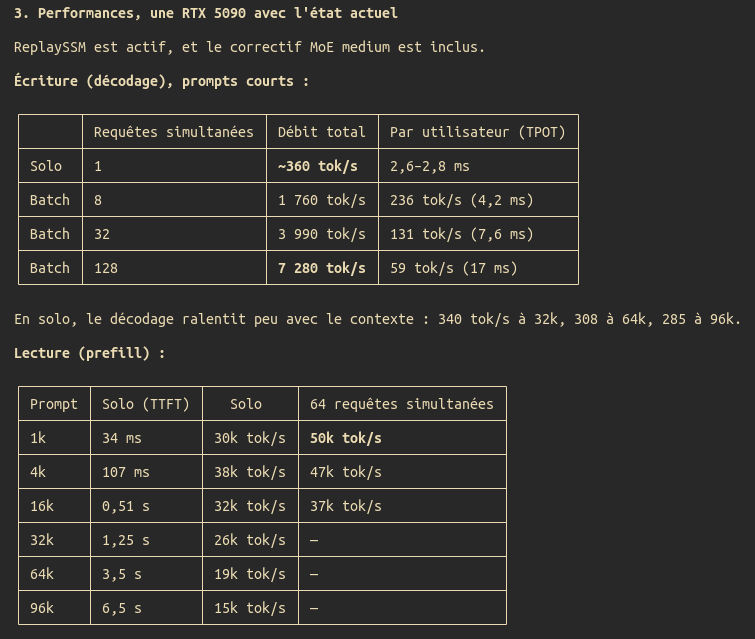
Testez Olala Mini 7A1B qui tourne à 220-380 tokens/sec sur les B300 de Blade.
pour tester Olala:
https://t.co/lMFoDkpv3R
pour comparer Olala avec les autres models:
https://t.co/DABrMRCUcI
pour télécharger Olala et toute la doc technique:
https://t.co/lE6wpEpvSP
Olala v1.0 7A1A un petit modèle de démonstration qui active 1B par requête. C'est pourquoi il sait tourner de l'agentique sans GPU.
Contexte v1.0 : 32K puis v1.1 dans 6 semaines avec 128K donc sera meilleur en math.
La v2.0 sera >100B et bon en agentique, devops et cyber.
La destination de tous ces modeles : les clients d'OVH et OVH lui-même:
- OVHai Workspace en Cloud et Local avec du chiffrement (le Cloud est sur votre poste)
- Public Cloud & AI services d'OVHcloud
- les partenaires cyber de l'ecosystem d'OVH.
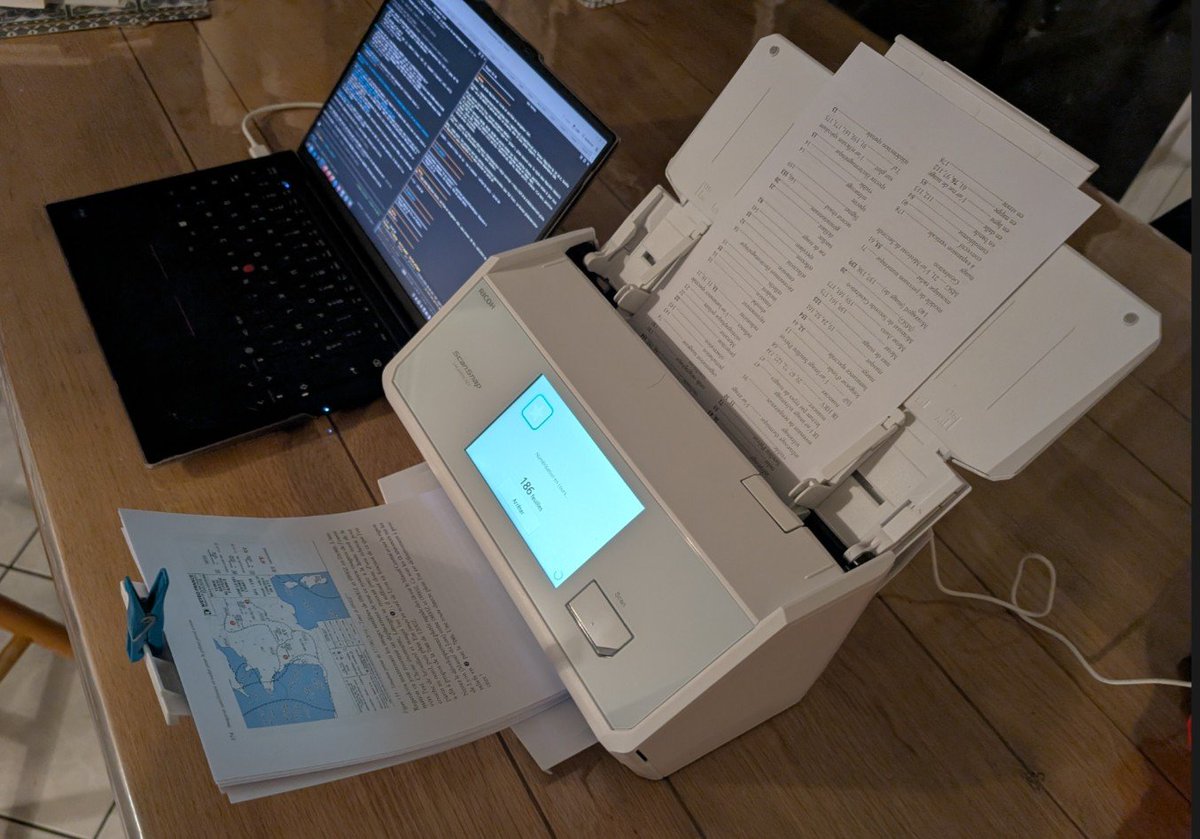
Après avoir scanné des dizaines de milliers de pages...
Toute ma bibliothèque, structurée, immédiatement accessible via une table des matières géantes ou par mot-clé.
😍😍😍
Finalement, je suis en train de massicoter et de numériser toute ma bibliothèque de livres techniques et scientifiques.
L'IA qui bosse pour moi a un large savoir natif, mais il lui manque encore l'information de spécialité.
Elle a peut-être déjà lu ces livres lors de son entraînement, elle en a peut-être un souvenir lointain et grossier. Un modèle compresse l'information avec de la perte, et il répète l'information qu'il a vue le plus fréquemment.
J'ai donc besoin que l'IA puisse feuilleter toute ma bibliothèque pour m'aider.
Quand je lui fournis mes livres, je veux qu'elle y retrouve le détail, l'information noyée dans la masse statistique.
L'information que stocke un modèle n'a jamais la qualité de l'œuvre originale. C'est pourquoi l'œuvre originale restera toujours nécessaire.
J'ai investi dans un scanner double-face à haute fiabilité : le Ricoh iX2500
@JG_Barthelemy@olesovhcom 👍
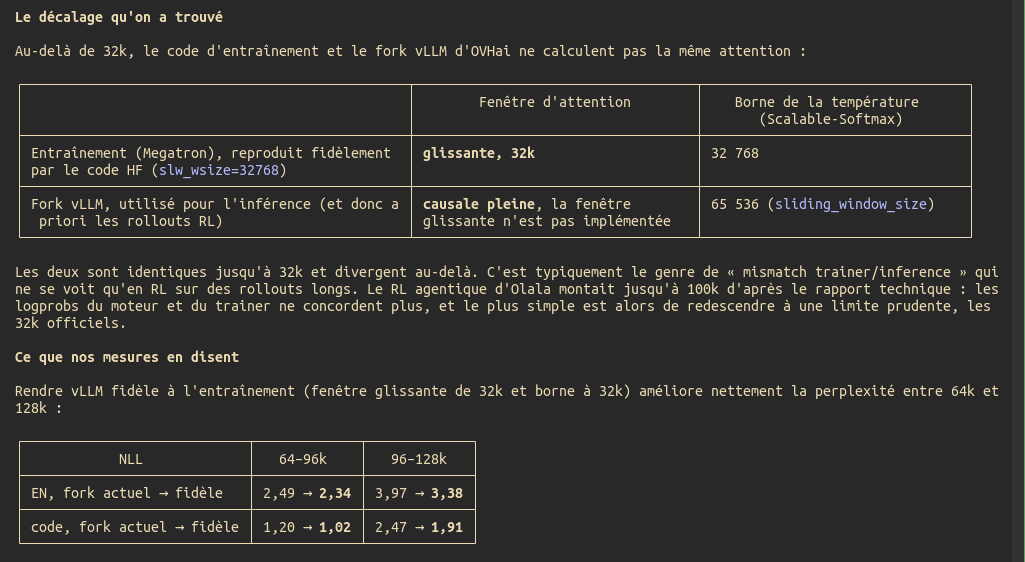
Au cas où vous auriez du compute disponible, ça m'intéresse fortement pour continuer à explorer les limites du modèle :
https://t.co/0r3wQCc7rX
Testez Olala Mini 7A1B qui tourne à 220-380 tokens/sec sur les B300 de Blade.
pour tester Olala:
https://t.co/lMFoDkpv3R
pour comparer Olala avec les autres models:
https://t.co/DABrMRCUcI
pour télécharger Olala et toute la doc technique:
https://t.co/lE6wpEpvSP
Olala v1.0 7A1A un petit modèle de démonstration qui active 1B par requête. C'est pourquoi il sait tourner de l'agentique sans GPU.
Contexte v1.0 : 32K puis v1.1 dans 6 semaines avec 128K donc sera meilleur en math.
La v2.0 sera >100B et bon en agentique, devops et cyber.
La destination de tous ces modeles : les clients d'OVH et OVH lui-même:
- OVHai Workspace en Cloud et Local avec du chiffrement (le Cloud est sur votre poste)
- Public Cloud & AI services d'OVHcloud
- les partenaires cyber de l'ecosystem d'OVH.