Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
曾同学👩🎓
@nicodigitial
90后 | Just Be Yourself! 主业海外市场Marketing 副业YouTube Ai 中长视频
Joined April 2023
683
Following
16
Followers
157
Posts
曾同学👩🎓
@nicodigitial
4 months ago
不管发生了什么,还能沉下心来认真做实事的女人真的超帅啊! 🙌
曾同学👩🎓
@nicodigitial
5 months ago
沉下心来认真做事才是最重要的,其他都是次要的。
曾同学👩🎓
@nicodigitial
11 months ago
#开悟
哪怕只是龟速行走,至少在朝着正确的方向前进了。
曾同学👩🎓
@nicodigitial
over 1 year ago
一番N8n流程搭建下来还是得靠Gemini pro,上下文支持量实在太高了,Claude pro太容易限制次数了还的开Max才行。
Who to follow
d. mar
@dmar00504458
niekuo
0X❣️47
@bitthree11
shuai
@Genius_Dogc
Crypto Apprentice
曾同学👩🎓
@nicodigitial
over 1 year ago
为了一个自动化N8N流程花了5天时间还没配置出来一个能用的,反复被Gemini pro带偏,Claude 一遍能解决的java 格式报错问题它怎么都整不出来。就因为Gemini pro就这么一直被它带沟里去,马上付费开一个Claude. 😖
曾同学👩🎓
@nicodigitial
over 1 year ago
年纪大了对一个人的失望都懒得敷衍了。
nicodigitial
retweeted
铁手(3卧槽版)
@0427SMtieshou
about 2 years ago
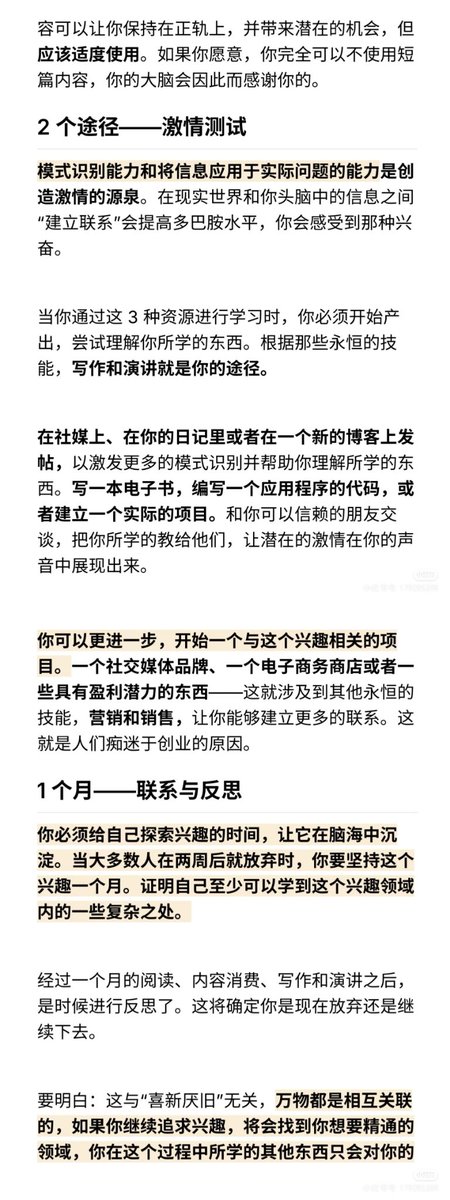
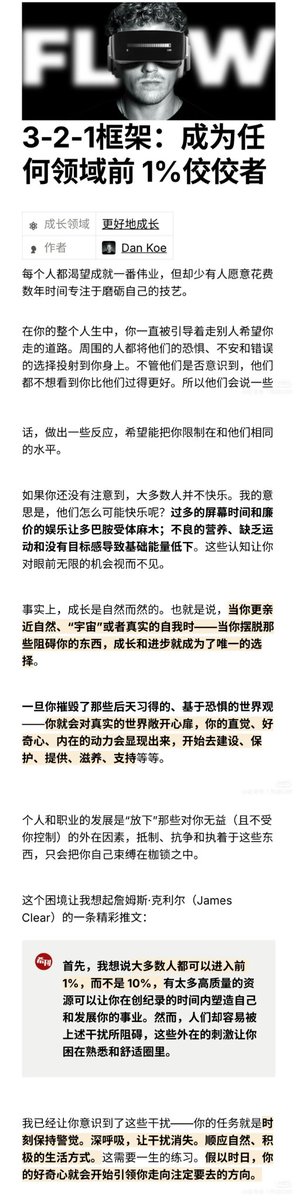
321框架:成为任何领域内前1%的赢家!���!
nicodigitial
retweeted
nicekate
@nicekate8888
about 2 years ago
数据分析自动化!Cursor Composer 和 Google Data Science Agent 使用指南 今天给大家介绍 Cursor Composer 和 Google Data Science Agent,帮你快速分析数据,自动生成交互式图表和报告! 时间戳: 0:00 - 0:20 介绍视频主题,两款 AI 工具 0:20 - 1:20 Cursor Composer 实战演示:分析学生饮食数据 1:20 - 1:55 Streamlit 介绍:快速构建数据分析应用 1:55 - 3:27 Cursor Composer 实战演示:分析电视市场数据 3:27 - 6:14 Google Data Science Agent 实战演示:分析全球城市 GDP 数据 #Cursor #数据分析 #编程工具 #效率神器 #datascience
See More
nicekate8888's tweet video.
nicodigitial
retweeted
Marcus
@marcuslejeune
about 2 years ago
1. The Art of "Niche Hacking" This was the first and most important step. We looked at the channels in the niche and identified their weaknesses.
曾同学👩🎓
@nicodigitial
about 2 years ago
@norvzi
tool
曾同学👩🎓
@nicodigitial
about 2 years ago
@theharut
Yes
曾同学👩🎓
@nicodigitial
about 2 years ago
@imatteo
Congrats
nicodigitial
retweeted
Nextify
@nextify2024
about 2 years ago
理解偏差,认识自己。
nicodigitial
retweeted
Star@Day1Global Podcast
@starzq
about 2 years ago
https://t.co/D8cEcPNPDb
nicodigitial
retweeted
Moritz Kremb
@moritzkremb
about 2 years ago
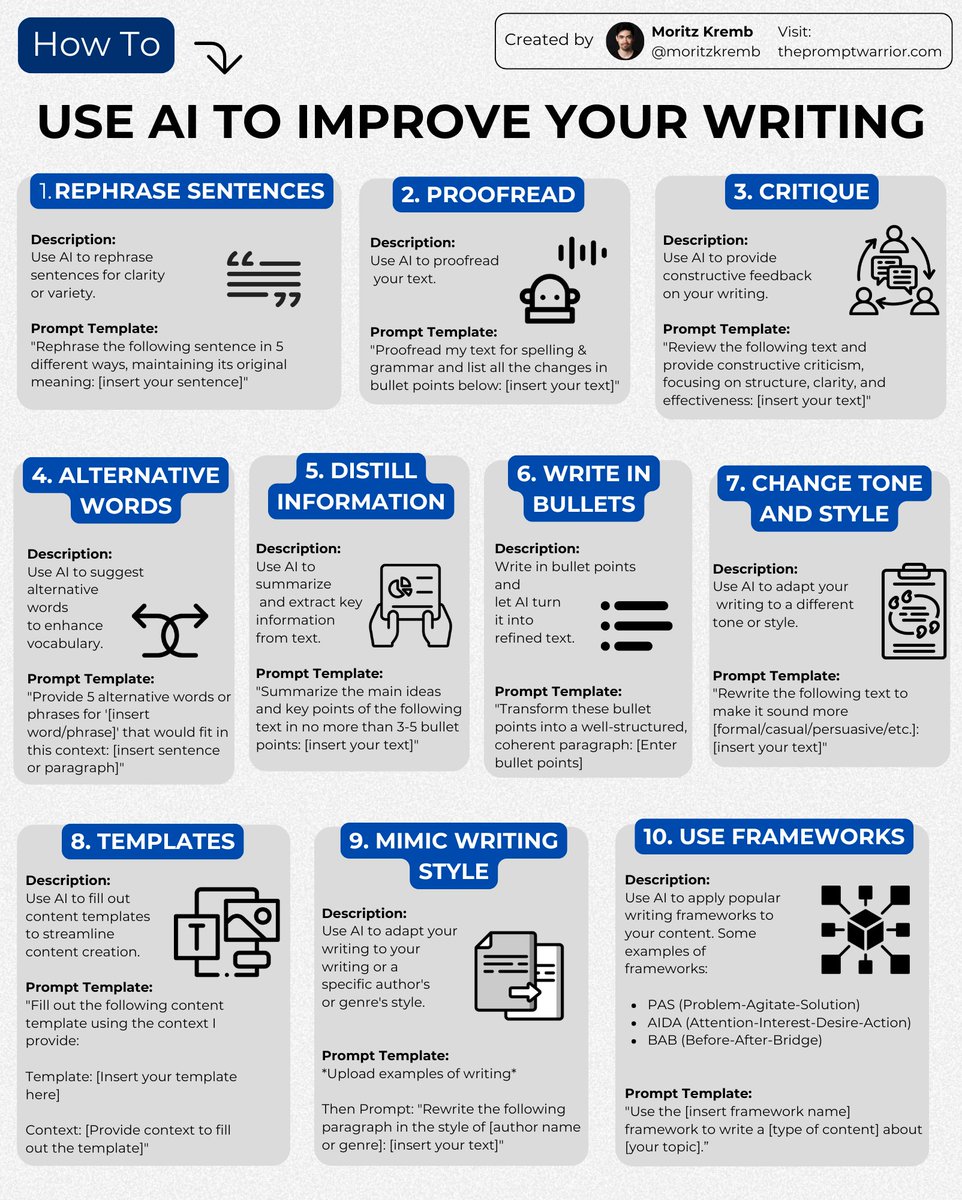
How to use AI to improve your writing: (With prompts to copy & paste)
nicodigitial
retweeted
宝玉
@dotey
over 2 years ago
推荐阅读:《我们在使用大语言模型 (LLMs) 构建产品一年中的经验总结 (第一部分) [译]》 文章主要分享了大语言模型核心组件的最佳实践,包括提示词设计、对 LLM 输出结果的评估,什么时候该用 RAG 还是微调等等。 一、提示词设计 1. n-shot 多样例 在提示词中加入 5 个以上不同类型的示例,覆盖各种可能情况 2. CoT 思维链 让 LLM 在输出结果之前解释其思维过程。简单的加入“让我们一步步思考”还不够好,最好是明确步骤 3. 输入输出的结构化 在使用结构化输入时,请注意每种大语言模型都有自己的偏好。Claude 偏好 xml,而 GPT 则偏好 Markdown 和 JSON。 4. 编写小而精的提示词,专注做好一件事 不要试图在一段复杂的中解决所有问题,尝试拆分成多个小而专注的提示词 5. 精心设计上下文信��� 上下文信息并非越多越好,而是要提供关键的有效信息,而不是冗余、自相矛盾和结构混乱的信息。 二、信息检索/检索增强生成(RAG) 1. RAG 输出的质量取决于所检索文档的质量 所检索的信息相关性越高、信息密度越高、文档细节越丰富,检索效果越好。 2. 关键字检索同样很重要 现在大部分 RAG 教程演示都是基于嵌入(Embedding),但很多应用场景关键字检索效果可能更好,最好是将嵌入和关键字结合使用 3. 优先使用 RAG 而不是微调 大部分时候是不需要微调的,RAG 便宜、容易实施,并且 RAG 提供了更精细的文档检索控制。 4. 即使是模型的上下文越来越长,RAG也不会过时 需要 RAG 来筛选输入模型的信息来提升上下文信息质量得到更好的结果,另外长上下文成本比较高。 三、从提示工程到工作流 1. ���步多轮的工作流能显著提升效果 将一大段复杂提示词分解为若干段短小提示词可以取得更好的效果,而多个短小提示词需要有工作流来支撑 2. 优先采用确定性工作流 工作流越确定越容易管理和控制 3. 合理使用温度(temperature)参数 如果希望 LLM 生成结果更加多样化,那么调高温度参数,如果希望更加确定性,则调低。 4. 不要忘记缓存 对于 LLM 生成的结果,可以缓存起来,下次有相同的请求可以重用节约成本。 5. 微调 有一些任务,即使是最巧妙设计的提示也无法胜任。例如,即使经过大量提示工程,我们的系统可能仍然无法返回可靠的高质量输出。如果是这样,那么可能有必要为特定任务微调模型。 如果决定微调,为了减少收集人工标注数据的成本,可以 生成并在合成数据上进行微调,或 在开源数据上引导。 四、评估与监控 1. 基于实际输入输出样本编写单元测试 收集实际应用的输入输出样本,用这些数据编写测试。由于 LLM 输出存在一定的开放性,可以用一些特殊的验证方式,比如字数、句子数在范围内,比如格式是否符合要求等。 2. 用 LLM 评估 LLM 生成结果 可行,但不是万能的。 3. “实习生测试” 把 LLM 当成大学实习生,如果这个任务实习生能完成,那么模型是不是也可以?如果实习生都不能完成,那么是不是应该简化拆分? 4. 过分强调某些评估指标可能损害整体性能 “当一个衡量标准变成目标时,它就不再是一个好的衡量标准。” 其他还有几个评估与监控方法,不再总结,有兴趣请阅读原文。 原文:https://t.co/PTKPZzigdt 译文:https://t.co/847rAw26CI
See More
nicodigitial
retweeted
歸藏(guizang.ai)
@op7418
over 2 years ago
给普通人的26条提示工程策略: 1、与LLM交流不需要礼貌,所以无需添加“请”、“如果你不介意”、“谢谢”、“我想”等短语,直接切入主题。 2、在提示中整合预期的受众,例如,受众是该领域的专家。 3、将复杂任务分解为一系列更简单的提示,进行互动对话。 4、使用肯定指令,例如“做...”,避免使用负面语言如“不要...”。 5、当你需要对一个主题、想法或任何信息有更深入的理解时,可以使用以下提示: 用简单的术语解释[插入具体主题]。 像对11岁的孩子解释一样对我解释。 像对[领域]的初学者解释一样对我解释。 用简单的英语写[文章/文本/段落],就像你在向一个5岁的孩子解释一样。 6、添加“我要给出$xxx的小费以获得更好的解决方案!” 7、实施示例驱动的提示(使用少量示例提示)。 8、在格式化你的提示时,以‘###Instruction###’开头,然后是‘###Example###’或‘###Question###’(如果相关)。随后,呈现你的内容。使用一个或多个换行符来分隔指令、示例、问题、上下文和输入数据。 9、包含以下短语:“你的任务是...”和“你必须...”。 10、包含以下短语:“你将受到惩罚”。 11、在提示中��用短语“以���然、人类化的方式回答一个问题”。 12、使用引导词,例如“逐步思考”。 13、在你的提示中添加以下短语:“确保你的回答是公正的,不依赖于刻板印象”。 14、通过提问让模型从你这里获取足够的信息,以提供所需的输出(例如,“从现在起,我希望你问我问题,以便...”。 15、如果你想了解一个具体的主题或想法或任何信息,并且你想测试你的理解,可以使用以下提示:“教我[任何理论/主题/规则名称],并包含一个测试,但不要给我答案,然后告诉我当我回答时是否正确”。 16、为大语言模型分配角色。 17、使用分隔符。 18、在一个提示中多次重复某个特定的词或短语。 19、将思维链与少量示例提示相结合。 20、使用输出引导词,即通过以期望输出的开始来结束你的提示。利用输出引导词,通过以预期响应的开始来结束你的提示。 21���要写一篇详细的文章/文本/段落/文章或任何类型的文本:“为我写一篇关于[主题]的详细[文章/文本/段落],详细添加所有必要的信息”。 22、要在不改变风格的���况下更正/更改特定文本:“尝试修订用户发送的每段文字。你应该只改进用户的语法和词汇,并确保它听起来自然。你不应该改变写作风格,例如将正式段落变成随意段落”。 23、当你有一个可能在不同文件中的复杂编码提示时:“从现在起,每当你生成跨多个文件的代码时,生成一个[编程语言]脚本,可以运行该脚本以自动创建指定的文件或对现有文件进行更改以插入生成的代码。[你的问题]”。 24、当你想要使用特定的单词、短语或句子来启动或继续文本时,使用以下提示:“我为你提供了开始[歌曲歌词/故事/段落/文章...]的开头:[插入歌词/单词/句子]。根据提供的单词完成它。保持一致的流动性”。 25、明确说明模型必须遵循的要求,以生成内容,包括关键词、规定、提示或指令。 26、要写任何文本,如文章或段落,目的是与提供的样本相似,包括以下指示:“请根据提供的段落/标题/文本/文章/答案使用相同的语言”。
See More
曾同学👩🎓
@nicodigitial
over 2 years ago
@1of10media
1of10
nicodigitial
retweeted
Jesse Lau 遁一子
@jesselaunz
over 2 years ago
在油管看见Jerry Jenkins讲的写小说12步骤,挺好,可以作为一个框架。 不是CC的视频,所以不搞字幕了。 我没看过Jerry Jenkins的小说,但维基上讲有100多部小说出版过了。 1. **选择故事想法**:从你热情所在的故事想法开始,确保这个想法足够吸引人,能够支撑起整本书的内容。 2. **确定你的写作方式**:判断你是“大纲者”(喜欢提前规划结构和情节)还是“即兴者”(边写边构思),使用适合自己的方式来组织故事。 3. **创造难忘的角色**:构建有深度的主角和反派,确保他们有充分��动机和性格发展,使角色真实且引人入胜。 4. **开展研究**:即使是虚构作品也需要通过精确的细节来增强故事的真实感,进行适当的研究以确保背景和细节的准确性。 5. **选择视角**:确定最合适的叙述视角(第一人称、第二人称或第三人称),选择一个或多个视角角色来讲述故事。 6. **开始写作**:使用“in medias res”(拉丁语,意为“事情中间”)的技巧开始你的故事,直接跳入行动或冲突中,立即吸引读者的注意。 7. **构建你的世界**:通过细节描写和背景设定,为读者创造一个具有浓厚氛围和可信度的故事世界。 8. **增加冲突和障碍**:确保主角在故事中面临足够的挑战和障碍,通过不断的试炼推动故事前进。 9. **达到高潮**:设置一个情节上的高潮,使主角面临看似无法克服的困难。 10. **解决冲突**:在故事最终阶段解决关键的冲突,展示主角如何克服困难,完成其性格上的转���。 11. **圆满结局**:提供一个满意的结局,解决所有主要的情节线,确保给读者一个记忆深刻的结束。 12. **编辑和润色**:完成初稿后,进行彻底的编辑和修订,提高语言的质量,确保故事的每一个部分都尽可能完美。
See More
nicodigitial
retweeted
howie.serious
@howie_serious
over 2 years ago
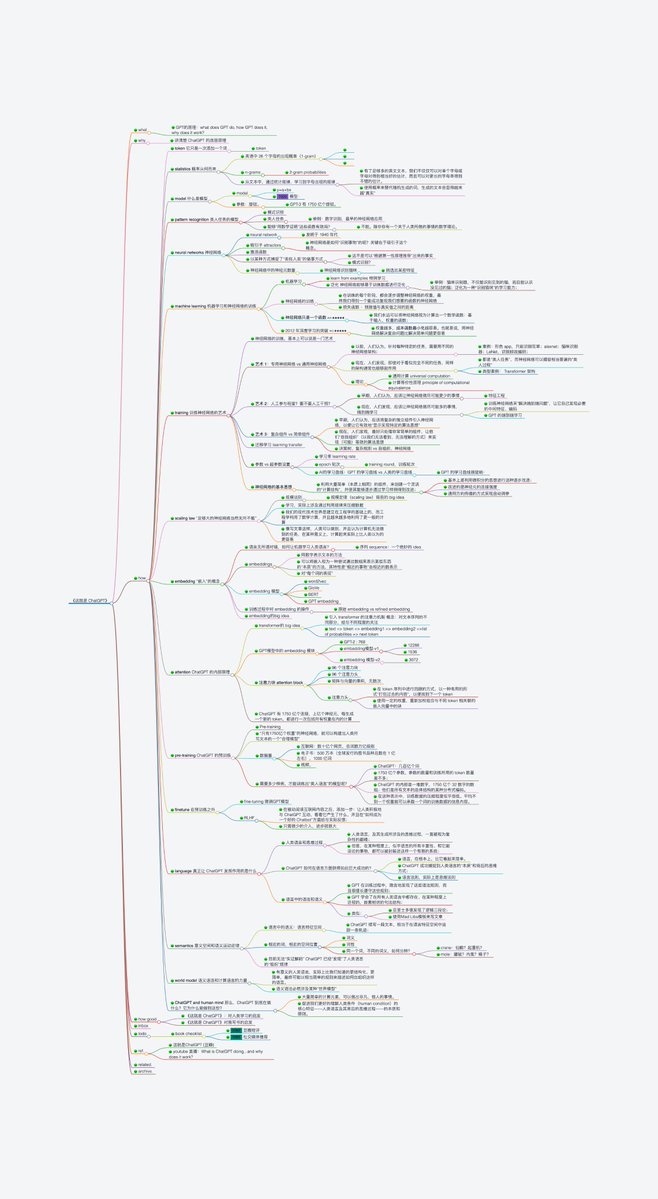
如何使用 ChatGPT 原理学会一切知识?读Wolfram 大神的神书《这就是 ChatGPT》之后的读书笔记 读了李沐大神的《使用随机梯度下降来优化人生》,忍不住拍大腿。加上前面推荐了wolfram 大神的神书《这就是 ChatGPT》,于是觉得有必要写点类似读书笔记或书评的东西。李沐的文章写于ChatGPT 之前,是结合随机梯度下降来讲人生道理的,我这篇准备从ChatGPT 原理出发,聊一聊 GPT对人类学习、构建个人知识体系的启发。以此文致敬两���大神。🫡 李沐的文章微言大义,只用了 1100 字。我对GPT原理的认识有限,所以写了5000字,请大家多多指正。 1 首先要有目标 所有机器学习,一定得有个目标函数。人类的学习也是如此,学习之前,目标先行。 目标函数,也叫成本函数,损失函数。**模型训练的目标就是让损失函数最小化**。人类学习,也是要不断接近自己的学习目标。 2 学习目标要大 GPT模型的训练目标,是用一个巨大的神经网络去模拟互联网上的所有人类语言文本,让损失函数最小化。目标基本达成,**GPT把基本上全部的人类知识压缩进了万亿参数的单一模型**,实现了通用认知任务上的卓越表现。 GPT的学习目标不可谓不大。 人类学习也是如此。目标不能太小,你的学习不是为了通过某次考试,取得某个分数。在我看来,人的学习应当以构建个人知识体系为学习目标。 在你在外,人类知识体系(body of knowledge)是一种客观存在,wikipedia 和书籍等都是对人类知识体系的一种��理和构建的实践,我称之为bok1。在你之���,你的脑子里应该有一个自己的个人知识体系,关于一个或多个学科或领域,我称之为 bok2。 **个人学习的目标,是缩小bok2和bok1之间的差距,形成你自己的更全面更扎实更强大的bok2。** 为什么学习目标要足够大?神经网络训练的实践有一个发现:**参数越多,成本函数最小化越容易。正因为这个规律,用神经网络解决复杂问题比解决简单问题更容易**。所以,AI 现在可以写作编程绘画,但是还没法在餐馆端盘子。 人类学习也是如此。目标足够大,进步才可能足够大,走的才能足够远。 3 从实例中学习 机器靠**样例学习**(learn from examples),从数据中学习,而非通过规则学习(符号AI路线已经破产多年)。机器通过大量的大量的数据来学习到数据中蕴含的模式和规律,就好像从大豆中压榨出其中丰富的油脂。 人类也应当从实例中学习。一本书,一篇文���,一个知识视频,一次演讲录像,一次面对面交谈,都是你���习的来源。从实例中,你学到丰富的、鲜活的、有意义的知识。 4 用高质量信息作为学习数据 **Garbage in,garbage out。这是机器学习的第一性原理**。如果数据本身不富含意义,哪怕训练数据再多,可能训练出来的大模型也无法实现高级的智能,甚至还会从垃圾材料中学到满嘴脏话。GPT的训练数据集是精心挑选的高质量数据,包括 Wikipedia、书籍、论文、代码以及高质量的互联网文本。 所以,人类的学习是不是也要尽可能用高质量信息作为学习数据?**在一头扎进某本垃圾教科书之前,先精心设计你的学习数据集**。对于任何主题,我通过什么小册子轻松上手登堂入室?通过大师的那本科普书获得大图景(big picture)?哪几本教科书才是全国范围内最好的教科书?有那些知识视频让我更直观更好的理解这个主题?有什么工具能让抽象复杂的知识变得具体而清晰? 学习是从数据中体验意义的过程。只有通过高质量的文章、书籍、视频、课程、网站和工具,才能高效提炼出真正的知识。 5 从错误中学习 在GPT模型的预训练过程中,数据依次通过神经网络的各层,最终生成下一个token。token的预测值和实际值之间的差异,这是模型的误差(error)。error = diff(预测值, 实际值)。 GPT就是通过error来学习,把误差用反向传播的方法反馈回去,调整模型参数,降低损失函数。 **预测下一个 token => 得出error => 反向传播 => 梯度下降 => 调整参数 => 预测下一个 token** GPT 只能通过误差来学习,人也是如此,只能从错误中学习到东西。错误和不足,是反馈的重要来源,也是最好的来源。 然而,人是追求奖励逃避惩罚的动物。**教育的规训让人追求正确,回避错误**。在孩子身上尤其明显,孩子会觉得错误不好,正确才好,一直正确一直好(直到ta迎来必然到来的重大挫折)。 我们可以认识到这个思维陷阱并尽量避免:虽然错误让人痛苦,但错误是唯一的学习���源。只有通过错误,人才能学到点什么东西。 6 唯有学习才能改变自己 GPT模型的训练过程,就是不断调整模型的过程,训练的每一步都在改变模型参数,改变模型本身的连接配置。 人的学习也还如此。每一次费曼,都得到你当前的理解与费曼式理解之间的差距,根据这个差距来调整,查资料,加深理解,再一次费曼。 每一次学习,都在改变你的大脑。不是比喻意义上的改变,而是字面意义上的改变,在生物和物质层面的改变:**短时记忆就是大脑突触之间神经递质增加释放,长时记忆就是基因表达蛋白质合成折叠,形成新的突触连接**。经过充分学习训练的大脑,在结构上不学习的大脑是截然不同的。之间的区别,类似于大脑和脑花之间的区别。 学习改变了大脑,改变了你,字面意义上的改变。 7 把阅读作为学习方法 **GPT的学习,是使用上百万GPU时间做一件事:阅读,阅读整个互联网,阅读几乎所有人类的语言文本**。这个阅读过程被被称为“预训练”,而GPT的阅读,只在做一件事:预测下一个token。而 GPT 的阅读量,是上万亿个 token。 人类的学习,也应该把阅读作为主要方法。scaling law对 GPT 适用,对人类神经网络也同样适用。人大附中早培班要求六年级小学生每年阅读五百万字,约 50 本书。个人认为这是保底要求。**人类学习者,需要首先成为一个贪婪的阅读者:一年五十本书。每天至少阅读一小时。** 没有预训练,GPT 无法学习;没有阅读,人类无法学习。 8 把费曼作为理解方法 GPT的理解,是在万亿维度的意义空间,用注意力机制,在数百层神经网络中,通过上万次的矩阵向量乘法来加工处理文本转化成的数字向量。 **text => token => generic embedding => embedding 2 => embedding x => final refined embedding => list of probabilities => next token** 对于一个token,GPT用它的上下文来不断关联,提取特征,调整这个向量在语言意义空间中的位置,形成富含意义的、更准确的理解。 人类的理解,也是把知识��块和它的上下文不断建立丰富的、有意义的关联。最好的理解方法就是费曼技巧。**首先费曼知识砖块,然后不断费曼知识砖块之间的关联。通过清晰的概念以及概念之间的关联,人类形成自己的理解。** 把阅读作为学习方法,把费曼作为理解方法,一个概念接着一个概念,一次费曼接着一次费曼。 而且,费曼技巧,就是人类的“预测下一个token”。费曼的实际结果与期待结果之间的差异,就是我们在具体实例学习中得到的 error。针对这个 error,计算梯度,沿着梯度前进一部,你就得到了改进。 9 把迭代作为进步方法 GPT模型是在万亿token的高质量数据上训练出来的,用反向传播来传递误差,用随机梯度下降来减少模型误差。**每一个token的生成,都是神经网络中上亿神经元的一次激活,都是一次包含万亿参数在内计算。** 人类的学习,每一次费曼都是一次对神经网络的调参过程。哪怕是对一个概念的理解和费曼,都不是一蹴而就的。费曼x3,任何一个概念都要至少费曼三遍。在有间隔的多次费���中,你对一个概念的理解变得越发清晰。 这是一种迭代式的学习闭环。闭环,迭代,这是学习之要义。把迭代作为进步方法。 10 规模法则,大力出奇迹 GPT模型是遵循规模法则(scaling law)的,规模法则是当前AGI之路的关键方法。wolfram说,“足够大的神经网络当然无所不能”。 人类神经网络,是否遵循规模法则?海量知识砖块的积累,构建出越发庞大、多元的个人知识体系,是否能像 GPT 一样带领个体发展出更强大的智能水平?用简单的话说,人类的学习,是否是“大力出奇迹”,凡事都靠积累? 答案很可能是肯定的。 11 身为父母,减少人为干预 曾经,人类设计AI系统走的是规则路线(符号AI)。曾经,机器学习是需要人工建立特征的(有多少人工,才有多少智能),相当于人类工程师教机器学习。现在,深度学习是端到端的,不用人为的特征工程。AI科学家们发现,学会放手,让神经网络做尽可能多的事情,让神经网络自己学习。**学会放手,结果惊人。** 身为人类父母,是不是也应该减少人为的、低水平的干预?大部分父母自己不是学习专家,不懂学习原理,强行扮演教育家是不是反而伤害了孩子的学习?是不是父母们也应该学会放手,不要瞎设计瞎教学? ��子的大脑就像一个等待训练的 GPT模型,与其自上而下去指导教学,不如每天陪着孩子读半小时书,像一个朋友一样,让孩子���乐地享受伟大的预训练过程(阅读)。每天晚饭后,孩子做作业,大人在旁边读书学习。作业完成后,一起快乐共读,一起谈天说地。学会放手,生活更美好,学习更有效。 12 注意力是最贵的 GPT的T,是transformer架构。而transformer的精髓在于其用算法实现了类似人类的注意力机制,从而让模型在阅读文本时针对文本序列的不同部分给与不同程度的关注。 GPT的学习,是注意力分配的艺术。 人类的学习,也是注意力分配的艺术。当你阅读,你在不同内容上分配不同程度的注意力,关注概念之间的关联。 而且,整个有效学习的前提,是你能在学习这件事上建立并维持你的注意力。注意力的质量,决定学习的质量。 然而,你的注意力,是很多厂商虎视眈眈的猎物,10 亿短视频用户每天刷 150 分钟短视频,人们的注意力模式每天都在被短视频算法疯狂训练,训���到最后,一篇长文章都读不下去,更不要说严肃的书籍读物。 机器在学习,人类在沉迷。**机器通过注意力机制实现了更强大的认知能力。而人类的注意力却愈发稀缺和脆弱。短视频是免费的,但是,注意力却是最贵的。** 13 预训练之外的后训练 在让GPT模型阅读完互联网文本之后,OpenAI的科学家们还做了重要的一步:让人类积极地与GPT互动,并且在“如何称为一个更好的LLM助手”方面给与实际反馈。 是的,GPT模型的训练,除了预训练之外,还有**后训练:微调(finetuning),奖励建模(reward modeling)和RLHF(基于人类反馈的强化学习)。预训练占比95%,是绝对大头;后训练强调少而精,事半功倍。** 人类学习也是如此。除了海量阅读作为预训练,还需要后训练作为补充。 对海量阅读的孩子进行考试元技能的微调,只做了 8 套真题,8 岁儿童就能通过 FCE 考试。而对孩子的三观培养,家庭的家风建设,则类似于 GPT 模型中的奖励建模。为人父母,我们最重要的角色就是正反馈父母,不要学上“老中”的毛病,不过脑子,什���话难听说什么。只要做好正反馈,每个孩子都能培养出强大的澎湃的学习内驱力。 14 语言就是思维本身 人类语言,以及语言生成所涉及的思维过程,一直被视为复杂性的巅峰。而ChatGPT的成功给我们一个启示:在某种程度上,似乎人类语言的所有丰富性,以及人类能用语言谈论的所有事物,都可以被封装进一个有限的系统。 语言,在根本上,似乎比它看起来简单。**ChatGPT 则成功捕捉到了人类语言的“本质”和背后的思维方式**。ChatGPT 在训练过程中,隐含地发现了人类语言的语法规则,并且很擅长遵守这些规则。人类语言中丰富的语义信息,也被 GPT 通过向量空间中无数次的矩阵计算成功提取出来,存储为万亿参数构成的神经网络连接。通过掌握人类语言,GPT 还建立了某种意义上的世界模型。 人类学习也不应轻视语言,把语言视作普通的一个科目,分值有限,在高考中拉不开差距。不宜把口头的语言表达视作非核心技能,不宜把书面语言的写作技能视作非核心技能。每一个终身学习者,都应该足够重视语言,重视演讲作为核心技能,重视写作作为核心技能。 15 学习,快与慢的艺术 机器学习的快慢由一个超参数决定:**学习率 learning rate**,这是模型在梯度下降时的步子长短。步子太大,可能无法实现模型损失函数的最小化。步子太小,梯度下降太慢,效率太低。神经网络的训练中,合适的学习率是只能在实践中摸索出来的,只能来自经验。 人类学习也是如此。步子太大,看起来学的快了,但是理解浅,遗漏多。突击可以让你在考试中蒙混过关,但在实际应用中需要支付更高的代价。步子太小,龟速爬行,学起来会没劲。在快速学习和深度学习之间平衡,是学习的艺术。 而掌握这么艺术的最佳方式,是构建自己的知识树。以知识树为目标的学习,在快与慢之间最容易取得平衡:前期快速搭建框架,快速建立大局观,获得正反馈;然后慢慢微调,一个概念接着一个概念,看起来慢,但实现了更好的快。 16 学习,没有人出生在罗马 有人煽动起跑线焦虑,说什么“有的人出生在罗马”。在财富和权力层面可能对,但在学习这件事上,众生平等,没有人的家住在罗马。哪怕是马斯克的孩子,也得自己亲自预训练自己的神经网络,也得自己逼近学习目标,而且没有捷径。 机器学习也有起点和终点。起点是初始化的随机参数,终点是高维空间中损失函数最小的点。GPT模型的学习,就是在万亿维度的意义空间中找到这个最低点。 LLM们的学习都是后天的,难道ChatGPT比文心一言聪明是因为它出生在罗马?学习就是在万亿维度的意义空间趋近自己的目标函数,所有学习者的起点都是一样的,没有人生在终点,没有人家在罗马。 17 学习,每个人有自己的时区 有人煽动学习焦虑,像把大活人变成竹节虫,让人生布满“节点”: “婴儿英语启蒙要抓住关键节点”,“三年级真的至关重要” ,“大二是最关键的一年”,“人生最关键的节点是35岁”……多少岁毕业,多少岁买房,多少岁结婚,多少岁生子���多少岁财富自由…… 这个“社会时钟”妄图规定出一个人生的“标准时间”,规定了人们在不同的阶段要完成相应的 KPI。在“社会时钟”下,很多人在疲于奔命地过一种“打卡人生”。 但是,GPT的学习,是万亿维度的意义空间的旅程。每一条梯度下降的路线,都是逼近目标函数的路线,没有一个固定的、正确的路线。 人的学习也是如此。我们不需要一个“社会时钟”来规定你是迟到了还是来不及了。娃 6 岁了还没学 scratch,是不是晚了?孩子已经初中了,英语词汇量才 500,是不是来不及了?我三十多岁了,才开始学 python,丢不丢人? 每个学习者都有自己的时区,按照自己的节奏,走在终身学习终身成长的道路上。芒格曾经说过,我今年学习了做 PPT,我这 90 多岁的老狗还能学会新技能,你们年轻人还担心什么。 只要你还在学习,还在往前走,就无所谓早晚。每个人都是独一无二的,每个人对自己的路线拥有主导权和解释权。横向比较是愚蠢且没必要的。 18 学习,简洁是更高级的复杂 机器学习的早���,人们认为应该在神经网络中使用各种复杂的独立组件,从而让神经网络“显式地实现特定的算法思想”。GPT之后,人们发现,更好的方式是使用非常简单的组件,让它们“自我组织”,反而能更好地实现算法思想。 **ChatGPT原理的一大启示:最强大的智能,并非通过复杂部件的堆砌,反而来自结构简单的无数计算元素的组合,以及朴实无华的scaling law。** 最复杂的神经网络,由最简单的基本结构组成。人类的学习也是如此。不要迷信复杂的工具和技巧,大道至简,简单最好。 最庞大的知识体系,也不过是由一系列简单的事实性知识、概念、模型组合而成,而学习这些概念的方法本身也是简单而非复杂的,朴实而非深奥的。 --- 这些,就是 ChatGPT 教给我关于学习的道理。
See More
Last Seen Users on Sotwe
fin (Commission open)
Seen from
Netherlands
Dario
Seen from
Belgium
The Cay Wild 😘
Seen from
Netherlands
عمكم السوداني 🔥(فحل الديوثين والمعرصين)
Seen from
France
Sen ben
Seen from
Turkey
King Leo🤴🏽
Seen from
United Kingdom
Jennifer Granda
𝑪𝒐𝒖𝒑𝒍𝒆 𝑻&𝑻 🍑
Seen from
Thailand
𝓦.
Seen from
Colombia
UTANMAZ BEYLER ÖZEL İÇERİKLER
Seen from
Turkey
Trends for you
1
Good Monday
Under 10K tweets
2
Jessie Bates
Under 10K tweets
3
#MondayMotivation
Under 10K tweets
4
Guna Yala
Under 10K tweets
5
Victory Monday
Under 10K tweets
6
#中国叠纸姚润昊纵欲狂魔
Under 10K tweets
7
Amnesty
Under 10K tweets
8
Nvidia
Under 10K tweets
9
Ray J
Under 10K tweets
10
Calle 18
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.4M followers
2
Barack Obama
@barackobama
118.8M followers
3
Cristiano Ronaldo
@cristiano
114.5M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107.1M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.3M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.4M followers
13
Kim Kardashian
@kimkardashian
70.8M followers
14
YouTube
@youtube
68.7M followers
15
Neymar Jr
@neymarjr
66.4M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.2M followers
19
CNN
@cnn
61.7M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫