Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
套利豪仔🗽
@pritipatelcut
价值投资者|专业白嫖|套利|分享实用工具|推文不构成任何投资建议
#Binance
做对的事,把事做对
HK
Joined February 2024
13.8K
Following
27.5K
Followers
1.7K
Posts
套利豪仔🗽
@pritipatelcut
about 8 hours ago
在多因子模型中,我们习惯为每个因子设定资金权重,但资金比例不等于风险贡献,高波动因子即使权重不高,也可能主导组合的总风险。本文想谈谈因子风险平价,如何让每个因子对组合风险的贡献趋于均等,避免单一因子在主导风险 从资产风险平价到因子风险平价 风险平价的概念最早应用于资产配置层面。传统的投资组合将资金平均分配到不同资产,但这种做法忽略了不同资产的波动率差异。债券的波动率远低于股票,等权重的股债组合,其风险几乎完全由股票主导。资产风险平价透过调整权重,让每个资产对组合总风险的贡献相等,使债券的权重远高于股票,从而达到真正的风险分散 因子风险平价将同样的逻辑应用到因子层面。在多因子模型中,我们可以将每个因子视为一个因子模拟组合,例如价值因子对应的是做多低本益比股票、放空高本益比股票的多空组合。这些因子组合各自有预期报酬与波动率,彼此之间也存在相关性。因子风险平价的目标,就是为这些因子组合分配权重,使得每个因子对整体多因子组合的风险贡献相等 如何求解因子风险平价权重 求解因子风险平价权重最常用的方法是循环坐标下降法。这个算法的核心思想是,每次只调整一个因子的权重,使其风险贡献等于目标水平,然后依序更新其他因子,反复迭代直到收敛 首先,给定一组初始权重,通常设为等权重或反波动率权重。接着,对于每一个因子 i,计算其当前的风险贡献 RC_i,然后调整其权重 w_i,使得调整后的风险贡献等于目标值 σ_p / N。这个调整可以透过求解一个二次方程式来完成。更新完所有因子后,重新计算组合的总波动率与各因子的风险贡献,检查是否收敛。如果未收敛,重复上述步骤,直到风险贡献的变异数小于某个默认的容忍值 另一种方法是使用牛顿法或序列二次规划,直接求解非线性方程组。这些方法收敛速度较快,但需要计算共变异数矩阵的逆矩阵,在因子数量较多时可能面临数值不稳定的问题 在实务中,循环坐标下降法因为其实作简单且数值稳定,是最常被采用的方法。它的收敛速度虽然较慢,但对于因子数量在数十个以内的情况,通常能在数百次迭代内达到足够的精度 因子风险平价与其他配置方法的比较 等权重配置是最简单的方法,每个因子获得相同的资金权重。它的优点是简单、透明、不需要估计共变异数矩阵。但它的缺点是忽略了因子之间的波动率差异,导致高波动因子主导组合风险。在因子数量较少且波动率差异不大的情况下,等权重与风险平价的差异可能不显著;但当因子数量较多且波动率差异明显时,两者的风险结构将截然不同 均值变异数最佳化是理论上最优的方法,它同时考虑了预期报酬与风险,试图在效率前缘上找到最适配置。均值变异数最佳化对预期报酬的估计极为敏感,微小的估计误差就会导致权重剧烈变动,产生极端集中的配置。因子风险平价则完全不依赖预期报酬的估计,只使用共变异数矩阵,因此在实务上更加稳 反波动率配置是介于等权重与风险平价之间的方法。它将每个因子的权重设定为其波动率的倒数,再进行标准化。这种方法能够降低高波动因子的权重,但没有考虑因子之间的相关性。当因子之间存在显著相关性时,反波动率配置的风险贡献仍然可能偏离均等。因子风险平价则同时考虑了波动率与相关性,是更完整的解决方案 实务上的注意事项 共变异数矩阵的估计误差是最大的挑战。因子风险平价的权重完全取决于共变异数矩阵的估计。如果使用历史数据估计共变异数矩阵,样本期间的选择、频率的选择、以及极端值的处理,都会影响估计结果,进而影响权重。在因子数量较多时,样本共变异数矩阵可能不稳定甚至不可逆。建议使用收缩估计法或因子模型来提高共变异数矩阵的稳定性 因子数量的影响也值得注意。当因子数量增加时,因子风险平价的权重会趋于分散,每个因子的权重都变得很小。这虽然降低了单一因子主导的风险,但也可能导致组合的预期报酬下降,因为每个因子的曝险都被稀释了。在实务中,因子数量通常控制在五到十五个之间,过多或过少都不理想 再平衡频率的选择同样重要。因子风险平价的权重需要定期重新计算,因为共变异数矩阵会随着时间而变化。再平衡频率太低,权重会偏离最适配置;频率太高,则会产生不必要的交易成本。一般建议每季或每半年重新计算一次权重
See More
套利豪仔🗽
@pritipatelcut
1 day ago
谈谈日历效应为什么会失效 同一个日历效应,可能在2025的回测里很好,换到今年就失效了,问题不在于执行,在于这类效应天生脆弱。以下四种失效方式,几乎涵盖了大部分的案例: 星期效应通常会在几年之内失效 有人统计过星期一报酬偏低、星期五偏高,理由是情绪。但把样本切成前后两段,两张图几乎对不起来,效应会自己换边。小时效应也一样,把不同年份分开画,同一个小时的表现差异很大,看不出稳定的讯号。用时间当特征的策略最怕这种不稳定,因为你分不清手上抓到的是这几年的巧合,还是真正存在的结构 看起来最高的夏普比率,往往只是市场曝险beta 有一个买在选择权到期前五天、到期日卖出的策略,回测的Sharpe和对标的的 beta数字看起来都还可以,但两个问题藏得很深:它本身带着市场方向,而它的比较基准持有时间长得多、波动不同,算出来的 beta 只会低报。把 beta 避掉之后,绩效反而更差,这在这一类效应上是很常见的结果 成本决定了哪些效应根本不用回测 有些效应是真的,只是赚不回手续费。以前比特币与以太币在每根小时线收完之后的那一分钟确实有规律,但把买卖价差算进去就知道不可能覆盖成本,而且这个价差在波动放大时还会放宽。另一个问题是这些小时效应的回测假设零手续费、只计价差,结论是这样的设定不现实。凡是预期报酬只有几个基点的效应,值得做的处理是把它并进执行流程 样本不够的效应,数字再大也不建议 低频效应最大的问题是次数太少。一个跨国选举的日历策略,二十年只做出四十四笔交易,即使平均单笔报酬看起来不错,这个样本撑不起robust的结论。 最大的问题是资料量根本不够,无法分辨它是讯号还是噪音。拿到一个日历效应时,先问它在样本里出现过几次,比先问它的夏普比率有用得多
See More
套利豪仔🗽
@pritipatelcut
3 days ago
这波zec的涨势矿工狂喜 Zec 矿机短短时间2手的价格已经被炒到1万美刀 2个月前 全新机不到3000 完全fomo 真的大恭喜Zec 矿工杠杆真的赚满满
套利豪仔🗽
@pritipatelcut
3 days ago
靠 打开电脑 突然看到里面有 100万刀 我还想说谁这么扯 结果是我账号忘记登出了🤪🤪🤪
套利豪仔🗽
@pritipatelcut
3 days ago
大多数交易者永远无法理解的一个悖论: 用更小的仓位交易,实际上可能比重仓交易更快地让账户增长 因为小仓位能够带来一致性,而真正能够随着时间产生复利效应的,正是一致性
套利豪仔🗽
@pritipatelcut
4 days ago
这个网站,可以让你完整体验一趟航班,却完全不用开飞机 它叫 InFlightSimulator → https://t.co/wUPQFY3FH4 真实机场、真实航线、真实飞行时间,但你只需要待在客舱里 选择出发地,再选一个目的地,然后你就可以坐到窗边,看着整趟航程慢慢进行 伦敦飞雷克雅未克,3 小时 伦敦飞东京,直接坐一整夜 甚至还有阿拉斯加 Deadhorse、斯瓦尔巴群岛、雅库茨克这些位于世界尽头的真实机场 你可以在机舱里走动,打开遮光板、关上遮光板,也可以随时换座位 里面甚至还有一个「收集国家旗帜」的小玩法:每完成一趟航班,就能解锁你到访过的国家 没有驾驶舱,没有任何飞行操控,也没有什么任务目标 你就是一名乘客 坐在窗边,看着脚下的世界缓缓移动,就像小时候终于抢到靠窗位置,却又无聊到只能一直盯着窗外看的那种感觉 这个网站是一个叫 Robert 的人独自做出来的 他说,他只是想模拟自己在这个世界上最喜欢的一件事: 坐在一趟特别漫长的航班上,望着窗外发呆,然后不停猜测——脚下经过的每一座湖、每一个小镇,到底叫什么名字 选两个机场 坐到窗边 然后在现实世界里,哪儿也不用去
See More
pritipatelcut's tweet video.
套利豪仔🗽
@pritipatelcut
5 days ago
如果你把任何一个市场的隐含波动率与后来的已实现波动率画在同一张图上,会看到一个持续了数十年的现象:隐含波动长期高于已实现波动。这个差距就是波动率风险溢价(Volatility Risk Premium, VRP)。它普遍存在于大部分时间,并非只在少数极端时段才有的异常。这也是为什么卖波动的策略看起来总是那么容易赚钱 波动率风险溢价,它到底在补偿什么? 溢价的本质是保险费 买期权的人买的是保护。持仓遇到跳空、遇到流动性断层、遇到无法连续对冲的行情时,期权是唯一还能履约的工具。卖期权的人提供的正是这份保护,而 VRP 就是他们收取的保费 这个视角一转,很多事情就说得通了。保险费是对承保风险的补偿,长期收取保费确实能累积正报酬,但前提是你承受得起偶尔一次的大额理赔。卖波动的策略之所以长期曲线漂亮、偶尔一次回吐数年利润,正是因为它的收益结构跟保险业完全一样:大部分时间收小钱,少数时间赔大钱 所以当有人说「卖波动是稳定收益」的时候,更准确的说法是它的收益分布为负偏。用 Sharpe Ratio 看它会觉得很吸引,但 Sharpe 假设报酬近似常态,而卖波动的报酬偏偏不常态 波动率有清楚的季节结构 要判断保费收得够不够,得先知道风险什么时候来。波动率的分布远比多数人想象的有规律:日内有所谓的开收盘效应,一周之内工作日明显高于周末,月内亦有月初月末的差异 这些规律的成因并不神秘。固定时点的再平衡、期权与期货的结算、宏观数据的公布时间,都会把交易活动压缩到特定窗口;而周末其他市场休市、新闻量下降、参与者减少,波动自然收缩。换句话说,波动的季节性其实是市场作息时间表的投影 这个结构的实用价值在于,它让「现在该收多少保费」变成一个可以估算的问题,不必单靠感觉。当你能预测未来一段时间的已实现波动大概落在什么区间,你就有能力判断当前隐含波动是偏贵还是偏便宜。这才是卖波动真正的决策依据 从「溢价存在」到「溢价可交易」之间,隔着执行 这里是最多人跌倒的地方。即使方向判断完全正确,能不能把溢价真正收进口袋,取决于两个常被低估的成本 第一是摩擦成本。波动率策略的持仓周期通常很短、调整频繁,而每一次调整都要付价差。当单次预期的边际收益只有几个基点时,用市价单吃单几乎必然把利润全部交出去。这也是为什么这类策略几乎只能靠限价单执行,用被动成交去换取成本优势 第二是逆向选择。限价单有个天生矛盾:你的单子成交得越顺,通常代表对手越急、资讯越充分。当市场朝着对你不利的方向快速移动时,你的报价会被大量吃掉;而当行情平稳、对你有利时,你的单子却挂在那里没人碰。做市商把这种专挑自己报价下手的订单流叫做毒流(toxic flow),它正是 VRP 策略在微观层面的具体形式。你收的溢价,有一部分就是用来补偿你被毒流选中的概率 所以同样一个卖波动的策略,在两个不同的执行框架下,实际绩效可以差到把策略从赚钱变成亏钱。定价模型给你的是理论边界,执行质量决定的才是你实际拿到多少。这两者之间的差距,往往比策略本身的 alpha 更大 什么时候该停手 既然溢价是对风险的补偿,那么当风险本身改变时,溢价就该重新定价。有几个讯号值得盯着:已实现波动开始持续抬升而隐含波动没有跟上,代表保费收得不足;波动率曲面的偏斜(skew)明显走平,代表市场对尾部风险的定价正在下降;而流动性深度收缩,则意味着一旦需要调整部位,成本会比模型假设的高得多 这三个条件同时出现的时候,通常并不是加仓的时机。真正让卖波动策略爆掉的,往往来自判断之外的东西:在保费明显不足的环境下仍然维持原本的规模 回测阶段表现良好的策略,进入实盘后仍需要持续检视 Sharpe Ratio、最大回撤以及风险收益比是否维持稳定,并根据市场变化调整配置。对负偏的收益结构而言,这一步尤其不能省 结语 波动率风险溢价是一份需要持续定价的合约。你要判断的,在于以现在的价格,这份风险你愿不愿意接。溢价一直存在,问题从来只在价格 很多人把卖波动当成稳定收益的来源,其实并非策略本身有问题,真正难的是:在保费充足时敢于收,在保费不足时敢于停,并且在两者之间维持一致的执行纪律 长期而言,稳定的决策框架,往往比一次成功的判断更有价值
See More
套利豪仔🗽
@pritipatelcut
6 days ago
在量化交易中,多数人将精力投入于讯号开发与因子优化,却经常忽略了从决策到成交之间的执行成本。同样一笔交易,在不同的下单方式与市场环境下,实际成交价格可能天差地远。本文想谈谈交易成本分析,让净报酬的评估更贴近实盘 什么是交易成本分析 交易成本分析的核心概念是,将一笔交易的实际成交价格与某个基准价格进行比较,计算两者之间的差异,并将这个差异归因于不同的成本来源 在回测阶段,我们通常会对交易成本做出简化的假设,例如:每次交易的成本为单边 0.15%。这种假设虽然方便,但无法反映真实市场中成本的高度变异性。同样一笔 100 万元的交易,在流动性充沛的大型股上可能只产生 0.05% 的滑点,在流动性不足的小型股上却可能产生 0.5% 以上的滑点。TCA 的价值,就在于它能够用真实的成交数据来取代这些粗糙的假设,让净报酬的评估更贴近实盘 TCA 的运作流程可以分为三个步骤。第一步是选择一个基准价格,作为评估执行绩效的参考点。第二步是计算每一笔交易的实际成交价格与基准价格之间的差距。第三步是将这些差距汇总、分析,找出成本偏高的模式与原因 交易成本的组成 手续费与税是最容易理解的部分。券商收取的手续费通常是成交金额的固定比例,而交易税则依各国法规而定。这些成本在对账单上清楚可见,不需要 TCA 来估计 买卖价差是下单时立即面对的成本。当我们用市价单买进时,成交价格会是委卖价而非委买价,两者之间的差距就是价差成本。价差的大小取决于标的的流动性与当下的市场状况 市场冲击是交易对价格的永久性影响。当一笔大单进入市场时,它会吃掉委托簿上的流动性,推升买进价格或压低卖出价格。市场冲击的大小与下单规模、市场深度以及下单速度有关 滑点则是从决策到成交之间,因价格变动而产生的成本。这个成本可以是正的也可以是负的,如果价格在我们买进之后上涨,滑点对我们有利;如果价格在我们买进之后下跌,滑点对我们不利 机会成本是那些未能成交的交易所造成的潜在损失。如果我们挂了一笔限价单,但价格没有触及,该笔交易就未能执行。如果后续价格朝有利方向发展,我们就错失了获利的机会 TCA 的目标,就是将这些成本从总执行缺口当中拆解出来,让我们知道钱究竟花在了哪里 如何计算执行缺口 执行缺口是 TCA 最核心的指标,它衡量的是实际成交价格与基准价格之间的差异。计算公式为: 执行缺口 = (实际成交均价 - 基准价格) / 基准价格 对于买进交易,正的执行缺口代表我们买贵了;对于卖出交易,正的执行缺口代表我们卖便宜了。无论是哪一种,正数都代表成本 基准价格的选择会直接影响执行缺口的数值。常见的基准价格有以下几种 决策价格是策略产生交易讯号时的市场价格。这是理论上最理想的成交价格,但实际上很难达成,因为从讯号产生到下单、再到成交,中间必然存在时间延迟 开盘价是当日开盘的价格。如果策略在开盘时执行,开盘价就是一个合理的基准 收盘价是当日收盘的价格。如果策略在收盘时执行,收盘价就是一个合理的基准 VWAP是当日所有成交的加权平均价格。它是评估执行绩效最常用的基准之一,因为它反映了当日市场的平均成交水平。如果我们的成交均价优于 VWAP,代表执行绩效良好 TWAP是当日各时点价格的简单平均。它适用于将大单平均分散到全天执行的情境 选择哪一个基准,取决于策略的执行方式与评估目的。如果策略是在特定时间点下单,决策价格或该时点的市场价格就是合适的基准。如果策略是将大单分散到全天执行,VWAP 或 TWAP 则是更合适的基准 TCA 的实作流程 第一步是资料收集。TCA 需要的不只是成交回报,还需要当时的市场价格资讯。具体来说,我们需要记录每一笔交易的以下资讯:下单时间、下单价格、成交时间、成交价格、成交数量、以及下单时的市场报价。这些资讯可以从券商 API、交易所资料或内部的交易日志中取得 第二步是基准价格的计算。根据策略的执行方式,选择合适的基准价格,并为每一笔交易计算对应的基准值。如果使用 VWAP 作为基准,需要取得当日的 VWAP 数据;如果使用决策价格,则需要记录讯号产生时的市场价格 第三步是执行缺口的计算与拆解。对每一笔交易计算执行缺口,并尝试将缺口拆解为价差成本、市场冲击与滑点等成分。拆解的方式可以透过比较不同时间点的市场价格来进行。例如,价差成本可以近似为下单时的买卖价差的一半;市场冲击可以透过比较成交价格与成交后一段时间的市场价格来估计;滑点则是决策价格与下单价格之间的差距 第四步是汇总与分析。将所有交易的执行缺口汇总,计算平均缺口、缺口的标准差、以及不同维度下的缺口分布。常见的分析维度包括:按股票、按交易时段、按下单规模、按券商、按算法等。这些分析能够帮助我们找出成本偏高的模式 第五步是回馈与调整。根据分析的结果,调整下单方式、选择更适合的券商、或优化执行算法。TCA 不是一次性的工作,而是一个持续的循环,每一次调整之后,都需要重新收集数据、重新分析,确认调整是否真的带来了改善
See More
套利豪仔🗽
@pritipatelcut
6 days ago
@DavidHoong1
不一样的
套利豪仔🗽
@pritipatelcut
7 days ago
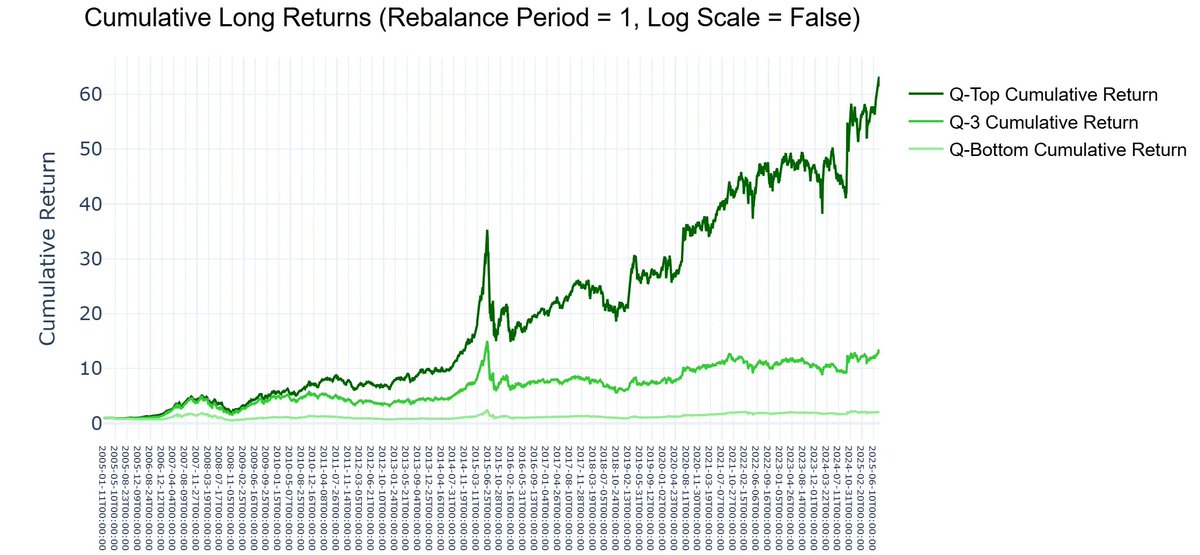
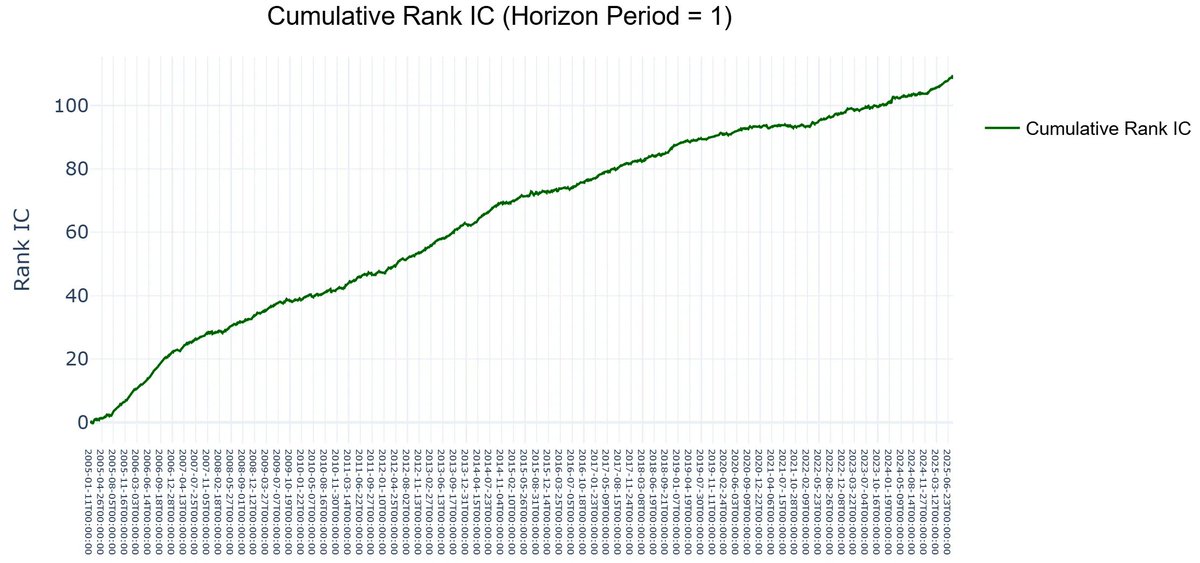
今天又测了一个很有意思的量化因子,叫做「价量协同失效反转因子Price-Volume Decoupling Reversal Factor( 下面会放测试图) 逻辑其实也很直觉:正常情况下,价格与成交量之间应该存在某种「协同关系」——上涨伴随放量、下跌伴随缩量,这是市场共识的典型表现。 但当这种关系在短期内被打破,例如价格上涨但成交量并未同步放大,或者成交量剧烈变化但价格反应迟钝,往往代表市场内部出现了结构性分歧 因子公式如下: (-1 * RANK(COVIANCE(RANK(CLOSE), RANK(VOLUME), 5))) 本质上是在捕捉市场中「价量协同失效」所带来的结构性错配,并试图在这种错配回归正常关系的过程中,获取反转收益 两行源代码就可跑完整回测,大家可以去试试 https://t.co/cvZgUElpJA
See More
套利豪仔🗽
@pritipatelcut
7 days ago
随着时间推移,市场结构的改变可能让某些因子逐渐失效,其实际贡献持续衰退。本文想谈谈如何透过滚动窗口回归计算各因子的实际负载,监控其衰退速度,在因子刚开始失效时就及时发现征兆 为什么因子权重会随着时间衰退 因子权重的衰退,本质上反映的是因子预测力的衰减。一个因子之所以在模型中被赋予正向的权重,是因为它在历史上展现了对未来报酬的预测能力。然而,这种预测力并非永恒不变的 市场结构的变化是最根本的原因。新的监管政策、交易机制的改变、市场参与者组成的演化,都可能从根本上改变一个因子的有效性。一个在散户主导的市场中有效的因子,在法人机构占比提高后可能完全失灵。一个在低利率环境中有效的因子,在利率上升后可能不再具备同样的预测力 因子的拥挤效应同样会侵蚀因子的超额报酬。当一个因子被越来越多的市场参与者所使用时,它的套利空间会被逐渐压缩。那些曾经可以利用该因子获利的交易机会,因为竞争者的加入而变得越来越稀少,因子的预测力也随之衰减 风险溢酬的变化是另一个因素。某些因子的超额报酬来自于承担特定风险所获得的补偿。当市场对该风险的定价发生变化时,该因子的溢酬水平也会随之调整 如何计算因子的滚动权重 监控因子权重衰退的核心工具是滚动窗口回归。这种方法不是使用全部历史数据来估计单一组权重,而是在每一个时间点,使用过去一段固定长度的数据来重新估计各因子的权重。这样做能够捕捉权重随时间的变化 具体的操作方式如下。假设我们有一个由 k 个因子组成的多因子模型,以及策略在每期的超额报酬。在每一个时间点 t,我们选取过去一段固定长度的历史数据,以策略的超额报酬为被解释变数,以各因子的值为解释变数,进行复回归分析。回归所得到系数 β₁(t) 到 β_k(t),即为该时间点各因子的估计权重 透过将这个估计过程对每一个时间点 t 重复执行,我们会得到每一组因子权重的时间序列。这些序列的变化轨迹,就反映了各因子权重随时间的演化 衰退速度的衡量指标 权重的时间趋势斜率是其中一个指标。对某个因子的滚动权重序列进行线性回归,估计其随时间变化的斜率。如果斜率为负且统计上显著,代表权重存在系统性的下降趋势,因子的影响力正在持续衰退。斜率的绝对值愈大,代表衰退的速度愈快 权重的半衰期是另一个有用的概念。计算某个因子的滚动权重从其历史高峰下降至一半时所需要的时间。如果某个因子的权重半衰期很短,代表其有效性的持续时间极为有限,在纳入多因子模型时应该被赋予较低的初始权重或更频繁地被重新评估 权重变异系数衡量的是权重估计值的稳定性。计算滚动权重序列的标准差除以平均值,得到变异系数。如果某个因子的权重在不同时期之间剧烈波动(即变异系数很高),代表该因子的贡献极不稳定,即使平均权重为正,其可靠性也值得怀疑 实务上的注意事项 滚动窗口的长度选择会影响结果。窗口太短,权重估计的噪声较大,容易对短期的市场波动过度反应;窗口太长,权重变化对市场结构转变的反应过于迟钝。一个常见的作法是测试多种窗口长度并比较结果的稳定性 估计误差的管理同样重要。滚动权重是从样本数据中估计出来的,本身就存在抽样误差。在判断权重是否衰退时,应该同时考虑其统计显著性,而非仅看数值的增减。一个权重从 0.12 下降到 0.10,但如果两者的标准误皆为 0.08,这个变化可能只是随机波动而非真正的衰退 衰退速度监控与因子择时的区别也需要厘清。因子权重的衰退速度监控是一种诊断工具,目的是为了识别因子有效性的长期变化趋势。因子择时则是试图根据近期的因子表现来预测其短期的未来表现。前者关注的是结构性的、慢速的变化,后者关注的是周期性的、快速的变化。两者的工具与方法应该有所区分
See More
套利豪仔🗽
@pritipatelcut
8 days ago
不知道是否因为受OpenAI 不上市 还是AI巨头要放缓 抑或沙国油管、曼德海峡被胡塞控制…影响 除油价上涨3%外 软银现在跌10% 韩股跌3%以上,海力士更跌5%以上 连同美国芯片、光通讯科技股夜盘也都表现不佳
套利豪仔🗽
@pritipatelcut
9 days ago
最近忙完Conference,终于有时间写下文章。这篇文章主题关于一个200亿次大爆炸都不会发生一次的事件,但是1987年发生了。文章内容偏Hardcore,但是我觉得挺有趣和值得分享给大家 市场上存在一类专门买保险的策略。长期买入价外Put期权,平时持续支付保费、承受时间值损耗,等待市场急跌之时,这批期权以非线性的速度升值,为组合提供保护。这类被称为Tail-Risk Fund的策略,最著名的实践者是由Mark Spitznagel创立、Nassim Nicholas Taleb担任顾问的Universa Investments 一、三个学术概念 Volatility Risk Premium,波动率风险溢价,Bakshi与Kapadia在2003年发表于《Review of Financial Studies》的研究,以1988至1995年的S&P 500指数期权数据,检验买入期权再用正股做Delta对冲的组合,发现这类组合的平均回报显著为负。整体而言,这个对冲策略平均每个持有期,每张期权由买入持仓至到期,输掉约指数水平的0.05%,平值Call的组合更输约0.10%。他们的结论是期权价格隐含的波幅之中,包含了一个显著为负的市场波动率风险溢价,期权买方长期向卖方支付一笔稳定的溢价。 Overpriced Puts Puzzle,价外Put定价过高之谜,Bondarenko在2014年发表于《Quarterly Journal of Finance》的研究发现,S&P 500价外Put的历史价格,贵到他所测试的一系列标准定价模型,没有一个能够解释。这个发现有两种读法,下面第三段会详细拆解。 Antifragility,反脆弱性,Taleb与Douady在2013年发表于《Quantitative Finance》的同行评审论文,将反脆弱由一个书名概念,落实为一个严格的数学定义。一个仓位的反脆弱性,等于它对分布离散度的正向敏感度。这个属性近似于一个正Vega的非线性回报结构。这篇论文的重要性在于,它证明了由波动中获益不是一个文学比喻,而是一个可以被量度、被检测的数学属性。 二、Convexity的实际威力 (以下是用Black-Scholes模型做的简化教学计算,不是任何基金的实际持仓或成交纪录;实际市场里,价外Put在危机时的买卖差价会大幅扩阔,真实成交价会与理论价有明显出入。) 假设一只股票现价100美元,无风险利率5%,你买入一张6个月后到期、履约价80美元的Put,20%价外: 平静市况,隐含波幅15%,这张Put的理论价格只有约0.031美元,接近免费。 急跌市况,假设约三星期后,股价跌至80美元、隐含波幅跳升至60%。这张Put的理论价格急升至约11.75美元,较买入价上升约385倍。 这里要做两层披露。第一层是基数效应,385倍这个倍数如此震撼,是因为买入价的基数接近零。以实际美元计,每张合约,100股的利润是约1,172美元,而不是385倍你的身家。第二层是成因分解,这385倍的升幅之中,其实包含了两股力量。如果股价跌了20%但隐含波幅完全没动,这张Put会升至约2.36美元,即约77倍;换句话说,最大的部分来自期权由价外变成价内的价格效果,Gamma驱动,而IV跳升,Vega效果,则负责将77倍再推上385倍。Convexity的完整威力是两者叠加,这点对理解尾部策略的回报结构很重要。 但这个示范只展示了危机发生那一面,没有展示危机迟迟不发生那一面。而后者,正是学术文献中记载得最详尽的部分。 三、学术界的两面证据,保险是贵的,但尾巴亦是真的 这是整个题目中最少人愿意同时呈现的一部分,因为两边的证据都是真的,而且都经过同行评审。 证据一,买保险长期是亏损的。Coval与Shumway在2001年发表于《Journal of Finance》的研究,样本期1986至1995年,发现S&P 500指数的零Beta跨式组合,Zero-Beta Straddle,平均每星期录得约−3%的回报。但这里有一个常被忽略的精确之处,同一篇研究发现,Call期权的预期回报其实是正的,因为Call本质上是正股的杠杆化曝险,它的正回报只是反映着正股本身的风险溢价。真正长期录得负回报的,是Put期权与跨式组合这类对波幅敏感的仓位。所以准确的讲法是就算你先对冲了所有方向风险,持有波幅曝险这个动作本身,长期都是一个负回报的行为。配合Bakshi与Kapadia (2003) 的发现,学术界对期权买方在波幅曝险上长期支付溢价这一点,证据是相当一致的。 证据二,但这个贵,本身就是市场不相信常态分布的直接证据。Jackwerth与Rubinstein在1996年发表于《Journal of Finance》的研究,样本期1986年4月至1993年12月,由S&P 500期权价格反推出市场的风险中性分布,发现在1987年股灾之后,市场对三个标准差下跌的定价概率,是对数常态分布预测的约10倍;对四个标准差下跌的定价概率,更是约100倍。 讲到这里,可以回头拆解Bondarenko那个谜团的两种读法。悲观的读法是价外Put的价格长期高得不合理,买保险的人持续向卖方进贡,持有它是一个期望为负的动作;但另一种读法刚好相反,价外Put之所以贵到没有任何标准模型解释得到,正是因为市场的集体定价行为,长期、持续地把常态分布模型预测不到的尾部风险计算在内。换句话说,这个谜团本身就是市场不相信常态分布的价格证据,同Jackwerth与Rubinstein的10倍、100倍发现,是同一枚硬币的两面。 这里必须加一个技术上的关键区分,以上是风险中性定价概率,不是现实世界的发生概率。风险中性分布混合了两样东西,市场对概率的估计,以及市场对这个状态的厌恶程度,亦即是风险溢价。所以正确的解读是市场为4-sigma下跌付出的价格,是常态模型下的100倍,而不是市场认为4-sigma下跌的发生概率高100倍。这个区分很重要,因为它直接关系到下面第四段的局限讨论。 Bollerslev与Todorov在2011年发表于《Journal of Finance》的研究再进一步,用极值理论与高频数据证明,市场对罕见灾难事件的恐惧补偿,占了股票风险溢价与波动率风险溢价的很大一部分。即是说,你在股市赚到的长期回报,有相当一部分其实是承担尾部风险的报酬。 四、学术文献记载的真实案例: 1987年股灾前后,期权市场说了些什么 案例的价值,不单止在事件本身,还在学术文献如何用事后数据重建当时市场的心理状态。 股灾之前,Bates在1991年发表于《Journal of Finance》的研究,检验了1985至1987年S&P 500期货期权的实际成交价,发现一个反直觉的事实,由1986年10月至1987年8月,期权价格隐含的跳跃扩散参数显示,市场某程度上预期到崩盘风险,隐含分布已经呈现负偏态;但在股灾前的最后两个月,期权市场反而没有显示强烈的崩盘恐惧。即是说,市场的警觉不是线性递增的,它会在危机前一刻松懈下来。 股灾本身的统计含义,Jackwerth与Rubinstein (1996) 在论文开头做了一个著名的计算,1987年10月19日,两个月期的S&P 500期货价格下跌29%,如果假设回报服从对数常态分布、年化波幅20%,接近历史水平,这一日是一个−27个标准差的事件,发生概率是10的负160次方。他们的原话是就算你经历了宇宙整个200亿年的寿命、再重复200亿次,200亿次大爆炸,这个跌幅在这段时间之内发生过一次,都是实际上不可能。而且他们指出1987年不是孤例,1989年10月13日,S&P 500单日跌约6%,在同一假设下是一个−5个标准差事件,概率是0.00000027,理论上每14,756年才应该发生一次。 股灾之后,Jackwerth与Rubinstein (1996) 发现,1987年股灾是市场定价行为的一个永久断裂点,股灾之前,期权隐含分布大致对称、贴近常态;股灾之后,隐含分布永久变成负偏态、肥尾,而且这个改变在他们的样本期内从未逆转。Rubinstein在1994年发表的另一篇《Journal of Finance》论文,将这个现象命名为Crash-o-phobia,崩盘恐惧症,市场经历过一次常态模型说不可能发生的事件之后,永久性地将肥尾风险定价进每一张期权里面。 但这里有一个你必须知道的诚实局限,Gemmill与Saflekos在2000年发表于《Journal of Derivatives》的研究,用FTSE-100指数期权检验了四个崩盘时期,包括1987年与1989年以及三场英国大选,发现隐含分布的形状并不能够预测崩盘,它只是在崩盘发生之后立即改变形状;隐含分布可以反映市场情绪,但这种情绪几乎没有预测能力。换句话说,期权市场那张对常态假设的否决票,是事后补投的,不是事前预警。这个发现与Bates (1991) 股灾前两个月反而松懈的观察是一致的,你可以用期权价格看到市场多害怕,但没办法用它来预测什么时候会跌。 五、我的看法 这批文献教懂我的,不是应不应该买保险,而是如何理解保险的价格背后的信息,以及它的边界。 第一,当你见到价外Put很便宜之时,不要急着高兴,Bakshi与Kapadia的研究告诉你,期权贵是常态,便宜才是异常;而Bates的研究告诉你,这种异常的便宜可能正是危机前的松懈的讯号。 第二,当你见到别人展示黑天鹅策略赚了几百倍的故事之时,记住Coval与Shumway的数字,持有波幅敏感仓位的长期平均回报是负的。任何一个靠尾部策略赚大钱的故事背后,都有一段漫长的、没有人写出来的流血期。评估这类策略,你不可以只看它收割的那几个月,你要看它熬过的那几年。 第三,也是我今次最想示范的一点,坊间流传着不少黑天鹅基金嘅回报神话,例如Universa Investments这类尾部基金在历次股灾中的惊人回报数字,但这些数字全部只见于媒体报道与基金公司自己的客户信件,未经同行评审,所以我特意将它们全部抽走,连同Gemmill与Saflekos那个期权价格没有预测能力的反证都放进来,是想示范一件事,在这个话题之内,最精彩的数字往往是最不可靠的数字,而最可靠的文献往往是最不精彩的,甚至是讲着与你想听的东西相反的结论。一个成熟的交易者,应该学会在精彩但不可查证与沉闷但经得起检验之间,永远站在后面那边。模型终究只是现实的近似值,而动人的故事,终究都只是未经检验的样本。
See More
套利豪仔🗽
@pritipatelcut
11 days ago
对于期权二阶希腊字母Vanna在动能策略对冲应用的一些思考 很多人理解期权对冲,只停留在Delta:标的升了,持仓的方向风险变大,就卖出一些现货或期货;标的跌了,便反向调整。这个理解没有错,但它漏掉了一个更深的问题: 如果价格在变,隐含波动率也在变,原来那个Delta本身还可靠吗? Vanna处理的正是这件事。它衡量的是隐含波动率改变时,期权Delta会如何改变。换句话说,Vanna并不直接告诉我们市场升还是跌;它告诉我们,价格与波动率一起移动时,原本的方向曝险会被放大,还是被削弱 这对动能策略很重要 一段上升趋势,若同时伴随隐含波动率回落,期权组合的Delta可能沿着有利方向调整。原本只是价格上行,后来却因为波动率变化,使方向性曝险进一步偏向上方。动能讯号在这种环境下,往往比单看价格突破更有延续性 但市场若一边上升、一边出现隐含波动率急升,情况便不同。价格仍然创高,图表也许很好看,Vanna带来的Delta变化却可能抵销部分原有趋势。这时候,价格动能未必失效,只是它的质量下降了。若交易者仍以相同仓位追入,很容易把波动率压力误读成趋势确认 所以,通常不会把Vanna视为单独的交易讯号,但把它当成动能策略的滤镜 策略的第一层,仍是价格本身: 趋势是否存在、报酬斜率是否稳定、突破是否持续 第二层才看价格与隐含波动率的关系:两者的联合变化,是否令Vanna朝有利方向发展。只有当这两层讯号互相支持,可以考虑提高仓位;若两者背离,则降低曝险,甚至只保留观察部位 更深一层的应用,是把Vanna由「讯号」改造成动态仓位变数。不要只问Vanna是正还是负,可以估算当价格变动一个单位、波动率变动一个单位时,整个期权组合的方向曝险会改变多少。研究时可按履约价与到期日分层,建立整体Vanna曲面,再观察目前价格所在区域的局部斜率。若价格上升会使方向曝险越来越集中,代表动能可能具有延续性,仓位可以逐步增加;若价格稍微上升便使曝险快速反转,则应视为脆弱趋势,采用较低仓位或更短持有期。这比单纯使用一个总Vanna数字更有用,因为真正影响交易的,往往是下一段价格移动后风险如何变化 这个概念必须可以检验。可以把期权持仓汇总成Vanna曝险,再比较不同价格&波动率状态下的未来报酬,确认它能否改善既有动能因子的IC,并在样本外维持稳定
See More
套利豪仔🗽
@pritipatelcut
12 days ago
本文想谈谈如何计算策略报酬与市场波动率的相关系数,并透过波动率分组分析,了解策略在不同波动环境下的真实行为 为什么波动率对策略如此重要 波动率不仅仅是风险的度量,它本身就是影响市场结构的关键变数。当波动率上升时,市场会出现几个系统性的变化。价格发现的过程可能暂时失序,因为极端价格跳动会干扰正常的买卖盘配对;市场参与者的行为模式也会改变,避险需求增加、风险承受度下降,导致资金从高风险资产流向避险资产;流动性提供者可能在波动率上升时撤单,使市场深度下降,进一步放大价格的波动 这些变化会直接影响量化策略的运作环境。一个依赖于价格趋势延续的策略,在波动率上升但趋势明确的时期可能表现良好;一个依赖于价格稳定回归均值的策略,在波动率飙升时可能因为价差持续扩大而遭受损失。理解策略对波动率的敏感度,是评估策略在不同市场环境下可行性的重要环节 计算策略与波动率的相关性 定义波动率指标。市场波动率可以用多种方式来衡量。最常见的选择是使用 VIX 指数,它反映了市场对未来 30 天 S&P 500 指数隐含波动率的预期。或自行计算市场指数的历史波动率,取过去一段时间,例如 20 个交易日的指数日报酬率标准差,再乘以年化因子 计算策略报酬与波动率的同期相关性。将策略的每日报酬率与同期的市场波动率进行配对,计算相关系数。如果相关系数为正,代表策略在波动率较高的时期倾向于产生较高的报酬;如果为负,代表策略在波动率较高的时期倾向于表现较差 计算落后相关性。除了同期相关性之外,落后相关性也具有重要的参考价值。例如,计算今日的波动率与明日的策略报酬之间的相关系数。如果落后相关系数显著,代表波动率本身具有一定的预测能力,可以用于策略的部位调整 波动率分组分析 相关系数虽然简单直观,但它假设策略报酬与波动率之间的关系是线性的。在金融市场中,这种关系往往是非线性的,策略在波动率从 10% 上升到 20% 时的表现,可能与从 20% 上升到 30% 时的表现完全不同。因此,除了计算相关性之外,我们通常会进一步进行波动率分组分析 分组方法。将整个样本期间按照市场波动率的高低划分为若干组。最常见的做法是将波动率排序后分为五等份:波动率最低的 20% 为低波动组,波动率最高的 20% 为高波动组,中间依此类推 计算各组的绩效指标。对于每一组,分别计算策略在该组所对应时期的平均报酬率、夏普比率与最大回撤。这些指标的跨组比较,能够清楚地揭示策略在不同波动环境下的表现差异 观察绩效的趋势。如果策略的平均报酬随着波动率的上升而单调递增,代表策略具有波动率偏好的特性;如果随着波动率的上升而单调递减,代表策略具有波动率厌恶的特性;如果没有明显的趋势,代表策略对波动率不敏感。这种非线性的资讯是单纯的相关系数无法提供的
See More
套利豪仔🗽
@pritipatelcut
14 days ago
美国前总统拜登的儿子 Hunter Biden 确认将于 9 月 9 日在 Base 链发行个人 Meme 币 LAPTOP 如果你只把它当成又一场名人的无聊跟风,那就严重低估了这背后的恶趣味 拆解其代币机制后会发现,这不仅是把当年的笔记本丑闻做成自嘲,更像是一场冲着特朗普量身定制的链上政治复仇,几个看点如下: 1. 极致嘲讽:定向空投给买 TRUMP 亏损的散户 代币总量的 20% 设立为空投,其中第一批明确划拨给“此前买入 TRUMP 亏损的人”。这招直接把政敌发币留下的套牢盘,打包吸收成了自己的社区流动性,杀人诛心🤡 2. 挂钩大选结果,对赌式销毁 机制设定最高可销毁 30% 供应量,但销毁条件完全绑定了政治博弈:比如“民主党赢下 2028 年总统大选”、或“$LAPTOP 估值反超 ;如果对赌失败,这部分代币将转入慈善 3. 筹码比例反向打脸 特朗普此前发币,将高达 80% 的份额归于关联实体;而 创始团队(含 Hunter 本人)只拿 30%,并设定了 6 个月完全锁仓与 2 年线性释放 虽然同为政治资本变现,但在吃相上刻意做足了反衬姿态
See More
套利豪仔🗽
@pritipatelcut
14 days ago
为了检验因子值的平稳性,KPSS检定提供了一个与ADF检定互补的视角。本文想谈谈KPSS检定的基本原理,以及它在因子值平稳性检验中的具体应用 KPSS检定的基本原理 KPSS检定将时间序列分解为三个部分的总和:一个确定性趋势、一个随机漫步,以及一个平稳的误差项: x_t = α × t + u_t + e_t 其中 u_t 是一个随机漫步,e_t 是平稳的误差项。KPSS检定的虚无假设是:随机漫步部分的变异数为零,亦即 σ² = 0。在虚无假设成立的情况下,序列中不存在随机漫步的成分,整个序列的变动完全来自于确定性趋势与平稳误差,换句话说,序列是平稳的。当虚无假设被拒绝时,代表序列中存在显著的随机漫步成分,序列是非平稳的 KPSS检定提供两种形式的虚无假设,分别对应不同的检定模式。第一种是水平平稳,检验序列是否围绕着一个固定的平均值平稳波动。第二种是趋势平稳,检验序列是否围绕着一个线性趋势平稳波动。在检验因子值时,通常采用水平平稳的设定,因为我们期望因子的平均值在不同时期保持一致,而非持续上升或下降 KPSS与ADF的互补关系 KPSS检定与ADF检定的核心差异在于虚无假设的设定方向不同。ADF检定的虚无假设是序列不平稳,而KPSS检定的虚无假设是序列平稳。这个差异决定了两者在实务中的互补角色 ADF检定只有在存在足够强的证据时才会拒绝不平稳的虚无假设,因此它倾向于认定序列为不平稳。KPSS检定则相反,它只有在存在足够强的证据时才会拒绝平稳的虚无假设,因此它倾向于认定序列为平稳。这两种检定的结合使用,能够提供更完整的诊断 在因子值检验中的应用 因子值的长期稳定性检验。计算因子在每个月的平均值或中位数,形成一个时间序列,然后对该序列进行KPSS检定。如果检定结果显示因子值为平稳,代表因子的排序基础在不同时期具有一致性。如果因子值呈现持续上升或下降的趋势,则需要考虑对因子进行标准化或去趋势处理 不同市场环境下的稳定性比较。将历史样本划分为不同的子期间,分别对因子值进行KPSS检定。如果在某个子期间内因子值呈现非平稳,而在另一个子期间内为平稳,代表因子的行为在不同市场环境下存在系统性差异,这对于策略的风险管理具有重要的参考价值 因子转换前后的平稳性确认。在对因子进行标准化、行业中性化或正交化等转换处理之后,可以用KPSS检定来确认转换后的因子值是否具备平稳性。一个平稳的因子值序列,是后续统计建模与讯号生成的基础
See More
套利豪仔🗽
@pritipatelcut
16 days ago
我们会对策略的风险结构设定明确的目标,市值中性、产业中性、或对特定因子的曝险控制在某个范围内。但策略在实际运行的过程中,这些因子负载并非一成不变。本文想谈谈如何透过定期计算策略的因子负载,确保策略的实际风险结构始终与设计目标保持一致 什么是因子负载与曝险漂移 因子负载衡量的是投资组合对特定风险因子的敏感度。在一个多因子模型的框架下,投资组合的超额报酬可以被分解为: R_p - R_f = α + β_1 × F_1 + β_2 × F_2 + ... + β_k × F_k + ε 其中 β_1 到 β_k 分别是投资组合对第 1 到第 k 个风险因子的负载,F_1 到 F_k 是这些因子的报酬,α 是超额报酬,ε 是残差项 举例来说,如果一个策略的市值因子负载 β_size 为 0.3,代表该策略倾向于持有小型股,当小型股整体表现优于大型股时,该策略会因此受益。如果 β_size 为 -0.2,代表该策略倾向于持有大型股。如果策略的设计目标是市值中性,则我们期望 β_size 在统计上不显著异于零 曝险漂移指的是这些因子负载随着时间而发生变化的现象。一个在初始设计时为市值中性的策略,可能因为小型股的价格上涨使其在组合中的权重增加,导致 β_size 逐渐转为正值。如果没有定期检视并进行调整,策略的实际风险结构就会与设计目标产生偏差 为什么曝险会随着时间漂移 价格变动导致的权重偏移是最直接的成因。即使策略在调仓日严格按照目标权重配置,在两次调仓之间,不同股票的价格涨跌幅度不同,会导致它们在组合中的实际权重发生变化。上涨较多的股票权重会膨胀,下跌较多的股票权重会萎缩。如果这些股票的因子不同,例如上涨的是小型股、下跌的是大型股,策略的因子负载就会在不知不觉中发生漂移 再平衡的频率与触发机制也会影响漂移的程度。再平衡频率愈低,两次调整之间累积的权重偏移就愈大,因子负载的漂移也愈明显。触发式再平衡虽然能够在权重偏离达到一定程度时进行修正,但在偏离累积的过程中,策略仍然会暂时偏离其设计的因子曝险 市场风格的转变同样会影响因子负载的测量结果。即使策略的持股完全没有变动,当市场对小型股或价值股的报酬结构发生变化时,策略对这些因子的计算负载也可能随之改变。这种漂移反映的是市场结构的变化,而非策略本身的权重偏移 新增或剔除持股的决策也会改变策略的因子结构。每次调仓时,新纳入的股票可能与被剔除的股票在因子属性上存在系统性差异,导致策略的整体因子负载发生变化 如何应对曝险漂移 定期进行因子中性化再平衡是最直接的修正方式。在每次调仓时,除了根据因子值选股之外,同时对组合的因子负载施加约束,要求组合对特定因子的负载维持在目标范围内。这种做法虽然增加了调仓的复杂度,但能够确保策略的风险结构始终与设计一致 设定偏离容忍区间是一种较为温和的做法。允许因子负载在一定范围内波动,只有在超出容忍区间时才进行干预。这样做既能够控制风险,又不会因为微小的偏离而频繁交易 使用Barra风格因子模型进行更精细的监控。可以使用更精细的风格因子模型,如Barra的因子架构,来追踪策略在数十个细项因子上的曝险,并定期产出风险报告
See More
套利豪仔🗽
@pritipatelcut
17 days ago
从量化的角度,聊聊趋势与泡沫,以及一些最近的思考 先说什么是趋势 从统计的角度,趋势是价格序列中的正自相关性(Autocorrelation)。简单说,今天的涨幅会增加明天继续上涨的概率。这不是什么神秘的东西,只是市场参与者行为的直接结果。但这里有个关键:这种自相关性不是恒定的,它会随着市场状态、波动率、资金规模而动态变化。最常用Momentum Factor 来量化这个现象,通过测试不同时间窗口的收益率相关性,能够找到最强的趋势信号 趋势之所以存在,根本原因是市场定价的非线性。当一个新的信息出现时,市场不会瞬间调整到新的均衡价格,是通过一系列的交易逐步消化。这个过程中,价格会超调,然后部分回调,再超调。每一次超调都会吸引新的参与者进场,形成正反馈。大部分的强趋势往往伴随着波动率的下降,这听起来反直觉,但实际上反映的是市场参与者对方向性的共识在加强。当波动率低而趋势强时,说明大家都在同一边,这时候的持续性最强 但趋势为什么会结束?我认为有三个层次的机制在起作用 第一层是均值回归的力量。任何极端的价格偏离都会招致反向的交易。当价格走到某个极端位置时,风险回报比开始变得不利,理性的交易员会开始反向操作 第二层是参与者的异质性消退。在趋势的早期,不同类型的交易员有不同的进场时间。机构投资者可能先进场,然后是量化基金,最后是散户。当所有参与者都已经上车时,就没有新的买家来推动价格了 第三层,也是最深层的,是资本配置的约束。对冲基金有风险限额,当某个头寸的波动已经占据了整个投资组合风险预算的大部分时,基金经理就必须减仓,无论趋势有多强 这里涉及到一个我经常思考的问题:Drawdown 的性质。在趋势中,Drawdown 通常很小,因为价格单向移动。但这种小 Drawdown 会给交易员一种虚假的安全感。实际上,趋势越强,当它反转时的冲击就越大。我用 Maximum Adverse Excursion 来衡量这个风险,发现在趋势的最后阶段,这个指标会急剧上升 泡沫是趋势的极端形式。在泡沫中,价格的上升不再由基本面驱动,而完全由预期驱动。这是一个自我强化的循环:价格上升导致预期上升,预期上升导致更多资金进场,更多资金进场导致价格进一步上升。从因子的角度看,基本面因子的有效性会大幅下降,而动量因子的有效性会飙升。这意味着传统的价值投资逻辑失效,市场变成了纯粹的动量游戏 我对泡沫的理解经历了一个转变。早年我认为泡沫是应该规避的风险。但后来我意识到,泡沫其实是市场最有效率的时期。为什么?因为在泡沫中,价格信号最清晰。没有基本面的干扰,没有复杂的估值模型,就是纯粹的供需关系在发挥作用。而且,泡沫期间的 Sharpe Ratio 往往最高,很多资产在泡沫期间连续三个月的月收益率都在 5% 以上,波动率却相对温和。这种风险回报比在市场的其他时期是找不到的 关键的认识是:泡沫不是异常,它只是市场的一个正常状态。它会经历几个可识别的阶段。萌芽期,价格缓慢上升,参与者还在观望。加速期,价格开始快速上升,越来越多的资金进场。狂热期,价格垂直上升,所有人都在谈论这个资产。最后是破裂期,价格快速下跌。每个阶段的交易特性都不同。在萌芽和加速期,Win Rate 很高,Payoff Ratio 也不错。到了狂热期,单笔收益可能更大,但尾部风险开始积累 我现在的观点是应该主动拥抱泡沫。但这不是盲目追涨,我们要有系统地参与。有几个监控指标可以参考一下: 第一个是相对估值的极端程度。可以用百分位数来衡量,当某个资产的估值指标进入历史前 5% 时,就是进入狂热期的信号 第二个是参与者构成的变化。跟踪市场中散户资金的占比,当散户资金大幅增加而机构投资者开始减仓时,泡沫的顶部往往不远。第三个是流动性的微妙变化。看起来充足的流动性可能在瞬间蒸发。可以监控买卖价差、成交量的稳定性,以及大单成交的难度 泡沫最危险的地方在于它的非线性破裂。价格可能在几分钟内从顶部跌到底部,留给你零反应时间。我见过流动性在一瞬间消失的情况,那时候止损单根本没用。所以我现在的策略是,在泡沫中期就开始逐步减仓。宁可少赚一些,也要保证能活着走出来 趋势的本质是市场参与者对未来的集体预期。泡沫则是这种预期的极端表现。理解泡沫,就是理解市场如何定价不确定性。与其站在道德高地批评市场的非理性,不如承认它的存在,理解它的运作机制,然后从中获利
See More
套利豪仔🗽
@pritipatelcut
19 days ago
分享一些在量化角度对技术分析的思考 从量化交易员的角度看,技术分析真正处理的问题,是辨认价格中是否存在可重复的条件分布。当某种价格行为出现后,未来报酬的概率分布有没有发生改变?改变幅度是否足以支付交易成本?这个差异,决定了技术分析究竟是一套交易方法,还是一种视觉化叙事 例如「股价突破前高」本身没有太大意义。突破发生时,成交量是否同步增加?突破前的波动率是收缩还是已经过度扩张?买方是持续主动吃单,还是卖方撤掉挂单后造成价格跳升?突破后的回踩是否守住原本的成交密集区?同一个图形,在不同市场环境里,背后可能完全是两种相反的机制 价格是一个压缩后的结果。它把买卖双方的估值差异、交易急迫性、流动性供给与风险偏好,浓缩成一条时间序列。单看收盘价,确实无法还原所有资讯,但价格的排列方式仍然会留下痕迹。趋势代表新资讯可能分阶段被吸收,或者资金流入具有延续性;短期反转则可能反映流动性冲击过度、杠杆平仓或交易者暂时性失衡 这些都只是推论,必须经过测试才有交易价值 图表语言可以拆成可计算的变数。均线之间的距离可以转成标准化偏离,突破可以定义为价格超过过去某段区间的幅度,成交量则可相对于自身历史分布进行调整。若研究短期反转,不能只看跌幅,还需要观察跌幅发生的速度、当时的买卖价差、波动率状态与后续流动性恢复程度。哪一种市场行为,可能真正代表价格暂时偏离了合理交易区间? 好的做法是让每个变数对应一个清楚的交易假说。动能因子假设价格具有延续性;均值回归因子假设短期失衡会修复;成交量因子试图分辨价格移动是否获得参与度支持;波动率因子则协助判断同一个讯号应该承担多少仓位 如果一个因子只能用一句模糊的话解释,通常代表它还没有被真正理解。技术指标的名称不重要,重要的是它测量了什么行为,以及这种行为为何可能持续 接下来要处理的是讯号质量。讯号不能只用「赚钱或不赚钱」判断。若讯号负责替资产排序,可以观察它与未来报酬之间的 IC;若讯号负责产生交易,则要分析不同持有期、不同波动环境与不同流动性条件下的报酬分布。平均报酬很容易掩盖问题,因为策略可能只靠少数几笔极端盈利支撑。胜率、盈亏比、连续亏损次数,以及最大回撤,必须放在同一个框架里理解 一个胜率很高的均值回归策略,可能在极端行情中一次失去数月利润;一个胜率偏低的趋势策略,则可能依靠少数大行情维持正期望值。交易员真正承受的是报酬路径,不是回测报告上的单一绩效数字。夏普比率可以衡量单位波动下的回报效率,但它无法完整描述流动性突然消失时,策略会如何穿越价格 市场状态也会改变技术讯号的含义。趋势明确时,均值回归往往变成逆势接刀;价格横向盘整时,动能讯号容易在区间边缘反复失败。假突破不一定代表指标错误,它可能只说明市场没有足够的新订单承接原有方向。若策略把所有市场阶段视为同一个样本,回测结果很容易产生虚假的稳定感
See More
套利豪仔🗽
@pritipatelcut
20 days ago
在评估量化策略时,多数人只关注最终的报酬数字,却忽略了这个数字背后的组成结构,究竟有多少来自于策略真正的预测能力,又有多少只是市场随机波动的结果。如果无法区分这两者,我们就无法判断一个策略的绩效是否值得信赖。本文想谈谈如何用讯号噪声比来分离策略报酬中的随机性与确定性成分,帮助你更客观地评估策略的真实预测力 什么是讯号噪声比 讯号噪声比的概念源自于通讯工程与讯号处理,用来衡量一个讯号中有用的资讯与背景噪声之间的比例。在量化交易的语境中,这个概念被借用来描述策略报酬的组成结构 更具体地说,我们可以将策略的每一期报酬 r_t 分解为两个部分: r_t = μ_t + ε_t 其中 μ_t 是讯号成分,代表策略在该期的期望报酬,也就是策略根据其预测模型所预期的、可被解释的部分;ε_t 是噪声成分,代表无法被预测的随机波动,也就是市场的随机性对该期报酬的贡献 讯号噪声比就是衡量 μ_t 的变异数与 ε_t 的变异数之间的比例: SNR = Var(μ_t) / Var(ε_t) 这个比率愈高,代表策略的报酬中愈大的比例来自于可预测的讯号,而非随机的噪声。反之,比率愈低,代表策略的绩效愈多是由随机波动所驱动 如何在实务中估计讯号噪声比 在实务中,μ_t 与 ε_t 都是不可直接观测的潜在变数。我们需要透过统计方法来估计它们 最常见的方法是透过策略报酬率的时间序列模型来进行分解。如果我们假设策略的期望报酬在短期内是稳定的(即 μ_t ≈ μ),则可以将报酬率的变异数分解为: Var(r_t) = Var(μ) + Var(ε_t) + 2 × Cov(μ, ε_t) 在简化的情况下,若假设讯号与噪声不相关,则: Var(r_t) = Var(μ) + Var(ε_t) 但这个假设在实务中往往不成立,因为策略的期望报酬可能会随着市场环境而变化,且讯号与噪声之间可能存在交互作用 一个更稳健的估计方法是使用滚动窗口的移动平均作为讯号的代理变数。具体做法是:对于每一期 t,使用过去一段时间的平均报酬率作为 μ_t 的估计值,然后将实际报酬率减去这个移动平均,作为 ε_t 的估计值。接着计算这两个序列的变异数,再计算它们的比例 另一种更严谨的方法是使用状态空间模型。这类模型将策略的报酬率视为由两个部分组成:一个是遵循某种随机过程演变的潜在讯号,另一个是白噪声。透过卡尔曼滤波器等工具,我们可以在每一期估计出讯号与噪声的条件期望值与变异数,进而计算出动态的讯号噪声比 讯号噪声比如何影响策略的信心 讯号噪声比与策略的统计显著性之间存在直接的关系。一个策略的讯号噪声比愈高,我们对其未来表现的信心就愈高 夏普比率可以被视为讯号噪声比的一种粗略近似。夏普比率衡量的是平均超额报酬除以报酬率的标准差,而报酬率的标准差包含了讯号与噪声两者的波动。因此,夏普比率同时受到讯号强度与噪声强度的影响,一个高夏普比率可能来自于高讯号,也可能来自于低噪声 讯号噪声比则更直接地聚焦于预测力本身。一个策略可以有很高的夏普比率,但如果它的讯号噪声比很低,代表它的高夏普比率主要来自于报酬率的低波动性,而非来自于强大的预测能力。这样的策略在市场结构发生变化时,其稳定性可能比讯号噪声比高的策略更容易受到冲击 实务应用:用讯号噪声比设定部位规模 讯号噪声比不仅是诊断工具,也可以直接用于部位规模的设定。基本概念是:讯号噪声比愈高,代表我们对策略的预测愈有信心,因此可以配置较大的部位;讯号噪声比愈低,代表策略的预测中噪声成分较高,因此应该配置较小的部位 实务上的操作建议 计算的稳定性。讯号噪声比的估计对估计方法与参数选择相当敏感。建议使用多种估计方法,比较结果的稳定性,避免因单一方法的缺陷而做出错误的判断 动态监控。讯号噪声比不是静态的。建议定期重新计算策略的讯号噪声比,观察其随时间的变化趋势。如果讯号噪声比持续下降,代表策略的预测力可能正在衰退,需要进一步检视 与其他指标的交叉验证。将讯号噪声比与其他评估指标放在一起观察。一个讯号噪声比高但夏普比率低的策略,可能隐含了未被充分捕捉的风险;一个讯号噪声比低但夏普比率高的策略,则可能存在过度拟合的风险
See More
Last Seen Users on Sotwe
ว่าไง น้องชาย'ย
Seen from
Thailand
Karim Karimo
Seen from
Netherlands
Vina Sky💋
Seen from
United Kingdom
Türbanlı İfşaa
Seen from
Turkey
Izmirzenci
Seen from
Turkey
The Blonde Wife
Seen from
France
Shemale in Public®️🔞 3️⃣0️⃣0️⃣K
Seen from
Indonesia
mrpussyy
Seen from
Malaysia
eymen mert
Seen from
Germany
Trung niên
Seen from
Vietnam
Trends for you
1
#IDontWantToOverreactBUT
Under 10K tweets
2
$EDEL
Under 10K tweets
3
#TIMELESS
Under 10K tweets
4
#CALI
Under 10K tweets
5
Good Monday
Under 10K tweets
6
Victory Monday
Under 10K tweets
7
#MondayMotivation
Under 10K tweets
8
Steak N Shake
Under 10K tweets
9
21st of September
Under 10K tweets
10
$AMD
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.7M followers
2
Barack Obama
@barackobama
119M followers
3
Cristiano Ronaldo
@cristiano
114.3M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107.2M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.4M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
89.9M followers
10
Taylor Swift
@taylorswift13
83.9M followers
11
Lady Gaga
@ladygaga
75.4M followers
12
Virat Kohli
@imvkohli
73.3M followers
13
Kim Kardashian
@kimkardashian
70.9M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.3M followers
16
Bill Gates
@billgates
65.1M followers
17
Selena Gomez
@selenagomez
63M followers
18
The Ellen Show
@theellenshow
62.3M followers
19
CNN
@cnn
61.8M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫