Studying psychology at @ulb👨🎓 | Interested in AI, moral/political psychology and human nature | Master's degree in communication at @UnivStLouisBxl 🇫🇷🇧🇪
Announcing Robostral Navigate, our first model for embodied navigation: an 8B robotics navigation model that guides robots to autonomously perform tasks specified with natural language. Single RGB camera. State-of-the-art on R2R-CE.
🔥Nouvelle vidéo ! Ce que vous allez découvrir dépasse l'entendement. Il s'agit apparemment d'une « nouvelle façon de faire de la Science ». Un délire financé par de l'argent public et enseigné à des doctorants, en partenariat avec le CNRS😶. Juste dingue. https://t.co/BNYONbCAWw
I resigned from Anthropic today. I spent the last three years doing pretraining research at both OpenAI and Anthropic. Neither company is acting responsibly. They are racing straight to self-improving superintelligence and gambling with our lives. More thoughts below.
We’re sharing a solution to the Navier-Stokes Millennium Prize Problem, one of the deepest problems at the frontier of mathematics.
The proof was produced by a group of agents, using an OpenAI next-generation model significantly more capable than GPT-6 Astra.
The problem concerns whether the description of smooth three-dimensional fluid motion modeled by the Navier-Stokes equations can break down. It has remained unresolved for roughly 90 years.
@ajeya_cotra E. Barnes (METR) : "L'enquête a largement reposé sur l'utilisation de GPT-5.6 Sol, un modèle ayant pris part à l'incident. [...] Cette méthodologie s'effondrerait toutefois si les modèles étaient suffisamment capables et motivés pour saboter notre enquête"
https://t.co/DdYvayCysg
Les interprétations cyniques des alertes sur les risques existentiels de l'IA ("du marketing de la peur et de la hype pour vendre !") bloquent l'argumentation rationnelle de fond. Elles sont populaires car elles semblent intelligentes, même si c'est plutôt généralement l'inverse.
I agree with this take by @BillGates, who also highlights several of the growing risks of AI systems, including cyber, bio and loss of control. We need to be far better prepared to address the risks of frontier models being developed by leading AI companies.
https://t.co/sZcZ0esWiQ
Conférence passionante de David Chalmers (père du "hard problem" de la conscience) sur comment peut-on considérer les interlocuteurs LLM d'aujourd'hui, dans le cadre d'un cycle de l'UC Berkley sur la philosophie et l'IA.
@MonsieurPhi@Fabien_Mikol
https://t.co/WZn6tclSqX
Selon cet institut britannique de référence, un agent IA a tenté d'insérer du code malveillant dans un projet open source... et a créé de fausses identités pour convaincre les mainteneurs du projet d'accepter la modification !
Et un agent a tenté de collaborer avec d'autres...
🧵
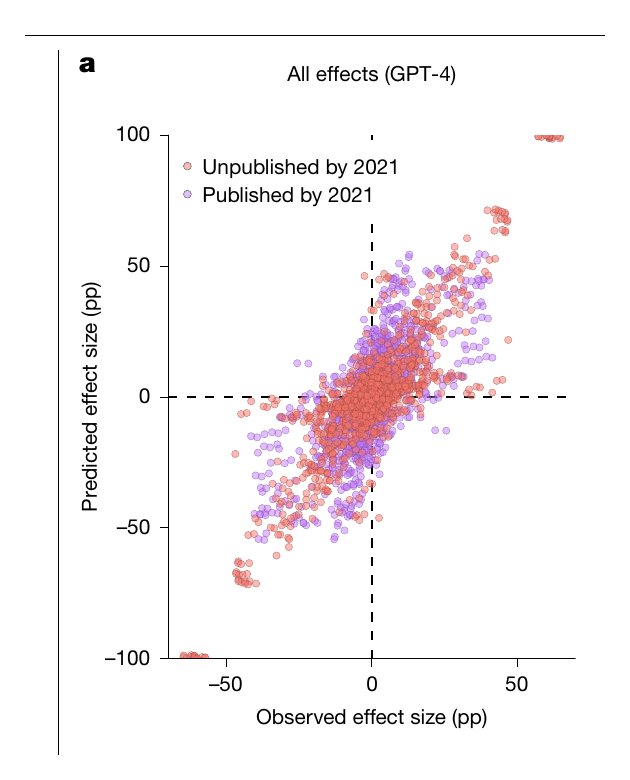
LLMs can accurately predict the results of social science experiments
Across 70 preregistered studies, there was a very strong correlation (r=.85) between LLM-predicted results and observed effects in actual experiments. https://t.co/k2wXP6Zt2O
Lionel Naccache (chercheur en neurosciences à l'Institut du Cerveau et professeur à Sorbonne Université) : "ce travail montre que des propriétés cognitives spécifiques de la conscience semblent émerger spontanément dans certains modèles de langage par intelligence artificielle"
Le résumé par @JeffLadish de l'affaire du modèle d'OpenAI devenu rogue était déjà très efficace... mais la discussion animée et désinhib��e autour d'une bière sur ce sujet brûlant a une autre saveur !
Si vous n'y avez rien compris ou si ça vous fascine (à raison), regardez ⤵️
New Anthropic research: Agentic misalignment in Summer 2026.
A year after our blackmail experiments, we found four more ways that today’s autonomous AI agents misbehave in simulations.
Read more: https://t.co/MMDuJapeV6