@MCampos73@globalelectsim Neste caso, estou me referindo a previsão que eles fizeram antes da eleição de que Flávio venceria com 100% de probabilidade.
@IonaraMonteiro Eu mudaria um pouco a conclusão: pesquisas eleitorais são tanto de Exatas quanto de Humanas! E esse é o legal delas: envolvem verdadeiras equipes multidisciplinares, tanto com psicologos, sociólogos e cientistas políticos, quanto com estatísticos e cientistas de dados.
- Especialistas descrevem situação atual e diz que se nada for feito haverá certas consequências.
- Ações são feitas para evitar tais consequências.
- Consequências não acontecem.
- Pessoas ficam bravas com especialistas porque consequências não aconteceram.
🤷♂️
@gui_levcovitz@topicosenemmm@EleicaoBr2026 Claro, uma amostra maior irá trazer uma precisão maior (assumindo-se um mesmo método). Mas a discussão aqui não é exatamente sobre o tamanho da amostra por si só, mas o impacto do tamanho da população sobre o cálculo da precisão ou sobre o tamanho amostral.
@gui_levcovitz@topicosenemmm@EleicaoBr2026 Sim, esse cálculo é assumindo uma amostra probabilística, mais especificamente uma aleatória simples. Para amostras não-probabilísticas, você precisaria de um modelo para justificar esse tipo de cálculo. +
Mais um pollster que implementa minha sugestão de publicar múltiplas estimativas de intenção de voto com base em diferentes cenários. E o melhor: tudo de forma completamente transparente!
Mais institutos deveriam começar a fazer isso, é a melhor maneira de denotar a incerteza!
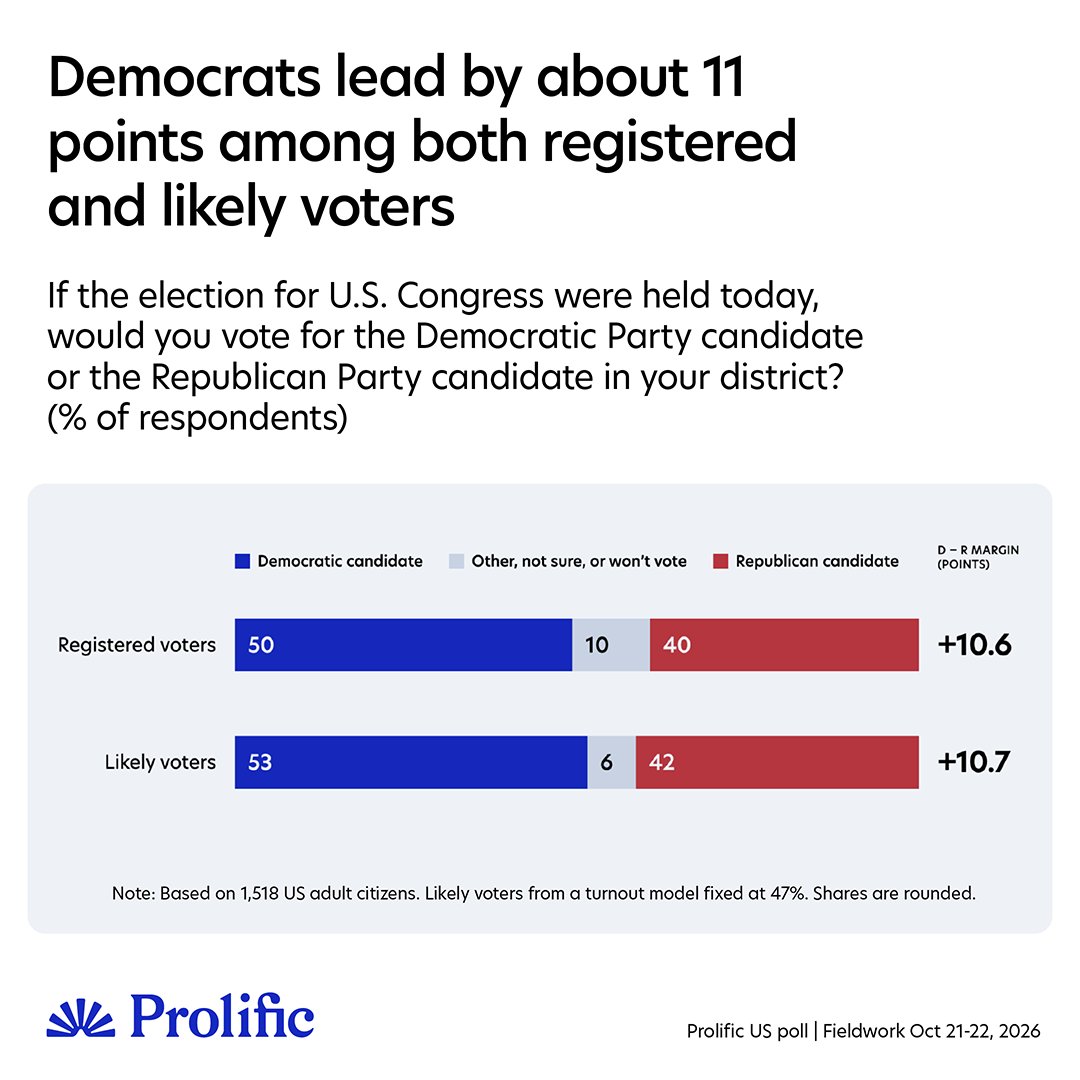
Our midterm poll has Democrats ahead by about 11 points among likely voters (D+10.7), 53% to 42%.
A few defensible choices move that from about 5 to about 15, so we show what each one is worth. ↓
@topicosenemmm@EleicaoBr2026 Para N = 200.000: ME = 1.96*sqrt((1-(2000/200.000))*(0,5*(1-0,5))/(2.000-1)) = 0,00218 ou 2,18%
Para N = 200.000.000: ME = 1.96*sqrt((1-(2000/200.000000))*(0,5*(1-0,5))/(2.000-1)) = 0,00219 ou 2,19%
Ou seja, uma diferença na segunda casa decimal do percentual da margem de erro.
@topicosenemmm@EleicaoBr2026 Okay, vamos fazer o cálculo então? Assumindo uma amostra aleatória simples e um nível de confiança de 95%, a margem de erro para uma proporção de p é dada por ME = 1.96*sqrt((1-(n/N))*(p*(1-p))/(n-1)).
Usando p = 0,5 e n = 2.000:
@viniribeiro13k@topicosenemmm@EleicaoBr2026 Eu mantenho a minha crítica, pois ela é baseada em fundamentos estatísticos, não em achismo. Uma pesquisa pode se aproximar mais do resultado e ser baixa qualidade, e ficar mais distante e ser de alta qualidade. Como já falei inúmeras vezes aqui, esse tipo de critério não é bom.
@topicosenemmm@EleicaoBr2026 Ou seja, uma amostra de 2 mil casos vai trazer praticamente o mesmo nível de precisão (margem de erro), seja para uma população de 200 mil ou 200 milhões de habitantes.
@topicosenemmm@EleicaoBr2026 Esse é um resultado um pouco contra-intuitivo em amostragem, mas para populações grandes o suficientes, acima de algumas dezenas de milhares, o tamanho da população é irrelevante no cálculo amostral ou na margem de erro. +
@orioljbosch@Prolific I really appreciate how transparent you guys were here! It's something quite rare in this industry! I've been collaborating with a pollster in Brazil that have been pushing this on this direction as well. Little by little we will make things change!
I've spent the past few months building our polling methodology at @Prolific .
Our new midterms poll finds D+11
🟦Democratic 53%
🟥Republican 42%
But different choices put the lead between roughly D+5 & D+15. The article explains all of our choices, and what could go wrong.