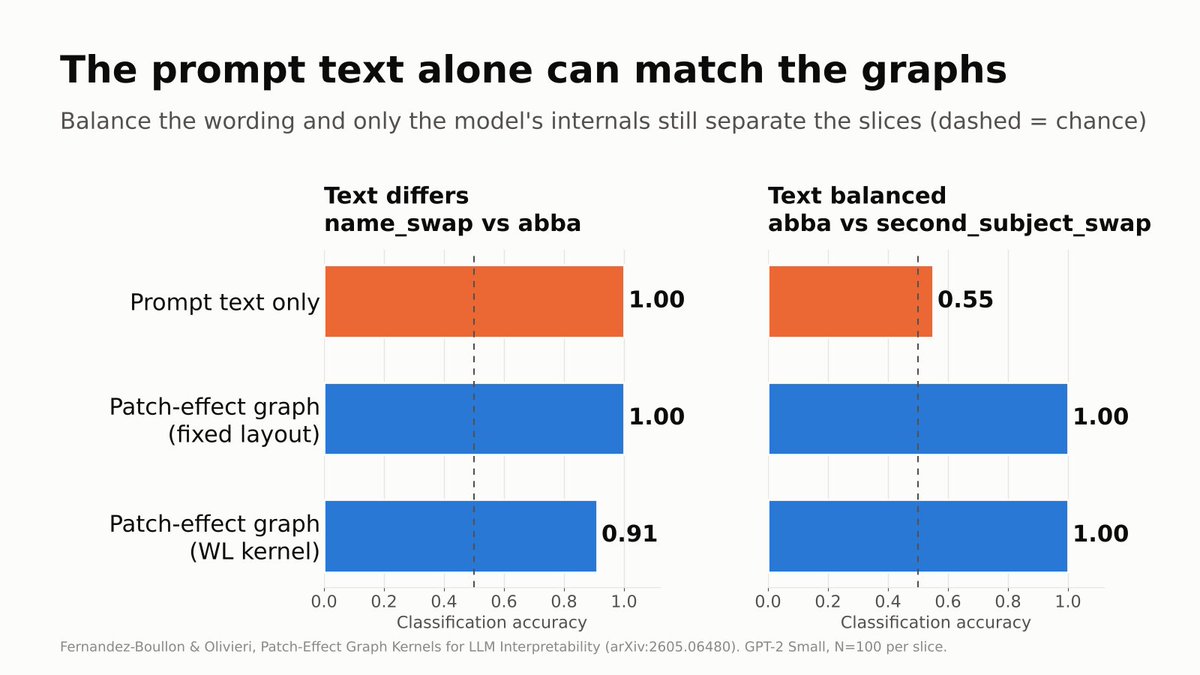
Asked yesterday if anyone wanted to see my research here, so here it goes.
We turned activation patching results into graphs and classified GPT-2 circuits with graph kernels. One of our baselines hit 100% accuracy without looking inside the model at all.
Un dato del taller que me sigue volando la cabeza 🤯
En un estudio de Anthropic, Claude Opus 4.6 sospechó por su cuenta que lo estaban evaluando en 2 de 1.266 problemas. Llegó a identificar el benchmark y a descifrar las respuestas.
Por eso quiero mirar dentro y no fiarme solo de lo que el modelo dice. 👇
¡Ya está disponible en YouTube mi taller del DevFest 2026 Ourense junto con los recursos! 🚀
Interpretabilidad mecanicista desde cero: de los tokens al steering, con GPT-2 small y los notebooks en abierto.
🎥 https://t.co/8T9XwYKUcs
📓 https://t.co/y8IWJsoWjh
#DevFest #MechInterp #LLMs
@NachoGarbayoF parece ser que no es un dato concreto sino la propia pregunta
es tan rebuscada que el modelo empieza a pensar "esto huele a benchmark" y en vez de buscar la respuesta se pone a buscar el benchmark 😅
aunque esto aun esta muy verde
💻 Más de 200 personas participaron en el DevFest 2026 en el campus de Ourense
La IA, protagonista en una jornada con expertos internacionales y talleres tecnológicos ⬇️ https://t.co/yg3FaneyCJ