Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
anonym(論文1000本ノックの人)
@shriver_light
#1年間1日1本論文
#111論文等共有
で機械学習の論文メモ1000本達成(Apr 26, 2020-May 4, 2023). 💡キーワード検索は 「from:shriver_light 検索ワード」 で💡 (Nov 7, 2025- LLM-assisted but not fully automated)
On the Shoulders of Giants
Joined January 2019
224
Following
2.1K
Followers
4.1K
Posts
anonym(論文1000本ノックの人)
@shriver_light
3 months ago
Explicit Regularization in Overparametrized Models via Noise Injection
anonym(論文1000本ノックの人)
@shriver_light
3 months ago
#111論文等共有
1605 https://t.co/kJA19dwf3K [AISTATS’23] 毎ステップ重みへノイズを乗せることはL^1-norm、group L^1-norm、nuclear norm のような正則化と等価であることを示した。 しかし 幅の大きいニューラルネットワークに全パラメータ同時のノイズを入れると ノイズ由来の分散が爆発する。これを避けるためち各ステップで一つの層だけをランダムに摂動する layer-wise perturbation を提案し効果を確認。
anonym(論文1000本ノックの人)
@shriver_light
3 months ago
#111論文等共有
1604 https://t.co/WzE1jQw0PH [arXiv’25] 二つの相互作用する確率系のあいだの情報流は、excess information flow と housekeeping information flow に幾何学的に分解でき、その二つは別々の熱力学的役割を持つことを示した。ここで、excess は分布や相関を時間的に変える成分、housekeeping は非平衡定常状態を保つために流れ続ける成分。この分解を連続状態の過減衰 Langevin 系で定式化し、特に excess 成分が 2-Wasserstein 距離を用いた最適輸送と自然に対応することを示した。
See More
anonym(論文1000本ノックの人)
@shriver_light
3 months ago
Continuous-Time Attention: PDE-Guided Mechanisms for Long-Sequence Transformers
Who to follow
akira
@AkiraTOSEI
Ph.D candidate, the university if Tokyo ← Tech Lead for the Computer Vision team at ExaWizards Inc. ← Manufacturing Engineer
Daisuke Okanohara / 岡野原 大輔
@hillbig
Co-founder and CEO of Preferred Networks (PFN). CEO of Matlantis. Development Strategy Office, Noetra.
Kyosuke Nishida
@kyoun
NTT人間情報研究所 上席特別研究員.大規模言語モデル tsuzumi リード.人工知能全般,特に,自然言語処理,Vision-and-Languageに興味があります.
anonym(論文1000本ノックの人)
@shriver_light
3 months ago
#111論文等共有
1603 https://t.co/GZTtHsCnNL [EMNLP’25] Continuous-Time Attention という attention mechanism を提案。通常の Transformer では、query と key から attention matrix を一度計算し、その固定された重みで value を集約する。これに対しattention matrix を diffusion equation, wave equation, reaction-diffusion equation などの PDE に従って擬似時間方向に更新。 直感的には、attention を「各 token 間の情報の流れ」と見なし、その流れを物理現象のように少しずつ拡散・伝播させる。これにより、局所的なノイズを平滑化し、遠く離れた token 間の依存関係を強め、勾配の安定性を改善することを狙う。
See More
anonym(論文1000本ノックの人)
@shriver_light
4 months ago
Accurate Evaluation of Quickest Changepoint Detectors via Non-parametric Survival Analysis
anonym(論文1000本ノックの人)
@shriver_light
4 months ago
#111論文等共有
1602 https://t.co/we45olI6EQ [ICML’26] 実データでの変化点検知は、不規則な系列長のせいでまともな評価が難しい。そこで、変化点検知と患者の死の予測とのアナロジー(医療統計)を元に変化点検知を定式化し直し、ARLとADDについて漸近的にunbiasedな推定器を提案。非漸近領域でもバイアスと、ついでに分散も大きく減らす。
anonym(論文1000本ノックの人)
@shriver_light
5 months ago
A Minimum Variance Path Principle for Accurate and Stable Score-Based Density Ratio Estimation
anonym(論文1000本ノックの人)
@shriver_light
5 months ago
#111論文等共有
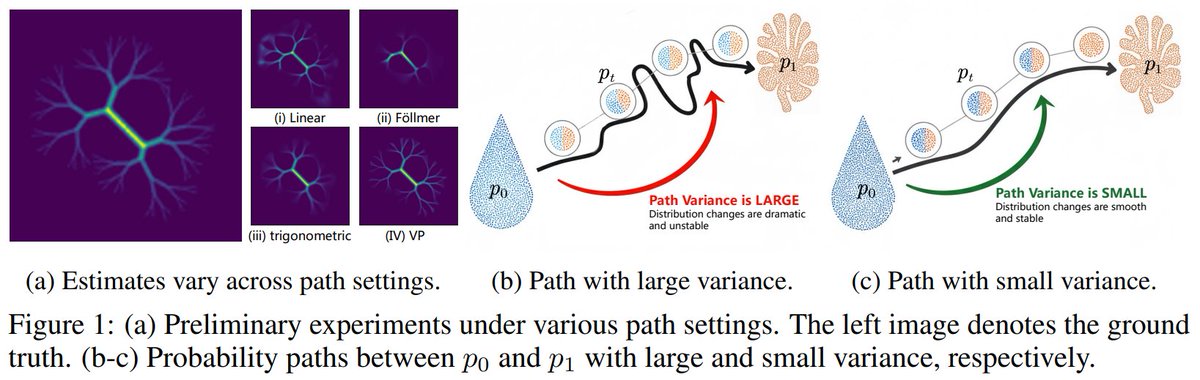
1601 https://t.co/QEdiNMmzH2 [ICLR'26] 密度比推定をする時、二分布がはっきり分かれていると学習が難しい。二分布間をinterpolateして学習すると安定する。本論文では、学習安定性はinterpolationのpath依存性があると指摘。学習の分散に差が出る。分散を最小化する学習を提案。効果を確認。
shriver_light
retweeted
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
#111論文等共有
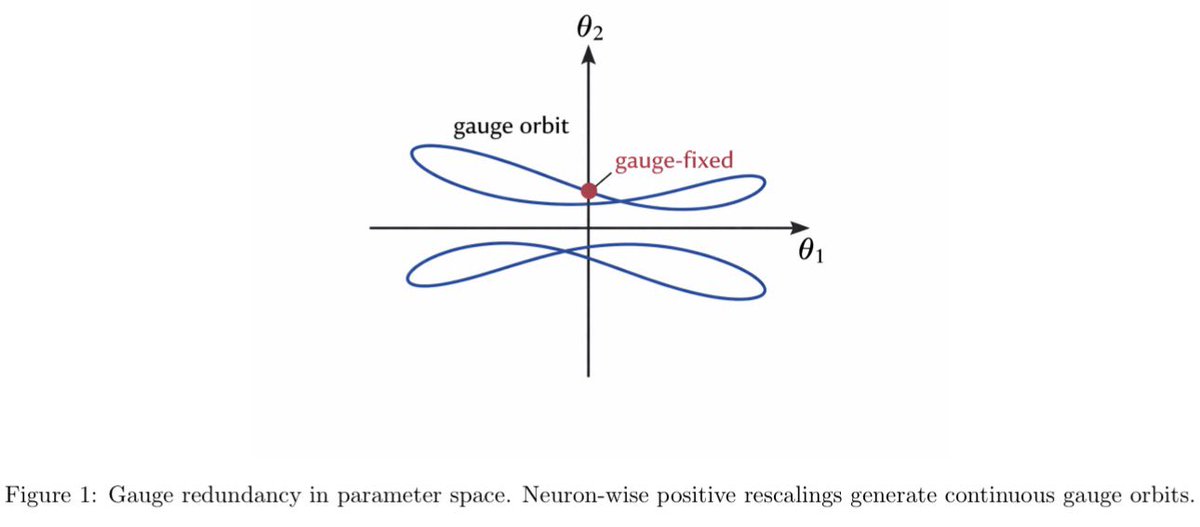
1600 https://t.co/Jy43ASDllq [arXiv’26] ReLU のようにpositive homogeneityを持つニューラルネットでは、重みのスケールを層間で付け替えても出力関数が全く変わらないという冗長性があり、それが学習を不安定にし得るので、その冗長な自由度だけを抑えるsoft gauge fixing を提案。 実験では、制約が程よい範囲にあると性能改善すること、学習が安定化することを確認。ちなみにランダムにゲージ変換しても出力差は $10^{-17}$ 程度(倍精度丸め誤差レベル)。逆にいうとそれくらい大きい。 まとめると、ReLU ネットには同じ計算をするのに重みのスケールだけを好きに付け替えられる自由度があり、学習中にそこへ無意味に漂うと不安定になるので、その自由度だけを罰して代表元を選ばせると、性能を大きく変えずに学習の安定性が上がる。
See More
shriver_light
retweeted
anonym(論文1000本ノックの人)
@shriver_light
over 4 years ago
Flat ⇒ Input smoothness ⇒ Generalize の二段階を両方証明した。
shriver_light
retweeted
anonym(論文1000本ノックの人)
@shriver_light
over 4 years ago
#111論文等共有
(179/365) https://t.co/KhFEVhj5UK [NeurIPS'21Spotlight] 第1層の重みと入力との関係に着目し、flat minimaが入力に対する勾配を正則化する(!)ことを証明。flat minimaが汎化する理由を入力の勾配と絡めて示した素晴らしい論文。 1/3
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
Scale redundancy and soft gauge fixing in positively homogeneous neural networks
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
#111論文等共有
1600 https://t.co/Jy43ASDllq [arXiv’26] ReLU のようにpositive homogeneityを持つニューラルネットでは、重みのスケールを層間で付け替えても出力関数が全く変わらないという冗長性があり、それが学習を不安定にし得るので、その冗長な自由度だけを抑えるsoft gauge fixing を提案。 実験では、制約が程よい範囲にあると性能改善すること、学習が安定化することを確認。ちなみにランダムにゲージ変換しても出力差は $10^{-17}$ 程度(倍精度丸め誤差レベル)。逆にいうとそれくらい大きい。 まとめると、ReLU ネットには同じ計算をするのに重みのスケールだけを好きに付け替えられる自由度があり、学習中にそこへ無意味に漂うと不安定になるので、その自由度だけを罰して代表元を選ばせると、性能を大きく変えずに学習の安定性が上がる。
See More
shriver_light
retweeted
anonym(論文1000本ノックの人)
@shriver_light
about 1 year ago
#111論文等共有
1542 https://t.co/W5QtjZMKfO [arXiv’25] VLMを新しいドメインに汎化させる手法のサーベイ。Promptベース(prompt tuningなど)、パラメタベース(robust fine-tuningや蒸留など)、特徴量ベース(adaptorなど)に分類。データセットと評価結果もまとめてある。
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
Optimizer choice matters for the emergence of Neural Collapse
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
#111論文等共有
1599 https://t.co/uSGwTw7N5O [ICLR’26] Neural collapse (NC) の必要条件を新たに導入し、 AdamW のような decoupled weight decay in adaptive optimizers では NC が起きないことを証明した。 NC についての初の optimizer 依存性解析。
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
$α$-divergence Improves the Entropy Production Estimation via Machine Learning
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
#111論文等共有
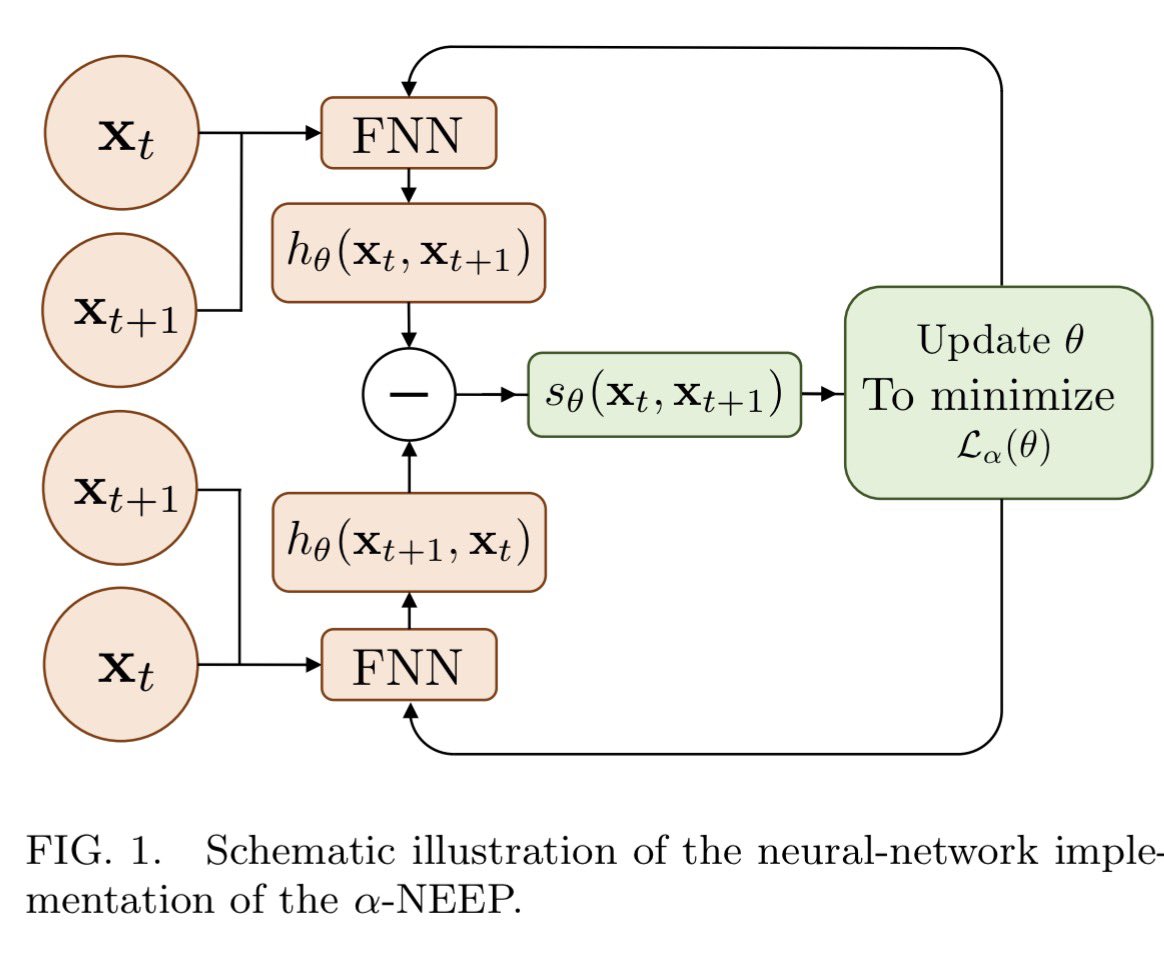
1598 https://t.co/CBsP7E4W6g [Phys. Rev. E’24] 離散時間Markov過程の entropy production の推定のための標準的な損失関数 NEEP は密度比推定としてKLD の変分表現から作った損失で学習するが、逆過程が極端にレアだとサンプリング誤差が指数的に増幅する。そこでα-divによる損失を提案した論文。 損失そのものは一般には EP とは一致しないので学習した EP をデータ上で平均することで別途計算する。
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
Equivariant Polynomial Functional Networks
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
#111論文等共有
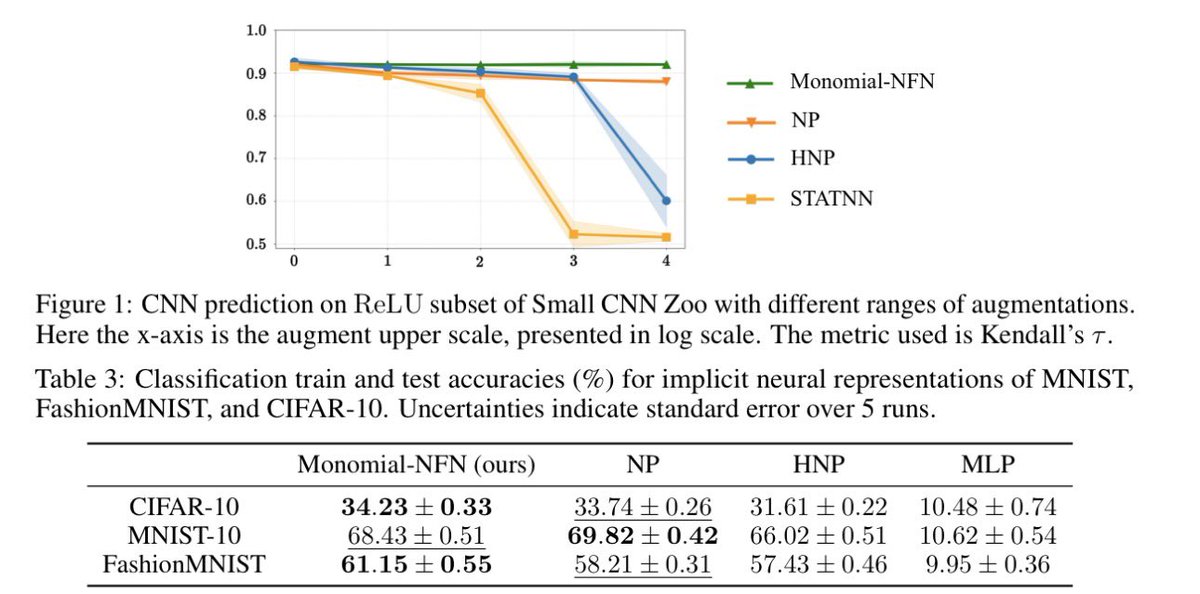
1596 https://t.co/HQFdodeuaA [NeurIPS’24] DNNの重み自体を入力とする neural functional networks (NFN) において、従来のpermutationに加えて、 scaling, sign flip 対称性も考慮できるようにした論文。これによりReLU や sin, tanh も扱えるようになった。 並べ替え +(各ユニットの)スケール変更/符号反転をひとまとめに扱うために monomial matrix(各行・各列に非ゼロが1つだけある行列。値は 1 に限らず任意) を利用。 そして その変換をしても出力が同じ(invariant)ないしは入力の変換に合わせて出力も整合的に変わる(equivariant)」ように、NFNの layers を設計。 これにより、 •学習が安定:同じ意味の重みを同じものとして扱えるので、重みの表現ゆれに強い。 •パラメータ効率が良い:対称性に合わせてparameter sharingするので、独立パラメータ数が減りやすい。 •理論的:全結合・畳み込みネットの重み空間で不変性を保つ変換群は monomial matrix group の部分群として扱えることを示した。
See More
anonym(論文1000本ノックの人)
@shriver_light
7 months ago
#111論文等共有
1597 https://t.co/92rndX6gc9 [ICML’25] Monomial Matrix Group Equivariant Neural Functional Networks から更に表現能力を上げて性能向上。この論文では線形ではなく多項式(重み同士の掛算)を使った nonlinear equivariant layer を導入します。これにより層をまたいだ重みの組合せが入り表現力アップ。
Last Seen Users on Sotwe
HollyVip
Seen from
Turkey
GX Mk-II
Seen from
France
Brandon
Seen from
Netherlands
Cd ayten
Seen from
Netherlands
%%% Taipei
Seen from
Turkey
lufizufira
Seen from
Indonesia
video paylaşım
Seen from
Turkey
sara sar
Seen from
Poland
trai thẳng quay lén
Seen from
Vietnam
GREYSSS
Seen from
United States
Trends for you
1
Rams
Under 10K tweets
2
Good Monday
Under 10K tweets
3
#LingOrmDiorAirportLook
Under 10K tweets
4
#thisisjimin
Under 10K tweets
5
RIP PAC
Under 10K tweets
6
Madonna
Under 10K tweets
7
#Lanterns
Under 10K tweets
8
Angela
Under 10K tweets
9
Full Episodes
Under 10K tweets
10
#VMAs
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.7M followers
2
Barack Obama
@barackobama
119M followers
3
Cristiano Ronaldo
@cristiano
114.4M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107.2M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.4M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
83.9M followers
11
Lady Gaga
@ladygaga
75.4M followers
12
Virat Kohli
@imvkohli
73.4M followers
13
Kim Kardashian
@kimkardashian
70.9M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.4M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.3M followers
19
CNN
@cnn
61.8M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫