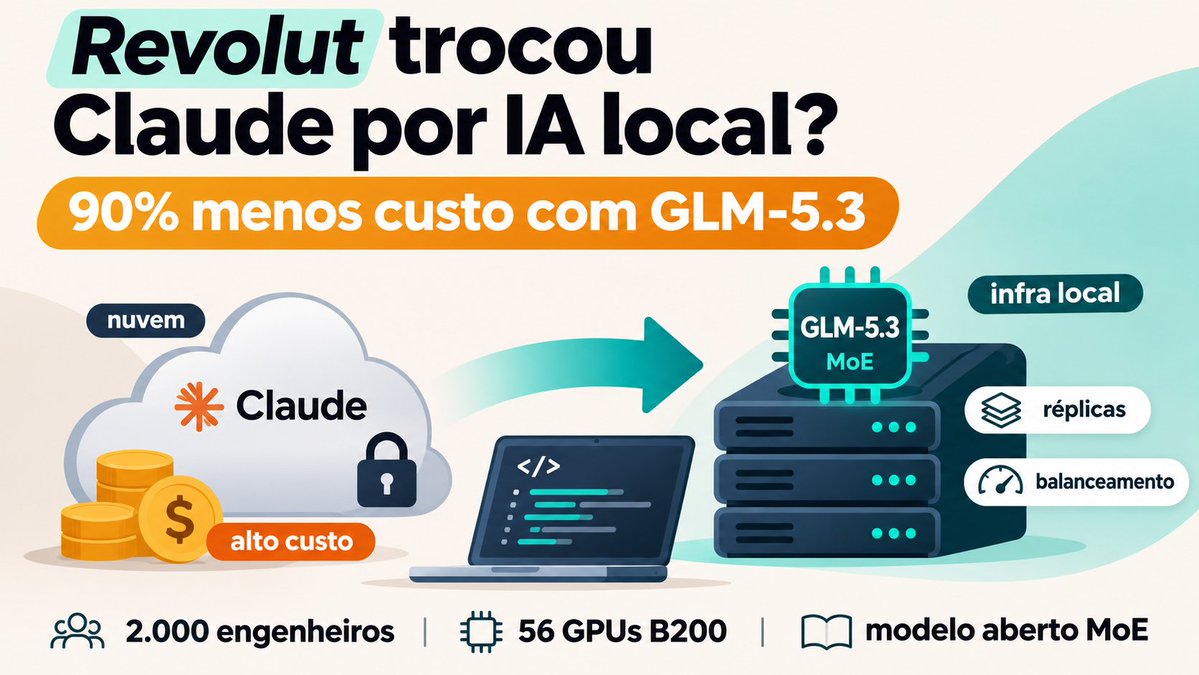
Semana passada saiu uma notícia BEM relevante pra empresas grandes. O @Revolut, banco digital do Reino Unido, disse que trocou o Claude por um modelo chinês rodando localmente e, com isso, está economizando 90% dos custos.
O David Abitbol, líder de infra da empresa, disse que tinha engenheiro gastando entre 1.000 e 10.000 dólares por mês em ferramentas de código com IA, sem ROI que justificasse. E que essa troca estaria valendo muito a pena.
Minha primeira reação foi: duvido. Aí, fui atrás de ver as afirmações deles: que estavam rodando pra 2000 engenheiros, com uma latência de 200 tokens/segundo e rodando em 8 máquinas NVIDIA DGX B200 (total de 56 GPUs B200). Minha segunda reação: DUVIDO que rode nessa latência com esse cluster.
Mas depois de dar uma estudada mais a fundo, deu pra ver que realmente é possível, com alguns asteriscos.
O modelo que eles estão rodando localmente é o GLM-5.3, que tem 753B parâmetros (isso é muito) e é realmente excelente pra código. A grande sacada é que, como quase todos os modelos top de hoje em dia, ele é um MoE (Mixture-of-Experts). Isso significa que apesar de a rede neural inteira (todos os 753B parâmetros) terem que estar carregados na memória, pra gerar respostas, ele ativa apenas 40B. Acredito ainda que estejam usando uma versão quantizada do modelo, o que também otimiza a velocidade e perde quase nada de qualidade (tenho um artigo sobre quantização no meu blog, que deixo no primeiro comentário abaixo).
Outra sacada deles foi de não subir apenas um GLM-5.3, mas várias réplicas dele, e fazer um balanceamento de carga bem feito. Assim, um engenheiro não tem que ficar esperando que aquele modelo único termine a resposta de outro.
E o que fecha a história é que eles não trocaram TUDO por essa solução interna. Disseram que, pra problemas complexos, os engenheiros ainda têm acesso ao Claude Code e ao Codex, mas que o GLM-5.3 vira o faz-tudo pras tarefas de programação do dia a dia. E realmente, qualquer modelo desse calibre (GLM, Kimi, DeepSeek, Muse) já é bom o bastante pra fazer CRUD e essas coisas que é 90% do que um dev faz semanalmente.
Como resultados, eles reportaram uma melhora de 60% no tempo de codificação e 70% no lead time (vale o adendo honesto de que esses números são autodeclarados, e parte do ganho pode vir simplesmente de tirar o limite de uso dos modelos privados, não do modelo em si).
Vale um grande asterisco final aqui: cada uma das máquinas DGX B200 que eles usaram (e eles têm 8) custa entre 600 e 900 mil dólares. Ou seja, empresa pequena ou média não vai conseguir replicar isso em escala ou latência. Essa conta só fecha pra quem já tem volume (e caixa) pra isso.
De qualquer forma, é um sinal importante que modelos abertos como o GLM-5.3 já chegaram num nível competitivo o bastante pra justificar esse tipo de aposta em produção, numa fintech gigante processando código sensível todo dia.
- Link da matéria: https://t.co/PeecTjimFy
- Link do artigo sobre quantização: https://t.co/Nia7eEOeeO
The US government spent billions building a chip embargo and cyber fortress around Nvidia.
Her name was Alice Huang (Huang Le).
She walked into a Taipei whiskey bar, got close to CEO Jensen Huang, and routed $4.8 billion of Nvidia AI hardware through a Singapore firm in 20 months.
This is the story of Alice Huang and how a 5,000-year-old human exploit bypassed a $3.5 trillion tech giant that's guarded like a military base.
2023 - June 2024
- Chinese mobile gaming firm 7Road spins out a new data center startup in Singapore called Megaspeed
- Alice Huang, a former TV reporter in China with no family relation to Jensen Huang, steps in as managing director
- during the June 2024 Computex conference in Taipei, she bets tech executives at a whiskey bar that she can get the Nvidia CEO to show up
- shortly after 12:00 AM midnight, 63-year-old Jensen Huang walks in wearing his black leather jacket and sits right beside her for the rest of the night
June 2024 - February 2026
- while Washington blocks H100 and B200 chip exports and bans ASML EUV lithography machines from China, Megaspeed becomes a massive buyer
- trade records tracked by The New York Times show Megaspeed and its Malaysian sister firm buy $4.8 billion worth of Nvidia AI hardware
- at least $2 billion in advanced chips flow through Malaysia into Indonesian data centers where Chinese tech giant Alibaba rents the compute capacity
May 2025
- Jensen Huang and Alice Huang are photographed leaving the San Liu Shi Fu restaurant in Taipei on May 23, with Alice walking right behind him in a pink dress holding a glass of red wine
- after monitoring Alice Huang for over 1 year, US intelligence agencies circulate a classified assessment concluding she was recruited by China's Ministry of State Security (MSS)
- when intelligence officers unmask the American citizen on her intercepted phone calls, the name comes back as Jensen Huang
October 2026 - Today
- Nvidia initially dismisses federal probes in the US, Singapore, and Taiwan by calling the meetings "completely normal and not unusual"
- on November 8, 2026, after The New York Times and Financial Times expose the romantic relationship, Jensen Huang emails 30,000+ employees admitting he was unfaithful to his wife of 43 years: "I was unfaithful to my wife. My actions hurt her and our children. There is no excuse for what I did. I am deeply sorry."
To this day, Nvidia's Board of Directors is investigating whether its own CEO was compromised by a foreign spy operation, while Kalshi prices a 20% chance he steps down before 2029.
You can spend billions locking down silicon wafers, export controls, and enterprise firewalls.
Across 5,000 years of espionage, when encryption becomes unbreakable, the biggest zero-day vulnerability on the planet is still human biology.
Muitos economistas advogam que o juro alto no Brasil tem motivos estruturais, como distorções no mercado e afins. Isso não procede! O juro alto do Brasil é conjuntural, fruto de falta de credibilidade fiscal e monetária. Basta notar que de 2016-2019, com uma politica fiscal restritiva e uma política monetária crível, nossa inflação chegou em 3% e nossa Selic em 6%. FIM.
Hot take: eu não gosto de deixar Grok bot, dots, claude remote etc aberto, de jeito nenhum. É só um monte de jeitos diferentes de ter acesso remoto à minha máquina com permissão pra rodar programas.
Vejo muita gente fazendo post idiota de "olha, eu falo com meu PC pelo celular pra fazer coisas por mim".
Não conecto no meu whatsapp, não deixo nenhum tipo de bot com acesso a terceiros aberto.
Nunca. Você só está aumentando a superfície de ataque. Quando for invadido, não vai mais nem saber de onde veio. Basta um desses serviços ter vulnerabilidade e você já era junto.
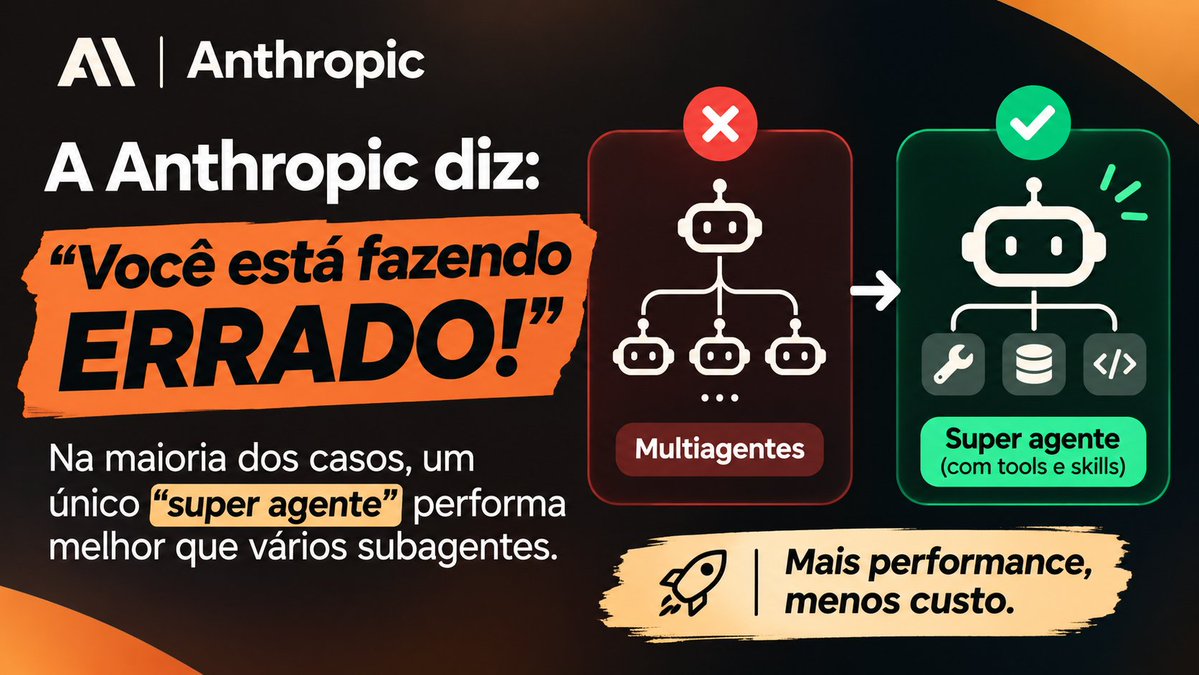
A @AnthropicAI acabou de soltar um artigo que eu acho OBRIGATÓRIO pra quem trabalha como dev ou criando agentes de IA. Basicamente, são eles dizendo: "Você está fazendo ERRADO!"
O time de Applied AI deles rodou comparações em vários deployments corporativos, comparando pipelines, e chegaram à conclusão que, na maioria dos casos, um "super agente" único com tools e skills costuma performar melhor do que uma arquitetura cheia de subagentes orquestrados, e potencialmente pode sair MUITO mais barato e rápido por tarefa.
Fazendo uma analogia, ter muitos agentes seria algo como ter um time em especialistas humanos que só falam entre si por relatório. Assim, cada um deles perde um pouco da ideia original do projeto, tipo um briefing que passa por três gerentes antes de chegar em quem executa. No fim, ninguém tem a visão completa, e o resultado sai mega genérico. É basicamente isso que eles disseram que acontece dentro dos agentes de IA.
O artigo também fala de um padrão bem comum (e que eu já vi de perto em um projeto de automação), onde cada time cria o próprio subagente pro seu pedacinho do problema. Até recentemente, era visto como "proto-boa-prática" ter um subagente só pra tratar reembolso, outro pra troca de produto, outro pra dúvida de garantia.
A alternativa que a Anthropic recomenda se chama "progressive disclosure" (o mesmo conceito que eu já expliquei no meu post sobre Skills). A ideia é que o agente só enxerga descrições curtas das tools e skills disponíveis, e só carrega o conteúdo completo quando realmente precisa usar aquilo. Com isso, dá pra manter um agente único MUITO mais enxuto, sem precisar splitar tudo em subagentes especialistas. A própria Anthropic disse que usou essa técnica pra reduzir o system prompt do Claude Code em mais de 80% (pros modelos mais avançados).
Eu acho muito boa essa lógica de manter o contexto inteiro dentro de uma única janela, pro agente conectar o que aconteceu em cada etapa anterior, em vez de só receber resumos parciais de subagentes diferentes.
E claro, isso só é possível devido às enormes melhorias em termos de qualidade e da janela de contexto dos modelos que temos disponíveis hoje em dia.
A Anthropic também deixa claro que uma pipeline com subagentes ainda pode ser melhor quando seu benchmark disser que um agente único sofreu uma degradação de performance por excesso de contexto, ou quando várias tarefas precisam ser tocadas em paralelo, ou quando houver instruções conflitantes no prompt.
A gente passou um bom tempo martelando a ideia de "multiagentes pra tudo", e agora a própria Anthropic tá dizendo publicamente um clássico da Engenharia de Software clássica, que diz "comece simples, e só adicione complexidade quando houver dados mostrando que ela é necessária".
No final das contas, é como a ciência, que pode mudar a cada nova melhoria ou descoberta. Estamos usando essa tecnologia e construindo-a ao mesmo tempo, trocando o pneu com o carro andando.
Segue o link do artigo: https://t.co/pRy2jU8Lqw
🏴🏆 Harry Kane is the 𝗖𝗟𝗔𝗦𝗦𝗜𝗖 example of never giving up on your dream to become to the best choosing perseverance every time.
▪️ At 9-years-old, Arsenal released him from their youth setup because he was not very athletic.
▪️ At 11-years-old, Watford picked Kane up on a short trial. During the trial, he scored a hat-trick against Tottenham who immediately offered him a spot in their own academy.
▪️ In his youth development phase he was sent out on four different loans in the English pyramid: Leyton Orient, Millwall, Norwich City and Leicester City.
▪️ When Mauricio Pochettino arrived at Spurs he wanted to sign Danny Welbeck. They couldn't make the deal happen meaning Kane was promoted to third choice striker behind Adebayor and Soldado.
▪️ In 2013, Kane made 10 appearances in his breakthrough season scoring 3 goals.
▪️ He went on to become Tottenham Hotspur's all-time top scorer, but left the club without winning a trophy. Some considered it a failure.
▪️ In 2019, he lost the Champions League final.
▪️ In 2021 and 2024, he lost two EUROs finals with England.
▪️ In 2023, he signed for Bayern Munich to win trophies, but ended up losing the German Super Cup on his debut and finishing 2nd in the Bundesliga in his first season.
▪️ In 2025, however, he finally ended his trophy drought, winning his first major title - the Bundesliga - at 31 years old.
▪️ In 2026, he scored 73 goals for club and country, winning the Ballon d'Or, football's ultimate individual prize.
PSA
> If you don't update everything you are screwed
> If you update everything you will be screwed by the new and more advanced hidden vulnerabilities.
Good luck
Have fun
Don't die
Em 2006/07, o Milan se tornou campeão da Champions League e o Bournemouth estava na terceira divisão da Inglaterra, terminando na 19º posição (de 24 equipes).
Em 2026/27, se enfrentaram na Europa League e esse foi resultado:
Vinte temporadas de diferença! Futebol…
Essa nova tecnologia chegou com uma promessa.
Os seus criadores garantiam que ela tornaria as pessoas mais inteligentes. Seria um remédio contra a ignorância.
Mas quem cria uma tecnologia raramente é quem melhor julga o bem e o mal que ela pode causar. O amor pela própria criação pode fazer seus inventores enxergarem nela justamente o contrário do que ela faz.
Na verdade, usar essa nova tecnologia vai trazer esquecimento, porque as pessoas vão deixar de exercitar a memória. Pela facilidade de acesso, elas vão sempre confiar em uma coisa externa, feita por outros, em vez de refletir e buscar o conhecimento dentro de si mesmas.
O que essa tecnologia oferece não é memória. É lembrete. Ela não entrega sabedoria, só a aparência.
As pessoas vão parecer saber de tudo quando, na maior parte, não vão realmente entender quase nada.
Eu sei, dá pra jurar que aquelas palavras falam como quem pensa. Mas se você perguntar qualquer coisa a elas, querendo de fato entender, elas vão te devolver sempre a mesma coisa.
---
E não, nada disso foi escrito sobre inteligência artificial. Encontrei durante as minhas pesquisas, em um diálogo de Platão, chamado Fedro, do século IV antes de Cristo.
E a "nova tecnologia" à qual ele se referia? A escrita.