"Beni bir gün unutacaksan, bir gün bırakıp gideceksen, boşuna yorma derdi; boş yere mağaramdan çıkarma beni. Alışkanlıklarımı özellikle yalnızlığa alışkanlığımı kaybettirme boşuna. Tedirgin etme beni. Bu sefer geride bir şey bırakmadım."
| Oğuz Atay, Tutunamayanlar(s.473)
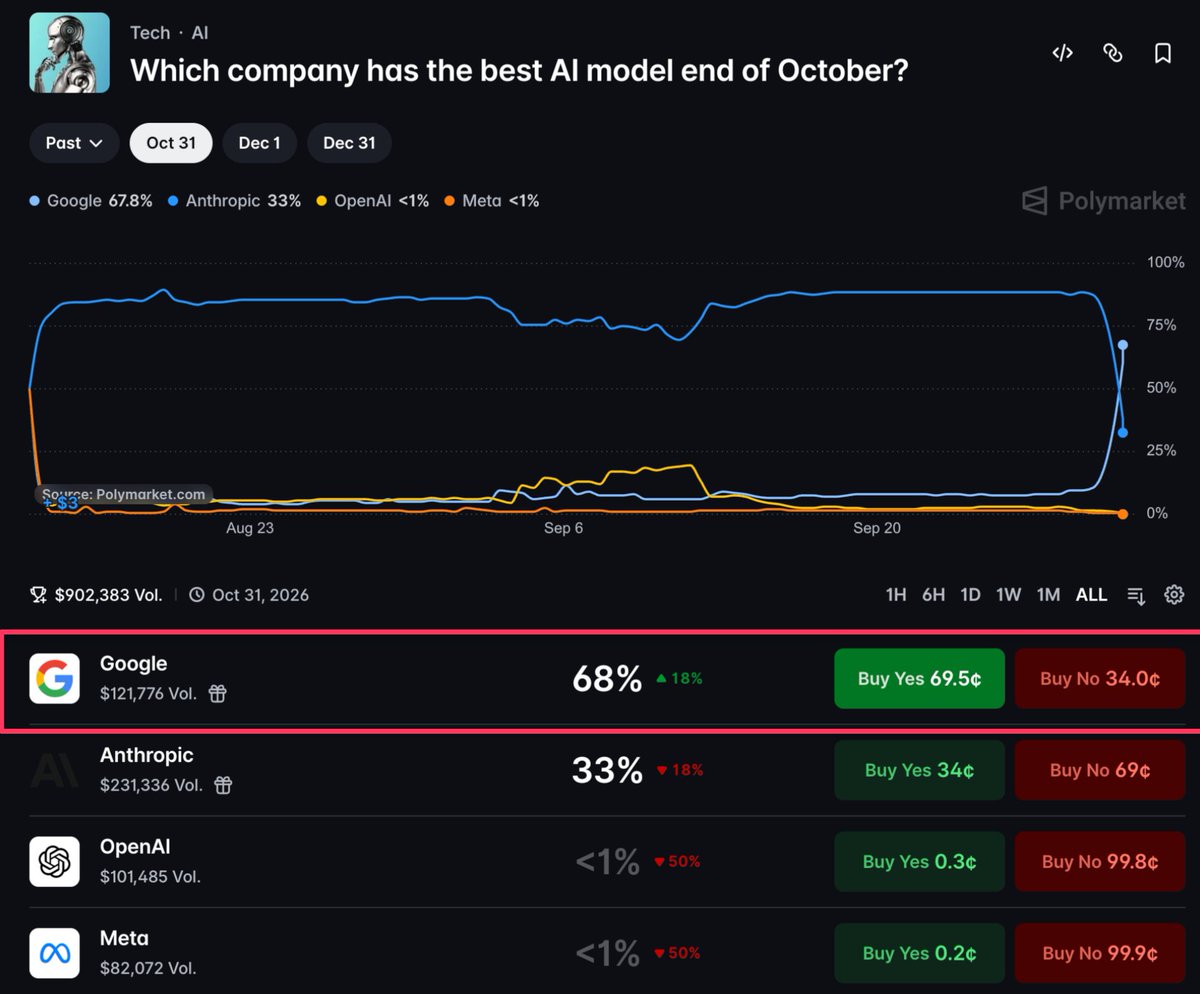
Gemini 4 Argon'dan sonra Polymarket'te Google öne geçti.
"Ekim sonunda en iyi AI modeli kimin?" marketinde Anthropic Ağustos ortasından beri açık ara öndeydi. Şimdi Google %68, Anthropic %33, OpenAI %1'in altında.
Claude-OpenAI karşılaştırması Claude-Gemini'ye dönebilir.
1M token ile neler yapılabileceğini merak ediyosanız şöyle kısaca özetleyeyim:
- Tek promptta 80-100 bin satır kod
- 7-8 roman uzunluğunda metin
- Tek HTML dosyasında komple bir oyun
- Orta boy bir projeyi bölmeden başka dile çevirmek
Claude'da bu sınır 128K.
Today we’re introducing Gemini 4 Argon.
It delivers frontier performance in complex workflows across real-world software engineering, knowledge work, and cybersecurity defense with an industry-leading 1M token output limit.
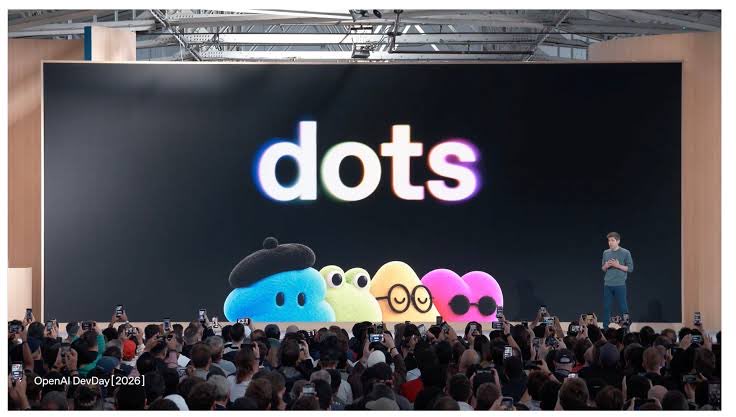
AHAHAHAHAHAHAHAHAHAHAHA NO WAY.
> OpenAI just announced Dots.
> SpaceXAI bought https://t.co/WdFqpl07IQ
it redirects straight to the Grok Bot download page. based lmao.
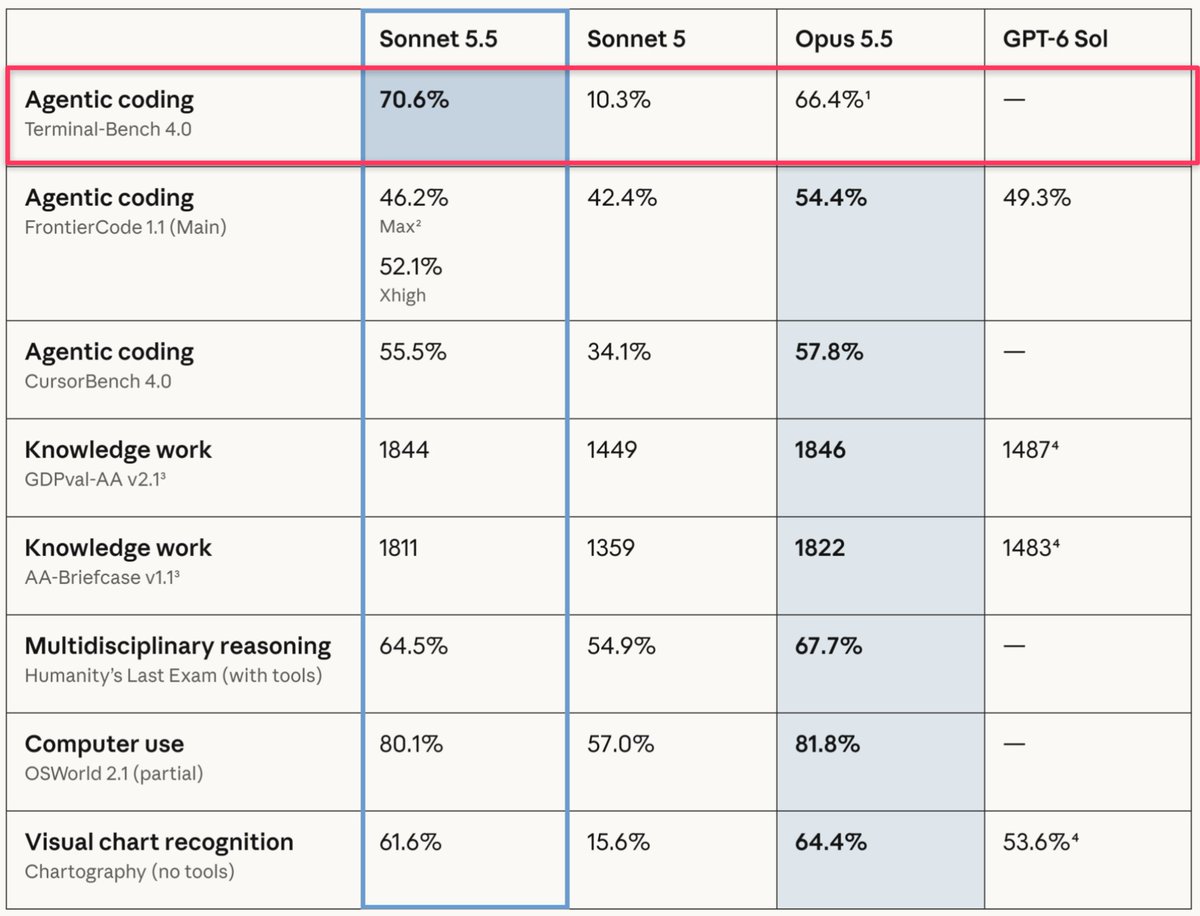
Introducing Claude Sonnet 5.5, the second model in the Claude 5.5 family.
It’s a clear upgrade over Sonnet 5, runs more than 30% faster, and costs up to 30% less for most work.
Linear'da test sayısı yılbaşından beri yaklaşık 4 katına çıktı ama PR bekleme süresi kısaldı.
Tip kontrolü Go ile yazılan tsgo'ya geçince bu adımın süresi %73 düştü. node_modules cache'ini de kaldırmışlar, paketleri yeniden kurmak cache'ten hızlı çıkmış.
https://t.co/8U4BOFFmXu
Claude Code artık 5 saatlik limite takılınca işi yarıda kesmiyor. Haftalık limitten küçük bir pay alıp elindeki işi toparlamaya çalışıyor.
Bende son bir haftada birkaç kez görev ortasında limit doldu.
Claude Code will now try to find a graceful stopping point when you hit your 5-hour limit mid-task, instead of cutting off mid-edit. It gets a small, fixed allowance pulled from your weekly limit to wrap up what it can.
Claude Code'da effort'u ne zaman düşürüp ne zaman artırmak gerektiğini ekipten Thariq anlatmış.
Yeni özellikte eksik detayları Claude'a sorduruyor. Kodu low effort ile yazdırıp testi high'da yaptırıyor.
Ben işin kompleksliğine göre ayarlıyorum, uzun sürecek işlerde artırıyorum.
What is effort really? When do you change it it and why not just use max effort for everything?
I dove deep into this problem, looking into evals and doing my own tests and I was quite surprised by the results. https://t.co/KO2D51j34H
jev/laya tarzi acik kaynakli decision modellerini ollama basitliginde kurup calistirabileceginiz bir servis gelistirdim.
ollama run ve ollama serve kolayliginda fakat decision modelleri icin, api destegi vesaire tum yetenekleriyle ve tamamen acik kaynakli.
projeyi aktif olarak gelistirmeye devam ediyorum destekleriniz benim icin cok onemli 👋
https://t.co/VG3sSTi6ct
Claude Code kurulumumda 700'e yakın skill birikmiş, kendi skill'lerim bile modele sadece adıyla gidiyordu.
/doctor prompt-audit ile fark ettim. Kullanmadığım 16 eklentiyi kapattım, 19 eski izin kuralını sildim. Biri her türlü Python kodunu onaysız çalıştırmaya izin veriyordu.
Geçen hafta laya-mlx'i paylaşmıştım. O günden beri Jev'in açık alternatifleri çoğaldı:
- OpenJev görsel girdi de alabiliyor.
- SemIf tek bir RTX 3090'da çalışıyor.
- Ollaya bunların bir kısmını tek komutla indirip Jev ile aynı API'den sunuyor.
Kalite tarafında Jev hala önde.
Jev ile başlayan "decision model" akımı şimdi tamamen local'e taşınıyor.
Laya-MLX adında açık kaynak bir proje, aynı fikri Apple'ın MLX altyapısına taşımış. Model paragraf yazmıyor; "hangi tool çalışsın", "hangi agent'a gitsin", "bu doğru mu" gibi sorulara hızlı, olasılıklı karar dönüyor.
İddia edilen rakamlar dikkat çekici:
- M3 Max'te ~7-13ms karar süresi
- 1GB altı bellek kullanımı
- Saniyede yüzlerce karar throughput
En kritik nokta: tamamen local çalışıyor, cloud API'ye çıkmıyor.
Agent mimarisi ikiye bölünüyor olabilir: üretim (GPT/Opus gibi) bulutta, hızlı kararlar (routing, guardrail, scoring) cihazın içinde.
İncelemek isteyenler için: https://t.co/aQZgbyCKG4
Anthropic Mühendisi:
"İnsanların çoğu Claude Code'u basit bir arama motoru gibi kullanıyor; kendi kendini geliştiren agent swarm çalıştıranlar ise çok az. Kendisi 100'den fazla agent'ı döngü halinde çalıştırıyor — bir "Chief" agent ve PM agent'lar tüm ekibi yönetiyor."
30 dakikalık bir workshop videosunda Claude Code'dan nasıl daha az parayla daha çok verim alınır anlatmış.
Çoğu vibe coding kursundan daha değerli
Jev ile başlayan "decision model" akımı şimdi tamamen local'e taşınıyor.
Laya-MLX adında açık kaynak bir proje, aynı fikri Apple'ın MLX altyapısına taşımış. Model paragraf yazmıyor; "hangi tool çalışsın", "hangi agent'a gitsin", "bu doğru mu" gibi sorulara hızlı, olasılıklı karar dönüyor.
İddia edilen rakamlar dikkat çekici:
- M3 Max'te ~7-13ms karar süresi
- 1GB altı bellek kullanımı
- Saniyede yüzlerce karar throughput
En kritik nokta: tamamen local çalışıyor, cloud API'ye çıkmıyor.
Agent mimarisi ikiye bölünüyor olabilir: üretim (GPT/Opus gibi) bulutta, hızlı kararlar (routing, guardrail, scoring) cihazın içinde.
İncelemek isteyenler için: https://t.co/aQZgbyCKG4
Loop engineering üzerine araştırmaya başlayınca kendi uygulamamdaki Sentry hatalarını bir agent zincirine bağladım. İlk agent hatayı analiz edip derecelendiriyor, düzeltmeyi onun çıktısını alan ikinci bir agent yapıyor.
Bulunan metinleri modele vermeden önce bir de LLM'e sıralatmak güzel fikir. Türkçe sorularla denenmesi de iyi olmuş; kendi RAG akışına böyle bir adım eklemek isteyenler için somut bir örnek.
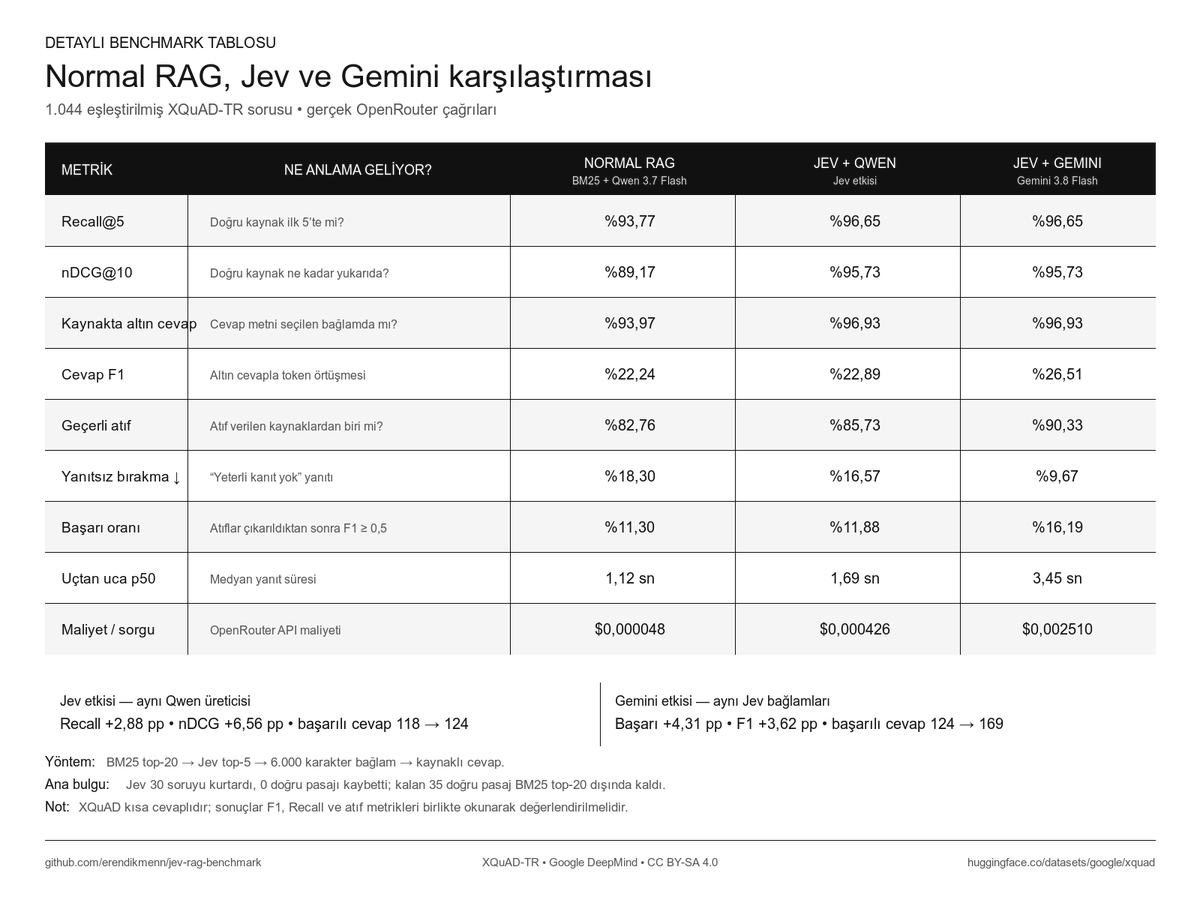
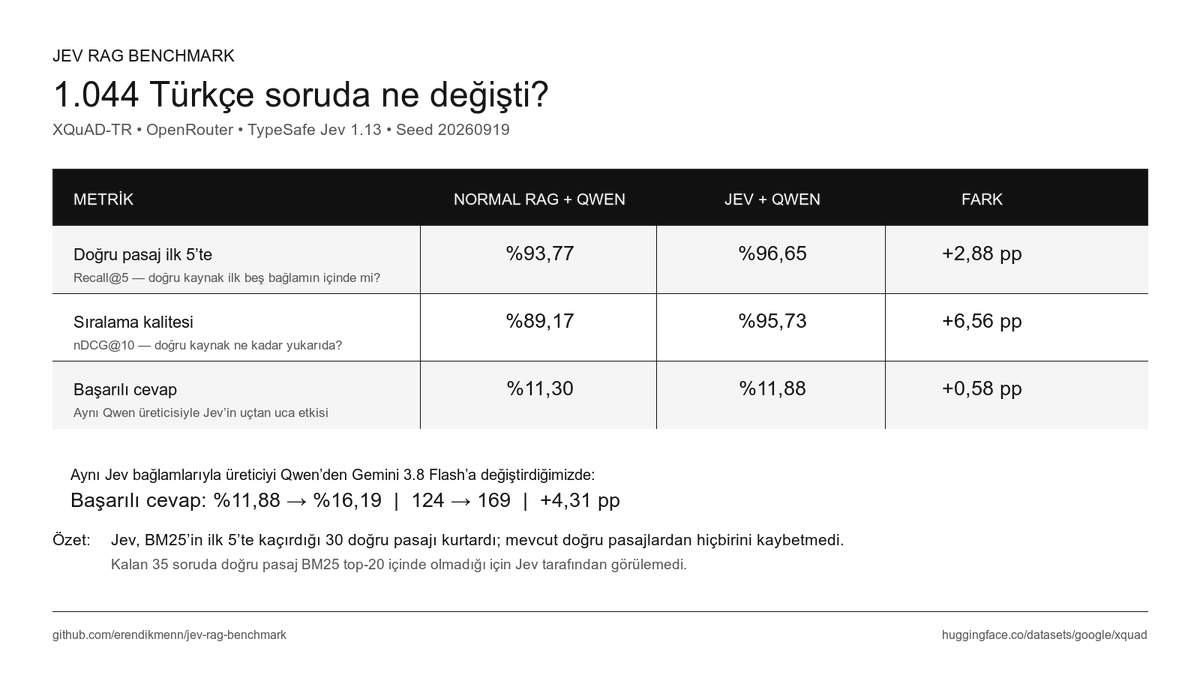
Jev kullanarak RAG sistemine farklı bir yaklaşım getirmeyi denedim ve sonuçlar gerçekten memnun edici.
Projeyi github'da opensource olarak paylaştım detaylıca incelemek isteyenler ya da önerileri olanlar mutlaka göz atmalı.
Klasik RAG’de BM25’in ilk 5 sonucunu doğrudan cevap modeline vermek yerine, önce 20 aday pasaj getirdim.
Ardından Jev’e her pasajı “Bu soru için gerçekten cevap taşıyan bir kanıt mı?” diye skorlatıp yalnızca en iyi 5’ini üretici modele gönderdim.
1.044 Türkçe XQuAD sorusunda:
Klasik RAG + Qwen
• Recall@5: %93,77
• nDCG@10: %89,17
• Başarılı cevap: 118
• Geçerli atıf: %82,76
Jev + Gemini
• Recall@5: %96,65
• nDCG@10: %95,73
• Başarılı cevap: 169
• Geçerli atıf: %90,33
En çarpıcı sonuç: 1.009/1.009. Jev, BM25 top‑20 içinde doğru kaynak bulunan bütün sorularda doğru pasajı top‑5’e taşıdı.
Klasik top‑5’in kaçırdığı 30 soruyu geri kazandı; doğru olan tek bir pasajı bile aşağı düşürmedi.
Retrieval artışı Jev’in kontrollü etkisini; başarılı cevap ve atıf sonuçları ise Jev + Gemini kombinasyonunu gösteriyor.
Şimdi ise llm router üzerinde çalışıyorum, şu ana kadar llm router üzerinde aldığım sonuçlarda fiyat yaklaşık olarak 3 kat azalırken başarı oranı sadece %4 geriye düşüyor. Onu da yarın detaylıca paylaşacağım.
Kod: https://t.co/z4gYK1aRSz
Dataset: https://t.co/sMYB5t6SzJ
Orijinal kaynak: https://t.co/trEdbRS3fS
Uzun bir görüşmenin ardından yapı onaylandı, bugün de canlıya aldım. Mentra bağımsız çalışan fitness koçları için; danışan takibi ve tahsilat tek yerden yürüyor. İncelemek isteyen olursa: https://t.co/2zBjeUfZD7
Bugün iyzico'dan onay geldi, Mentra artık ödeme alabiliyor. Bu iş bende tahmin ettiğimden uzun sürdü. Sebebi şu: platformun içinde birbirine hiç benzemeyen iki ayrı para akışı var ve ikisini aynı hesaptan yürütemiyorsun.
Sonuçta aynı VKN altında iki ayrı üye iş yeri hesabı açtım, biri abonelik biri pazaryeri. İki ayrı başvuru, iki ayrı inceleme. En çok vaktimi alan kısım da burasıydı: iş modelini karşı tarafa doğru anlatmak ve yazışmaların sonuçlanmasını beklemek.