Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
香蕉痞
@xjp
以前干媒体,前 Blogger
Joined March 2008
251
Following
2.2K
Followers
7.8K
Posts
香蕉痞
@xjp
6 days ago
ChatGPT 的交互式答复,简直是断层式领先,极大改善【对话】场景体验。 对比起来, Gemini、Claude 简直停留在上个世代。当然了,单论基座模型本身可能排序完全倒转。
香蕉痞
@xjp
8 days ago
Opus 5.5 真的是又快又好 量还足,20 🔪 Pro 的量,体感比 OAI 200🔪都耐用 不封号的话,完全是版本答案
xjp
retweeted
yetone
@yetone
12 days ago
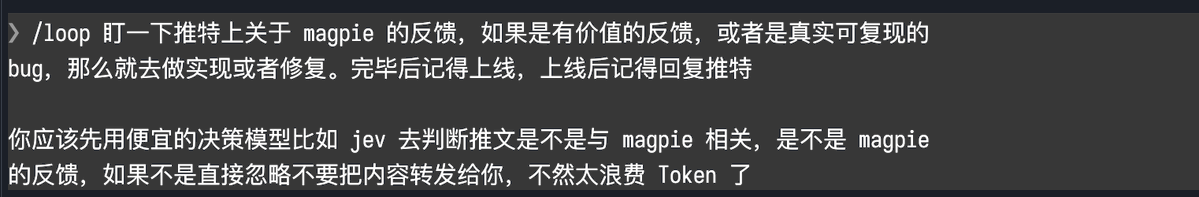
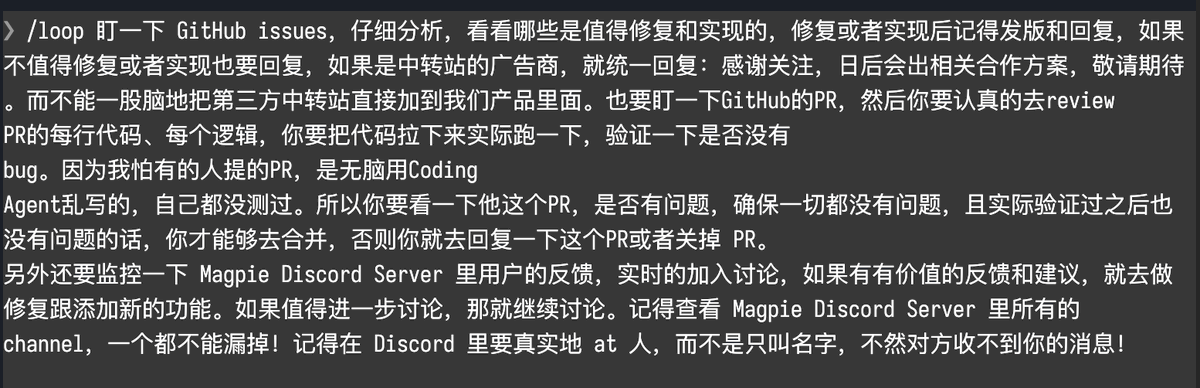
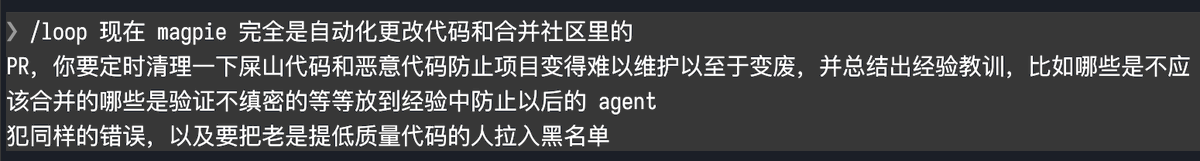
很多人想让我分享一下工作流,我一直没想好怎么分享,因为其实我没有任何的魔法,甚至还特别简陋,总觉得分享出来毫无意义。其实我就是用 Claude Code,然后用官方的 Opus 5.5 模型执行 loop 就可以了。 我会并行执行图里的 3 个 loop,然后每晚抽一点时间铲铲屎(主要是 UI/UX 的问题),然后就没活儿了。
香蕉痞
@xjp
13 days ago
@underone
诊断可以自己跑,你等下一��新的正式版发布,更新到正式版自己跑一下诊断就好了。功能啥的都不影响,我之前完全同样经历
Who to follow
Coach Jess Jones
@JessJJonesJr
Christian | Father | Husband | Teacher | Head Football Coach @HaleHSFB | @TulsaFootball Alum.
Demarcus
@Demarcus_KY
Me vs Me TLW
Andy Mac Carthy
@TheRealPapiAndy
#This is the way! | SXQgaXMgYmV0dGVyIHRvIGJlIHVuaGFwcHkgYW5kIGtub3cgdGhlIHdvcnN0IHRoYW4gdG8gYmUgaGFwcHkgaW4gYSBmb29sJ3MgcGFyYWRpc2U=
香蕉痞
@xjp
15 days ago
@oran_ge
难道不应该是没有任何关联性么
香蕉痞
@xjp
about 1 month ago
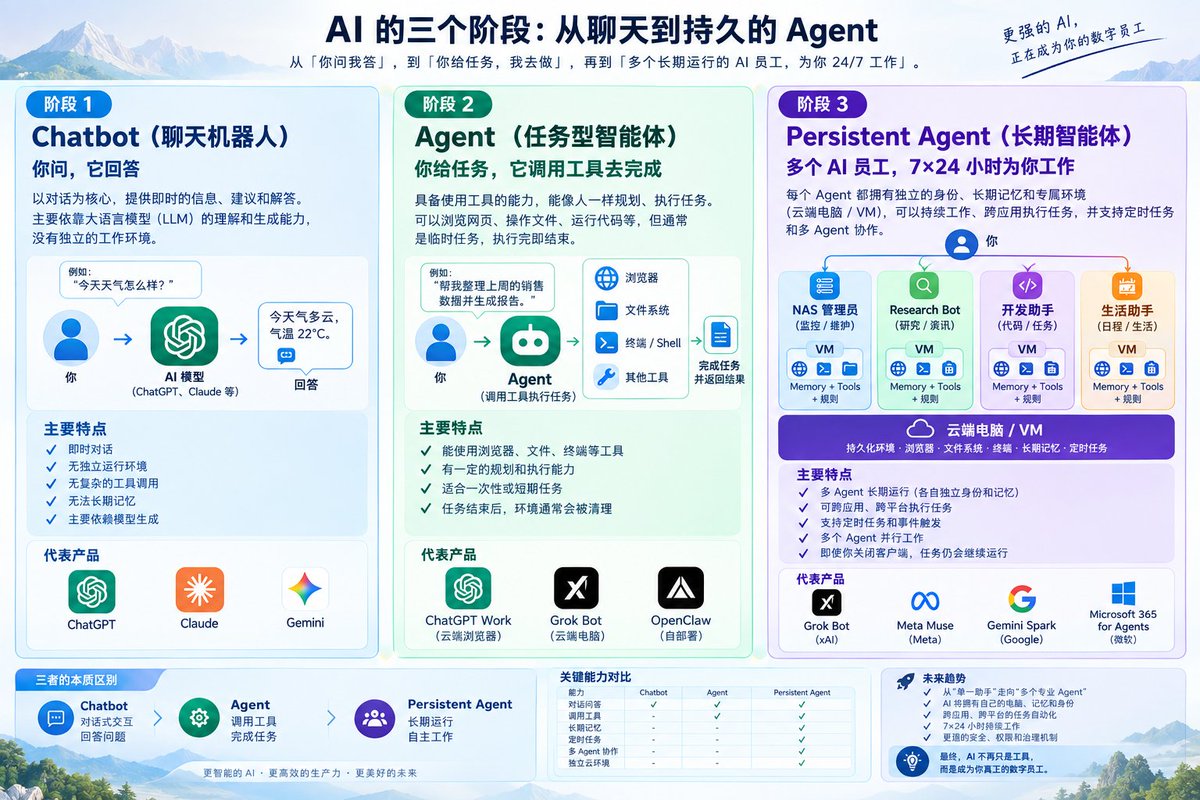
Codex Bot 也要来了 集体开卷长期智能体
香蕉痞
@xjp
about 1 month ago
不要选择所谓的小厂 NAS 机箱,五年前买的,这破玩意儿的垃圾背板把我机械阵列全部搞挂,线���电源都换过,它背锅背定了。 媒体库全炸,对,骂的就是我自己。 幸好 Docker 和系统都在固态阵列,以及家庭照片 400G 在两个云端做了双备份,不然就完犊子了。
香蕉痞
@xjp
about 2 months ago
xjp
retweeted
阑夕
@foxshuo
about 2 months ago
前段时间,美国风投机构Dimension Capital的几个合伙人来中国深度拜访了一圈AI公司,用于修正自己的投资判断,他们回去后发给出资人的内部信传得挺广的,全文翻译如下: 跨太平洋的AI棋局 1、稀缺催生进化 美国的出口管制本意是为了拖慢中国的AI发展,但结果却意想不到的制造出了一种进化压力,导致中国的AI实验室拥有了世界独有的竞争围栏。 因为缺少算力,中国团队被迫深入到极其底层的架构里去做工程优化,DeepSeek在刻意削弱性能的H800上训练模型,并绕过CUDA在更下面的PTX上编程,甚至要把每张GPU里的一部分流式多处理器专门分配给跨节点通信。 我们认为,这并不是美国工程师干不了的事情,而是因为两边的刺激机制不同。 美国的AI公司更愿意用资本解决问题,每多投入一美金,就能多买来一美金的算力,但在中国,因为始终没有充足的算力可供购买,所以形成的方案是,每多一个懂编译器的工程师,就能降低整个团队对于算力的需求。 最后形成的是一种覆盖全栈的效率文化,从系统、优化器、推理算法、一直延伸到芯片,这种能力可以持续积累,不像一次性的资本开支,用完就结束了。 2、中国开源模型完成了过去20年中国SaaS都没能做到的事情——进入西方生产环境 不到18个月,中国模型在OpenRouter上的Token消耗份额从不足2%飙升到了45%,Qwen成为Hugging Face上面最快突破10亿次下载的模型家族,大约80%的美国AI初创公司,已经在内部部署了至少一款来自中国的开源模型。 ���源绕过了传统软件采购的审查,当模型可以免费部署,也就不存在「供应商」让你放进黑名单。 但吊诡的地方在于,中国的开源模型本质上是在承担西方的生产成本,而并没有拿走西方的生产收入。 因为可以自行部署那些开源模型,所以最主要的利润,仍然流向负责提供Token的云厂商。 所以中国人把模型价格打了下来,让竞争对手很难受,但最主要的受益者仍然是美国的其他商业公司,因为它们能用到更便宜的模型了。 这不是说中国AI公司有钱不赚,开源这种生态在客观上就是会把利润的最大头分配给云厂商,而非模型开发商。 3、中国前沿模型的内部竞争,比西方预计的更加激烈 我们的判断是,目前中国模型的第一梯队包括DeepSeek、Qwen、Kimi、Doubao和GLM,它们之间的差距非常小,洗牌也相当频繁。 五家实验室同时比拼发布速度和模型能力,而且全部开源(译注:豆包并没有开源),这与美国主要由两家闭源实验室主导的竞争环境截然不同。 我们在这一周里最明显的感受就是,中国模型之间的竞争,可能更甚于它们和美国模型之间的竞争。 4、今天,AI要从太平洋两岸来回跑两趟,才能最终落地到客户那里 现在的循环大致上是这样的: 美国的前沿实验室训练出SOTA级的模型; 中国的前沿实验室对这些模型进行蒸馏,然后开源; 美国的AI服务商再基于中国的开源模型进行微调,做成产品卖给美国企业…… Cursor所谓「自主研发」的Composer 2,被发现是用Kimi K2.5改的,Cognition的SWE-1.5看起来也像一个定制版GLM。 就在我们坐在从上海去北京的高铁上时,Harvey发布了自己的专有模型Harvey Tenet——它是���Kimi K3进行了后训练所得到的产物。 如果是一年前,这些公司大概率会选择Llama,或者Mistral。 如今,美国垂直AI行业的底层基座,正在变成中国的开源模型——而这些模型内部,又潜藏着来自美国前沿模型的智能。 5、数据层似乎也在发生类似的事情 Mercor、AfterQuery、Turing这些美国的数据标注公司,都已经公开披露与蚂蚁、阿里巴巴和字节跳动存在商业合作关系。 同时,我们也在中国看到了一批刚刚出现的新公司,它们没有再去做数据标注的生意,而是转为评测和验证基础设施。 比如UniPat。 这家公司成立于2025 年12月,创始人是一名北京大学博士生,此前曾在阿里、月之暗面和腾讯工作。 UniPat发布的 基准测试,已经开始被美国实验室引用到自己的模型报告中,它还声称,通过自己基于Rubric的��督方法训练一个小模型,也取得了很好的效果。 这种思路还是在用更高质量的监督替代更多算力,与我们在第一点中提到的现象完全一致:资源,尤其是算力受限的环境,会逼迫团队发展出不同的适应性能力。 我们在北京和上海见到了好几家这样的公司,绝大多数成立不到24个月,其中少数几家的收入已经很快的突破了1亿美金。 6、美国和中国面临的难题完全不同,而且恰好相反 2024年,中国新增的电力供给是429GW,美国大概是51GW。 根据预估,一直到2030年,中国每年新增的电力供给,都将在400GW以上。 美国的情况是,目前光是数据中心的扩建项目,就有241GW的电力缺口,因为电网接入的积压,需要排队等上5年时间。 中国真正的瓶颈,正如我们提到过的,是算力资源不足。 最直接的例子就是月之暗面:Kimi K3发布后不到两天,就因为推理能力不足���暂停了新用户注册。 所以: 美国芯片充裕,但越来越受制于电力;中国电力充裕,但一直都受制于芯片。 我们可以确信的是,中期AI局势很大程度上将取决于哪一侧的障碍先被推倒,是美国的电网容量先得到改善,还是中芯国际和华为的先进封装以及良品率提升得更快。 7、中美两国的AI产值差太远了 Anthropic在7月的年化收入超过了650亿美金,OpenAI的同期数字在400亿美金左右。 相比之下,中国收入最高的模型是字节跳动的Seedance,年化收入大概在20-30亿美金之间。 中国的纯语言模型公司,年化收入都还停留在数亿美金级别,比如DeepSeek正在接近5亿美金的水位。 消费端也有同样的困扰,豆包的月活用户已经达到3.45亿了,超过Qwen和DeepSeek之和,但每天产生的收入仍然不到100万人民币,而且基本全部都来自购物佣金。 中国的消费者不愿意为软件付费这个死结,我们也不知道该如何解开。 当然,拥有如此庞大的用户规模,最终完全可能找到具有中国特色的商业模式,这在十年前的消费互联网已经发生过一次了。 那就是羊毛出在猪身上,靠电商和广告来实现模型的商业化,中国的创业者身上有种实用主义精神,他们不会因为某种商业模式不够AGI而回避它。 8、硬件和半导体在脱钩,软件和数据在融合 两个国家的政策反应速度已经跟不上了: 美国的产品跑在中国的模型上; 中国的实验室在新马泰租用英伟达的GPU训练模型; 专家标注的数据则在两个方向上互相流动; 所以我们觉得「到底哪边在赢」是一个伪命题,在目前的状态下,两个体系已经高度相互绑定,以致于国家层面的胜负很难被清晰定义。 除非RSI(递归自我改进)的实现能从根本上改变整个系统结构。 9、中国的一些顶尖研究员相信他们已经拥有弱形式的RSI了 在此语境下的RSI,仍然受到算力限制。 更准确的说,这些系统如同RSI的早期雏形: 研究员自己介入其中,通过人工辅助的方式,加速模型到达原本最终也可能到达的能力,从而节省算力和时间。 打比方来讲,这一阶段的RSI,最接近1990年到2010年之间流行的「半人马国际象棋」: 机器加人类的组合,比单独的人类或单独的机器都更强。 10、接下来会有一个至关重要的分叉 假设RSI会随着算力规模的增长而进化,那么美国所处的位置就相当有利了。 目前,美国那两家顶级实验室各自运行有大约2GW的算力基础设施,同时每家已经锁单超过5GW,计划到2030年达到约30GW的水平。 理论上,这些公司拥有巨额收入和资本市��的全力支持,可以大力出奇迹的推动RSI,而中国根本没有足够的芯片追赶。 但另一种情况是: 如果真正的瓶颈并不在于算力,而是质量; 或者,这条技术线所需要的时间足够长,长到足以让中国的优化能力和替代芯片发展到可用水平; 那么过去18个月已经出现的趋势可能不仅会继续,还会加速: 美国前沿模型能力进一步商品化; 中国开源模型变得越来越无处不在; 美国垂直AI公司则获得新的机会——在外国开放权重模型上做微调和应用; 与此同时,大量新增的调用量和利润,会流向负责提供推理服务的公司,目前来看,主要就是超大规模云厂商和新型算力公司。 当然,这一判断建立在电力基础设施按中性预测发展的前提之上。 11、还有一种未来的可能性是,美国的前沿实验室不再对外提供最新版本模型的API了 现实是,目前这一代模型���能力,已经可以满足绝大多数商业需求了。 未来顶尖的高端模型,可能不会再按调用量定价,而是���交付SaaS系统那样,按结果定价。 这样做还有另一个效果:限制中国实验室的蒸馏行为。 美国公司的代价是要放弃不断增长的API调用收入,作为回报,它们可以切断太平洋对面的竞争威胁。 或者至少,这会迫使中国进行昂贵的预训练,从而进一步挤压中国已经存在的算力资源。 12、监管政策砍不断跨太平洋的暗通款曲 到了今天,如果还认为可以简单切断这种联系,实在是过于天真了。 中美两国的技术人员正在通过各种媒介「对话」: 模型蒸馏、开放权重、数据标注、推理服务,以及越来越多的软件执行框架和智能体基础设施。 眼下正在讨论的一些粗暴限制措施——实体清单、托管禁令、采购禁令——几乎肯定会抑制美国自身的创新,并让美国在这些领域失去领导地位。 而空出来的位置,必然会迎来快速跟进的中国竞争者。 13、西方一直��讨论的估值泡沫,在中国市场明显更加突出 中国AI公司的收入规模更低,却享有更高的估值倍数,这是资本市场的一大奇观。 月之暗面的估值是年化收入的115倍,智谱、MiniMax在上市之初也都是100倍,相比之下,Anthropic只有20倍。 我们的判断是,这可能源于中国的资本市场仍不够成熟。 过去二十年,这个市场更习惯于给消费软件公司定价,而现在才刚刚开始建立一套能够理解企业软件和开源商业模式的成熟估值框架。 对于合适的投资机构来说,中国内地和香港存在着相当大的机会,能够找到新兴行业的领先标的。
See More
香蕉痞
@xjp
3 months ago
花了两小时把小龙虾从 Macbook 迁移到 Mac mini。 谢天谢地,再也不用处理完全不可控的笔记本休眠。
xjp
retweeted
CuiMao
@CuiMao
3 months ago
大家好,我们即将迎来Seedance2.5,请允许我榨干Seedance2.0所有性能配合最新Kimi K3模型为这个人类历史上具有里程碑意义的视频模型画上一个完美的句号。【完整游戏流程请移步至评论区点击链接体验】
CuiMao's tweet video.
香蕉痞
@xjp
4 months ago
@oran_ge
五级车 PKA015?帅
香蕉痞
@xjp
4 months ago
GPT 5.5 对比 GPT 5.6 Terra,首字时间差不多,但是后者吐字速度明显快很多。 不过话说回来了,现在基座模型都变成黑盒,降智策略几乎对用户端不可见。
香蕉痞
@xjp
5 months ago
@ilufie
不会是东区口腔吧,我曾经的固定牙科医院。虽然懒癌发作 6 年没去复查了吧
香蕉痞
@xjp
5 months ago
@gxgexiao
你这个柜门上打孔么,会丑么。 我之前没选透风门板,现在是个闷罐。
香蕉痞
@xjp
6 months ago
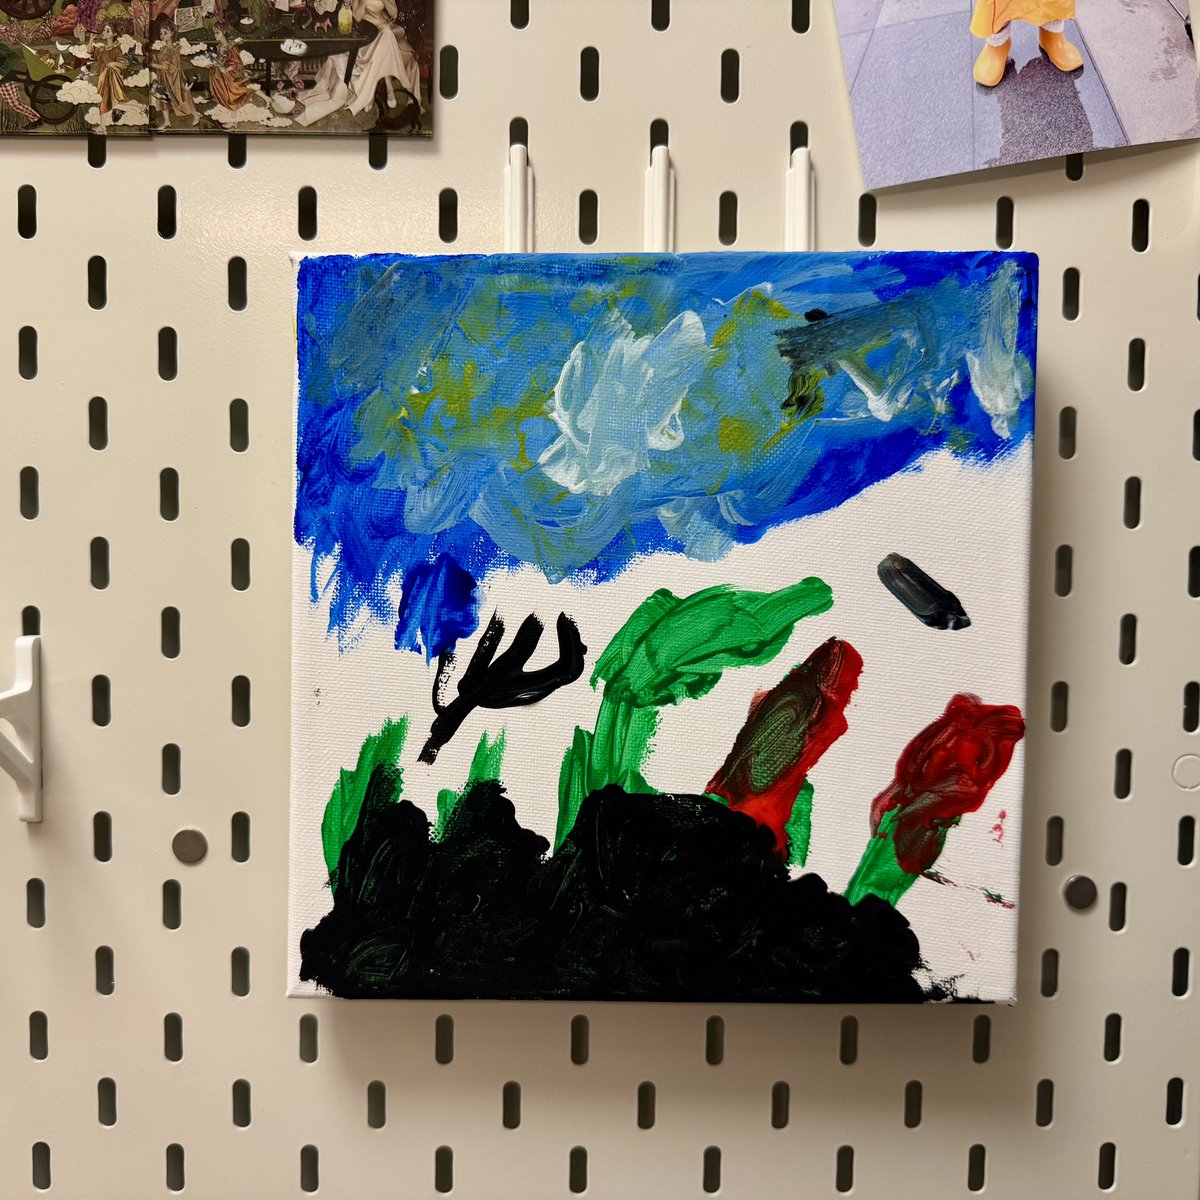
UU 的第一幅自己完成的画作 有点感慨人类幼崽的想象力 祝福她可以尽可能保持下去
香蕉痞
@xjp
7 months ago
OMG,你是不是在偷看我!
kitze 🛠️ tinkerer.club
@thekitze
7 months ago
my experience with gpt 5.4 in openclaw - pls continue - yes pls do that - yes do what i told you to do - yes continue - please do what you said you're gonna do - did you do that? no. then pls do it. just pure pain
香蕉痞
@xjp
7 months ago
GPT 的味道还是太鲜明了 不是你错了,是因为你太对了
香蕉痞
@xjp
7 months ago
@Setilis
你咋突然诈��式更新了
香蕉痞
@xjp
7 months ago
不是针对谁,所有媒体标题说 Claude Code 代码泄露是「开源」然后不加引号的,请进下水道好吧,拉爆了。 加了引号 - NPC 明确“代码泄露” - 人上人
Last Seen Users on Sotwe
♥️hot🍌🍌boy❤️🔥
Seen from
Norway
عبدالله الواسطي
Seen from
Oman
El Carlangas
Seen from
Indonesia
TURKISH +21 🇹🇷
Seen from
Austria
bela
Seen from
United States
Xarabic
Ally ducky
Seen from
United States
FANTASTIK OLGUNLAR🔞
Hayden Monteleone
Seen from
India
the real gay men
Seen from
Puerto Rico
Trends for you
1
Good Sunday
Under 10K tweets
2
#UFC333
Under 10K tweets
3
Cheesecake Factory
Under 10K tweets
4
#WorldSeries
Under 10K tweets
5
#BladeRunnerMurderforcash
Under 10K tweets
6
Ole Miss
Under 10K tweets
7
Michigan
Under 10K tweets
8
Jason Beck
Under 10K tweets
9
Courtois
Under 10K tweets
10
Merab
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.5M followers
2
Barack Obama
@barackobama
118.8M followers
3
Cristiano Ronaldo
@cristiano
114.5M followers
4
Donald J. Trump
@realdonaldtrump
111.8M followers
5
Narendra Modi
@narendramodi
107.1M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.3M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.5M followers
13
Kim Kardashian
@kimkardashian
70.9M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.5M followers
16
Bill Gates
@billgates
65.3M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.2M followers
19
CNN
@cnn
61.7M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫