Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
谎言岛的低端囚徒
@zy__China
I am Chinese, I am sorry for that.
Hubei
Joined November 2015
381
Following
41
Followers
521
Posts
zy__China
retweeted
另一面
@OtherSideBJ
about 1 month ago
看完这个视频,我在办公室做了很久很久,太震撼了!👍 前英国首相苏纳克当面硬刚马斯克,专门聊AI、科技和人类文明未来,干货炸裂! 从AI安全测试、开源争论,到教育私教、就业革命,再到X平台社区笔记,苏纳克问得专业,马斯克答得狂,50分钟直接把未来画给你看! 马斯克直接预言——AI是史上最颠覆的力量,以后工作全变“可选”,AI啥都能干,人类直接进入“丰裕时代”!机器人还能追着你跑?安全风险真实存在。 这才是真正的未来感!机会爆炸,但必须把安全放第一,政府得跟得上节奏,不然真要翻车。 以后上班?不存在的! AI给你打工,你躺平数钱!但记得给机器人装个硬核急停开关,不然它追你跑马拉松你哭都来不及🤣 赶紧点开看完,不然AI先把你工作抢了,你还在刷短视频呢~🚀
See More
OtherSideBJ's tweet video.
zy__China
retweeted
0x鸣人
@LuBtc888
3 months ago
家必看看: AI时代我们要把孩子培养成什么样的人? 人大附中,杨波教授讲座
LuBtc888's tweet video.
zy__China
retweeted
RJ
@RJDAIGOGO
3 months ago
华尔街见闻:闪迪新专利曝光!处理器直接键合NAND闪存芯片,HBM退居辅助角色 闪迪最新专利揭示一项激进存储革命:将多核处理器与NAND闪存直接键合,构建3D堆叠架构,同时将HBM从"核心主角"降格为"辅助配角"。这一设计剑指HBM容量天花板与现有高带宽闪存的延迟痛点,若落地将从根本上重塑AI加速器的内存架构逻辑,存储与计算深度融合的时代或已提前到来。 据美国专利商标局公开的专利文件,闪迪提出了一种将多核处理器直接集成于CBA存储芯片之上的3D堆叠架构,整体封装于同一中介层之上,HBM则围绕该堆叠结构分布于周侧。这一设计意在同时突破HBM容量天花板与现有高带宽闪存(HBF)架构在延迟、功耗及系统集成层面的局限。该专利的曝光表明,闪迪在加速推进HBF量产路线的同时,已在专利层面布局更激进的存储-计算融合方案,对AI加速器及GPU的内存架构设计路径具有潜在的深远影响。 根据专利文件,该设计将一块基于CBA结构构建的NAND闪存芯片置于计算芯片(如AI加速器或GPU)正下方,实现处理器与NAND的直接物理键合。CBA结构本身将大容量NAND闪存阵列与CMOS逻辑层合二为一,而整个集成堆叠随后被安装于中介层之上。HBM芯片栈则附着于该组合堆叠的一侧或多侧,与NAND层共享同一中介层平台。 这一架构的关键在于重新定义了各类存储介质的分工边界:HBM负责处理即时性、高速内存操作,而NAND闪存层则承担读写密集型工作负载及大规模数据存储任务。据Wccftech报道,在此配置下,HBM仍被集成于系统之中,但其角色已从主导地位转变为整体存储-计算层级中的特定功能模块。
See More
zy__China
retweeted
Viking
@vikingmute
4 months ago
原文的评论中有人说提了这篇文章:《Inside the Transformer: The Life of a Token》 https://t.co/sFDLVz8oHz 如果看完了原帖这篇文章,可以当这篇文章的进阶版,可以更深的了解,文章详细追踪一个 Token 在现代 Transformer 中的完整前向传播过程,有很多实战实现细节。 图做的很好,而且很丰富,很多细节,结合真实模型讲解,干货很多,但是难度高一些,适合有一定基础的朋友
Who to follow
柠檬🍋
@amyqq101
春卷的世界
@JCai2022
NanJade
@NanJade3
闲散专家
zy__China
retweeted
fin
@fi56622380
4 months ago
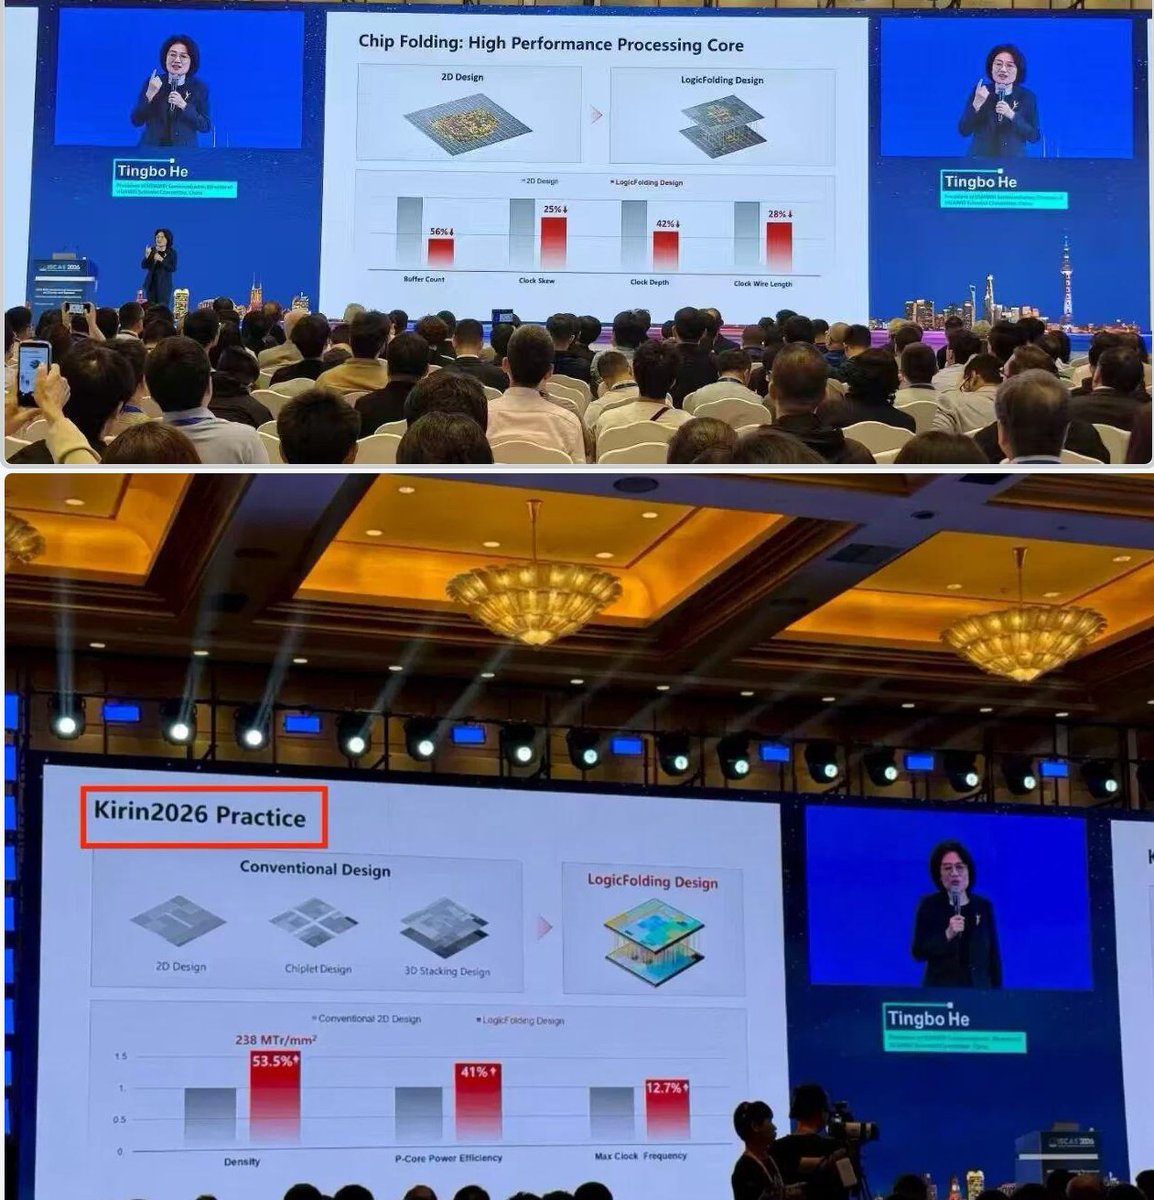
华为τ scaling定律营销策略,无非是more than moore的广义摩尔定律的另一种说法而已 作为芯片架构师,我更感兴趣的,还是芯片密度提升,ppt上41%能耗提升和12.7%性能提升,到底是怎么实现的 看完了论文,感觉华为这次创新,本质上是用设计复杂度高 + 高制造成本 + 超前散热,一定程度弥补了工艺差距 ----------------- 1. 华为芯片堆叠带来的等效密度提升,是虚假宣传还是真的,是不是工艺突破?有没有实打实的好处? 等效密度提升的来源,是两片芯片用hybrid bonding技术绑在一起,投影面积理论上能减小一半,但第一代不是全芯片双层折叠,而是选择性折叠关键logic,所以只有大概53%的芯片面积实现了折叠(密度155->238),等到后面几代折叠面积会逐渐增大,到2030年接近全折叠(密度155->292) 这2026第一代等效密度从 2025 年 155 MTr/mm² 跳到 2026 年 238 MTr/mm²,时钟频率也提升了12.7%,功耗比提升41%,表面上看似乎和工艺突破没有什么区别,但有一点重要区别就是leakage power华为从头到尾没有提,只要工艺节点不变,gate leakage、junction leakage 不会因为 3D stacking 自动改善 2030年到2031年的等效密度突变,大概率是来自于2层堆叠到3层堆叠,正如2025到2026年的等效密度突变,时钟频率突变,来自单层到2层折叠 所以从leakage没提这个事来看,这个2031年等效1.4nm,和工艺节点上的突破没有联系。 本质上是用设计复杂度高 + 高成本 + 超前散热 + 超前部署advanced packaging,一定程度弥补了工艺差距 ----------- 那么这样看起来虚假的等效密度提升,有用处吗?好处在哪里? 有的,设计上topology折叠,原来要跑几毫米的水平走线,折叠后变成了几十微米。降低了super buffer/bus的长度,降低了clock tree的深度(clock depth -42%、clock wire -28%),clock skew也带来了改良(-25%),这对动态功耗的改善是实实在在的。部分critical path的缩短,也让时钟频率的上升更容易 所以ppt roadmap上performance的提升,从2025年到2026年上升了12.7%,大部分都是来自于时钟频率的上升(12.7%) 所以好处基本上是topology拆分电路逻辑设计上带来的提升 既然没有实质上的工艺提升,华为芯片堆叠带来等效密度提升的trade off代价在哪里? 三个代价:散热超前发展,设计复杂度高,制造成本变高 最大的代价就是热密度的同步上升,理论上logic on logic都是CPU execution发热最严重的区域,这部分折叠起来相当于功耗密度直接翻倍,但算上41% power efficiency改善,功耗密度仍只比非堆叠方案高40%左右。所以第一代只能对最关键的部分做折叠,大概只占全芯片面积的53%。 所以散热技术也被逼的超前发展,直接上毫米级的MEMS风扇,做micro-cooling fan。 另外的代价就是设计复杂度的变高,critical path的折叠,哪个部分的logic能折叠,折叠之后又会带来从前端到后端的巨大变化要推翻重来 现有的所有EDA工具也不可能支持3D topology,论文自己也承认,full-scale LogicFolding需要全新的3D-native EDA toolchain,把多层stacked dies当作单一连续设计实体处理。哪些logic能折叠、折叠后的inter-die timing closure怎么做,Physical Design(PD)也是难点 制造成本也会更高,被迫超前部署advanced packaging封装,1.5~2um的hybrid bonding + logic on logic都是很有挑战需要显著更高的成本 以前一层wafer做一次光刻;现在两层wafer分别做光刻再bonding,加上hybrid bonding的overlay控制(论文要求<0.5μm)、TSV、KOZ keep-out zone、冗余修复、良率乘法损失,每颗芯片的制造成本和测试成本都要显著上升 -------------------------- 2. Tau scaling这个说法,scaling的到底是什么,这个scaling技术路线是不是一次性的design topology红利?潜力如何?持续进步的空间在哪里? τ Scaling的核心主张是:用时间常数τ替代几何线宽作为全栈优化目标,在器件、电路、芯片、系统四个层级分别压缩特征延迟 公式本身没有任何新物理。"关注瓶颈延迟"是所有架构师都在做的事情。整个行业都知道互联RC是延迟瓶颈,TSMC每一代工艺都在用low-k dielectrics/semi-damascene等手段降RC。把一个众所周知的优化方向包装成"定律"是显然的营销宣传手段,本质是More than Moore的广义摩尔定律的另一种说法 抛开marketing,华为目前所谓RC delay的改善,本质上是芯片堆叠之后,topology距离缩短,让匹配的effective RC都变小,不是RC工艺常数 至于scaling的意思,是能持续发展的一条roadmap。这里的持续改善路径指的是,全芯片堆叠的层数越来越多,从25~30年的2层堆叠,到31年开始的3层堆叠,以后甚至会考虑4层堆叠 第一代折叠技术甚至不是全芯片双层折叠,而是选择性折叠关键logic,所以只有大概53%的芯片面积实现了折叠(密度155->238),等到后面几代折叠面积会逐渐增大,到2030年接近全折叠(密度155->292)。2031年的roadmap之所以会出现一个阶跃,就是因为那是从2层折叠到3层折叠的时间点。 但需要注意的是,这个scaling方法的边际效应是逐渐缩小的,折叠成双层的收益是100%,2->3层的收益就只有50%,如果2035年再从3->4层堆叠,收益就只有33%了 另外随着堆叠层数变高,上面说到的三个挑战,散热,设计复杂度,成本,都是越来越大 --------------------- 3. 华为的芯片堆叠,是不是TSMC/AMD已经有的hybrid bonding技术?华为做到的是cache on logic,cache on cache,还是logic on logic,logic on logic最大的散热问题是怎么解决的? 是已经有的技术没错,但同时也是把现有技术指标做到了领先也是真的,3D堆叠本身不是新技术,TSMC的hybrid bonding量产还是6um,华为论文给出Kirin 2026的hybrid bonding pitch是1.5μm 我在刚刚看到华为的堆叠消息之后,第一反应也是怀疑和AMD的3D V cache类似,它主要把 SRAM cache 叠在 已经有的L3 cache 区域上,通常会避免直接堆在最热的 CPU execution logic 上,就是避免散热问题,毕竟SRAM 的功耗密度和热点特性与high-activity logic 不一样,如果最热的logic on logic堆叠,散热恐怕会碰到困难 但看了更多数据之后,clock buffer -56%、clock depth -42%、clock wire -28%,这些只有在core内部的clock distribution被重构时才可能发生。纯SRAM stacking不会碰core内部的clock tree。另外如果只是cache on cache,大概率是不需要单独MEMS微型风扇额外散热的,证据普遍都指向logic on logic方式 华为这个技术的精妙之处在于,logic on logic 折叠之后热密度并没有翻倍,而是因为topology的好处,能耗下降了30%,这样热密度只上升了40~50% 而第一代没有完全把整个最热的execution logic 100%堆叠起来,论文也明确说selectively applied along key critical paths,只是大概53%有选择性关键路径会堆叠起来,可能颗粒度都没有那么好,只是IP堆叠在IP上,那么热密度上升也许能维持在20%以内 但这条道路继续前行,超前发展的散热就成了必然,现在是MEMS微型毫米级的主动散热风扇,紧贴处理器传导效率高,和华为手机一样,散热堆料特别足,而且技术领先同行。 以后怕是要把HBM7/8的微流道散热技术提前用起来了,毕竟HBM7/8要上24+层堆叠,华为很可能要在提前用上下个世代的散热技术了 ------------------------- 4. 从架构角度来说,最重要的问题,华为41%的power efficiency(能耗比)提升,到底是怎么实现的?为什么AMD的3D V cache没有这么大的提升? 首先确定41%的定义。论文只说"SoC performance-core power efficiency improved by 41%",没有给出benchmark名称、Voltage/Freq点、温度条件、功耗边界。但PPT roadmap上有一个关键线索:ISO-Power Performance的数字,2025年是2.75,2026年是3.1,提升12.7% 这个时钟频率提升12.7%完全一致,可以理解为,同功耗的性能提升是12.7%,绝大部分是时钟频率提升带来的 至于能耗比上优化的猜测是,LogicFolding缩短critical path → 在固定Vdd下Fmax从2.75GHz提升到3.1GHz → 这意味着在原来的2.75GHz频率下,有了约12.7%的timing headroom → 这个空间在iso-performance模式下可以换成更低的Vdd 另外的能耗比的提升,可能也来自于电路折叠之后,cache hit latency的下降。从业界经验来看,一般L2/L3 cache hit latency下降10%,CPU整体性能会有至少5%的提升 ppt里显示SRAM latency下降30%,估计会有一部分转化为cache hit latency的下降 AMD的3D V cache没有这么大的提升,主要是因为AMD的底层logic die并没有重新设计,3D cache的延迟latency不仅没有减小反而加大,只是增加了cache大小,收益不如latency下降那么明显。 另一方面,clock skew的下降,critical路径变短,造成电路timing变好,意味着华为可以使用更低的vdd(猜测甚至能低7~8%),以及路径缩短所带来的RC的下降(考虑到clock buffer -56%、wire -28%、SRAM pJ/bit -24%这些数字,比如C_eff下降10~15%合理),再加上clock tree的整体缩短和下降,确实是有可能在部分Voltage/Freq点做到同性能下,做到30%的功耗下降的,而30%的功耗下降换算过来就是41%的power efficiency 对比苹果和高通,每一代手机芯片在iso-power下单核性能一般提升10-20%,iso-performance下功耗一般降30-40%,这是V/F曲线的特性决定的,所以从经验上来说,数字是对的上的。 所以这个power efficiency(能耗比)的提升,从现有的数字上来说可以从topology推导出来是合理的,可能真的和工艺节点没有太大关系 ---------------------------- 5. 这个技术路线有没有可复制性,其他家会不会效仿? 短期内不会大规模效仿,因为性价比和风险收益比来说不好。长期来看,这个方向所有人都在走,只是名字不一样 华为做LogicFolding的根本驱动力是制裁,工艺节点被卡在7nm,只能在封装,散热,和设计层面想办法弥补。华为也为此付出了不小的代价:散热成本,设计复杂度,以及制造成本更高(包括良率)。这是一个被逼出来的路线,不是一个自然选择 其他玩家在用TSMC就能做到正常的经济迭代,是没有必要冒着这个风险,去超前迭代散热技术和设计复杂度的 长期来看,Intel的Foveros、TSMC的SoIC、AMD的MI300的3D stacking都在朝同一个方向走。如果继续追最先进节点的经济性持续恶化,那么"固定一个成熟节点+3D topology optimization"的路线会越来越有吸引力 散热方面,MEMS微型风扇和微流道也会成为未来HBM散热的主流 ------------------- 总结一下,华为这次的创新,绝对是值得尊重的,在制裁环境下,用极高的设计复杂度和成本,在一个被锁定的工艺节点上大胆重新设计,榨出了一次大的topology红利,虽然它有天花板。每多加一层的边际收益递减(堆叠1->2层, 2->3层, 3->4层,提升百分比变小),leakage无法解决,散热越来越难,3D EDA工具链更是全新的挑战。 但这个Tau scaling不是一条可以走十年的指数增长路径,每次爬完一个台阶,下一个台阶更难爬,而且台阶更矮收益更小,华为以后想缩小差距,还得再想想靠什么其他的路线
See More
zy__China
retweeted
陈成
@chenchengpro
5 months ago
看了
@Khazix0918
那条关于横纵分析法的帖子,又把他开源的 khazix-skills 仓库从头到尾翻了一遍,聊聊我的观察。 先说背景。作者三年前在金融行业做公司和行业研究,当时就搞了一套方法论。后来 AI 来了,他把这套东西迭代了一下,封装成了 Prompt 和 Skill 两个版本,开源在 GitHub 上。自己说用了两年,是手头最顺手的工具之一。 这套方法叫横纵分析法,底层逻辑来自两个学术传统。一个是语言学里索绪尔的历时分析和共时分析,一个是社会科学里的纵向研究和横截面研究。他把这些研究视角抽出来,结合商业竞争战略分析的思路,做成了一个 AI 可执行的通用研究框架。 具体操作就两条轴。纵轴沿时间线还原一个事物的完整故事,从诞生到现在,谁做的,经历了什么,为什么在某个节点爆发或掉头。横轴在当下时间点做竞品对比,它跟同赛道的东西有什么不同,用户为什么选它,它在整个赛道里是什么位置。最后把两条轴交叉起来看,能发现单独看任何一条轴都看不到的东西,比如今天的某个优势其实是三年前一个不起眼的决策慢慢积累出来的。 他用 Claude 深度研究模式演示了一下,研究对象是 Harness。13 分钟出了一份大概一万字的报告,纵向把历史节点拉得很清楚,横向对比了 Prompt Engineering、Context Engineering 和 Agent Engineering。 翻仓库能看到更多细节。整个仓库只有 9 个文件,但信息密度极高。 hv-analysis 这个 Skill 的执行流程是这样的:先拉起并行子 Agent 分三路收集信息(纵向历史、横向竞品、补充资料),还接了 arXiv API 查论文。然后按框架生成报告,纵向分析 6000 到 15000 字,横向分析 3000 到 10000 字,交汇洞察 1500 到 3000 字,最后用 WeasyPrint 生成带封面的 A4 PDF。它还会根据研究对象的类型自动调整侧重,研究产品就重点看版本迭代和功能对比,研究公司就重点看融资历程和商业模式,研究人物就重点看职业轨迹和同领域对比。 但真正让我觉得这个仓库被低估的是第二个 Skill,khazix-writer。 这是一个微信公众号长文写作 Skill,SKILL.md 有 29.5 KB,几乎是一本完整的写作方法论手册。核心定位一句话:「有见识的普通人在认真聊一件打动他的事」。 它定义了五种文章原型:调查实验型(「我替你做了这件事」)、产品体验型(「跟我一起体验」)、现象解读型(「你注意到了吗?背后是什么?」)、工具分享型(「我发现了一个好东西」)、方法论分享型(系统化分享积累经验)。每种原型有不同的叙事结构和节奏。 写作技法拆得非常细:长短句混合的节奏感、口语化的故意打断、知识「顺嘴带出」而不是「我来科普」、私人视角连接公共议题、敢于判断有明确好恶、理解对立面后再表达不同观点、文化升维(从具体事件连接到更大的哲学参照)、回环呼应(契诃夫之枪,第一幕挂在墙上的东西第三幕必须响)。 还有一套四层自检体系。L1 硬规则扫描,L2 风格一致性检查,L3 内容质量审查,L4 人味终审,最后一层的核心问题就一个:「这是有见识的普通人在聊天,还是 AI 信息输出?」 最让我觉得有意思的是它的反向约束设计。大部分人写 Prompt 是告诉 AI 你要怎么写,这个 Skill 花了同样多甚至更多的篇幅告诉 AI 你绝对不能怎么写。禁用冒号和破折号,禁用直引号,禁用「说白了」「本质上」「综上所述」「值得注意的是」这些 AI 死亡标记词,禁止编造案例,禁止用「AI 工具」「某个模型」这种模糊称呼,必须写具体名字。甚至画了一条清晰的人机分工线:AI 负责找证据、扩写、提供背景知识;人类负责一手观察、核心创意、真实情感。AI 绝对不能代替人类生成的是:编造的场景、核心原创洞察、文字里的温度。 两个 Skill 可以串联使用,先用 hv-analysis 做深度研究,再用 khazix-writer 把研究结果写成文章。支持 Claude Code、Codex、OpenClaw 直接安装。如果只想用横纵分析法做快速研究,仓库 prompts 目录下有独立 Prompt 版本,复制到任何有深度研究功能的 AI 里就能跑。 仓库地址:https://t.co/o8sxfv5plx 原帖最后有一句话我觉得是整件事的核心:这个时代做研究,真正稀缺的不再是信息,而是你对这个世界有多好奇。方法和工具都是后面的事,好奇心在前面。没有好奇心,有再好的方法论也是摆设。
See More
zy__China
retweeted
Berryxia.AI
@berryxia
6 months ago
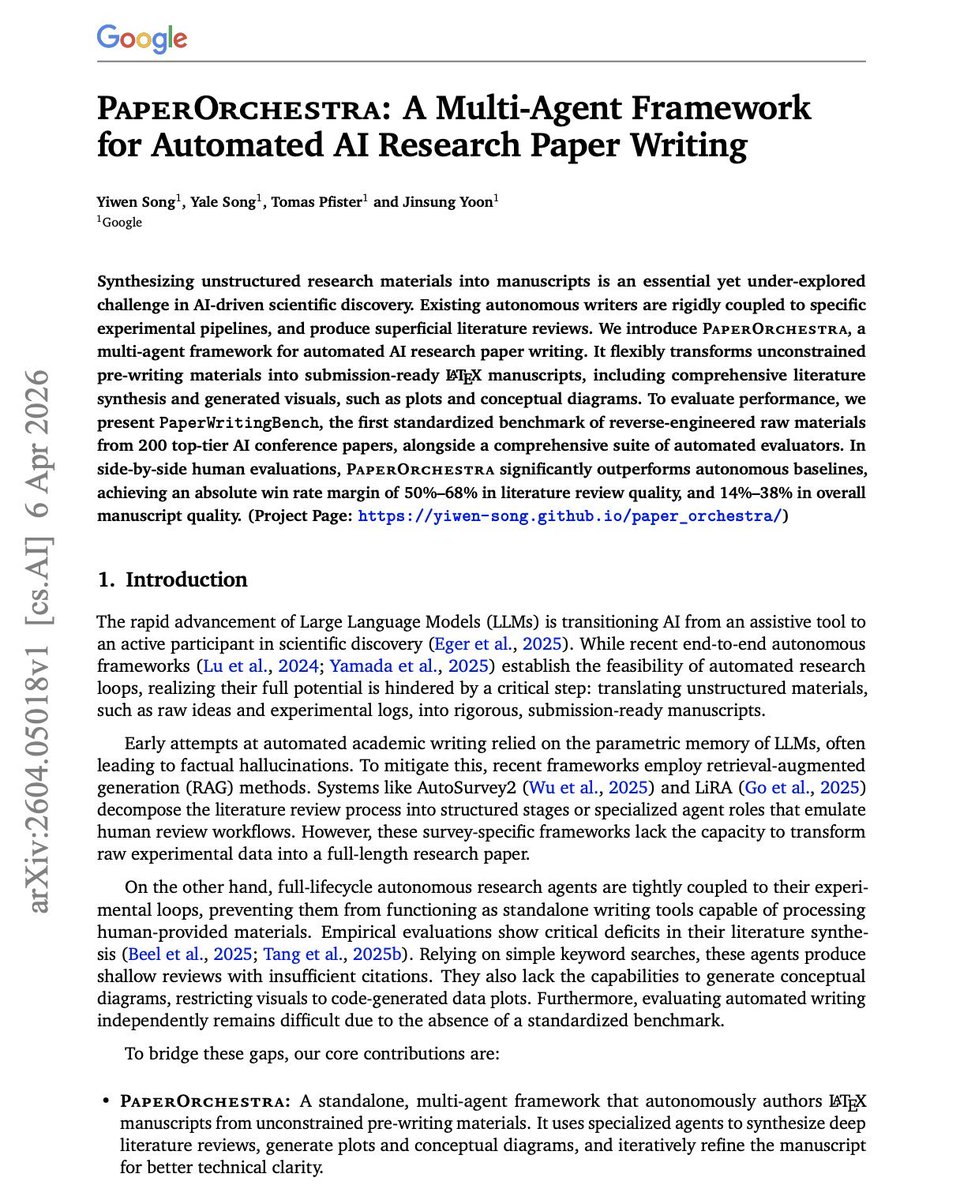
Google 又把 AI 科研写论文这件事重新定义! 全新多智能体系统 PaperOrchestra: ✅ 把原始想法、实验日志、笔记直接变成投稿级 LaTeX 论文 ✅ 专门的 Literature Agent 做深度文献综述 ✅ 自动生成概念图、实验图表 ✅ 迭代打磨到能直接投顶会 还开源了 PaperWritingBench 基准(从 200 篇顶会论文逆向工程来的) 人类盲测里,文献综述质量胜率 50-68%,整体论文质量胜率 14-38%!太离谱了🤯
zy__China
retweeted
李继刚
@lijigang
6 months ago
读好文: https://t.co/XdfAJkJoLS
zy__China
retweeted
seekinganythingbutalpha
@ivanalog_com
6 months ago
目前看来,所有不动手的科研人员都有很大的可能几年内被AI取代: Semantic scholar (信息搜集) -> [下载] -> Notebook LLM (课题RAG)-> Claude code [调用] NLLM 针对主题,直接研究写作 -> code/cowork 生成测试和结果,分析数据,写作 -> Paperpile 插入文献格式。 AI针对主题自动研究。
zy__China
retweeted
AIGCLINK
@aigclink
6 months ago
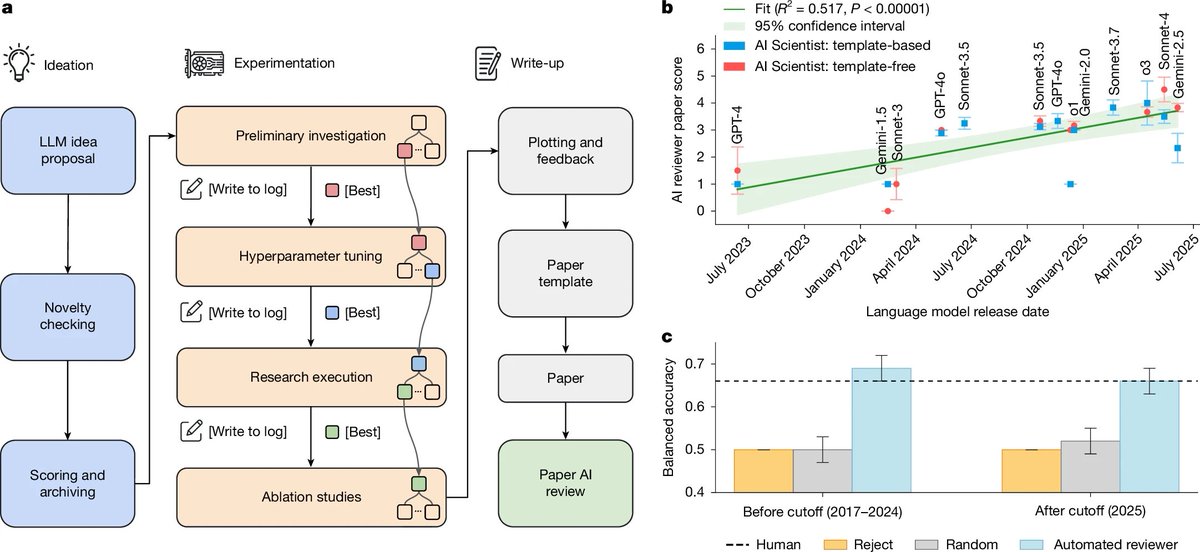
最新,这款AI科学家系统登上了Nature:The AI Scientist 从生成研究想法、代码编写运行实验、分析数据、论文撰写、自动审稿评估,全程端到端自动化 生成的论文向ICLR 2025研讨会提交了3篇,1篇通过盲审 不过按预先协议(AI生成)已被主动撤回 它有两个模式 1、基于模板Template-based,给定一个初始代码模板,AI在此基础上扩展研究,适合目标明确的任务 2、无模板Template-free,不依赖初始代码,从零开始生成代码和实验,适合开放式探索 #TheAIScientist #AI科研系统 #AI科学家
zy__China
retweeted
李继刚
@lijigang
6 months ago
https://t.co/q9JL7v4nXv 把「圆桌讨论」的skill 也添加进来了,以后归拢一下,把日常使用比较成熟的skill 都放在这个repo。
zy__China
retweeted
宝玉
@dotey
6 months ago
Agent Skills 设计哲学和实战进化 前半段是真实场景演示,看我日常怎么用 Agent + Skills 完成实际工作;后半段是设计哲学和迭代方法论,把踩过的坑和悟出来的经验都讲透。 四个核心观点: 1)从提示词到 Skills:起步没有门槛。把你已有的好用提示词、好的实践、甚至模糊的想法,直接用 /skill-creator 变成 Skill。关键是动手。 2)别做万能 Skill:Skill 要原子化,每个只做一件事。然后用 Skill 或者 AGENTS.md 编排成工作流,让 Agent 灵活执行。我的素材收集和写作流程就是这么串起来的。 3)Skills 像随身小刀,越用越顺手:自己常用、遇到问题当场改、给 Agent 高质量对比样例让它自己优化、用 git 做版本管理留后悔药。 4)站在 Agent 角度设计:多存中间文件、先分析再执行、写清验证标准、用子 Agent 并行、脚本优先于 MCP。这些小细节决定 Skill 能不能真正跑通。 baoyu-skills 已全部开源:https://t.co/pRDqxdiSrH
See More
dotey's tweet video.
zy__China
retweeted
yan5xu
@yan5xu
7 months ago
所以我说啊,学习管理学,是让自己用好 AI 的一条捷径。 人和AI的关系,本质是一道领导力题。用情境领导力的框架看,有三种人: 将才,Team Leader。 自己能干,但把能干不想干的活委托给AI,腾出手做更有价值的事。关键是:他会看AI怎么干的,把AI的能力内化成自己的。就像带兵的将军,既能指挥也能上阵,跟下属打成一片的过程中自己也在进化。Senge说的"学习型组织",将才和AI之间就是一个双向成长的学习闭环。 帅才,Architect。 不亲自干活,但花大量精力做三件事:Probing(探测AI的能力边界)、Decomposition(把复杂任务拆到AI能可靠交付的粒度)、Verification(关键节点抽查质量)。这是德鲁克定义的"做正确的事"——认知不在问题本身,在系统设计。调度10个Agent,产出10倍。 弃权者,Abdication。 管理学里最忌讳的词。把问题扔给AI,接受输出,完事。不探测边界,不校验质量,不过脑子。正如MIT这篇论文里,重度用户连没有AI就回忆不起自己写过什么。这不是Delegation(授权),是Abdication(弃权),把认知主权交出去了。 当然将才和帅才是两种范式,并不冲突。同一个人可以在熟悉的领域当将才亲自下场共同进化,在已验证的流程上切帅才模式系统调度。而弃权者,哪种都不是。 所以AI没让人变笨。放弃思考让人变笨,AI只是让放弃思考变得前所未有的容易。
See More
zy__China
retweeted
Jason Zuo
@xxxjzuo
7 months ago
文章洞察太深刻了 是目前最安全的位置的确是第二层:电力驱动者。 不是因为技术壁垒,是因为"定义问题"的能力短期内很难被替代。 几个观察: 1. SOP 比代码值钱。AGI 会写代码,但不知道该写什么代码。我的 Agent 能自动跑 20+ 个脚本,但每一个脚本背后是我踩过的坑、试过的方案、最后沉淀下来的流程。这些东西不在代码里,在我脑子里。 2. Token 成本是风向标。文章说"Token 不会降价,会涨价",这个我有直观感受。Anthropic 的 Fast 模式一天能烧掉以前 12 倍的 Token。用得越深,成本越高。如果这个趋势持续,第二层会越来越薄。 3. 时间窗口是真的。一年前会用 AI 是优势,现在只是及格线。三年后可能连及格线都不算。现在建立的 SOP 和领域经验,是唯一能带进 AGI 时代的东西。 "控制的最高形态,是让被控制者感觉不到控制的存在。"希望不要彻底成为第三层。 第三层的人可能过得很舒服,但舒服和自由是两回事。
See More
zy__China
retweeted
泊舟
@bozhou_ai
10 months ago
今天在公司给同事们做了一场简短的AI分享会,我说了一下我日常如何用AI的,同事们觉得都很有收获,在这里也分享给大家。 日常工具 聊天工具: ChatGPT,Gemini,Qwen 学习工具: NotebookLM 输出工具:YouMind 编程工具:后端Codex,前端Antigravity 图片工具:Nano Banana Pro,Lovart 如何使用AI 和AI聊天 在聊天之前我要先想清楚我要问的问题属于什么维度,这里参照四象限,看图片一。 根据维度来选择沟通的方式,比如我要AI帮我做个数据清洗,这属于共识区,我直接把数据给他,让他给我清洗一下,提取我要的结构就可以了。 这里有个小技巧,我们让AI回答的时候让他基于思维框架来回答会出奇的好,比如: SMART,5W2H,黄金圈,第一性原理,金字塔原理,SWOT,奥卡姆剃刀,二八法则。 具体用法就太多了,我就不一一举例,大家可以给到AI让其分一些应用场景 写提示词 文本创作类 1. 先搜集相关资料,我会使用Deep Research,比如我要写一个儿童绘本提示词,我会让调研一下一个好的儿童绘本要有什么核心要素 2. 告诉AI我要写一个提示词,会提供什么,我需要得到什么,然后提供调研的资料,让其出一个结构化的元提示词 修改一下元提示词,然后去使用,把结果给到AI,说要改进的地方,不断迭代 图片类 找对标,然后发给AI,生成一个json的元提示词,限制800字,然后改里面的主体结构等等 基本能复刻90% 如果对于自己的目标比较模糊,我们要学会让AI对我们进行提问,就是让AI问我们问题,来理清目标再写提示词。 AI进行编程 遵循spec规范驱动开发的原则,先写PRD,然后技术文档,然后列计划然后开发,测试 1. 写PRD,我一般是通过和AI沟通,然后不断PUA ,就是说一下自己的需求,然后不看第一版,直接开始不断PUA,一般效果能好不少。图二 2. 使用aistudio的Build模式进行快速原型开发,只开发前端功能 3. 代码拉下来到Antigravity进行调优 4. 然后可以让写测试用例,使用 chrome-dev-tool MCP进行自动化测试 5.后端编写我会用提示词先总结一个文档文件夹,看图三,然后使用专有的规则,会先读取私域知识库,然后再进行开发。 这种代码采用率会很高,但是要求就是在架构层面需要提前设计好,反正宗旨就是上下文越清晰,越准确,AI生成的质量越好。 对于从0到1的项目,就直接按照Sepc规则,生成技术文档,然后一步一步执行 关于企业化落地方案 我了解到市面上就以下几类,比较火,大家可以从这里面找一些我们可以做的 问答类 主要是是企业内知识库问答和ToC的智能客服 审核类 合同审核,然后一些流程审核 写报告类 比如写PRD,研报,季度汇报,规划等等 问述类 TextToSQL这种,比如老板直接说一句要第一季度报表,会查询数据库这种 我觉得可以看一BISHENG这个产品,我觉得公司部署一个是非常好的 AI信息源 我的AI信息流主要来自于以下三个 1.Waytoagi飞书文档,Waytoagi应该是国内最大的一个AI社群了,知识库非常的全面 2. aibase 这个会有很多AI导航和新闻一体化的,中文友好 3.自己搭建了符合我个人需求的一个获取外网的AI最新信息的网站 三个链接都放在评论区了
See More
谎言岛的低端囚徒
@zy__China
10 months ago
@elonmuskTN
37
谎言岛的低端囚徒
@zy__China
10 months ago
@shao__meng
向您请教下,推文最后的图是怎么生成的呀?
zy__China
retweeted
苍何
@canghe
10 months ago
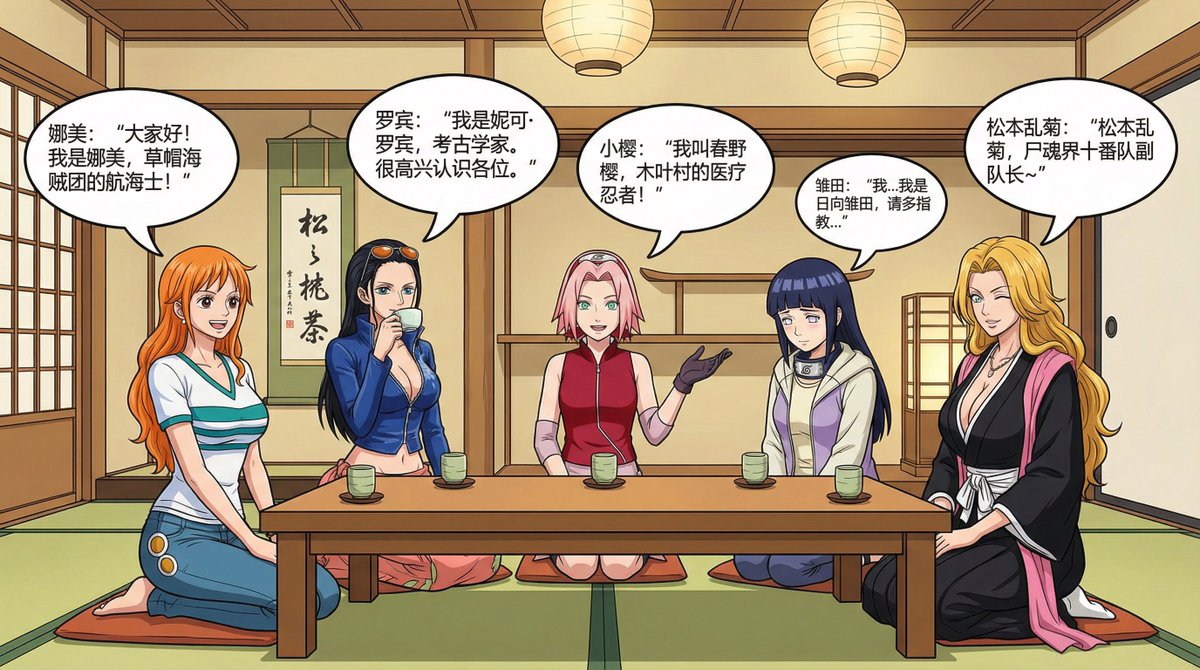
又熬夜测了谷歌最新 Nano Banana Pro,总结了 20 种邪修玩法和提示词。 整体感受非常炸裂,人物一致性、中文支持、速度上、审美上,提升都不止一个台阶。 以下是我的case。 1、串场漫画 prompt:帮我生成动漫角色中的女角色的一个合集故事,其中包括娜美、罗宾、,小樱、雏田、松本乱菊,做成彩色漫画的形式,要求中文。
zy__China
retweeted
看不懂的SOL
@DtDt666
11 months ago
硬核高能!强烈建议我的每一位粉丝兄弟必看《投资的底层逻辑》这部纪录片 这片子是师兄孟岩耗时2年制作,是我认为是关于投资最好、最接地气的科普纪录片 特别是处于恐惧、亏损、无助、迷茫期的兄弟们,观看后你会醍醐灌顶豁然开朗。 仅需30分钟你就能理解货币、经济、供需、投资周期的底层逻辑。 ——此文无价,建议兄弟们收藏反复观看!
DtDt666's tweet video.
zy__China
retweeted
Mr Panda
@PandaTalk8
about 1 year ago
我试玩了一下, 越来越好玩了。
Last Seen Users on Sotwe
minh kiên
Seen from
Vietnam
Average_dicks
Seen from
United Kingdom
˗ˏˋ☀´ˎ˗
Seen from
Turkey
Hakan Filiz
Seen from
Germany
jess
Seen from
Italy
◌みなまる◌
Seen from
United States
Türk İfşalar
Seen from
Germany
りお
Seen from
Thailand
Sergeramos
Seen from
Malaysia
Aslıhan Aslan
Seen from
Turkey
Trends for you
1
Good Saturday
Under 10K tweets
2
Deflate
Under 10K tweets
3
Northwestern
Under 10K tweets
4
Packers
Under 10K tweets
5
Breaking Bad
Under 10K tweets
6
#ADifferentWorld
Under 10K tweets
7
Cleveland
Under 10K tweets
8
#AzerbaijanGP
Under 10K tweets
9
The Wire
Under 10K tweets
10
Lando
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.7M followers
2
Barack Obama
@barackobama
119M followers
3
Cristiano Ronaldo
@cristiano
114.4M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107.2M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.4M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
83.9M followers
11
Lady Gaga
@ladygaga
75.4M followers
12
Virat Kohli
@imvkohli
73.4M followers
13
Kim Kardashian
@kimkardashian
70.9M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.4M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.3M followers
19
CNN
@cnn
61.8M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫