بنلعب بشرف ضد الفيفا ضد الحكم قصاد كل مغريات البطوله اللي عايزين الارجنتين تكمل عشان مدللهم المعتوه و اعلاناتهم . معدتش خلاص يفرق معايا نتيجه الماتش بعد الروح اللي شفتها دي … و كسم استديو فوكس علي كسم زلاتان إبراهيموفتش
من خطاب السيسي النهاردة بالنص
"اسمحولي أقولكم ليه القيادة الاستراتيجية للدولة موجودة هنا ، لأنه في يوم من الايام كان بيتم محاصرة المحكمة الدستورية ومجلس الوزراء وفي يوم من الايام كانوا بيهددوا وزارة الدفاع وفي يوم من الايام كانوا بيحاصروا مدينة الإنتاج الإعلامي ، عشان تدار الأزمة ايا ما كانت الأزمة تدار تحط ضغط ويمكن تكون خوف كمان.
كان لا بد ان الدولة تخرج من العاصمة وان الكلام دا ميتنفذش مرة تانية ، أنا بتكلم بمنتهى الصراحة كدا.
تخرج الدولة من العاصمة عشان الكلام دا ميتكررش تاني.
الاشرار والارهابيين مش هيبطلوا ، ربنا بيساعدنا لكن احنا لازم ناخد بالاسباب.
عشان كدا الدولة كانت لابد متبقاش موجودة مرة تانية البرلمان ميبقاش هناك وميبقاش مجلس الوزراء هناك ووزارة الدفاع تبقى هناك ، زي ما كان موجود قبل كدا ، الكلام دا خلاص محدش يقدر يعمل كدا في مصر تاني"
يعجبني في السيسي انه بيختصر شرح كتير ، الراجل اختصر كتاب "الدولة والثورة" للينين بس من وجهة نظر الدولة.
هاجس ثورة يناير هيفضل موجود عند الدولة ، كنت شوفت حد بيتسائل ليه الدولة تعمل كدا وتجمع كل الأماكن الاستراتيجية في مكان واحد وان احنا لو في حرب دا هيسهل على العدو انه يضرب ويشل الدولة كلها في ضربة واحدة.
باختصار لان الدولة دي عدوها الاول مش اي عدو خارجي ولكن الشعب المصري.
اجهزة الدولة وظيفتها مش حماية الدولة من الاعداء والكلام الفاضي دا ولكن وظيفتها حماية الطبقة الحاكمة من الشعب ومن خطر الثورة.
من أسوأ الناس اللي اتعاملت معاهم الفلاحين ، ومش بقولها عشان أصلهم ولا عشان شغلهم لا خالص ، لكن أنا بتكلم عن طبع اتكرر منهم قدامي كتير ، اللؤم اللي بيخليك تطمنله وتفتكر إنك قدام شخص بسيط وصافي ، وهو في الحقيقة لئيم جداً وبيقيس كل خطوة بمصلحته ،⤵️
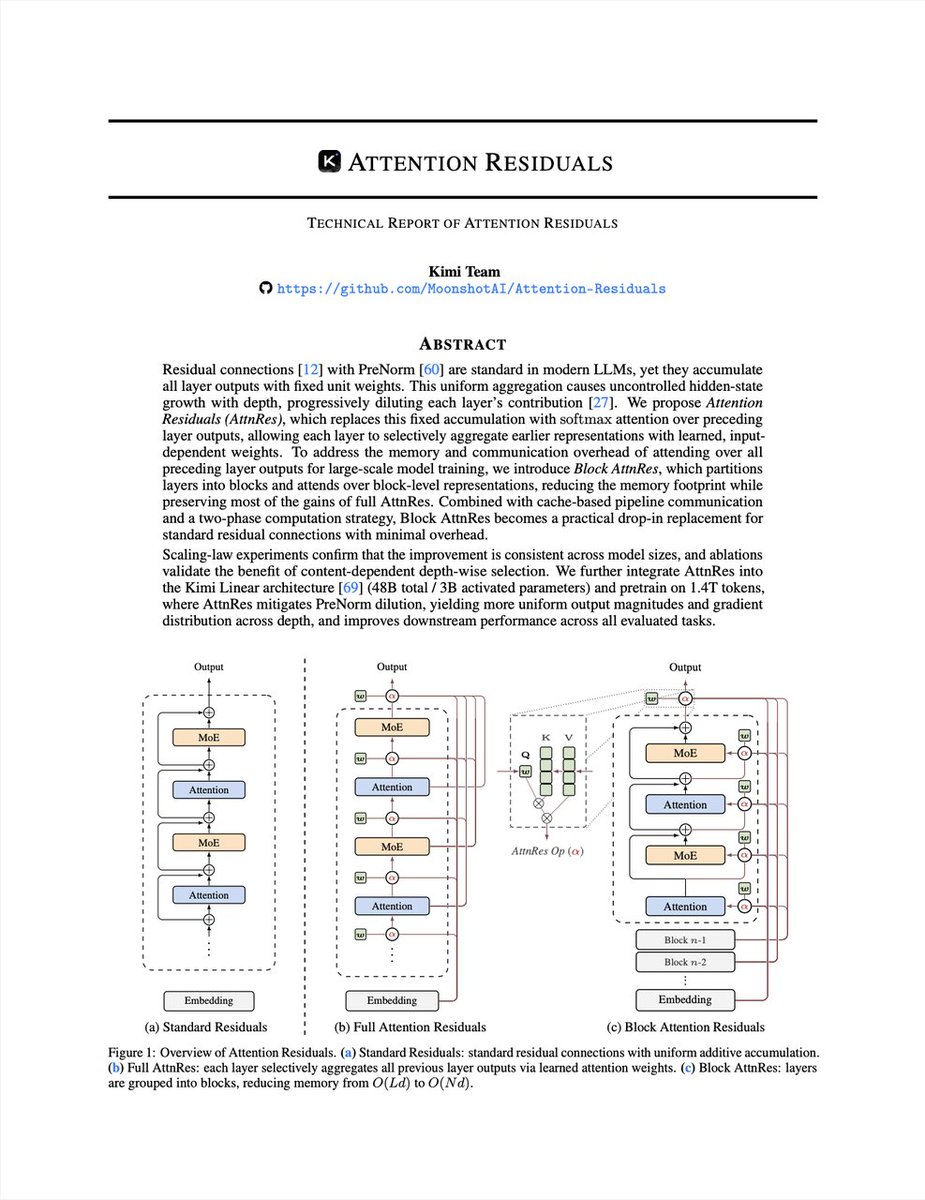
Introducing 𝑨𝒕𝒕𝒆𝒏𝒕𝒊𝒐𝒏 𝑹𝒆𝒔𝒊𝒅𝒖𝒂𝒍𝒔: Rethinking depth-wise aggregation.
Residual connections have long relied on fixed, uniform accumulation. Inspired by the duality of time and depth, we introduce Attention Residuals, replacing standard depth-wise recurrence with learned, input-dependent attention over preceding layers.
🔹 Enables networks to selectively retrieve past representations, naturally mitigating dilution and hidden-state growth.
🔹 Introduces Block AttnRes, partitioning layers into compressed blocks to make cross-layer attention practical at scale.
🔹 Serves as an efficient drop-in replacement, demonstrating a 1.25x compute advantage with negligible (<2%) inference latency overhead.
🔹 Validated on the Kimi Linear architecture (48B total, 3B activated parameters), delivering consistent downstream performance gains.
🔗Full report:
https://t.co/u3EHICG05h