I resigned from Anthropic today. I spent the last three years doing pretraining research at both OpenAI and Anthropic. Neither company is acting responsibly. They are racing straight to self-improving superintelligence and gambling with our lives. More thoughts below.
OPINIÓN | "El gobierno de El Salvador oculta información de proyectos pagados con dinero público y concede excepciones a diestra y siniestra en la aplicación de las leyes de compras públicas. Bukele concibe el manejo de datos como una forma de vigilar a amigos y enemigos".
https://t.co/x2heV5IiKA
🧵(4/4) What El Salvador gets out of it
Nemotron-Personas-El-Salvador is open and live on Hugging Face today (see link below).
Here’s what it gives us:
1.Citizen services: population-scale demographic coverage across all 14 departments, with around 1M synthetic personas to build and evaluate AI assistants for the Salvadoran public.
2.Privacy by design: all data is fully synthetic, with no personally identifiable information. It’s grounded in El Salvador’s real 2024 census distributions, but every persona is artificially generated, and no real individuals are represented, which makes it safe, ethical, and ready to use out of the box.
3.A stronger position: El Salvador stands alongside leading tech economies in NVIDIA’s Nemotron-Personas collection, with an open foundation our whole ecosystem can build on.
It’s free for the government, universities, startups, and researchers to use.
El Salvador has put itself at the front of sovereign AI in the region, and this is the kind of foundation that compounds: every assistant, agent, and model built on it makes the next one better. A new El Salvador is taking shape—not just a place that adopts frontier technology, but one where people build it.
Here is the link to Nemotron-Personas-El-Salvador on Hugging Face:
https://t.co/05FFxvK3j4
Litio, cobre y tierras raras: América Latina se vuelve clave para que EEUU y Europa reduzcan su dependencia de China en minerales críticos para la transición energética y digital.
✍️ Yannic Fricke
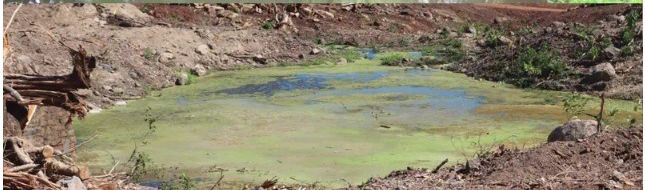
"Reforestación" en Bicentenario no es conciencia ambiental, sus acciones dicen lo contrario 👇
Laguna Condadillo, La Unión.
Antes y despúes de iniciar la contrucción del Aeropuerto del Pacífico.
#ElEspino| #ElSalvador | Anoche, cuando las máquinas comenzaron los trabajos en una parte de la finca El Espino para la construcción de @CIFCOSV , vecinos de colonias cercanas a la obra documentaron mapaches huyendo de la zona.
📹Cortesía
Más de medio millón de personas firmaron contra la construcción del nuevo CIFCO en El Espino y la única respuesta a la petición fue una campaña de desinformación y ataques liderada por el mismo Estado mientras dan inicio al proyecto. Así se gobierna en El Salvador. Cínicos.
La NASA acaba de anunciar que en Bennu —un pedazo de roca tan viejo que podría burlarse de cualquier dios— encontraron todos los componentes del ARN. No algunos. Todos.
Primero aparecieron las nucleobases, esas piezas fundacionales que ya Antonio Lazcano habría celebrado como quien encuentra huellas fósiles en un desierto silencioso. Y ahora se suman azúcares como ribosa y fructosa, el armazón mismo que sostiene la molécula que antecedió al ADN y nos dio la primera chispa de continuidad.
Es un golpe directo al pecho: la vida, o al menos su química, no fue un accidente exclusivo de la Tierra. Estaba allá afuera, dispersa como semillas en un universo oscuro y paciente, esperando caer sobre un planeta con suficiente agua, suficiente tiempo, suficiente calma para empezar su lento oficio de organizarse.
Y mientras yo trato de entender mis propias rutinas, allá afuera la naturaleza nos recuerda —como diría Lazcano en una de sus clases— que somos el eco de procesos tan antiguos que ninguna mitología alcanza. Que la vida es tenaz, testaruda y profundamente cosmopolita.
Una noticia histórica, sí.
Pero sobre todo, un recordatorio de que venimos de lejos.
Mucho más lejos de lo que solemos admitir.
Algunas veces la memoria insiste en traer de vuelta lo vivido, como si quisiera recordarnos que hubo momentos que marcaron nuestro camino. Me alegro que coincidiéramos, pese a que las circunstancias nos llevaron por lugares distintos.
Vivimos en una cultura que teme a la muerte, pero muere un poco cada día sin darse cuenta, negamos el final, lo escondemos, lo maquillamos.
Sin embargo, la muerte no es lo opuesto a la vida, es parte de ella.
Los estoicos lo sabían: quien aprende a contemplarla sin miedo vive con más libertad, más presencia y más amor.
🐍 ¿Has visto "Python: El documental | Una historia de origen"?
Debo decirlo: es una joya para quienes amamos la programación y la historia detrás del software que usamos todos los días. 🎬
👉¿Por qué vale la pena verlo?👇🧵
#Python#HistoriaDelSoftware#OpenSource#DataScience
Estudié la lic y maestría en sociología. Empecé a estudiar ciencia de datos mientras trabajo porque mi formación llegó solo a los modelos (regresión) y yo quería aprender a minar, procesar mejor, y entrarle al vizdata.
Y hay vatos que me exigen casi que el código entrenado
[Jueves de libro 📚] - Network Analysis in R – Sacha Epskamp, David Schoch, Kolaczyk & Csárdi
El análisis de redes abre un mundo de posibilidades para entender relaciones complejas: desde interacciones sociales hasta conexiones biológicas o de sistemas. Este recurso te guía con teoría y práctica directamente en R.
✨ ¿Por qué vale la pena?
🔹 Introduce los fundamentos del análisis de redes y grafos.
🔹 Incluye ejemplos aplicados que podés replicar.
🔹 Explica cómo interpretar modelos de redes reales.
👩💻 Ideal para estudiantes, investigadores y profesionales que quieran ir más allá de las tablas tradicionales y explorar cómo se conectan los datos.
👉 Guardá este recurso, compartilo con alguien que trabaje con redes ¡y contame en comentarios qué aplicación de network analysis te interesa más!
[Jueves de libros 📚] – Como todos los jueves, te traemos una lectura recomendada para seguir creciendo en el mundo de los datos.
📌 En esta oportunidad: Programación práctica con R
Este libro es una guía amigable para quienes quieren dar sus primeros pasos en R, con un enfoque claro, ejemplos aplicados y sin necesidad de experiencia previa en programación.
✨ ¿Por qué vale la pena?
⤷ Parte de lo más básico, ideal para principiantes.
⤷ Explica objetos, funciones y estructuras de datos paso a paso.
⤷ Ofrece ejercicios prácticos para ganar confianza desde el inicio.
✨ Temas principales que vas a encontrar:
✒️ Fundamentos de R
Objetos, funciones y estructuras de datos.
✒️ Resolución práctica de problemas
Cómo escribir y organizar código de forma clara.
✒️ Ejemplos aplicados
Casos sencillos que permiten aprender practicando.
👩💻 Ideal para estudiantes, investigadores y profesionales de cualquier disciplina que quieran aprender a programar en R para analizar datos.
👉 Guardá este recurso, compartilo con alguien que recién arranca ¡y contanos en comentarios qué es lo primero que te gustaría programar en R!
🔗 https://t.co/Y3v1pNGbfc
✍🏻 Garrett Grolemund
#RStats #RStatsES #DataScience #AprenderR #RLibro #Programación #ComunidadRLatam
Conceptos de negocio para jóvenes data scientists
Cómo los problemas de negocio se pueden traducir en problemas de Machine Learning.
Ejemplo: segmentación de clientes
El negocio quiere entender mejor a sus clientes para diseñar estrategias diferenciadas: campañas personalizadas, precios dinámicos, productos ajustados a cada grupo.
Desde datos, podemos convertir esto en un problema de agrupamiento:
¿Qué grupos de clientes existen en la base actual y cuáles son sus características comunes?
Así se traduce a ML:
•Entrada: variables de clientes como edad, ingresos, ubicación, historial de compras, uso de canales digitales, frecuencia de interacción.
•Etiqueta (dataset): no hay una etiqueta explícita, porque es un problema no supervisado. El “resultado” son los clústeres que el algoritmo descubre.
•Salida: grupos de clientes con características similares, que pueden servir para marketing, cross-sell, upsell o retención.
Primer enfoque sencillo:
•Escalar las variables y aplicar un algoritmo como K-Means o Gaussian Mixtures.
•Analizar los grupos resultantes y darles un “nombre de negocio” (ejemplo: clientes digitales jóvenes, clientes de alto valor tradicionales).
•Usar esos segmentos como feature en modelos posteriores (ejemplo: predicción de churn o de compra de producto).
Este enfoque de “clustering + interpretación” es fácil de implementar, intuitivo para explicar al negocio y genera insights rápidos. Después se puede evolucionar hacia segmentaciones dinámicas con embeddings de usuarios, autoencoders o clustering jerárquico sobre grafos de relaciones.
🔑 La clave: un reto de negocio puede convertirse en un problema de ML bien definido, y la segmentación es la base de muchas estrategias más avanzadas.
En mis años de academia algo que fue una constante es que, fuera de las ciencias de la computación, el código detrás de grandes descubrimientos científicos tiende a ser feo, y si el estudiante que lo escribió se fue… ese conocimiento se pierde para siempre.
Lo interesante es que Google Research y DeepMind acaban de presentar un sistema de IA que no solo escribe mejor código científico que los humanos, sino que incluso descubrió nuevos métodos que superan el estado del arte en bioinformática, epidemiología, geoespacial y más.
Crearon un sistema muy ingenioso para generar código de calidad para el descubrimiento científico. Sería un honor poder pilotear algo así con investigadores en México.
Ya no hablamos de IA como asistente de productividad, sino como motor de descubrimiento.
La pregunta es: ¿estamos listos para que la ciencia dependa de código que ningún humano habría escrito?