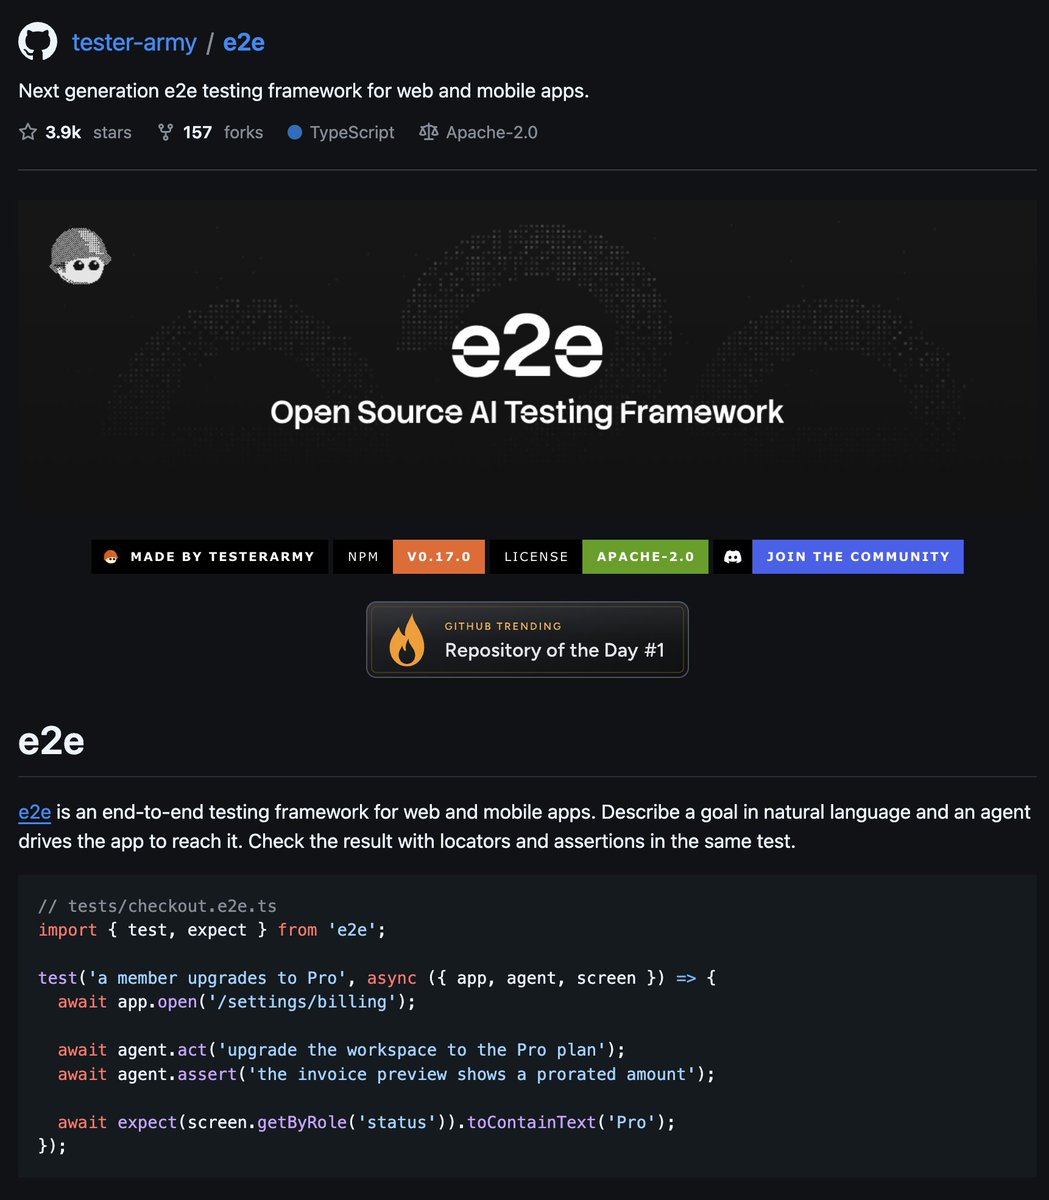
¡La nueva generación de tests para web y apps móviles!
El framework se llama "e2e" y es de código abierto
✓ Mezcla IA con pruebas deterministas
✓ Compatible con OpenAI, Claude y cualquier AI
✓ La misma API para web, iOS y Android
→ https://t.co/n09ldmz3PD
@Ubendev You have gentle ai which works everywhere and Gentle Shell, our own custom agent:
https://t.co/kKINXa2nns
https://t.co/OaMIC9YeXH
Give it a try !
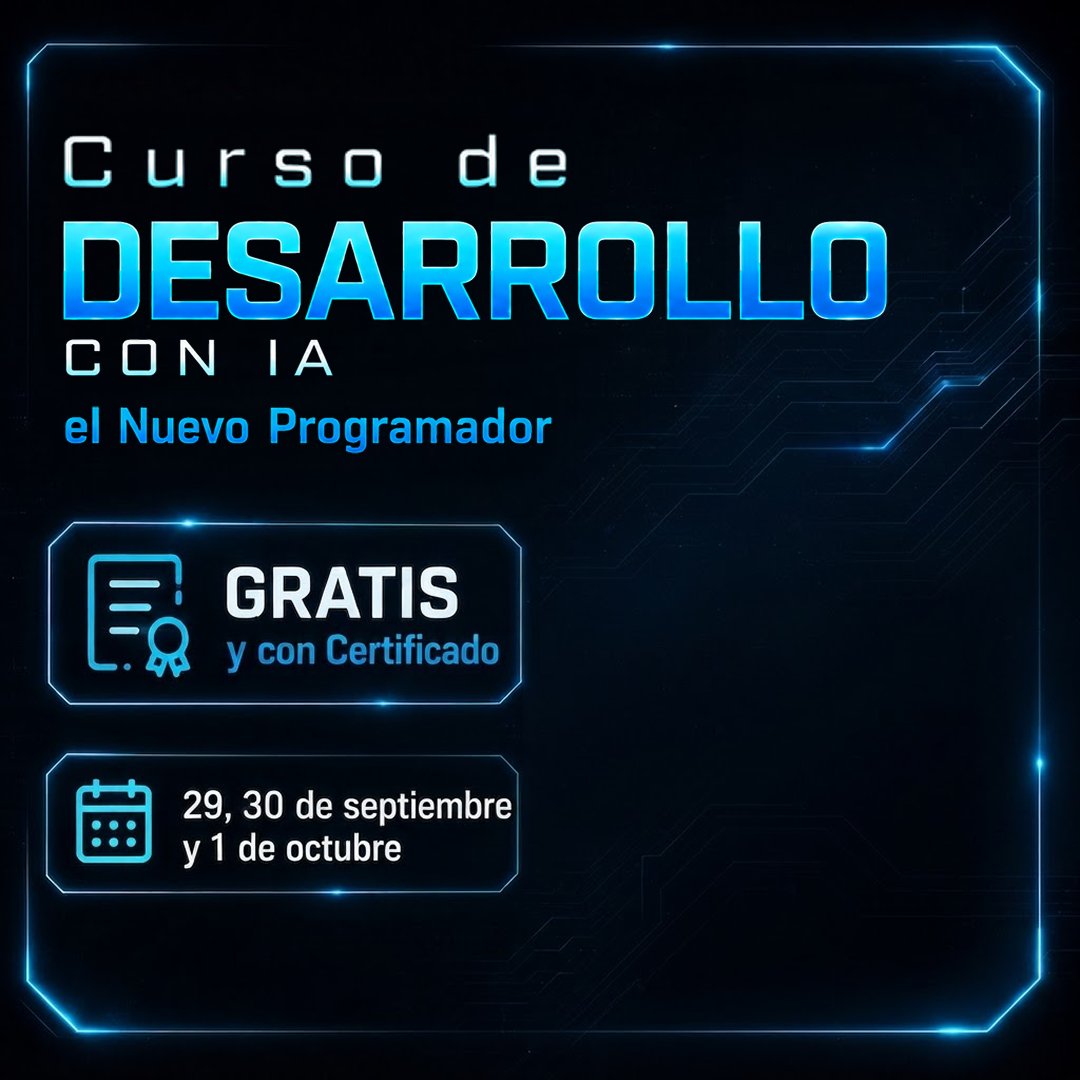
Curso gratis de desarrollo con IA, con certificado, y lo da @MoureDev .
29 y 30 de septiembre y 1 de octubre, 19:00 hora España, en abierto.
Día 1 diseñás, día 2 delegás a un agente, día 3 orquestás tu equipo de agentes.
El que solo pica código pierde valor. Es gratis, ponete las pilas.
Link en el primer comentario (afiliado, si entrás por ahí me das una mano).
¡POR FIN! Claude Code añade soporte a AGENTS.md.
No tienes que hacer nada:
→ Por defecto lee el AGENTS.md
→ Si no lo encuentra, leerá el archivo CLAUDE.md
Disponible desde la versión 2.1.277
Meta lleva MCP a WhatsApp Business.
WB Tools MCP, los agentes de IA pueden ayudar a configurar cuentas, números, templates, webhooks y pruebas usando lenguaje natural.
La IA ya no solo responde. Empieza a operar herramientas empresariales.
#AI#MCP#WhatsAppBusiness#Agents
Este es un post desde el corazón que estaré compartiendo en mis redes.
Hace unos años empecé Gentleman Programming, en tiempos de pandemia tratando de llegar a todo el mundo para ser ese acompañamiento y mentor que no pude tener.
El día de hoy fue mí hito más grande como creador de contenido pero no solo eso, sino también como creador de herramientas y comunidad.
Con casi lágrimas en los ojos di las gracias a un público que llenó la sala y más, por venír a conocerme, a hablar conmigo y sobre todo a darme las gracias. Lo que no se dan cuenta es que las gracias las tengo que dar YO a ellos.
Por guiarme, iluminarme, darme fuerzas, acompañarme, defenderme y compartir etapas increíbles juntos.
El anuncio de la llegada de mí hijo, mis nuevos trabajos, la perdida de los mismos, mis nuevas ideas, mis herramientas, nuevo video, short, oportunidad y muchísimo más.
Son mucho más importantes de lo que creen para mí, por eso no solo quiero que me saluden sino que me abracen y sientan el afecto que tengo por ustedes. Que nos conocemos desde antes, porque es verdad !! No es solo verme por la pantalla es conectar juntos.
Así que gente... No les fallaré, o al menos haré lo mejor que pueda... Dios ahora si que ya se largó a llover 🥹
Ahora sí, 1:20am, día cansador pero les presento... Organic Driven Development, mí alternativa a SDD para tiempos de los modelos actuales
https://t.co/9lD7bFpt5I
YA MISMO EN IMPLEMENTACION
gentle-ai v2.8.0 afuera: evidencia de review que aguanta cuando el trabajo se pone real.
Y arranco con una promesa cumplida. En el post de la v2.7.0 les conté que dos merges quedaban AFUERA a propósito: cambiaban cómo los agentes pueden correr comandos remotos, y queríamos convivir con ellos un tiempo antes de que llegaran a un stable. Bueno, acá están. Maduros, probados en main durante semanas, y ahora con controles explícitos de autorización, inputs confiables e identidad de origen. Eso es release engineering: lo que no está listo espera, y cuando entra, entra bien.
¿El tema de la release? Los bordes. Los límites que importan cuando el trabajo cruza agentes, worktrees, plataformas y caminos de recovery:
→ Review y RDD más explícitos en los bordes: donde se cruzan autoridad, identidad del candidato, remediación y estados terminales. Menos estado implícito, recovery más claro, y protección más dura contra acciones de review viejas o mal ruteadas.
→ SDD más veraz: el trabajo fallido, interrumpido o resumido se maneja con ownership estricto y estado claro, en vez de señales de progreso ambiguas. El sistema te dice la verdad sobre dónde estás parado.
→ Y el runtime más inspeccionable: visibilidad de operaciones activas con atribución de subagentes en todos los runtimes soportados. Con un principio que me importa mucho: los diagnósticos se vuelven más accionables SIN convertir la telemetría en una fuente de autoridad. Mirás mejor, pero el que manda sigue siendo el contrato.
Los números: 117 commits, 48 PRs mergeados y ONCE autores distintos desde la v2.7.0. Once. La comunidad ya es parte del motor.
https://t.co/Tbfj2ai2z8
#OpenSource #DeveloperTools #AI
Voy a ser honesto con @AnthropicAI y @claudeai sobre algo que me comió el 85% de la suscripción semanal de Claude Code en UN día. Y no, no fue por el laburo.
Este es el tema. Tuve una sesión viva tres días. Venía andando fantástico: releases, infra, todo. Pero el contexto creció hasta casi un millón de tokens y Claude Code nunca me dijo nada. Ni un aviso, ni un "che, compactá esto", nada.
Entonces hoy mi thread principal hizo 537 requests. La mayoría eran el modelo corriendo un comando y leyendo el resultado (justo tenia una tarea "monitor" corriendo a un Grafana y cada vez que llegaba data consumía esta cantidad). Cada una releyendo unos 690.000 tokens de contexto. Cacheado, sí, pero 537 por 690k en un día es una factura real, y me cayó encima con cuatro días para el reset.
Ya te lo estoy diciendo: el modelo no hizo nada mal. Hizo exactamente lo que le pedí. El tooling me dejó caminar derecho contra la pared sin visibilidad de nada.
Tres cosas que me hubieran salvado:
1- Mostrame el tamaño del contexto y lo que cuesta cada turno, ahí mismo en la status line. Si un turno cuesta medio millón de tokens, lo quiero ver ANTES de apretar enter.
2- Pasado cierto umbral, sugerime compactar o arrancar sesión nueva. En un plan de suscripción esto tiene que sonar fuerte.
3- Notificaciones en background, monitors, hooks: que no conviertan cada una en un turno con el contexto completo.
Construyo mucho sobre Claude Code y justamente por eso me jode muchísimo. Las sesiones largas son su mejor feature y su trampa más cara al mismo tiempo. Hagan visible el costo y esto no le pasa a nadie más.
¿Se entiende? Que solo esta sesión hubiese sido alrededor de $1615.
Algunas imágenes del nuevo gentle-pi 3.0, alias - Gentle Shell, el nuevo agente propio de gentle-ai basado en pi-agents. Todo lo que ven es hecho nativo:
- Podrás ver el status de tu sub de OpenAI y Claude directo desde la status bar inferior.
- Interfaz totalmente moderna, nativa y super rápida.
- Consumo de recursos MÍNIMO.
- Diff Checker para que puedas ver qué está haciendo tu agente en vivo.
- Manejo NATIVO de sub agentes con posibilidad de abrir su session en cualquier editor de tu preferencia.
Y muchas más cosas que se vienen :)
#opensource #agents #llm #ai #workflow #work #agent #engineering
🚀 Salieron DOS releases de Gentle AI, y vienen cargadas de mejoras reales.
**v1.45.0**
- Nuevos perfiles GPT-5.6 para Codex: Sol, Terra y Luna, con presets más inteligentes para cada fase de SDD.
- Integración de Codex más segura.
- Fixes: upgrades de Homebrew, configuración de temas, comportamiento de Engram, y varios casos donde una instalación podía quedar en estado incierto.
Release: https://t.co/WRGJX3HyDU
**v1.46.0**
Esta cambia de raíz cómo Gentle AI hace reviews. El nuevo 4R v2 prioriza PRECISIÓN sobre ruido:
- Los cambios chicos ya no levantan un ejército de reviewers.
- Los cambios normales reciben una sola lente enfocada.
- Los cambios grandes o sensibles mantienen el review completo, pero con límites concretos.
- Los findings críticos ahora tienen que sobrevivir una refutación adversarial antes de generar trabajo.
- Chau loops infinitos: rondas de fixes limitadas y refutadores batcheados para que el costo no explote con la cantidad de findings.
¿Qué deberían notar? Reviews más rápidos, menos falsos positivos, menos agentes corriendo porque sí, y mucha más claridad sobre cuándo un cambio está realmente listo.
Release: https://t.co/rqizJwNDiP
**Para actualizar**
```
brew upgrade gentle-ai && gentle-ai sync
```
Si usan Codex con GPT-5.6, necesitan la versión 0.144.0 o superior:
```
npm install -g --ignore-scripts @openai/[email protected]
```
Las dos releases están probadas con unit tests y E2E en Ubuntu, Arch y Fedora. Y la v1.46.0 fue revisada usando su propio protocolo: eso nos permitió encontrar y corregir la explosión de refutadores antes de publicarla. Dogfooding DE VERDAD.
Actualicen, pruébenlo en proyectos reales y cuéntenme cómo les funciona. Que lo disfruten ❤️
Hoy mejoré mi sistema de review adversarial a la mañana, y ese mismo sistema custodió todo lo que shippeé el resto del día. Nació y se pagó solo en la misma sesión. Te cuento el proceso completo, porque acá lo que vale no es el resultado, es cómo se llegó.
Empezó con una auditoría de tokens a mi propia herramienta. Resulta que gentle-ai le inyectaba unos 13.600 tokens de contexto fijo a CADA sesión de Claude Code antes de que escribas una sola palabra. El protocolo de memoria entraba tres veces por canales distintos. La persona entraba dos veces. Y lo peor: las dos copias habían drifteado, eran textos parafraseados diciendo casi lo mismo con wording distinto. Eso no es solo plata, locura. Instrucciones repetidas con palabras diferentes te degradan el compliance del modelo. Es calidad la que se te va.
¿Cuál fue la regla? No tocar una sola línea de código sin proceso. Cada cambio pasó por el ciclo completo de Spec-Driven Development: exploración, propuesta, diseño, tareas, implementación con TDD estricto, verificación. Y arriba de todo eso, judgment day: dos jueces ciegos revisando en paralelo, un ledger de findings persistido, y re-reviews acotados solo a lo que tocaron los fixes.
Y acá viene el dato que me parece el más importante del día. Cinco veces el verify formal dio PASS. Y las cinco veces los jueces adversariales encontraron críticos reales. Un data race reproducido con go test -race. Un GET HTTP a la API de GitHub metido en cada session start que nadie había pedido. Reglas de contenido perdidas en una migración que los tests no veían, porque comparaban versión nueva contra versión nueva y nunca contra la fuente de verdad. En total: 54 findings encontrados, arreglados y verificados antes de mergear.
Los números finales quedaron una flor: entre 1.700 y 2.600 tokens menos por sesión. Y reviews que antes churneaban infinito ahora convergen de verdad. Cinco findings, después uno, después uno, después cero. Finish.
La parte que más me gusta ya te la spoileé arriba, pero mereces el detalle: el primer feature que shippeamos a la mañana era justo el contrato de review con ledger. Ese mismo sistema custodió los otros tres durante el resto del día. Construimos la herramienta de calidad primero, y la herramienta se pagó sola.
Tres lecciones que me llevo. Un test de regresión vale lo que vale su baseline. A los agentes la evidencia se les dicta verbatim, porque cuando parafrasean, inventan. Y la IA es una herramienta: el humano dirige, la IA ejecuta, y los procesos existen para que ninguno de los dos se mienta a sí mismo.
gentle-ai v1.44.0 y engram v1.19.0 ya están afuera, con todos los artefactos y ledgers de review archivados en los repos para el que quiera auditar cada decisión.
Esto es lo que pasa cuando dejás de pedirle código a la IA y empezás a construir SISTEMAS con ella.
Éxitos, nos vemos ahí. Y disfruten el nuevo Gentle-Ai !!
¿Importa el medio, mientras el valor sea el mismo?
Dar contenido de valor, lo antes posible, con razonamiento, pensamiento e ideales propios. Pero asistido por una herramienta fine-tuneada para hablar como hablo yo.
¿Eso es perder mérito? ¿Deja de ser mi observación, mi pensamiento, mi razonamiento?
Yo creo que no. Si no, dejemos el teclado. Dejemos el text to speech. Dejemos el autocorrector. Y ya que estamos, volvamos al cincel y la piedra.
Porque la herramienta no piensa por mí. Yo dirijo, ella ejecuta. El mérito nunca estuvo en quién mueve los dedos. Está en saber QUÉ pedir, y POR QUÉ lo que te responde puede estar mal.
Eso no me lo terceriza ninguna IA.