Coding agents can now work directly with Windmill through MCP. Start with a read-only token to inspect the workspace, then grant write access only where the task needs it.
Point Claude Code or Cursor at a Windmill workspace and it can build, test and deploy scripts and flows. The AI session toolset is now an MCP server at /api/mcp. Scope the token however you want, down to read-only.
https://t.co/eE5zMUtH8q
Validar o plano de execução antes de liberar o diff poupa horas de git reset. Quando você poda o escopo no texto, o agente mexe só nos arquivos necessários e evita refatoração acidental na base de código.
Dica de Claude Code que evita muito retrabalho: antes de qualquer código, peça o plano em passos. Leia, corte o que não precisa e só depois mande executar.
O mal-entendido aparece no plano, e não depois de dezenas de arquivos alterados.
Compiling deterministic media through coding agents makes more sense than raw generative video models. Driving programmatic camera moves over real DOM assets gives reproducible output and zero hallucinated UI states.
Tell Claude Code "make a promo for my product" and get back a finished launch video.
→ Captures your real website pages
→ Picks from 150 tuned camera moves and animations
→ Cuts it to the beat and adds sound
→ Checks every frame, then hands you an MP4 you can keep editing
No AI-generated footage, every frame is your real product.
https://t.co/JjclF1IGMj
Velocidade de geração sem leitura crítica só acelera o acúmulo de bug em produção. O diferencial de operar agente no terminal é saber validar o diff linha por linha e refatorar a lógica antes de dar merge na branch principal.
o júnior com Claude Code provavelmente entrega primeiro, o sênior sem IA provavelmente entrega o que não quebra depois. a pergunta que decide é quem consegue revisar o que foi gerado: sem review, a feature roda e a dívida técnica vai junto. eu colocaria o sênior com IA nessa comparação e o resto do debate some.
Internal evals built from actual shipped code beat public leaderboards every time. When agents write most of your commits, synthetic benchmarks stop mattering and only task completion on your real repo harness decides the model.
Ramp says effectively all of its code is now written by agents? 😳
So they built their own benchmark to decide which agent gets the work. Ramp SWE-Bench v2: 500 tasks from code 200+ of their engineers actually shipped to production, every model running in its native harness.
GPT-6.2 Astra (Codex): 76.4%, $3.31/task
Carbon (OpenCode): 75.4%, $4.25
Fable 5.2 (Claude Code): 73.4%, $3.79
GPT-6.2 Sol (Codex): 73.4%, $1.05
Ramp says these scores shift its inference between providers, sometimes multiple times a week.
Still picking your coding agent off public leaderboards?
#AICoding #AIAgents #SWEBench
Rodar Claude Code direto no GitHub Actions muda a dinâmica de revisão de PR. O segredo é manter o runner próprio com escopo fechado e suite de testes rodando antes de aplicar qualquer patch sugerido pelo agente.
So ICYMI you can tag @claude on a GitHub pull request and it reviews or fixes it. official, free, open source 👀
Claude Code Action runs Claude Code inside your GitHub workflows.
- answers @claude mentions on PRs and issues
- reviews PR changes and suggests fixes
- can implement simple fixes, refactors and small features
- runs on your own GitHub runner
- set up from Claude Code with /install-github-app
10k stars. MIT. you bring your own API key.
https://t.co/4XOF8LKwD1
Paulinho o Loko bateu mais de 270 mil pessoas simultaneas na estreia do GTA 6.
A expectativa da comunidade brasileira pelo jogo quebrou todos os recordes da Twitch.
#GTA6#GTAVI
Spending 45 minutes and six dollars to generate a single Three.js scene shows the current economics of coding agents. Autonomous execution loops and compile-time sandbox checks consume more runtime than the actual token drafting phase.
someone just ran the same tokyo alley prompt through GPT-6.2 Astra and Gemini 4 Neon
one continuous 20-second three.js steadicam shot, through a rainy street, across a wet intersection, and up to an elevated train
> GPT-6.2 Astra: $6.48, 46 min 56s
> Gemini 4 Neon: $6.40, 48 min 5s
test by @teddyaisi
which one do you like ?
Rodar múltiplos agentes em paralelo no mesmo repositório multiplica conflitos de merge na velocidade da máquina. A trava real dessa arquitetura fica na resolução automática de AST e no isolamento de contexto entre branches antes de autorizar o commit.
Parallel agents on one codebase sounds like a productivity dream until you picture merge conflicts at machine speed. Anthropic's real test isn't coordination—it's whether…
https://t.co/1iJcrN3dfH
Usar agente de terminal como primeiro rascunho funciona se você tiver suite de testes cobrindo a feature. Sem teste automatizado para validar o diff, o tempo que você gasta limpando alucinação em arquivo alheio anula o ganho de velocidade do scaffolding.
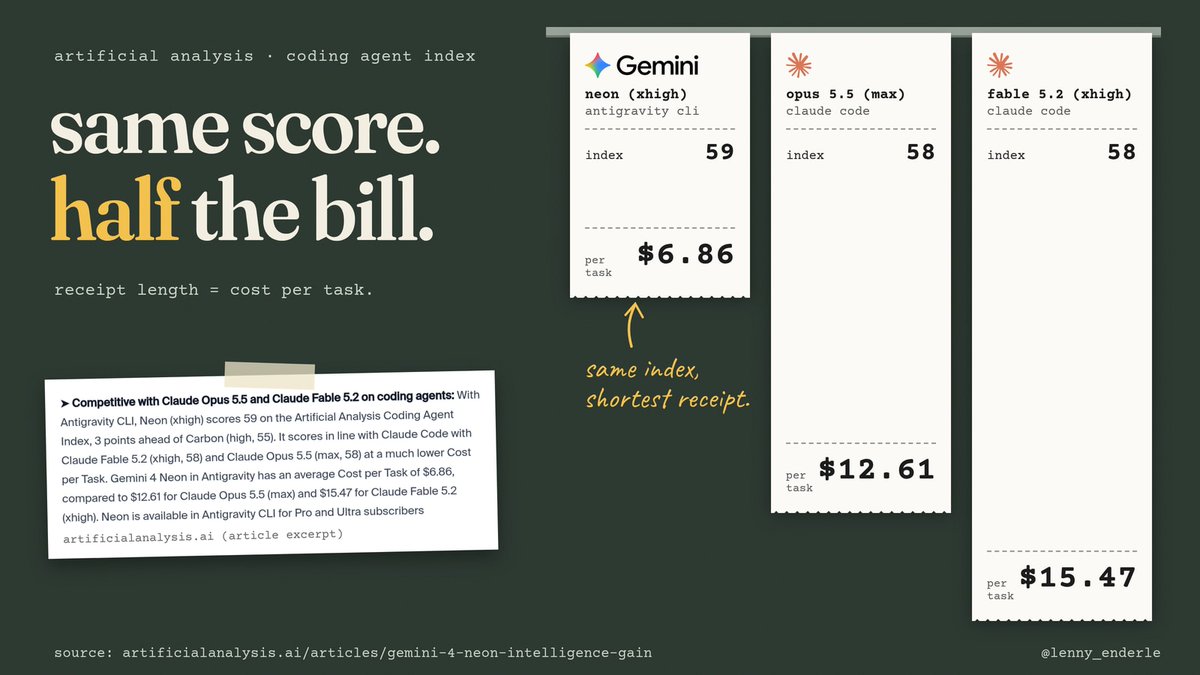
Cutting task cost in half at parity score changes how aggressively you can parallelize agent runs. When runs drop to $6, spinning up multiple review subagents and speculative branches becomes practical for daily pull requests.
gemini 4 neon tied claude code last night. for about half the price.
artificial analysis coding agent index, score / cost per task:
neon (antigravity cli): 59 / $6.86
opus 5.5 max (claude code): 58 / $12.61
fable 5.2 xhigh (claude code): 58 / $15.47
does it get a slot in your setup?
O bug de renderizacao mais bizarro do GTA 6 ate agora: pedestre evaporando na cara do GabePeixe no transito de Vice City.
A Rockstar vai ter trabalho nas primeiras atualizacoes.
#GTA6#GTAVI
Closing the benchmark gap while charging $3/$15 per million tokens completely shifts production economics. When a top-tier model prices close to mid-tier rates, teams can afford aggressive self-eval loops and multi-agent verification without rationing API calls.
Gemini 4 Neon is making GPT-6.2 Sol and Claude Opus 5.5 look seriously OUTDATED.
Artificial Analysis Intelligence Index:
Claude Fable 5.2: 65
GPT-6.2 Astra: 62
Gemini 4 Neon: 61
Claude Opus 5.5: 59
GPT-6.2 Sol: 57
Neon is just ONE point behind Astra, while beating Opus by 2 and Sol by 4.
And it costs just $3/$15 per million tokens.
Empilhar assinatura fechada para rodar múltiplos agentes cobra a conta rápido no fim do mês. Orquestrar modelos locais ou via API com harness próprio dá controle de execução e corta o desperdício de limite antes de travar a operação.
O time de 11 agentes roda no plano Super do Grok Bot. Uns 500 por mês.
Quem escreve o código do app de leitura bíblica é o Claude, no Pro. Uns 115.
ElevenLabs, Canva e CapCut também entram. Desses eu nem lembro mais o valor.
Mas o Super ta acabando rápido demais. E não me adaptei ainda ao Openbot
Synthetic benchmarks lose credibility within hours of release. The real test starts when developers throw raw production codebases, messy pull requests, and automated agent harnesses at the new model to measure cost and failure rates.
gemini 4 Neon is 11 hours old and hacker news already has it in a cage match with Opus 5.5. model launches don't get a honeymoon anymore, they get a weigh-in 💀
Colocar prompt em SDK e plugar RAG básico qualquer tutorial ensina. A régua sobe quando a aplicação exige harness com controle de memória, telemetria de chamadas e baterias de eval rodando a cada commit para barrar regressão.
Tem muito AIE que só usan langchain, os SDKs da OpenAI/Anthropic/Gemini e usam uns sistemas de RAG pre construídos etc então a régua fica baixa, e já dá pra fazer muita coisa mesmo, mas sem entender harness e inferência, memória, orquestração além do básico, arquiteturas de modelos pra escolher os melhores métodos de aprimoramento (RLHF DPO, GRPO etc) e fazer fone tuning, eval, telemetria, e também saber servir modelos, multi deflcoding etc tem muito lugar que descarta, geralmente Labs de AI e times maiores e mais especializados. Pré training e post training é visto como luxo por vários devs migrando pra AI eu tenho visto, e times também cujo objetivo é só fazer agentes com modelos cloud que consultam bases internas, mas também acho que é porque é mais difícil, exige mais ciência de dados pura pra trabalhar inferência e mais entendimento de estatística no geral pra realmente melhorar um modelo então parece um mecanismo de lidar com algo que se sabe menos e se usa menos no dia a dia que os deve usam ("cara só preciso de RAG"). No futuro próximo, porém, modelos locais serão bem mais atraentes e usados e saber essas coisas será obrigatório. O Brasil vai demorar mais, mas vai chegar aqui também. Atualmente a maioria das vagas de AIE só ficam em RAG, justamente porque a maioria das empresas ainda usa modelos cloud e não precisam otimizar vários processos e pipelines que modelos locais faz parte. Não tem como fazer fine tuning de um sol ou opus etc, então a maioria não usa e aprender a fazer BEM não é só aprender a usar lora etc... AI na verdade é difícil e exige muito estudo específico que vários AIE atuais não quiseram ter... Muito mesmo. Ainda vejo muito dev que só vê AI como um framework a mais que você aprende a usar onSDK e prompt Engineering e pronto. Apenas a opinião de alguém trabalhando com ML e AI há anos que já viu muito processo de contratação, times de ML e estilos de liderança por aí ....
Chamar API de modelo e printar texto qualquer script de dez linhas faz. O trabalho de verdade em agentes começa no harness: gerenciar estado, podar contexto, tratar erro de tool call e validar retorno de terminal antes de aceitar a resposta.
💡 O apagão não veio, mas tem muita gente ainda no escuro quando o assunto é IA. 😂
Vejo muita gente aprendendo a chamar uma API, recebendo uma resposta e achando que já sabe construir agentes de IA.
Mas o diferencial não está aí.
Os modelos estão disponíveis para todo mundo. O que muda o jogo é saber construir o que existe ao redor deles: o harness, a memória, as ferramentas e toda a lógica que faz um agente realmente funcionar.
🚀 É justamente isso que ensino no meu curso de Engenharia de Agentes.
São mais de 25 aulas, construindo tudo do zero, código por código, sem depender de ferramentas prontas. E ainda tem um espaço exclusivo para tirar dúvidas diretamente comigo.
Minha ideia é simples: quero que você entenda como tudo funciona, não que apenas copie código.
Porque saber usar IA é uma coisa. Saber construir soluções com ela é outra.
⚡ E por aqui esse assunto ainda vai render muita conversa!
#InteligenciaArtificial #AgentesDeIA #EngenhariaDeSoftware
Chamar API de modelo e printar texto qualquer script de dez linhas faz. O trabalho de verdade em agentes começa no harness: gerenciar estado, podar contexto, tratar erro de tool call e validar retorno de terminal antes de aceitar a resposta.
💡 O apagão não veio, mas tem muita gente ainda no escuro quando o assunto é IA. 😂
Vejo muita gente aprendendo a chamar uma API, recebendo uma resposta e achando que já sabe construir agentes de IA.
Mas o diferencial não está aí.
Os modelos estão disponíveis para todo mundo. O que muda o jogo é saber construir o que existe ao redor deles: o harness, a memória, as ferramentas e toda a lógica que faz um agente realmente funcionar.
🚀 É justamente isso que ensino no meu curso de Engenharia de Agentes.
São mais de 25 aulas, construindo tudo do zero, código por código, sem depender de ferramentas prontas. E ainda tem um espaço exclusivo para tirar dúvidas diretamente comigo.
Minha ideia é simples: quero que você entenda como tudo funciona, não que apenas copie código.
Porque saber usar IA é uma coisa. Saber construir soluções com ela é outra.
⚡ E por aqui esse assunto ainda vai render muita conversa!
#InteligenciaArtificial #AgentesDeIA #EngenhariaDeSoftware
A 12.8% to 39% jump on the same model proves how much benchmark scores depend on the scaffolding. Your execution loop, tool definitions, and terminal feedback drive performance just as much as raw weights.
We keep arguing about which AI model is “best”. Gemini 4 Neon’s launch has a useful reminder: Google reports 12.8% on one coding-agent setup and 39% in Antigravity. Same model, different harness. The tools around the model matter too. 👀
Characte